
知识蒸馏是什么?大模型本事怎么塞进小模型,图解讲透
知识蒸馏(Knowledge Distillation)是把大模型的能力迁移给小模型的训练方法:让小模型当学生,不只学标准答案,还模仿大模型老师输出的完整判断分布。这套方法由 Geoffrey Hinton 等人在论文《Distilling the Knowledge in a Neural Network》系统提出,2015 年 3 月 9 日提交 arXiv,如今是端侧模型和低成本推理的主力技术。
为什么不直接用大模型?
Hinton 论文的出发点是模型集成(ensemble):把很多模型训练出来一起投票,确实能提分,但部署太贵,线上服务扛不住。解决办法是把这个集成的知识"压缩"进一个小模型,这就是蒸馏。
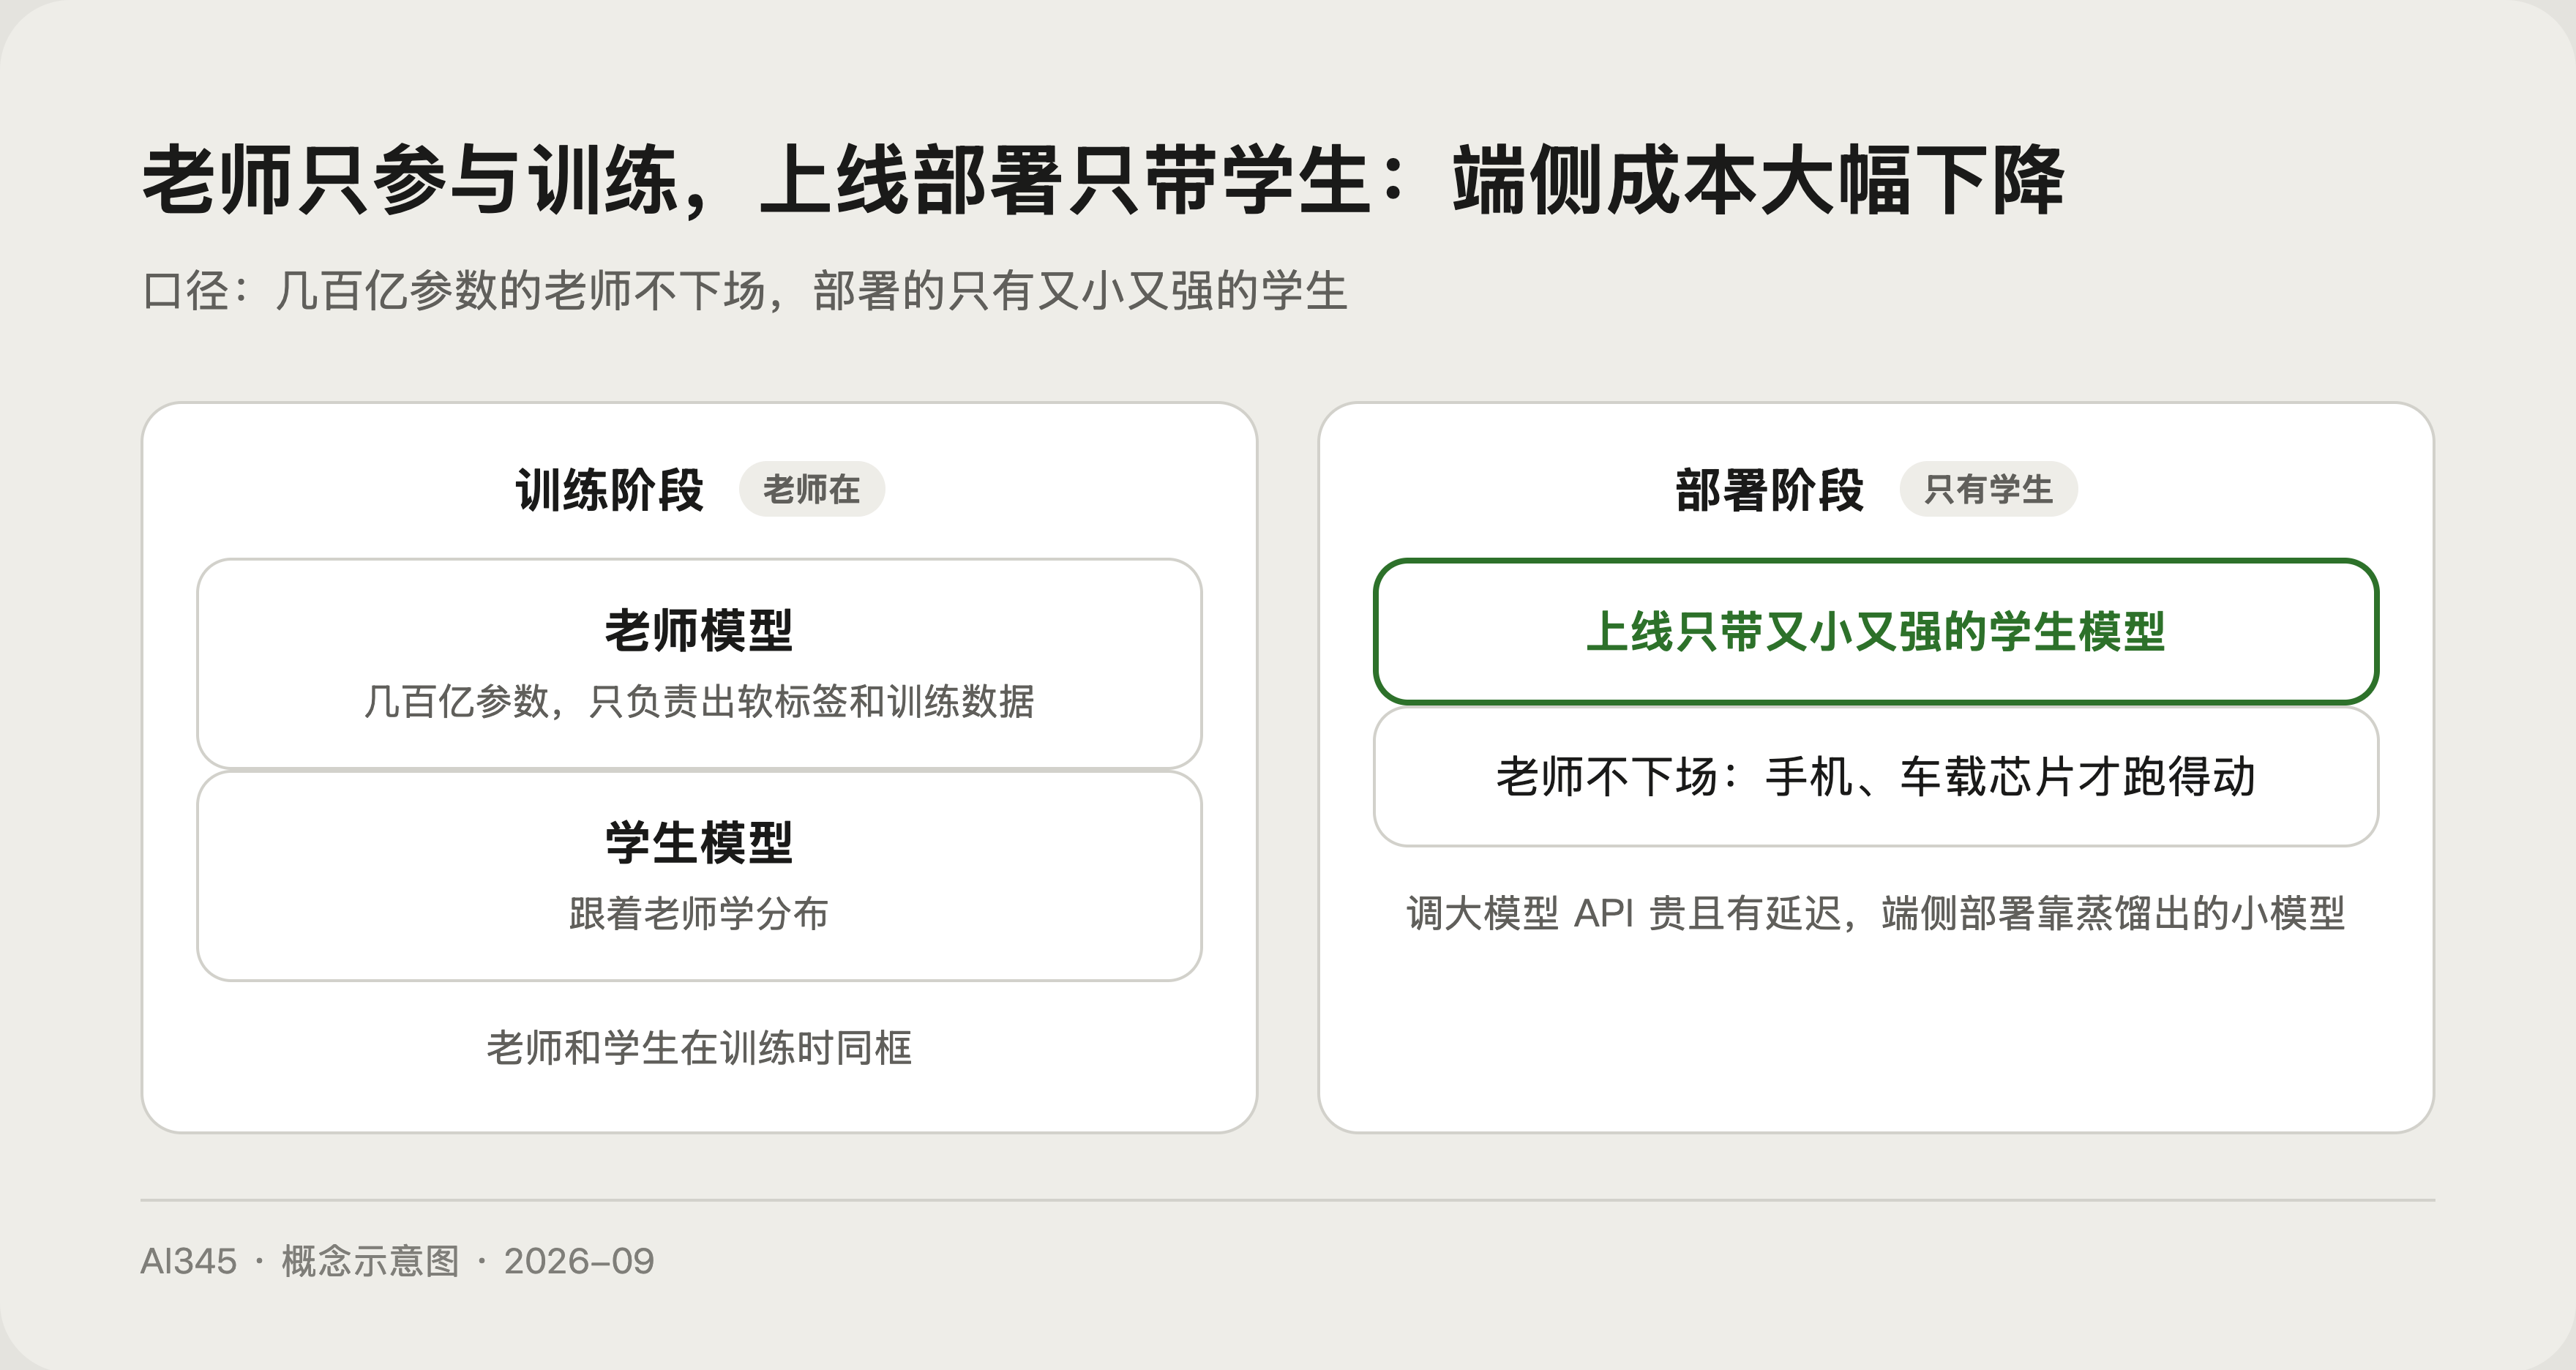
放到今天的大模型语境,逻辑一样:几百亿参数的模型效果虽好,但手机、车载芯片根本跑不动,调 API 又贵又有延迟。蒸馏就是"让小模型继承老师本事"的标准路线。
老师和学生比喻:学答案不如学解题思路
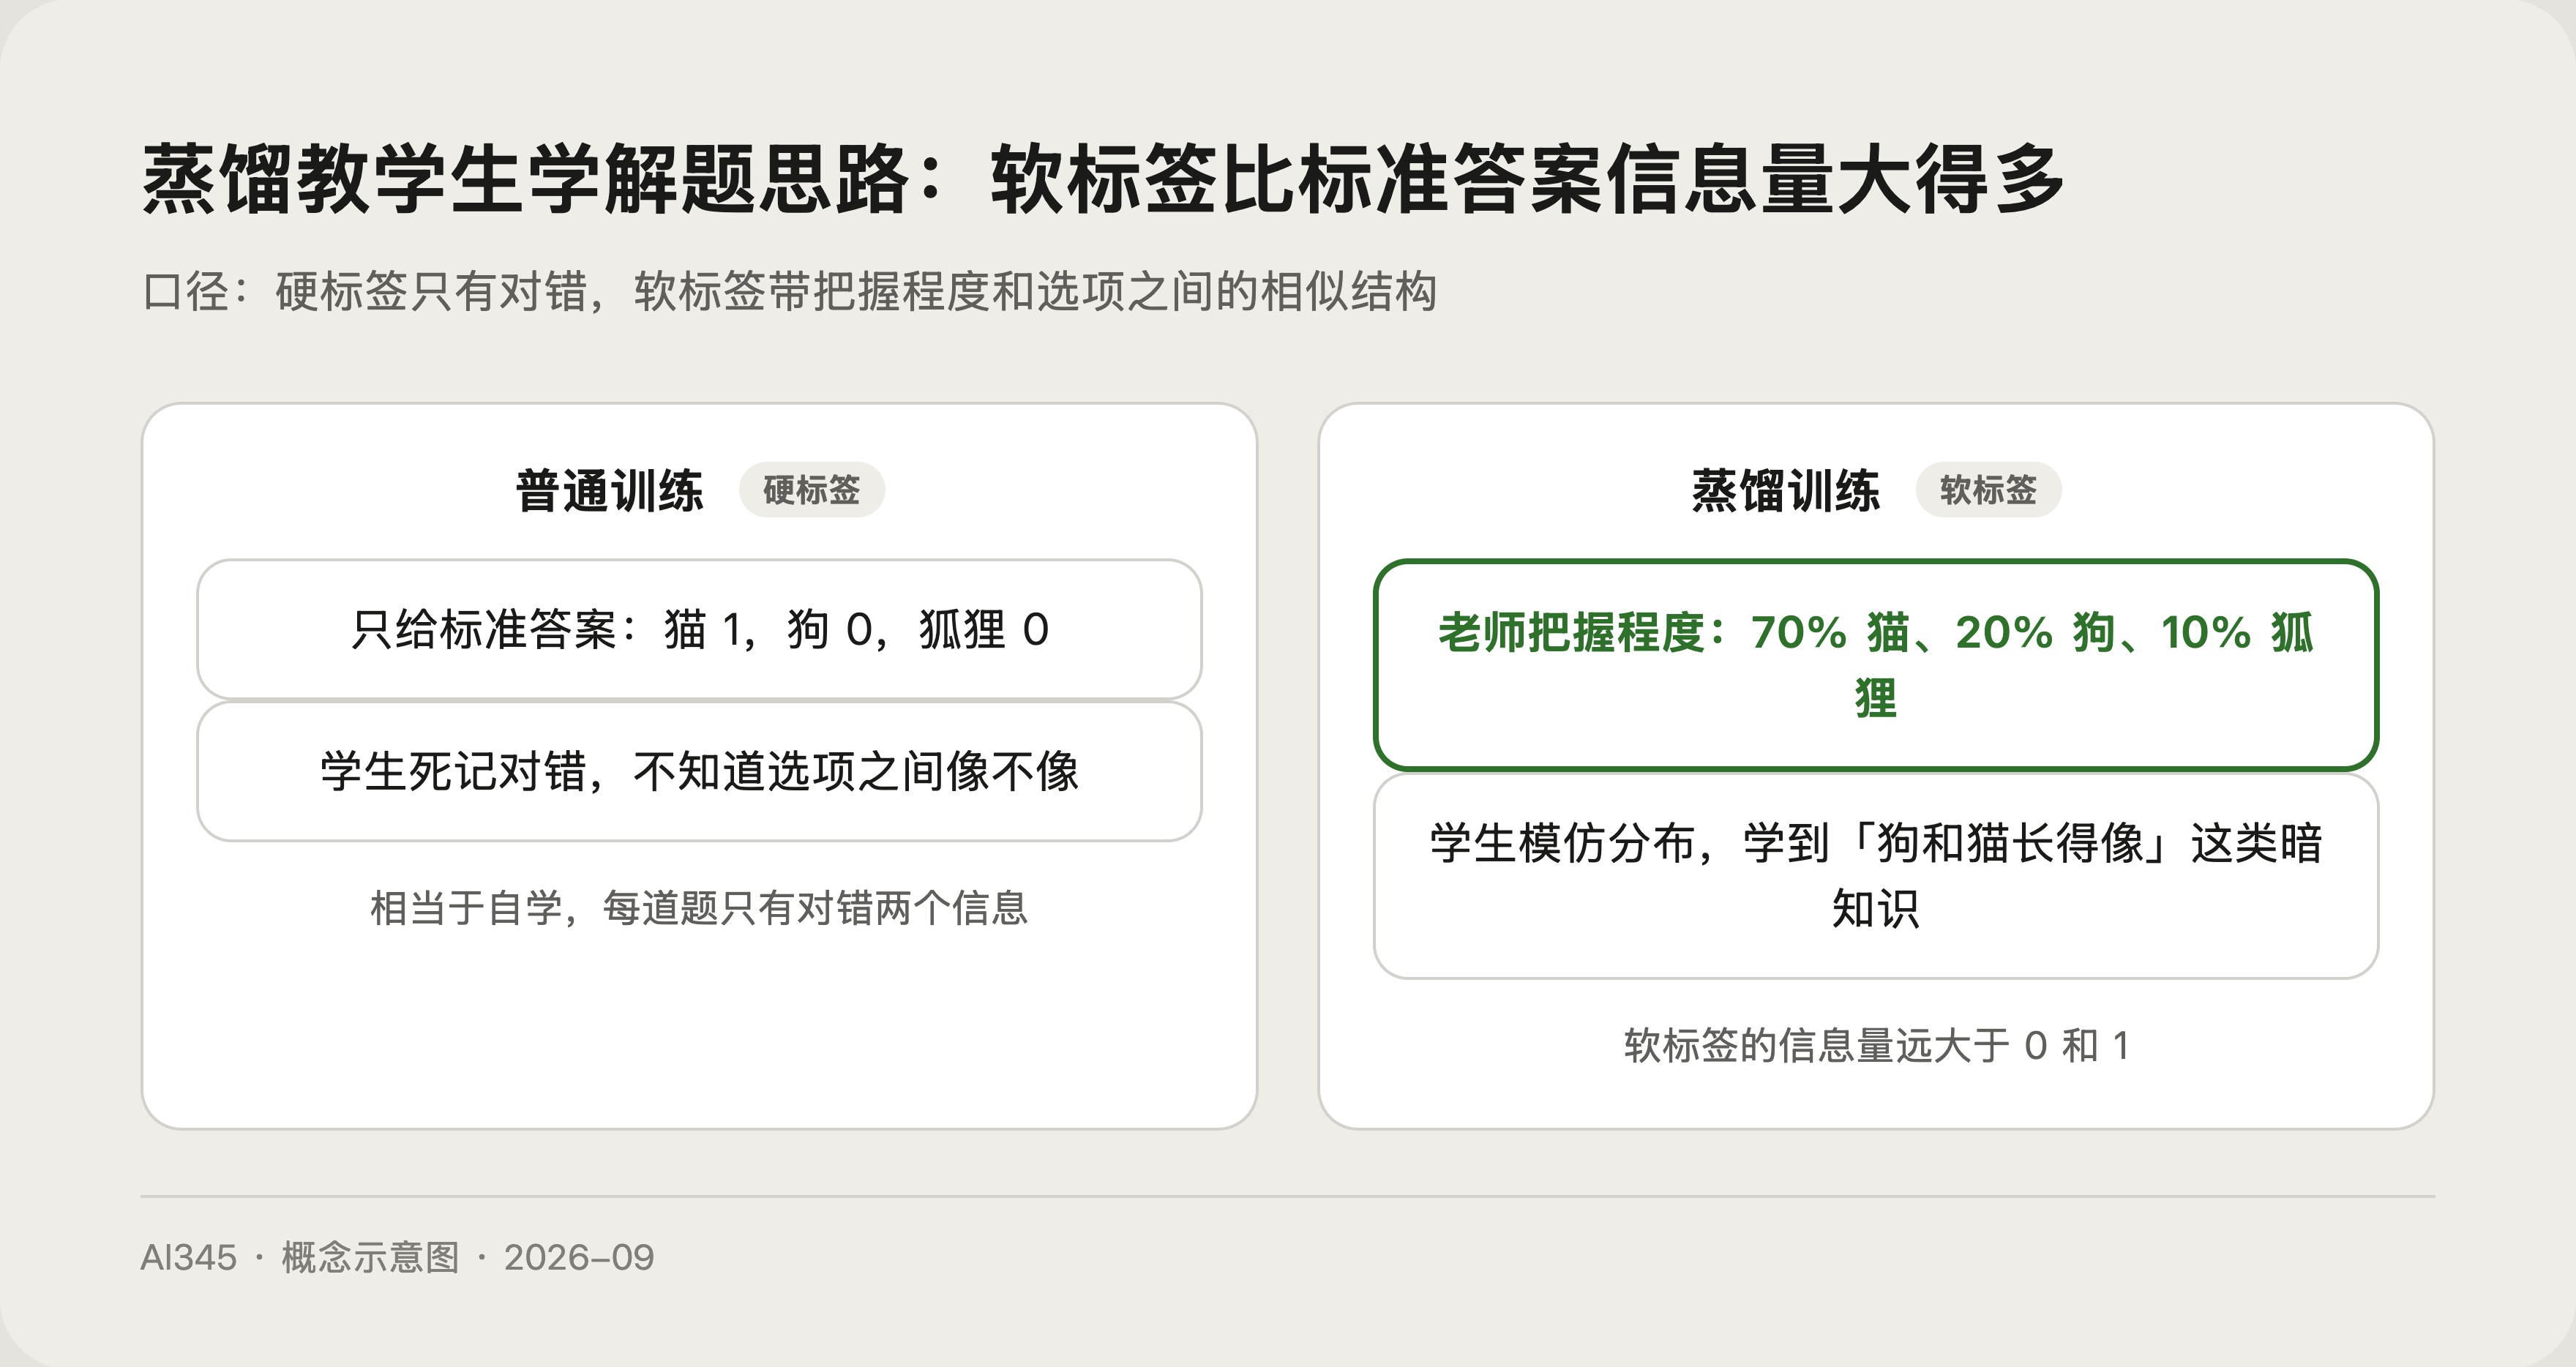
普通训练相当于学生自学:只告诉学生每道题的标准答案,对记 1 错记 0,这类标签叫硬标签。
蒸馏训练相当于老师带教:老师不只给答案,还给出自己的把握程度,比如这道题 70% 像 A、20% 像 B、10% 像 C。这组概率叫软标签,比硬标签信息量大得多:它告诉学生哪些错误选项"长得像对的",也就是答案之间的相似结构。学生照着老师的把握程度去模仿,往往比直接啃标准答案学得更快更好。论文在 MNIST 手写数字等实验上验证了这一点。
为什么端侧模型都用它?
- 算力现实。手机端模型必须塞进几 GB 内存,参数必须小,蒸馏是"小而强"的关键手段,典型代表见站内的《MiniCPM5-2B 是什么?面壁 2B 端侧模型手机部署全解》;
- 老师只出现在训练阶段。老师负责在训练时输出软标签,最终部署的只有学生模型,上线成本大幅下降;
- 行业标配。DeepSeek-R1 的 2025 年 1 月论文就专门展示了把推理模型蒸馏到多个小尺寸模型的做法,这已是开源生态的常规操作。
蒸馏和微调、量化是一回事吗?
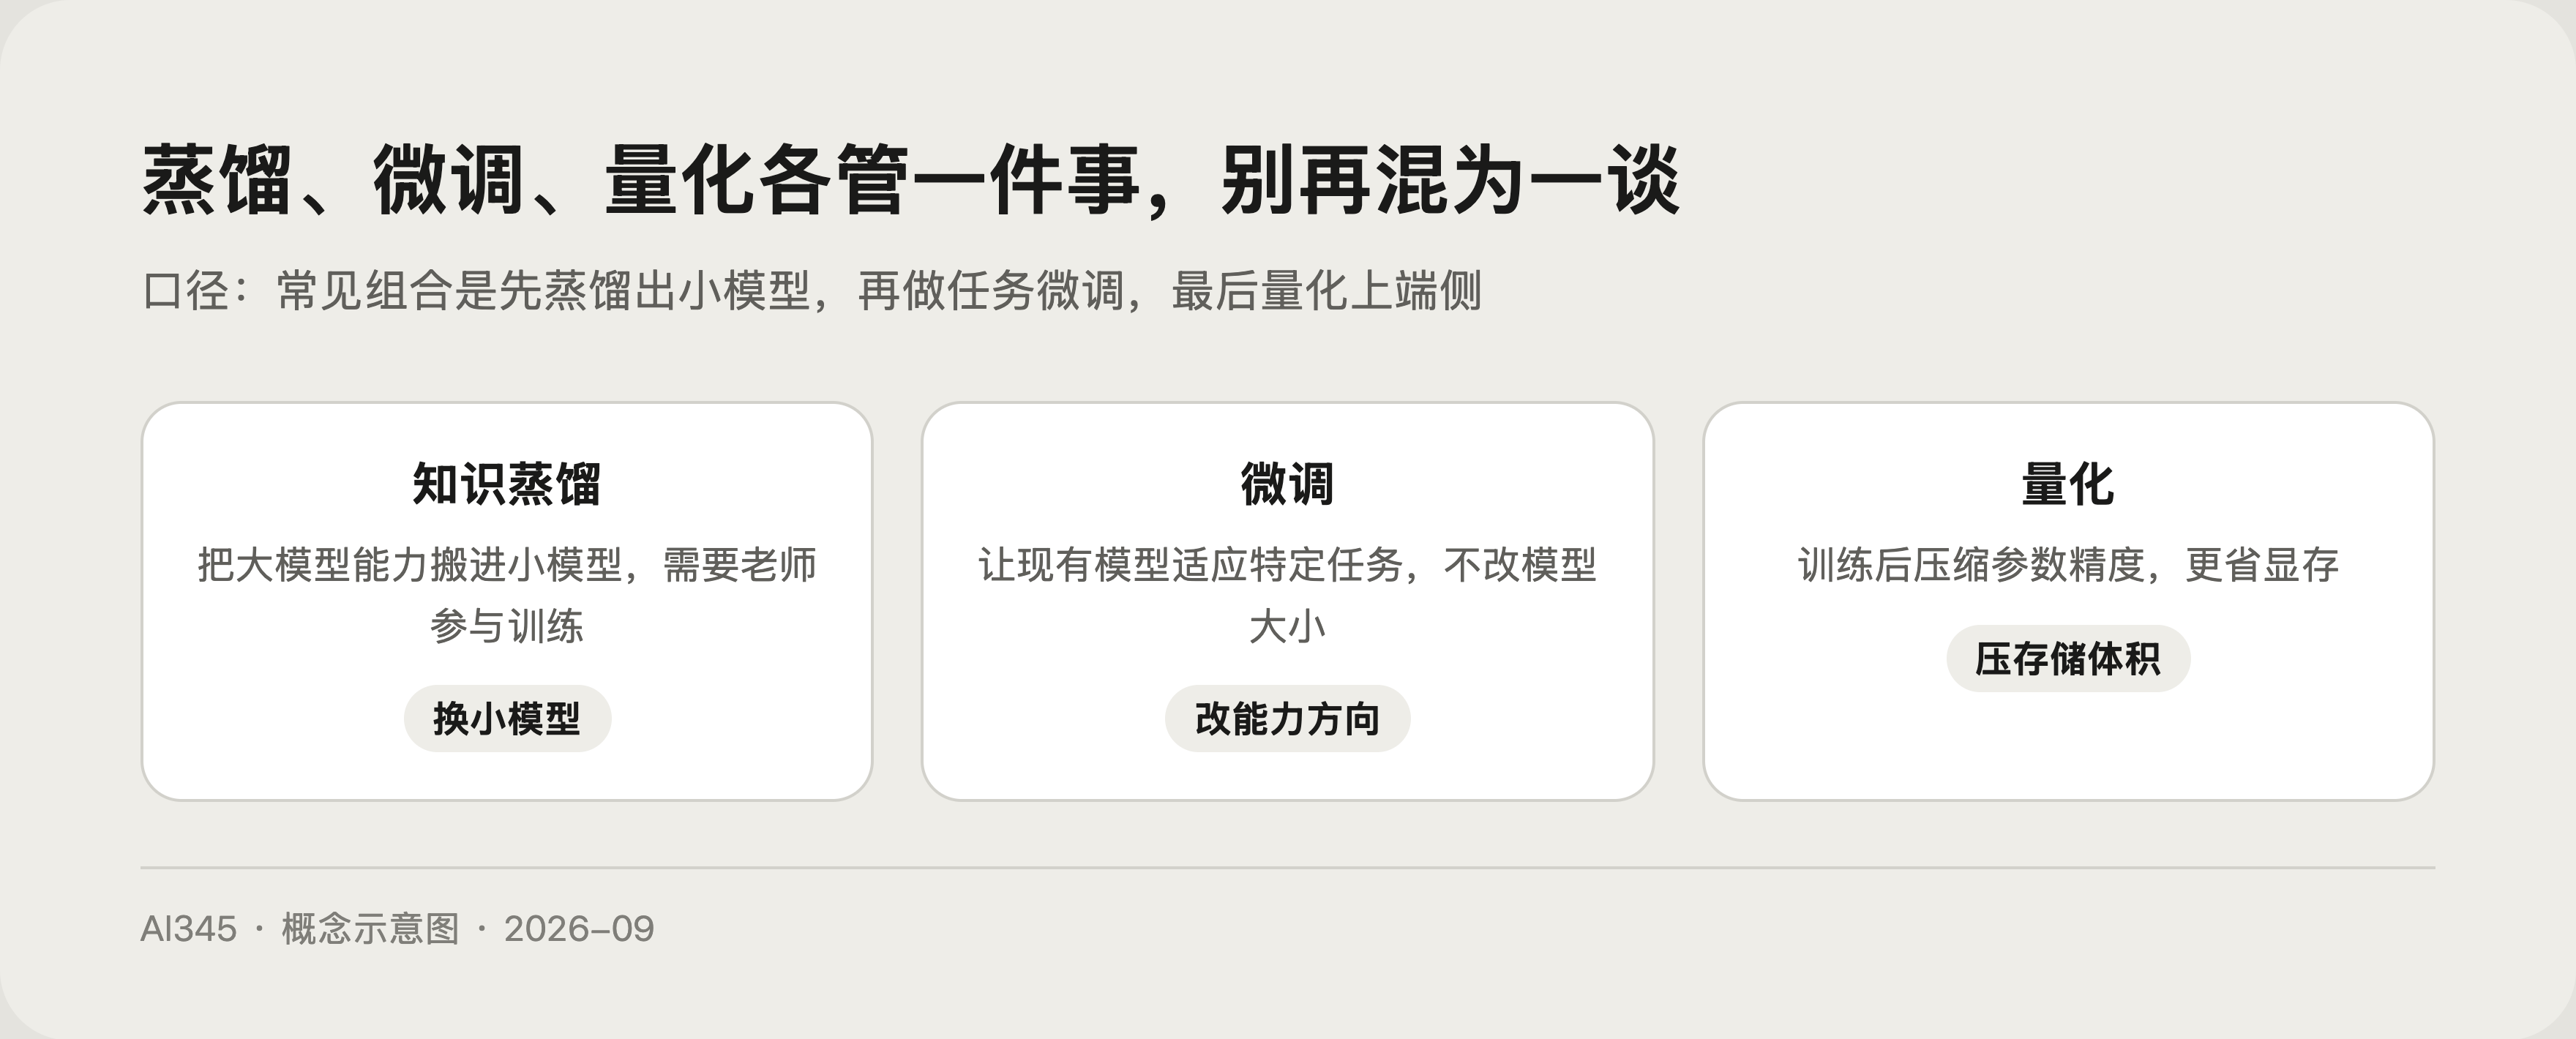
不是,三者解决不同问题。蒸馏解决"把能力搬进小模型",需要老师参与训练;微调解决"让现有模型适应特定任务",不改变模型大小,选型对比可以看站内的《微调是什么?和提示词、RAG 怎么选,一张对比表讲透》;量化解决"把已有模型压得更省显存",是训练后对参数精度的处理。
实践中三者经常组合使用:先蒸馏出小模型,再做任务微调,最后量化后部署到端侧。想了解模型底层的运转方式,配合站内的《大语言模型是怎么工作的》一起看会更顺。
一段话讲清知识蒸馏
照这个口径复述:知识蒸馏是 Hinton 2015 年提出的模型压缩方法。核心思想是用大模型当老师、小模型当学生,学生不学标准答案,而是模仿老师输出的概率分布,也就是软标签,因为软标签包含"哪些选项容易混淆"的暗知识,信息量远大于 0 和 1 的硬标签。它的价值是让小模型拿到接近大模型的效果,部署成本大幅下降,所以端侧模型普遍采用。一句话版本:蒸馏就是让小模型抄大模型的解题思路,不只抄答案。
常见问题
软标签到底是什么?
答:就是老师模型对每个候选答案给出的概率分布。比如判断一张图是猫,硬标签只说"是",软标签会说 90% 是猫、8% 是狗、2% 是狐狸,后者包含类别之间的相似信息。
蒸馏后的学生能超过老师吗?
答:整体上通常不会。不过在特定小任务上,学生可能接近甚至局部超过老师,因为小模型在窄任务上更专注(属于常见的经验观察,非绝对结论)。
大模型时代的蒸馏和传统蒸馏有区别吗?
答:除了模仿概率分布,大模型时代更常见的做法是让老师生成大量高质量训练数据,学生直接在这些数据上学习,R1 论文对 smaller 模型的处理就是这种思路的体现。
端侧模型都是蒸馏出来的吗?
答:不全是。蒸馏之外还有小型架构设计、量化、剪枝等手段,实际产品通常是几种方法的组合。
 京ICP备2024094994号-29