
算力 FLOPS 是什么?3 分钟看懂 TOPS 和显卡跑分
算力 FLOPS 是什么?3 分钟看懂 TOPS 和显卡跑分
FLOPS 是 Floating-point Operations Per Second 的缩写,意思是每秒能完成多少次浮点运算,也就是带小数点的乘加计算。它是衡量算力的通用单位,显卡、手机芯片、超算的算力指标最终都折算成这个数(来源:FLOPS 词条)。
FLOPS 是什么:后厨翻菜谱的速度
把芯片想象成后厨:厨师每翻一页菜谱就能做出一道菜,翻得越快,出菜越多。FLOPS 就是这个后厨"每秒翻页做菜的次数"。
AI 计算几乎全是浮点乘加,所以看一款芯片跑 AI 的潜力,第一眼就看它的 FLOPS 数字。数字越大,理论上每秒能完成的计算越多。
这些数字怎么读:像重量单位一样逐级放大
FLOPS 前面加 K、M、G、T、P,每级乘一千,和重量单位的千进位一模一样:
| 单位 | 每秒运算次数 | 大致对应 |
|---|---|---|
| KFLOPS | 千 | 上古计算器 |
| MFLOPS | 百万 | 早期个人电脑 |
| GFLOPS | 十亿 | 手机 CPU |
| TFLOPS | 万亿 | 游戏显卡、NPU 宣传常用 |
| PFLOPS | 千万亿 | 数据中心集群 |
英伟达 H100 官方页面就标注了 989 teraFLOPS 的算力指标(来源:NVIDIA H100 官方页面),也就是接近一千 TFLOPS 的量级。
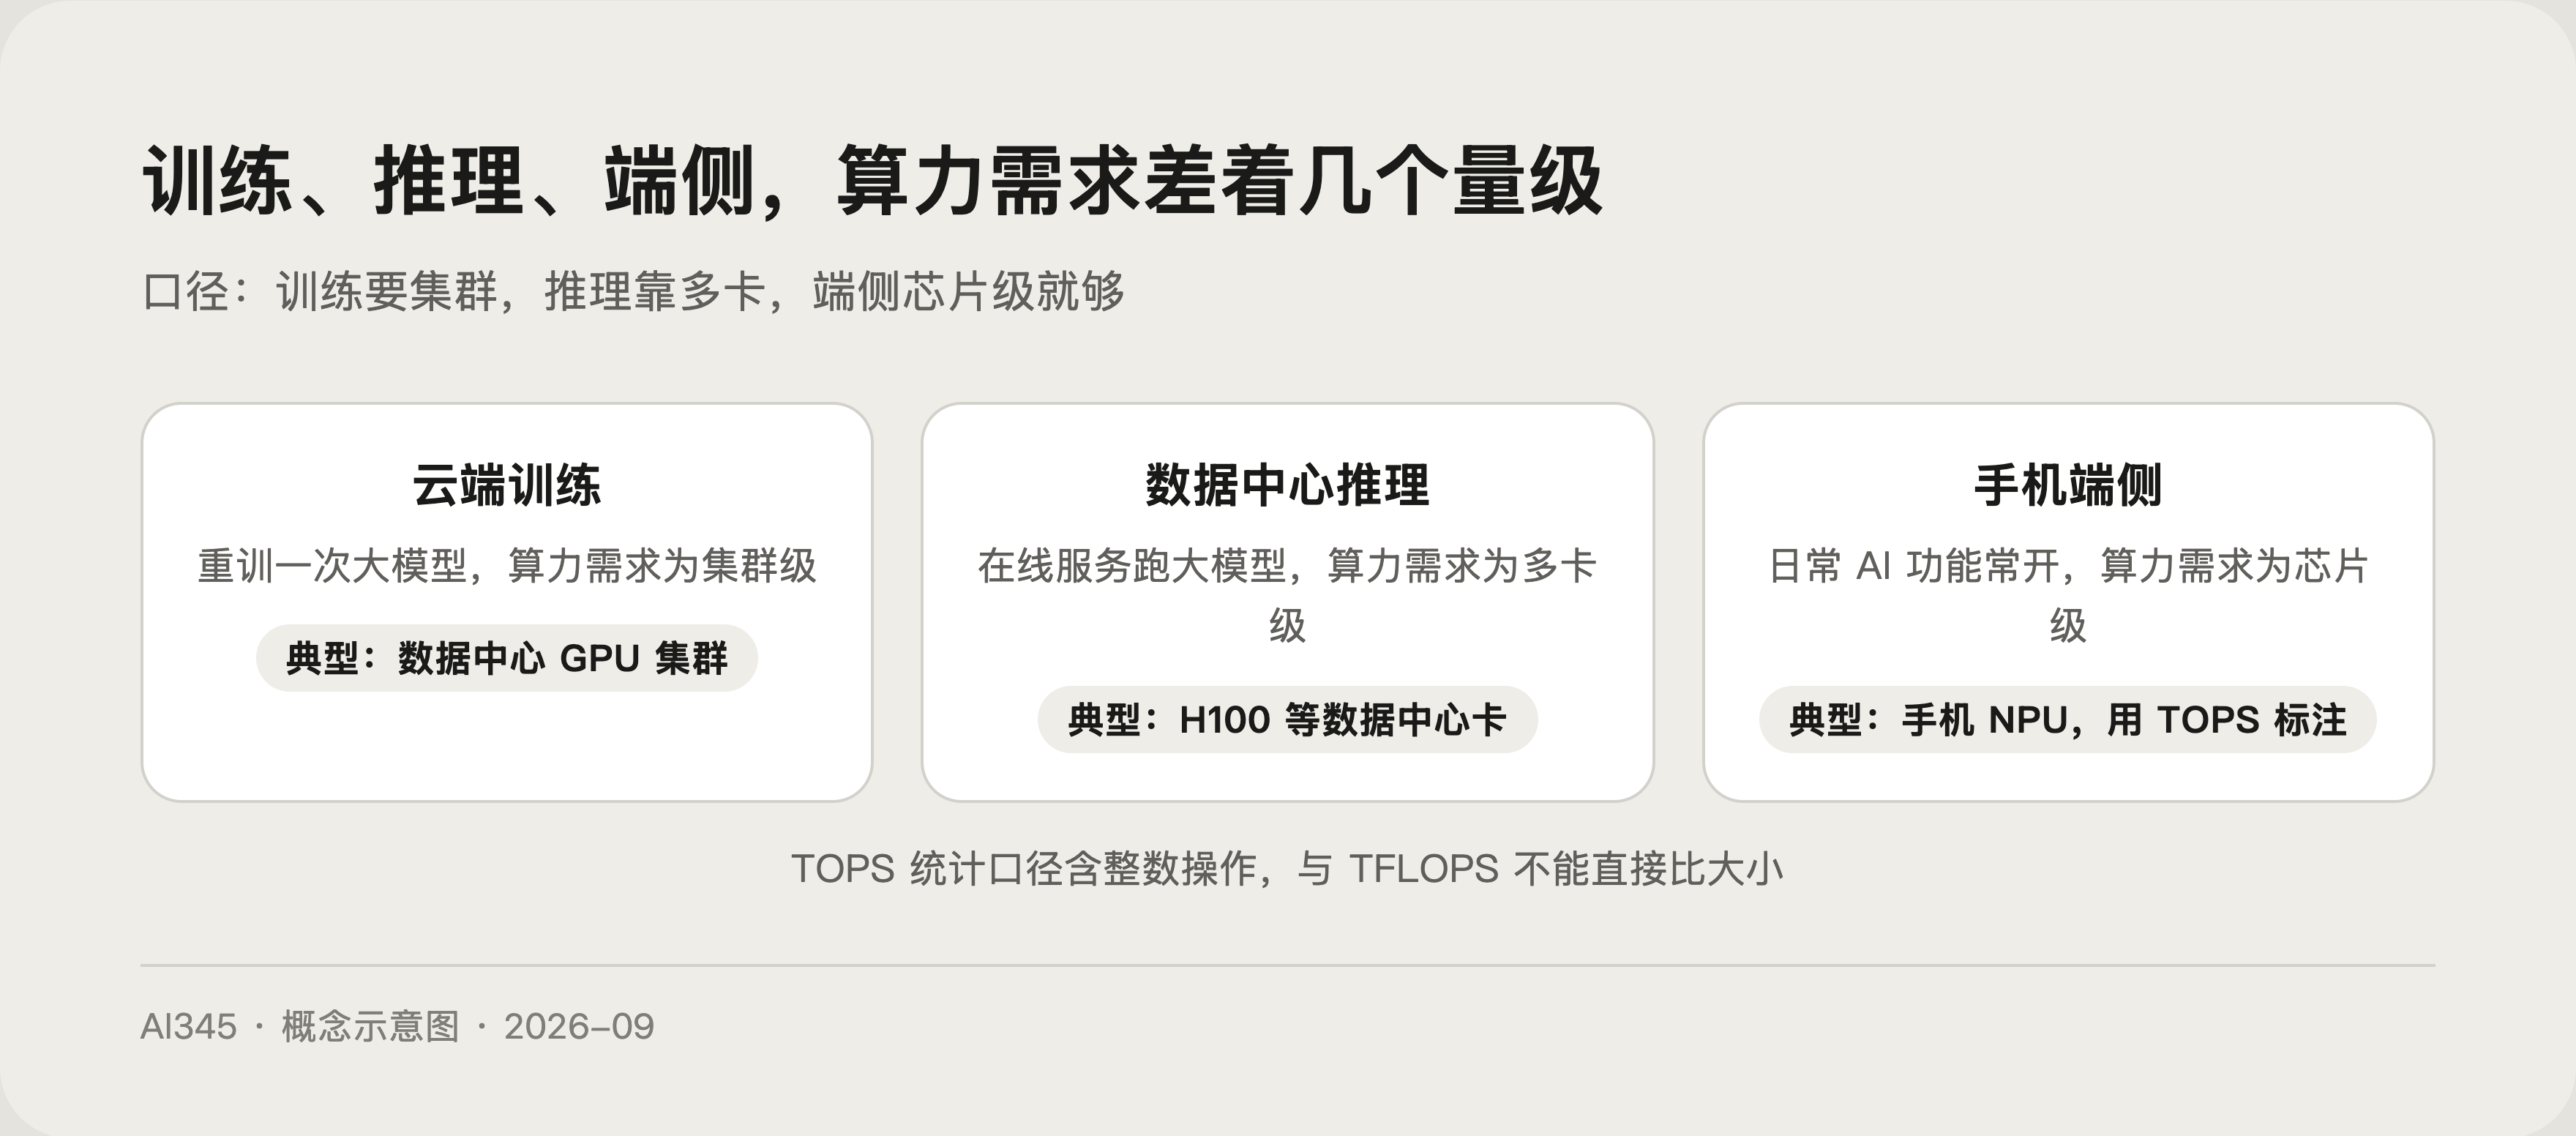
TOPS 是它的兄弟单位:Operations Per Second 统计的"操作"不限于浮点,整数运算也算,所以 NPU 和手机芯片喜欢用 TOPS 标注,数字看起来更漂亮。两种口径不能直接比大小。
多少算力才够跑模型
跑模型和练模型要分开算:
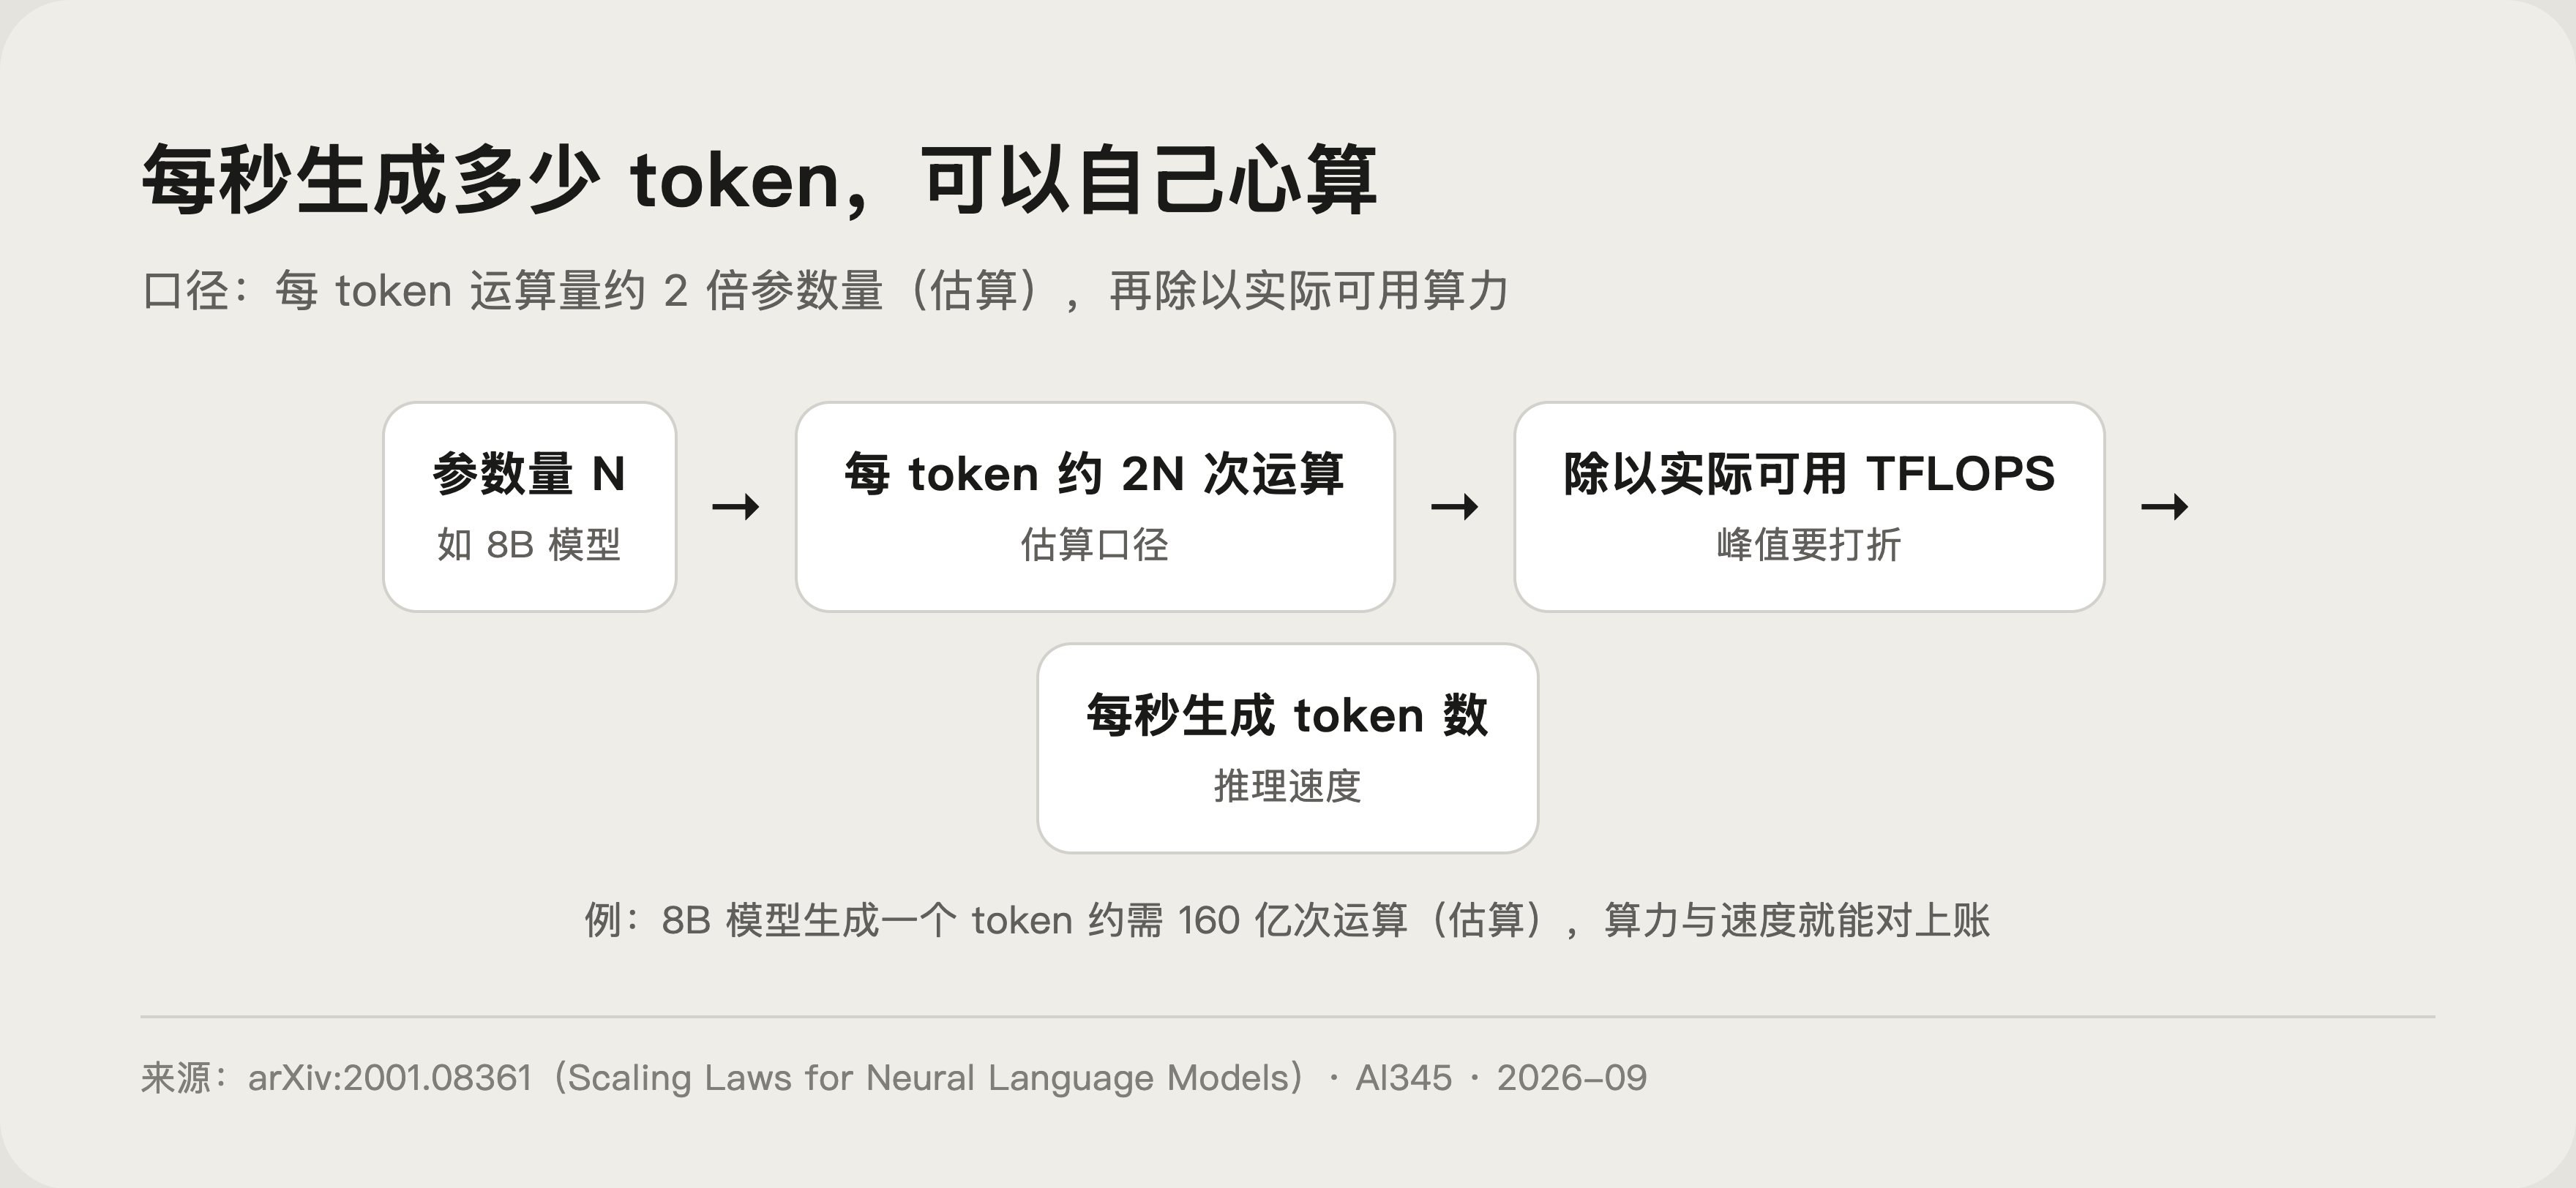
- 推理(跑):经典估算口径是每生成一个 token 约做 2 倍参数量次运算。这个近似来自大模型缩放律研究,卡普兰等人的论文给出训练算力约为 6 倍参数量乘数据量,推理可粗略按 2 倍参数量估算(来源:Scaling Laws for Neural Language Models)。举例:8B 模型生成一个 token 约需 160 亿次运算(估算)。
- 训练(练):按 6 倍参数量乘训练数据量估算,头部大模型的总算力达到 10 的 23 次方到 25 次方 FLOPs 量级,只有数据中心集群扛得住。
举个直观的账:一张几十 TFLOPS 的显卡,理论上每秒完成几十万亿次运算,除以 8B 模型每个 token 160 亿次的需求,再考虑实际利用率打个三到五折(估算),每秒生成几十个 token 就是合理预期。算力和速度的关系,到这里就能自己心算了。
想自己动手跑开源模型的读者,可以接着看盘古 2.0 本地部署教程,里面按显存档位拆了三条路线。
显卡跑分和真实体验为什么差那么远
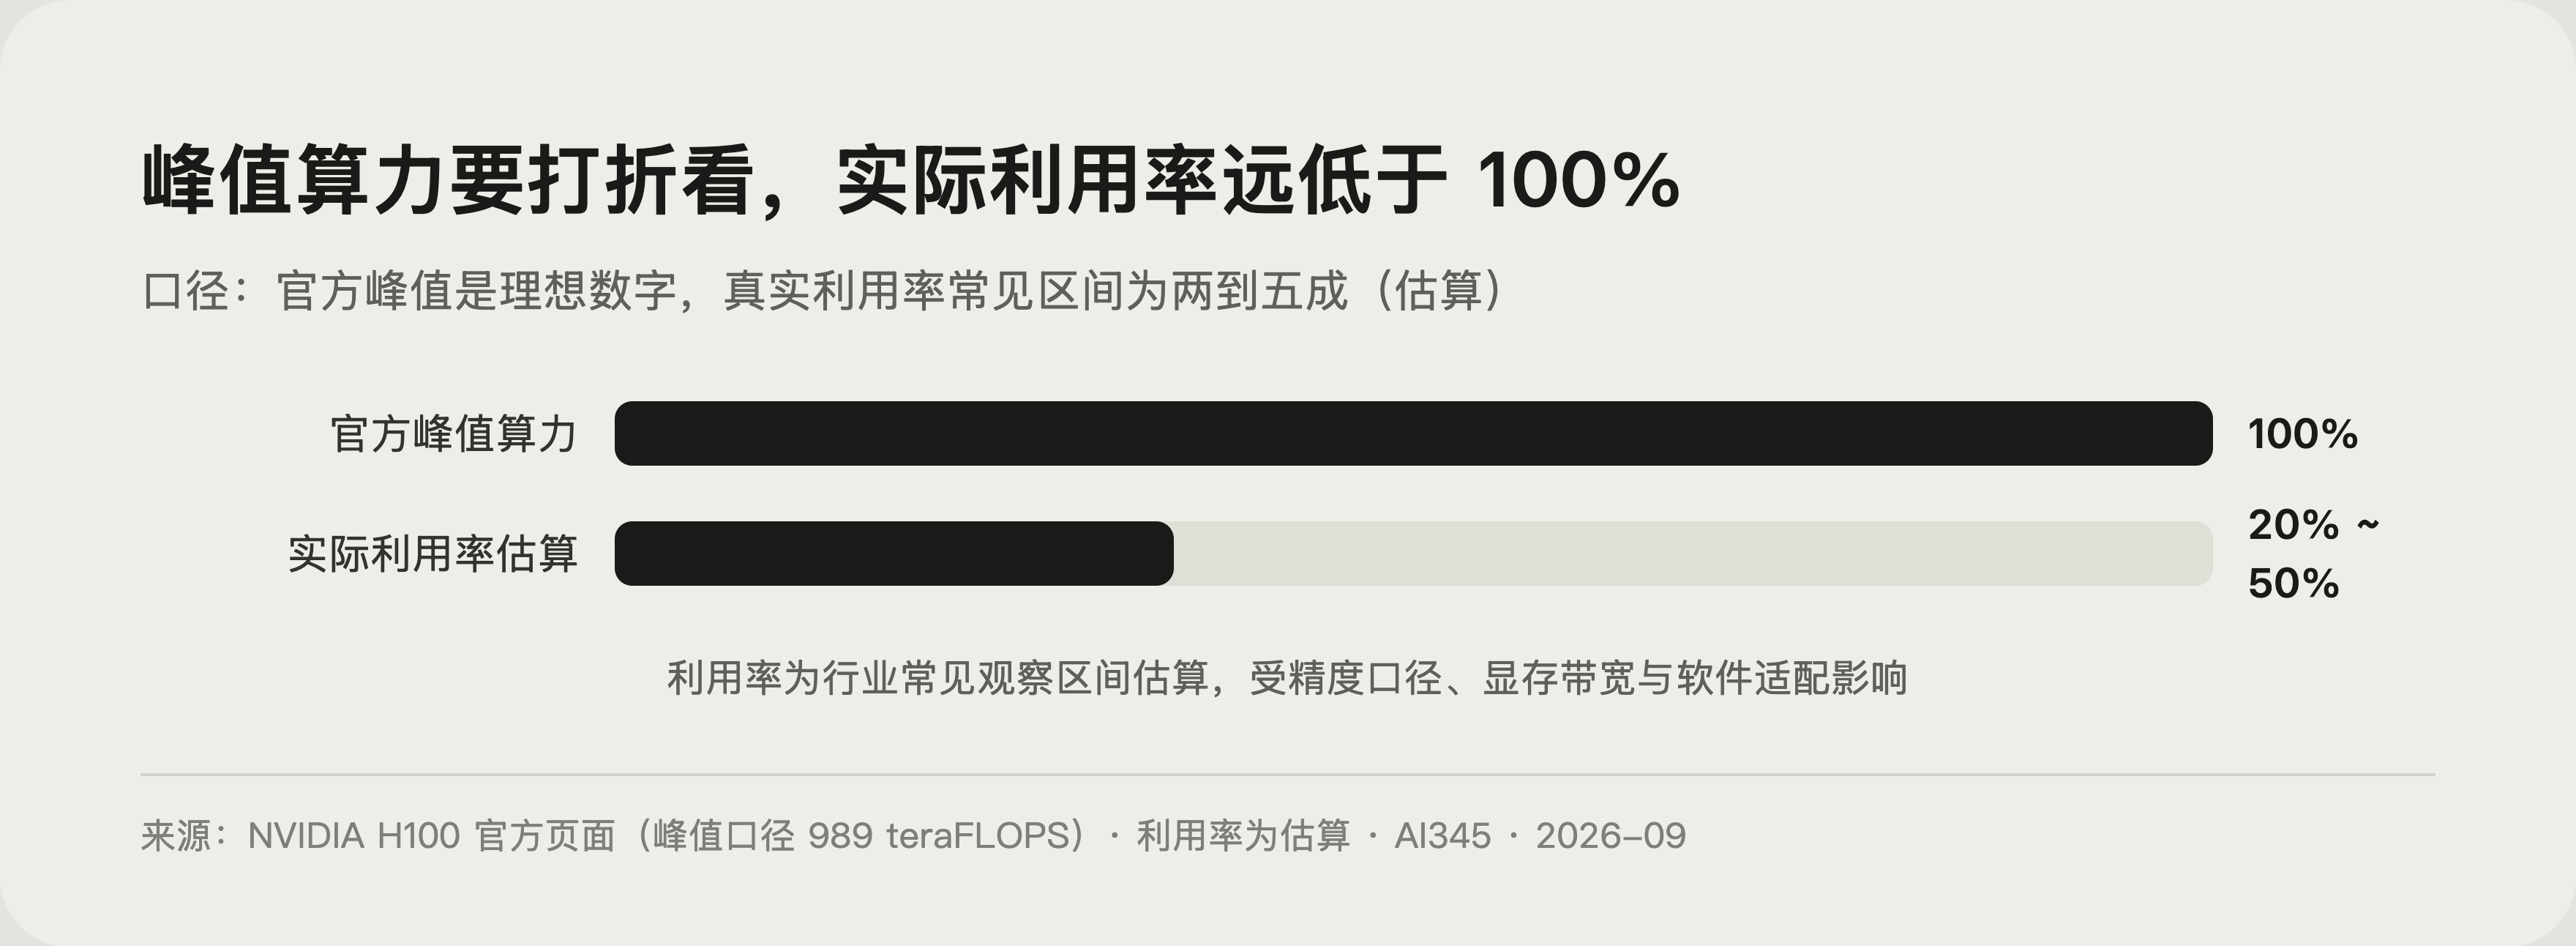
- 峰值是理想数字:官方标注的是理想条件下的峰值,实际训练和推理的利用率通常远低于此,行业常见的观察区间在两到五成之间(估算)。
- 口径有脚注:数字按什么精度统计、是否包含稀疏加速,都会让同一张卡差出一倍,看跑分先看脚注。
- 瓶颈不止算力:显存容量和带宽、软件栈适配,同样决定模型能不能跑起来、跑得快不快。只看 FLOPS 买卡,容易买回来跑不动想跑的模型。
芯片厂商也清楚峰值利用率的问题,所以提高"每瓦有效算力"成了新方向:OpenAI 在自研推理芯片(跑分解读见这里),架构层面也有用更小参数量换取等效算力的探索(Looped Transformer 解读)。
评价一张卡或一颗芯片,看的都是实际表现而不只是纸面数字,新卡的流出跑分同理(小米 MiMo V3 跑分事件)。把峰值、功耗和实测量级放在一起对照,结论会比单个大数字可靠得多。
一个容易踩的误区:算力高不等于跑得快
算力之外还有一条木桶短板:显存带宽。计算核心再快,数据供不上也只能空转,所以很多算力标称相近的卡,跑同一个模型的速度能差出一截。
判断时可以把三个数字放一起看:峰值算力决定上限,显存带宽决定实际喂得多饱,显存容量决定能不能跑。三者取短板,才是你真实能得到的速度。
一段话讲清算力 FLOPS
可以背这个口径:
FLOPS 是每秒浮点运算次数,是算力的通用单位,常用量级到 TFLOPS 和 PFLOPS;NPU 场景常用 TOPS,统计口径包含整数操作,两者不能直接比。跑模型的推理算力可按每个 token 约 2 倍参数量粗估,训练则约为 6 倍参数量乘数据量。显卡宣传的是峰值 FLOPS,真实体验还受利用率、显存带宽和精度口径影响,所以跑分要打折看。
常见问题
FLOPS 和 FPS 有什么区别?
答:FLOPS 衡量芯片每秒运算次数,FPS 衡量画面每秒帧数。前者是算力指标,后者是显示指标,完全两码事。
TOPS 数字为什么看起来比 TFLOPS 大?
答:TOPS 统计所有运算操作,包括整数运算,口径更宽,不能和 TFLOPS 直接换算比较。
买显卡跑 AI 只看 FLOPS 够吗?
答:不够。显存容量和带宽往往是更硬的门槛,模型装不进显存,算力再高也跑不起来。
手机芯片标注的几十 TOPS 能跑大模型吗?
答:TOPS 只是 NPU 峰值,能跑多大模型还要看内存带宽、发热和软件支持,端侧实际多以小模型为主。
同样的卡跑同一个模型,速度为什么差别大?
答:量化精度、上下文长度、批处理大小和框架优化都会影响利用率,纸面算力相同不代表实际速度相同。
 京ICP备2024094994号-29