
深度学习是什么?深度深在哪,3 分钟看懂 AI 起飞
深度学习是机器学习的一个分支,用层数很深的多层神经网络,自动从数据里学习特征。深度既指网络层数多,也指它学到的特征一层比一层抽象。你今天听到的大模型、自动驾驶、人脸识别,背后都是深度学习;而它真正起飞的转折点,是 2012 年。
深度到底深在哪
深度学习常被说得玄,其实“深”有三层含义。
- 层数深:网络由很多隐藏层堆叠而成,信息逐层往上走。
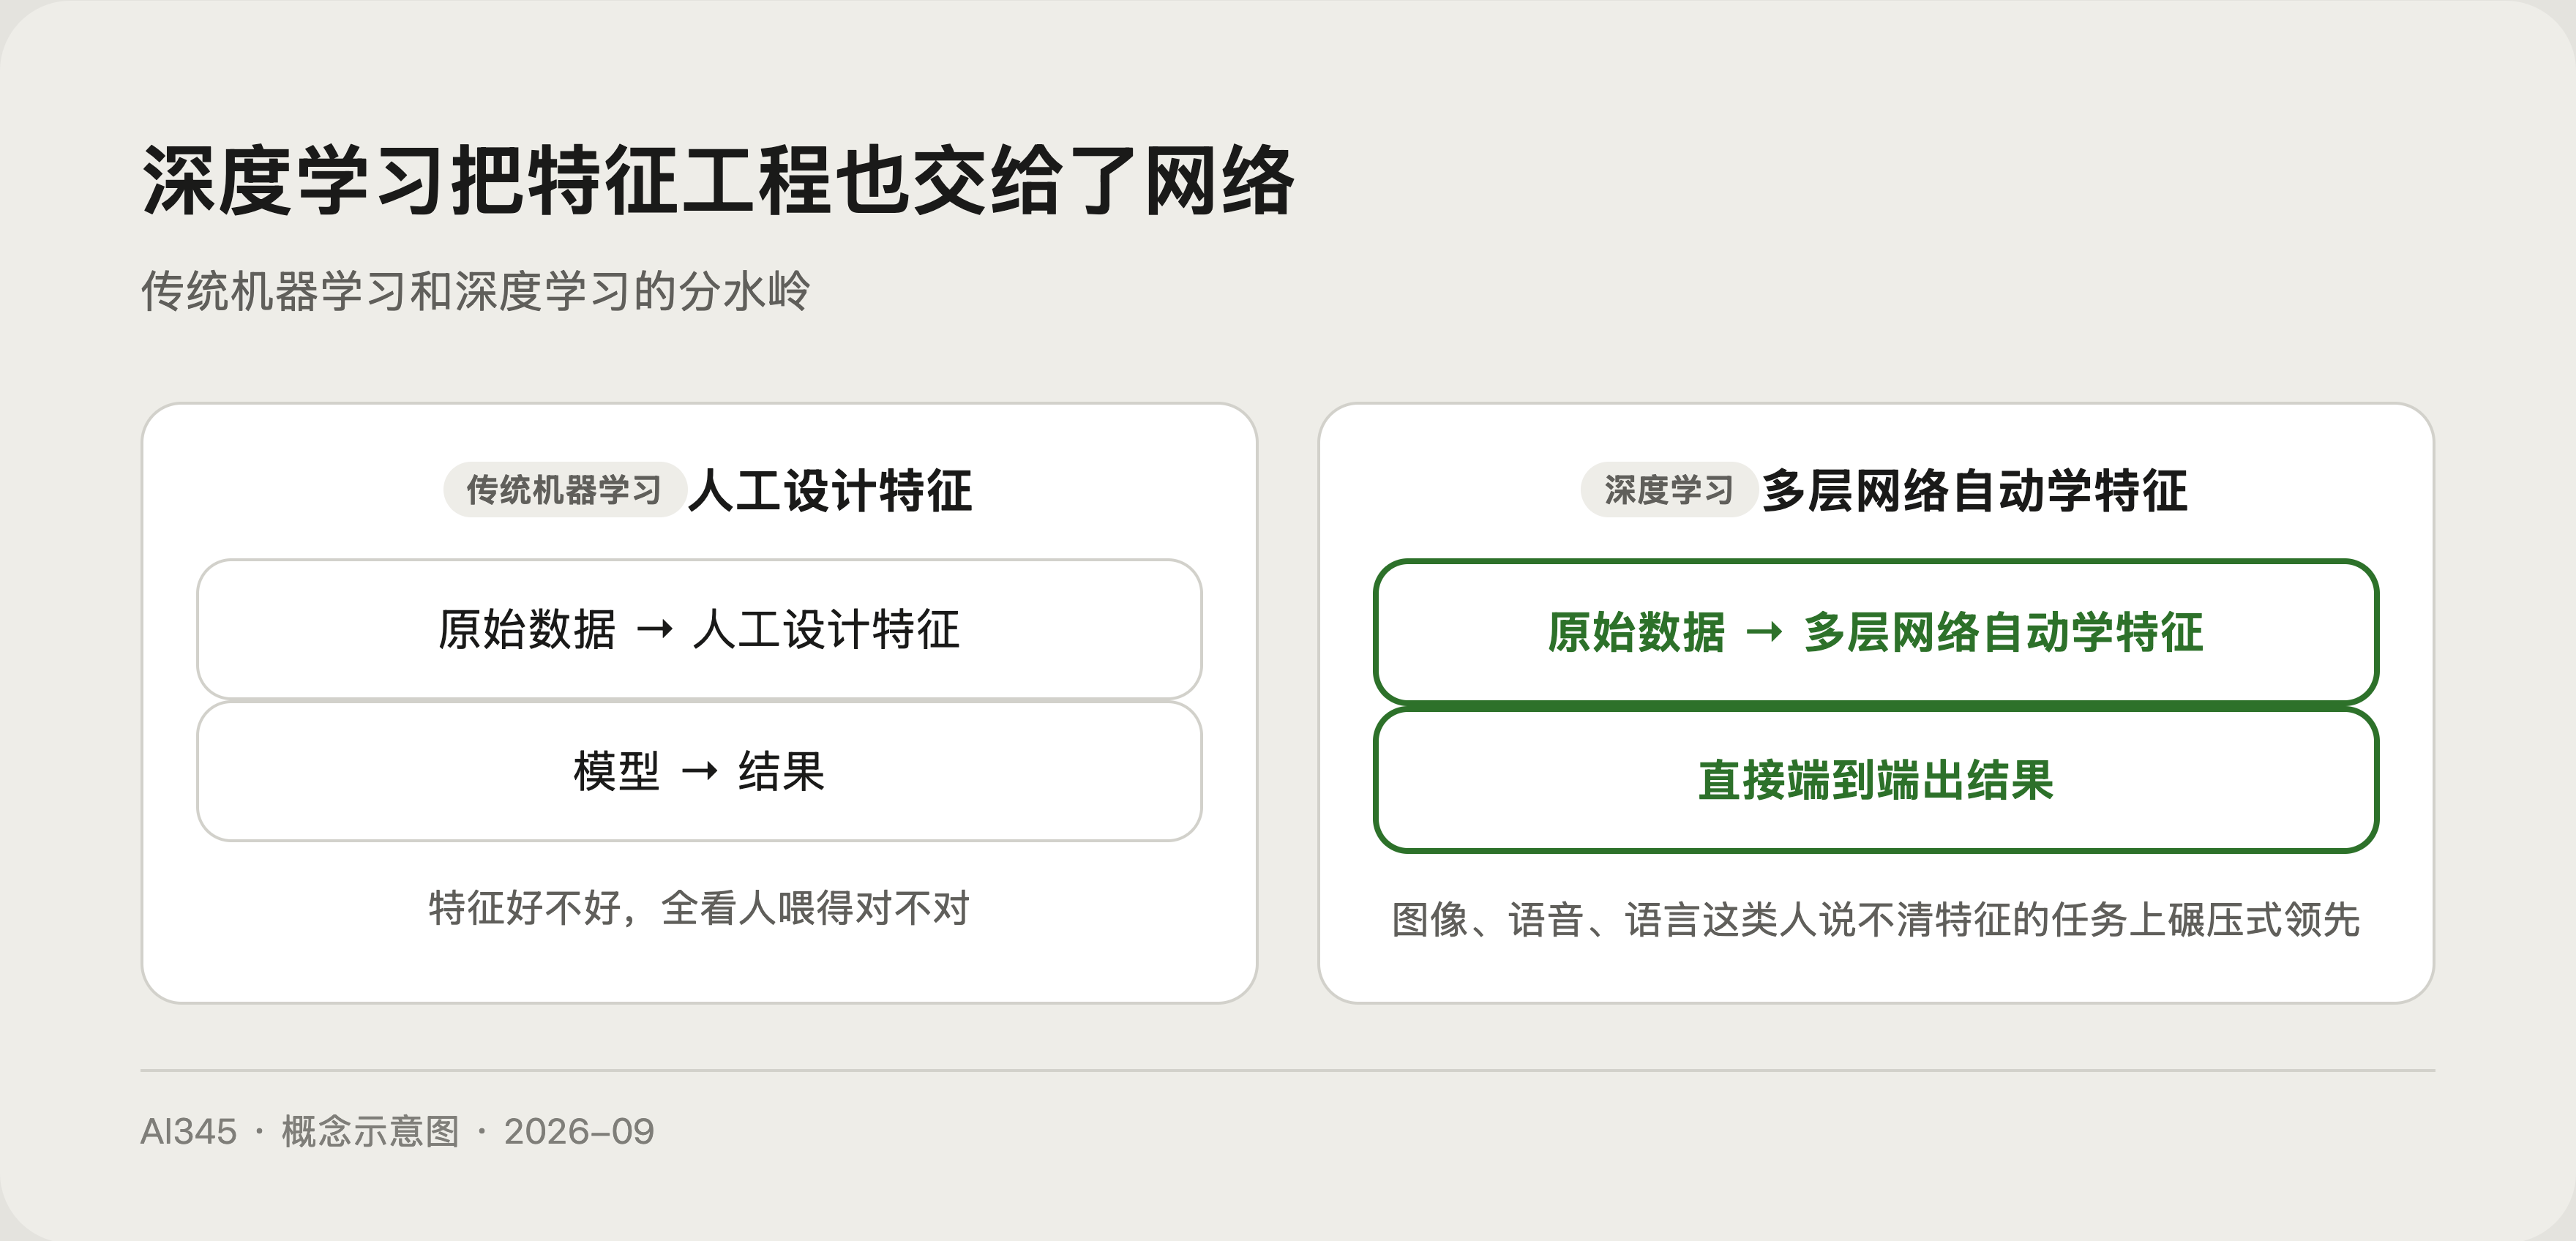
- 特征自动学:传统机器学习要工程师手工设计特征,深度学习把这一步也交给网络自己,端到端直接从原始数据学到结果。
- 依赖深:它极度吃数据和算力,没有海量样本和 GPU,深网络根本跑不动。
打个游戏的比方:传统机器学习像手动练级,每升一级都要人工喂装备(设计特征);深度学习像闯多层关卡,关卡越多,能拿到的本事越高级,而且装备是它自己打出来的。
为什么 2012 年之后 AI 突然变强
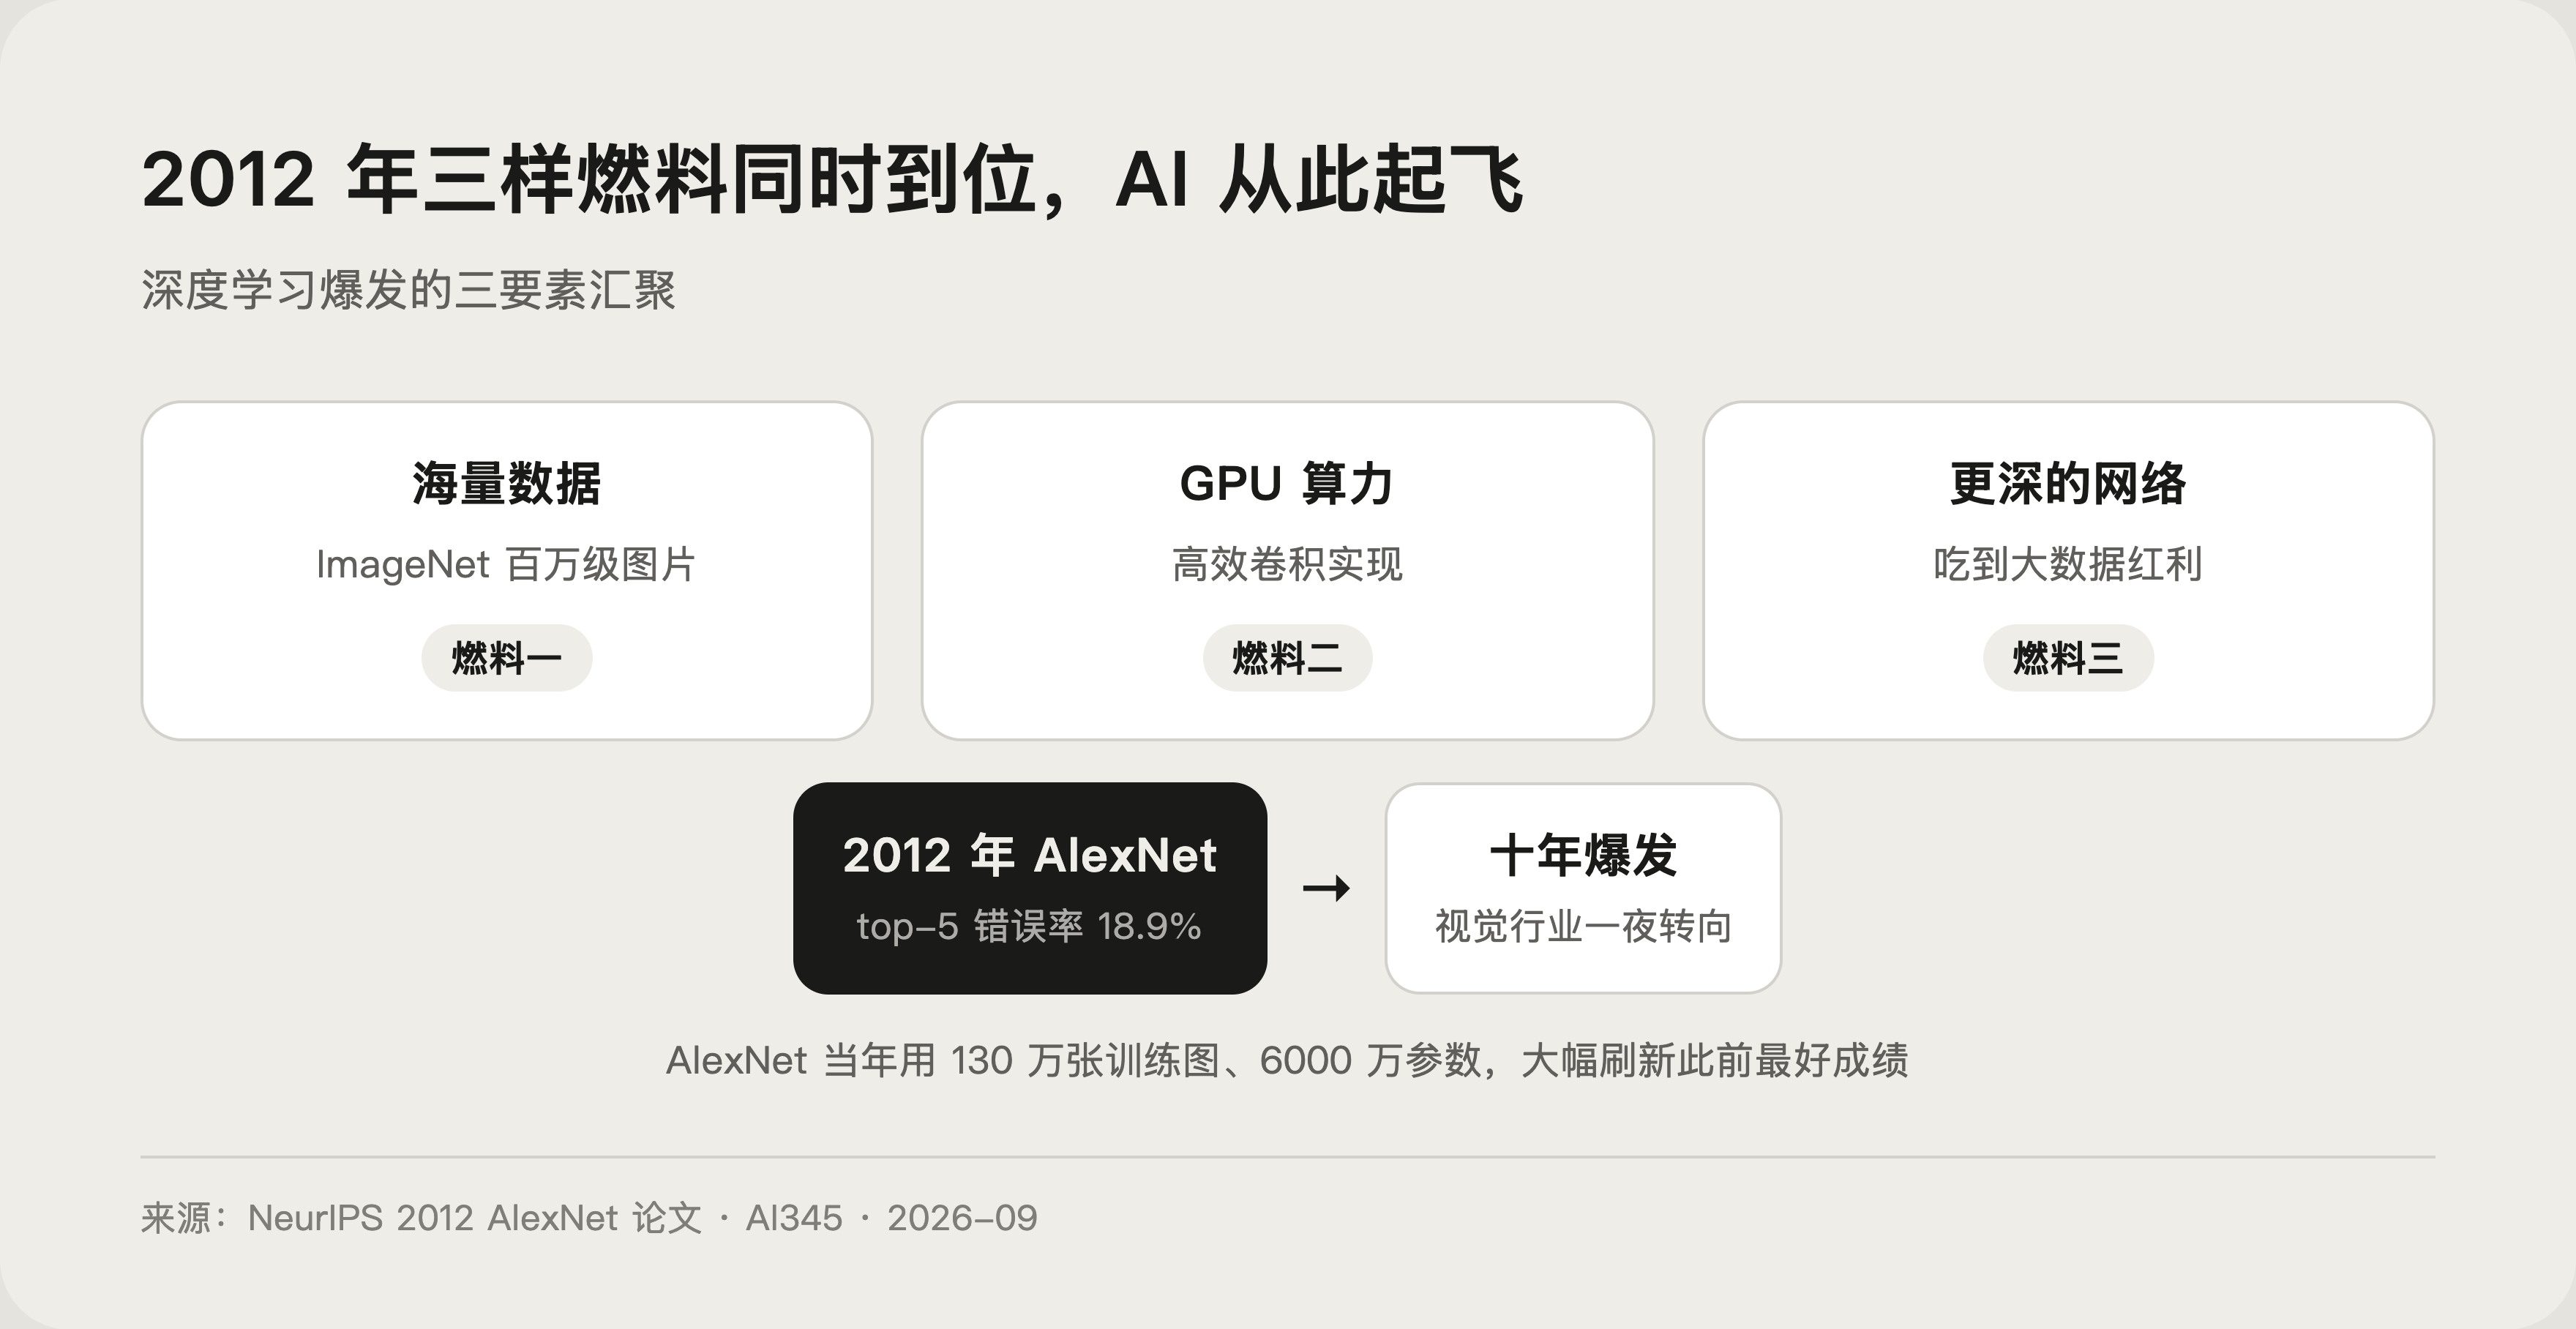
深度学习的思想并不新,神经网络几十年前就有了,它缺的是三样燃料。2012 年,三样燃料同时到位。
- 数据:ImageNet 提供了百万级标注图片,论文里直接用了 130 万张高分辨率训练图。
- 算力:GPU 让训练大网络成为可能,AlexNet 论文明确使用了高效的 GPU 卷积实现。
- 网络:层数够深、设计得当的网络架构终于吃到了大数据红利。
实证就在当年的论文里:AlexNet 拥有 6000 万参数、5 层卷积加 2 层全连接,在 ImageNet 上把 top-5 错误率做到了 18.9%,显著好于此前所有最好成绩(见 NeurIPS 2012 论文原文)。这一年被后人称为“ImageNet 时刻”,计算机视觉整个行业从传统方法一夜转向深度学习。
IBM 的知识体系也把深度学习单列为机器学习下靠神经网络驱动的重要分支(见 IBM Deep Learning)。
和机器学习是什么关系
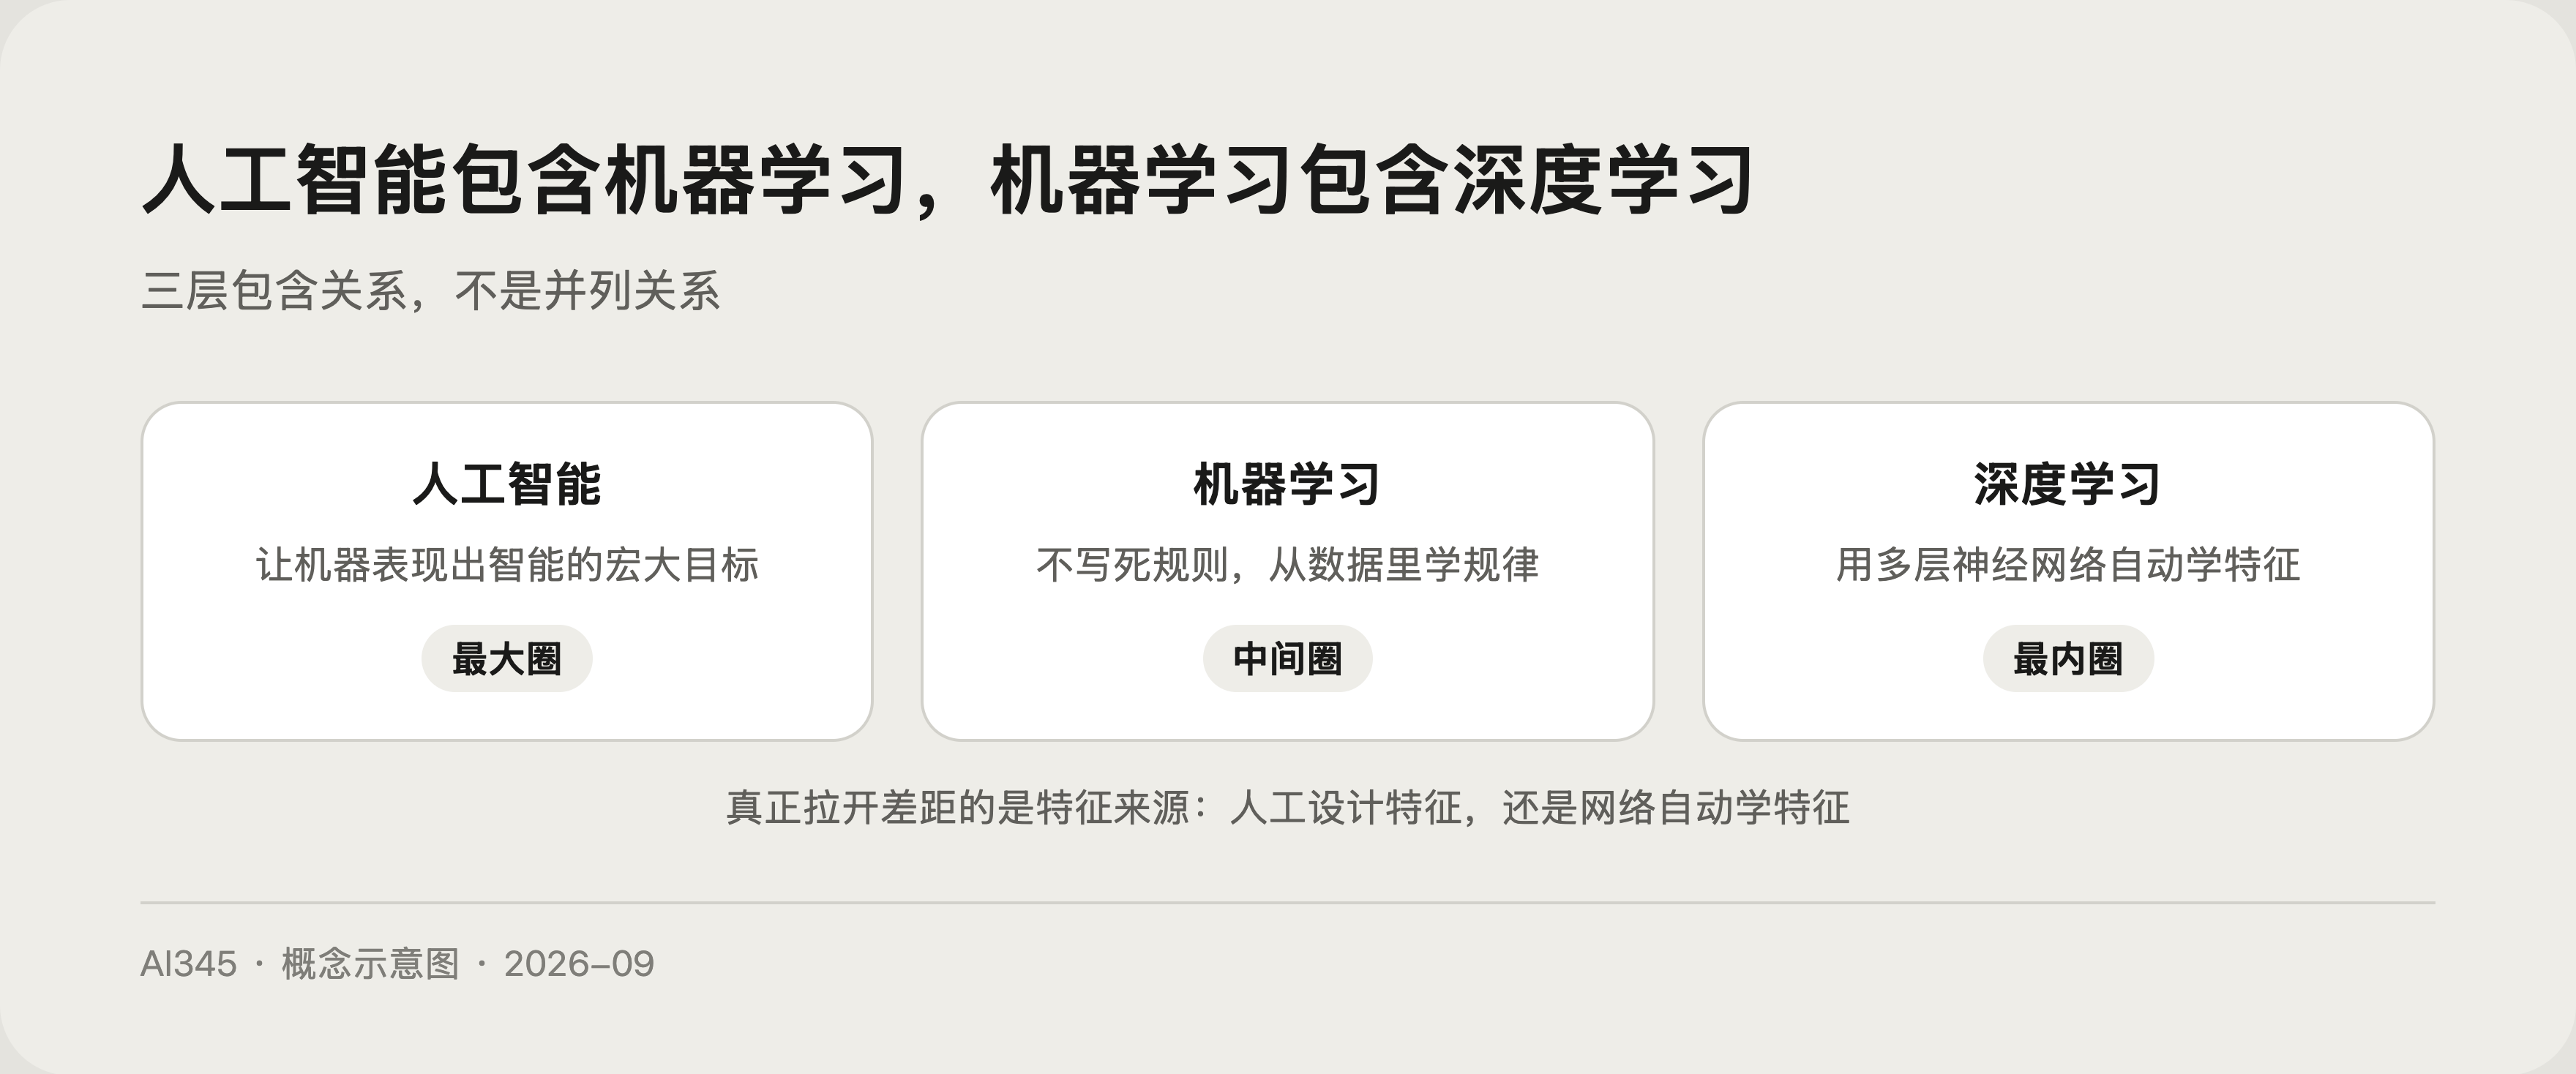
包含关系,不是并列关系:人工智能包含机器学习,机器学习包含深度学习。
- 人工智能:让机器表现出智能的宏大目标。
- 机器学习:不写死规则,让机器从数据里学规律的方法总称。
- 深度学习:机器学习里用深层神经网络、自动学特征的那一支。
真正拉开差距的是特征来源:传统机器学习的成败很大程度取决于人喂的特征好不好,深度学习把特征工程自动化了,所以在图像、语音、语言这类“人说不清特征长什么样”的任务上碾压式领先。
深度学习的边界
它不是万能药。第一,数据少的小任务上,传统方法往往更好用;第二,训练贵、推理也重,成本是实打实的门槛;第三,深网络是黑盒,出了错不容易解释,在强合规场景要先掂量。
一段话讲清深度学习
深度学习是机器学习的分支,用多层神经网络自动从数据中学习特征,替代了传统方法的人工特征工程。深度既指层数深,也指特征逐层抽象、端到端学习。它在 2012 年爆发,因为 ImageNet 百万级数据、GPU 算力和更深的网络架构三件事同时到位,AlexNet 把 ImageNet 错误率大幅压到此前无法企及的水平。关系上,AI 包含机器学习,机器学习包含深度学习;今天的 ChatGPT 等大模型就是深度学习在 Transformer 架构上的最新形态。
从这里接着往下学
深度学习是一条树干,往语言方向长出了大语言模型,往下分叉是具体机制。建议按这个顺序读:大语言模型是怎么工作的 讲清树干上最新果实,Transformer 是什么?图解 AI 大脑的工作原理 讲透底层架构。
接着用 预训练是什么?大模型是怎么练出来的 看完训练全过程,最后用 强化学习是什么?从 AlphaGo 到 ChatGPT 补上对齐这一环。
常见问题
深度学习和机器学习有什么区别?
答:机器学习是大类,深度学习是其中用深层神经网络的分支。最大差别在特征:传统方法靠人工设计特征,深度学习让网络自动学特征,端到端出结果。
为什么深度学习偏偏在 2012 年起飞?
答:因为三要素同时到位:ImageNet 百万级标注数据、成熟的 GPU 训练方案、适合大数据的深网络架构。AlexNet 当年大幅刷新纪录,整个行业随即转向。
神经网络和深度学习是一回事吗?
答:不是。神经网络是模型结构,深度学习特指用很多层(深)的神经网络做学习的方法。层数浅的网络不算深度学习。
ChatGPT 属于深度学习吗?
答:属于。大语言模型是基于 Transformer 的超大规模深度神经网络,在海量文本上训练,是深度学习最新、最出圈的成果。
深度学习需要很多数据吗?小公司用得起吗?
答:从头训练确实需要海量数据和巨额算力,但常见做法是拿现成预训练模型做微调或直接调用 API,小团队低成本用上深度学习完全可行。
 京ICP备2024094994号-29