
AGI 是什么?一次讲透通用人工智能的争议
AGI(Artificial General Intelligence,通用人工智能)指能像人一样跨领域学习、解决各种问题的 AI。它离我们还有多远?目前没有任何权威结论,因为连「怎么才算 AGI」都还没吵出结果。本文讲清各家的定义和争议到底在哪。
先把概念放准:AGI 和现在的 AI 差在哪?
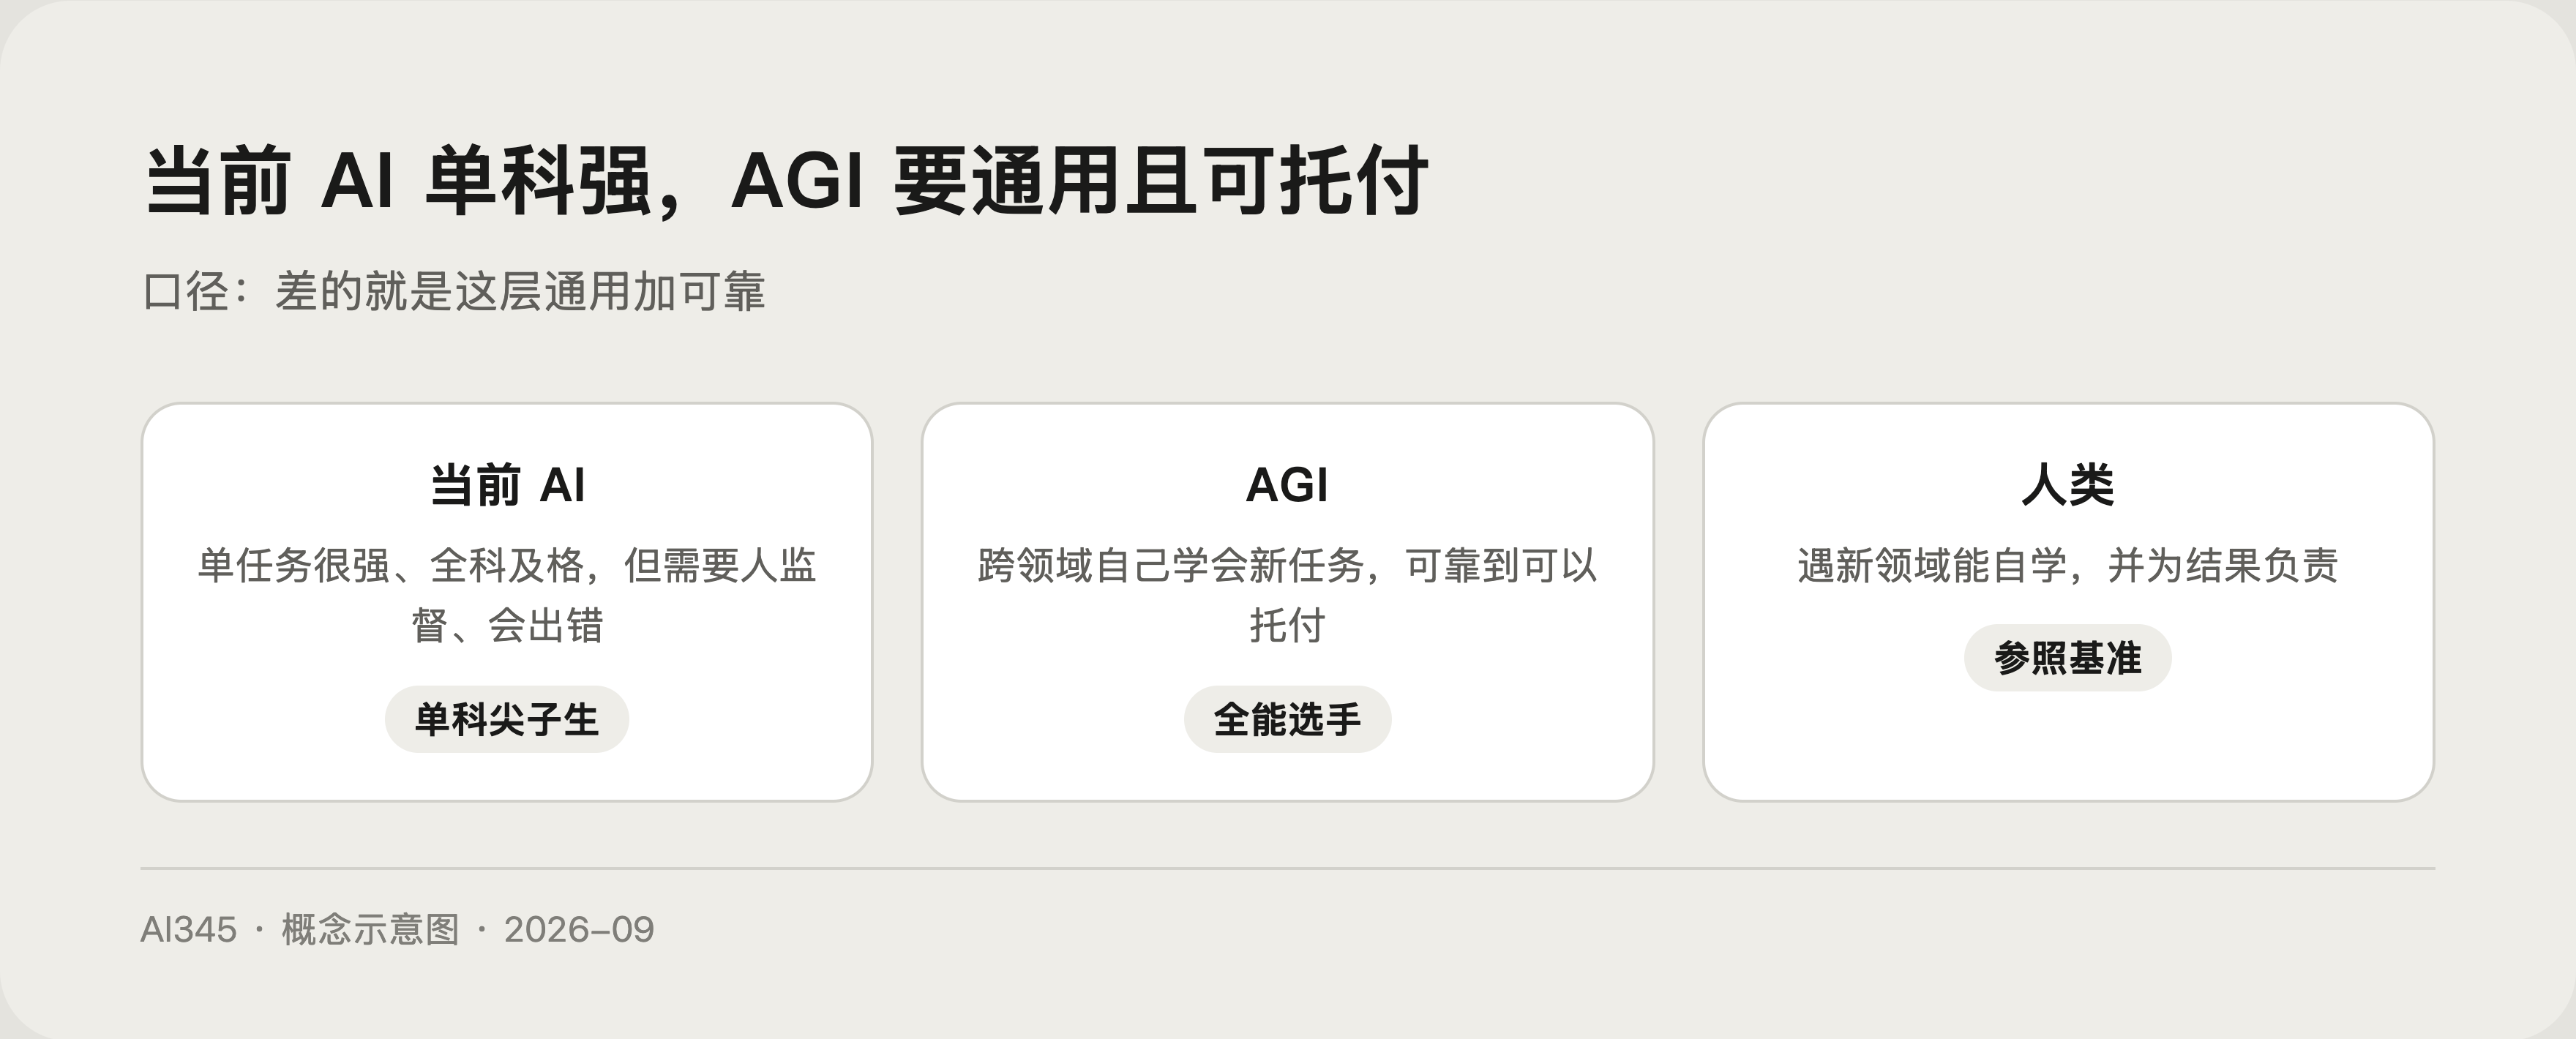
现在的大模型更像「单科尖子生加全科及格」:写代码很强、聊天很顺,但你让它明天独立替你开一整天会、办事、付钱、承担责任,它做不到,因为它需要人监督、会出错、没法为结果负责。
AGI 的标准形象是一个「全能选手」:不需要针对每个任务单独训练,遇到新领域能像人一样自己学会,并且可靠到可以托付。差的就是这层「通用加可靠」。
各家怎么定义 AGI?
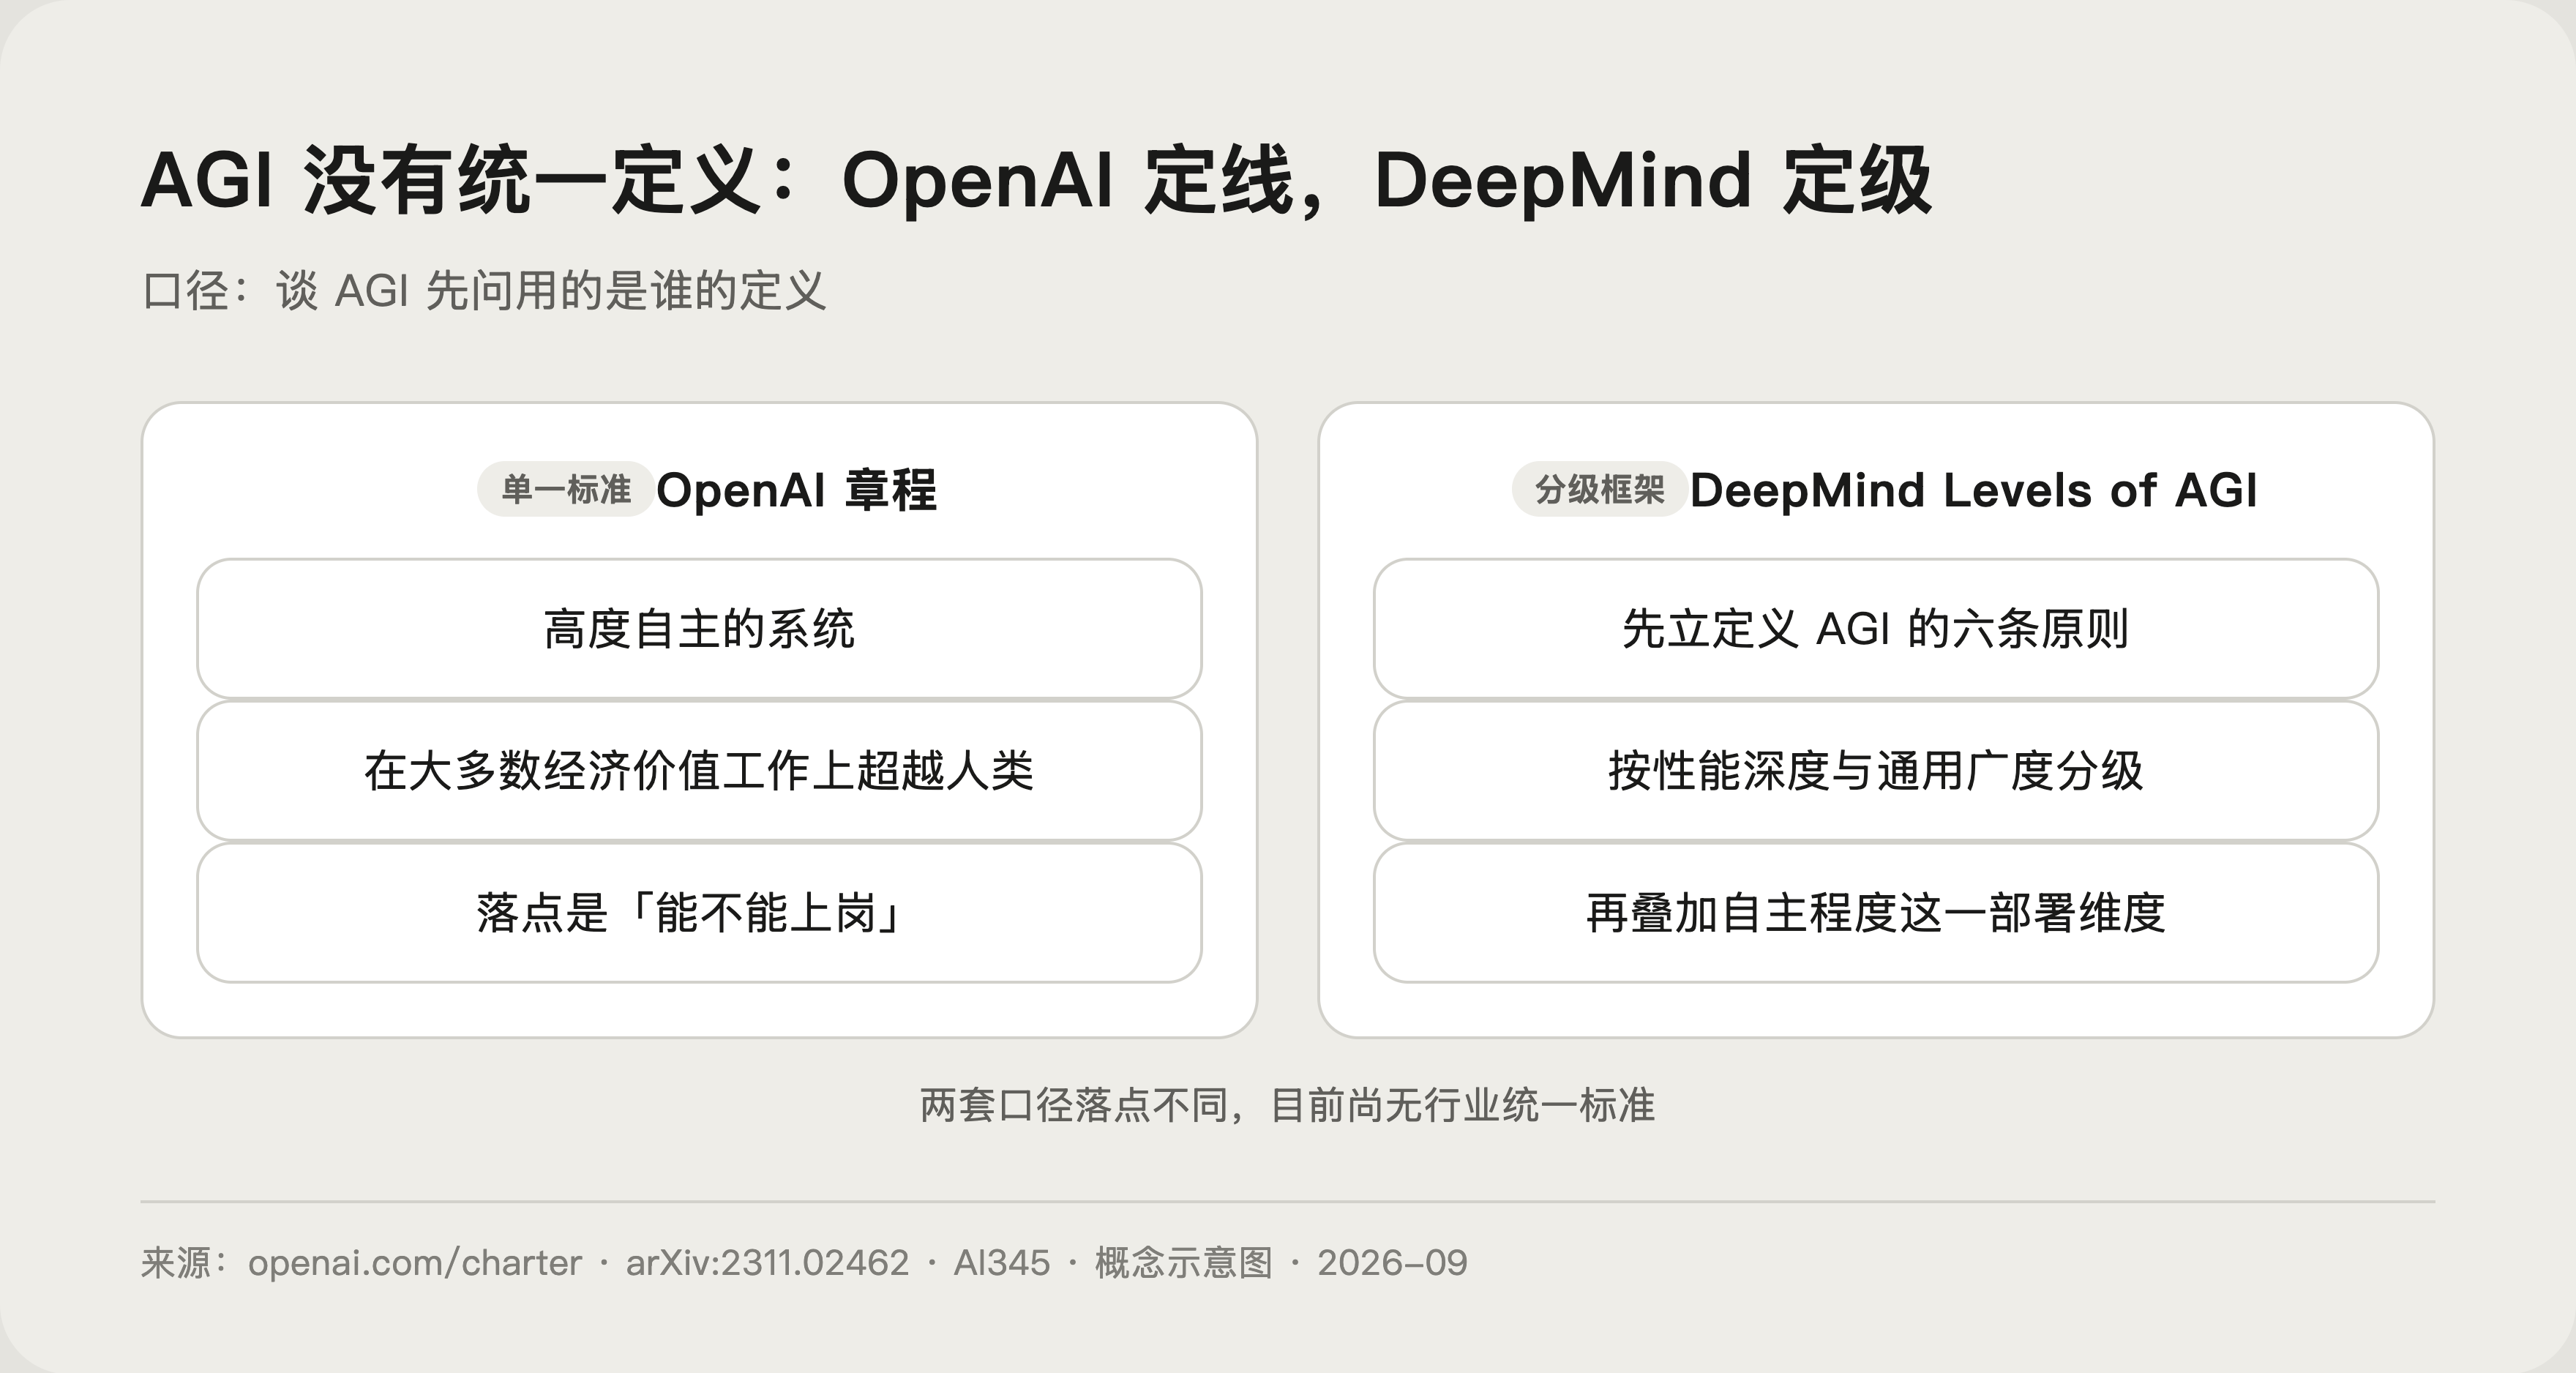
OpenAI 的章程原文把 AGI 定义为「高度自主、在大多数经济价值工作上超越人类的系统」,并称其使命是让这样的 AGI 造福全人类(OpenAI 章程)。注意这个定义的落点是「经济价值工作」,很像用「能不能上岗」来划线。
Google DeepMind 的做法不同:不给单一定义,而是给分级框架。他们在论文 Levels of AGI 中先提炼了定义 AGI 应满足的六条原则,再按「性能深度」和「通用广度」两个维度给 AI 分级,并叠加「自主程度」这一部署维度,用来给现有系统定位、评估风险(Levels of AGI 论文)。
为什么定义本身就有争议?
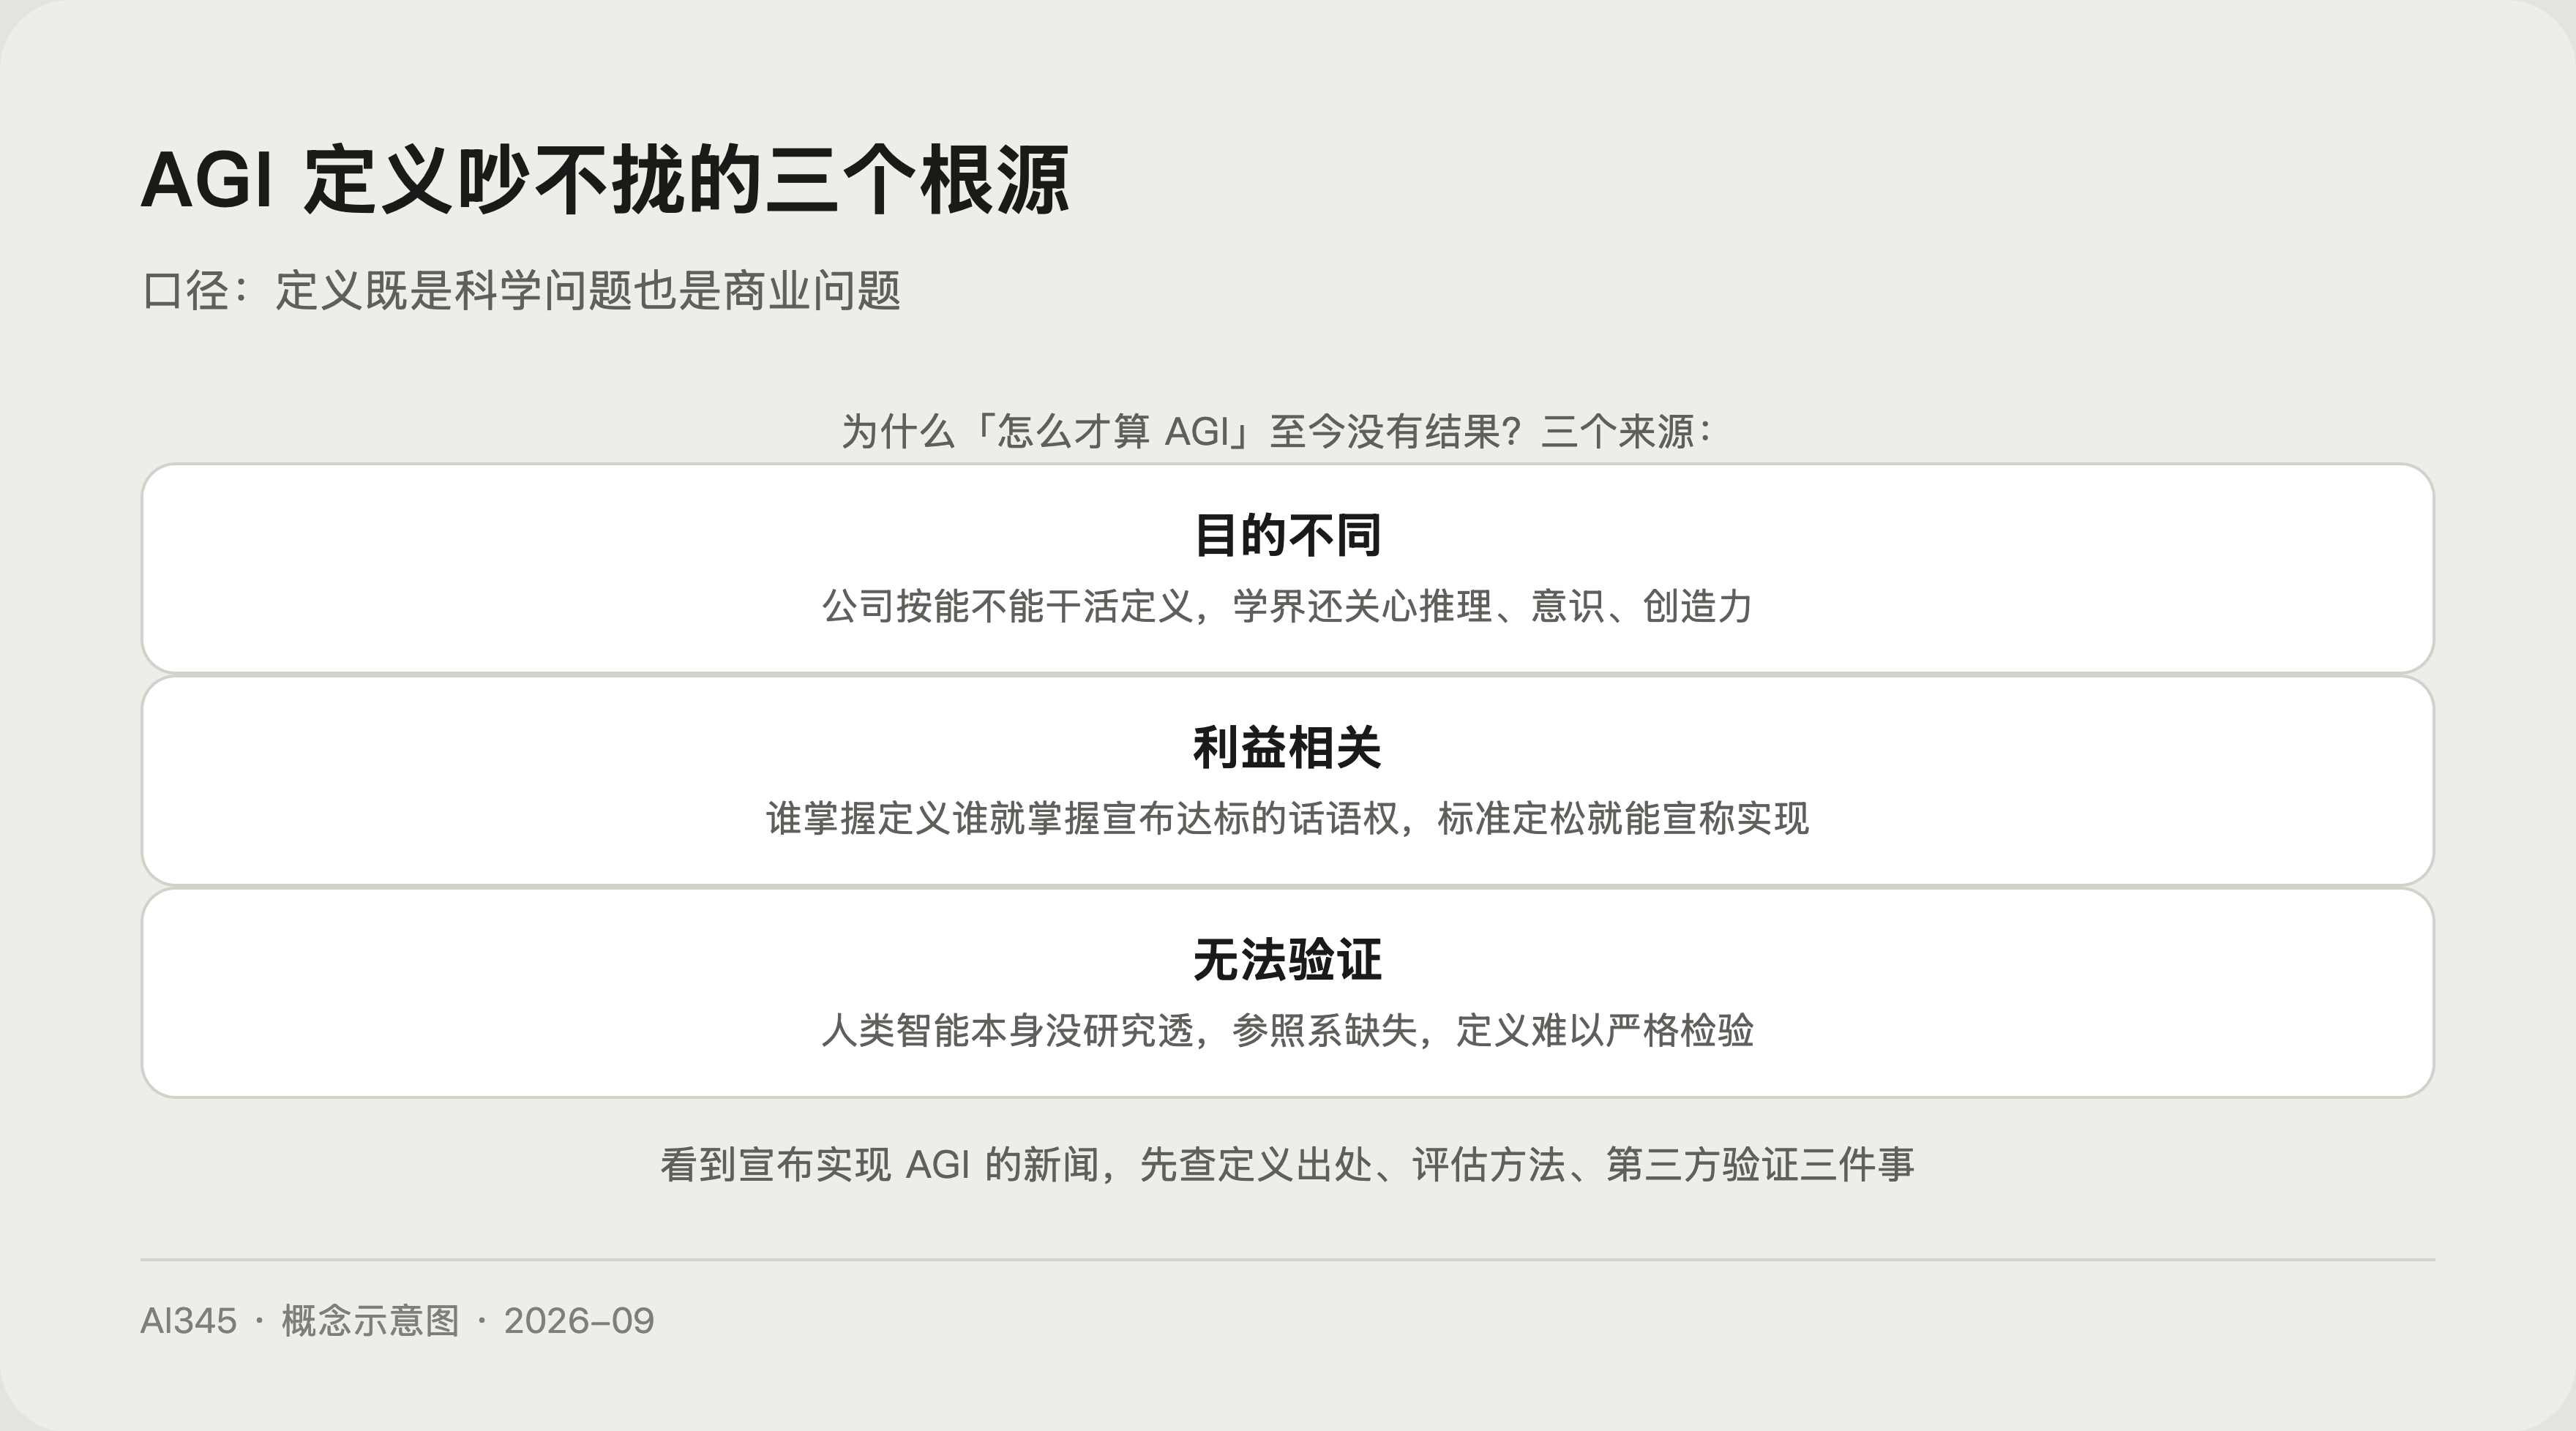
- 目的不同:公司倾向按「能不能干活」定义,学界还关心推理、意识、创造力这些更根本的维度。
- 利益相关:谁掌握定义,谁就掌握「宣布达标」的话语权,标准定松一点,公司就能宣称实现了 AGI。
- 无法验证:人类智能本身就没被研究透,参照系缺失,任何定义都难以严格检验。
通用人工智能离我们还有多远?
诚实的回答是:没人知道。DeepMind 论文的立场很有代表性:与其预测时间表,不如先把分级标准和评估方法定下来,否则「离 AGI 更近了」这句话根本没法检验。
普通人可以观察的中间信号有三个:模型在长程任务上能不能自主可靠地跑完、能力能不能跨领域迁移、经济活动中的实际替代比例到了哪一步。在此之前,行业先把「能自主干活的 AI」做成了 AI Agent,这是当前更务实的方向,可以延伸阅读站内的AI Agent 是什么,底层原理见大语言模型是怎么工作的。
还有一个实用提醒:看到「某公司宣布实现 AGI」的新闻,先看三件事,用的是谁的定义、评估方法是否公开可复现、有没有第三方验证。三件都缺的,基本可以当营销叙事处理。
一段话讲清 AGI?
「AGI 指跨领域通用的 AI,能在没被专门训练过的新任务上达到人类水平。目前没有统一定义:OpenAI 章程把它定义为在大多数经济价值工作上超越人类的高度自主系统,DeepMind 则用性能、通用性、自主性三个维度做分级框架。争议的核心是定义既是科学问题也是商业问题,标准松紧直接决定谁先宣布达标。所以谈 AGI 的第一步,是先确认双方用的是哪个定义。」
为什么这个概念对从业者很重要?
AGI 不是遥远的谈资,它影响实际决策:融资叙事、监管口径、产品边界都围着它转。宏观层面各行业被 AI 改造的进度,可以看这篇AI 影响的产业有哪些;个人层面怎么在渐进式进步里建立职业安全感,可以读AI 时代的职业安全感。把 AGI 当成一个「移动的球门柱」,比把它当成一个确定日期,更接近现实。
顺带一提,把 AGI 讲清还有个额外好处:它逼你区分事实和叙事,这正是产品经理做判断的基本功。
常见问题
ChatGPT 是 AGI 吗?
答:按主流定义不是。它任务覆盖面广,但可靠性不足、需要人监督,且在长程自主任务上表现不稳定,不满足「可托付的通用性」。
AGI 和 AI Agent 有什么区别?
答:Agent 是一种工程形态,用工具和流程让模型自主干活,能力上限还是模型;AGI 是能力假设,指跨领域通用且可靠。现在的 Agent 离 AGI 还很远。
AGI 真的实现后会发生什么?
答:没人能确定。这正是安全研究和治理框架存在的原因:OpenAI 章程里专门写了利益分配和安全承诺条款,说明头部公司自己也在为不确定性做准备。
有没有靠谱的 AGI 时间表?
答:各家说法差异极大,从几年到几十年都有,且都基于假设而非可验证的方法,只能当观点看,不能当事实用。
DeepMind 为什么做分级而不直接定义?
答:因为单点定义要么太宽没法用、要么太窄有争议。分级框架允许把现有系统放进刻度里比较进度,也便于把能力等级和风险、部署方式挂钩。
 京ICP备2024094994号-29