
Mercury 2.5 和 Gemini 3.8 Flash 哪个好?
直接给结论:追求速度和极限低价、任务质量在性价比档够用的场景选 Mercury 2.5;需要更强推理、超长上下文和更稳的工具调用选 Gemini 3.8 Flash。两款当前都在限时折扣期,但一个便宜 10 倍以上,一个强在智能档位,选错方向钱就白花。下面用 8 个维度把账算清楚。
一张总对比表
| 维度 | Mercury 2.5 | Gemini 3.8 Flash |
|---|---|---|
| 模型路线 | 扩散(并行生成再精修) | 自回归(逐 token 生成) |
| 厂商 | Inception Labs | |
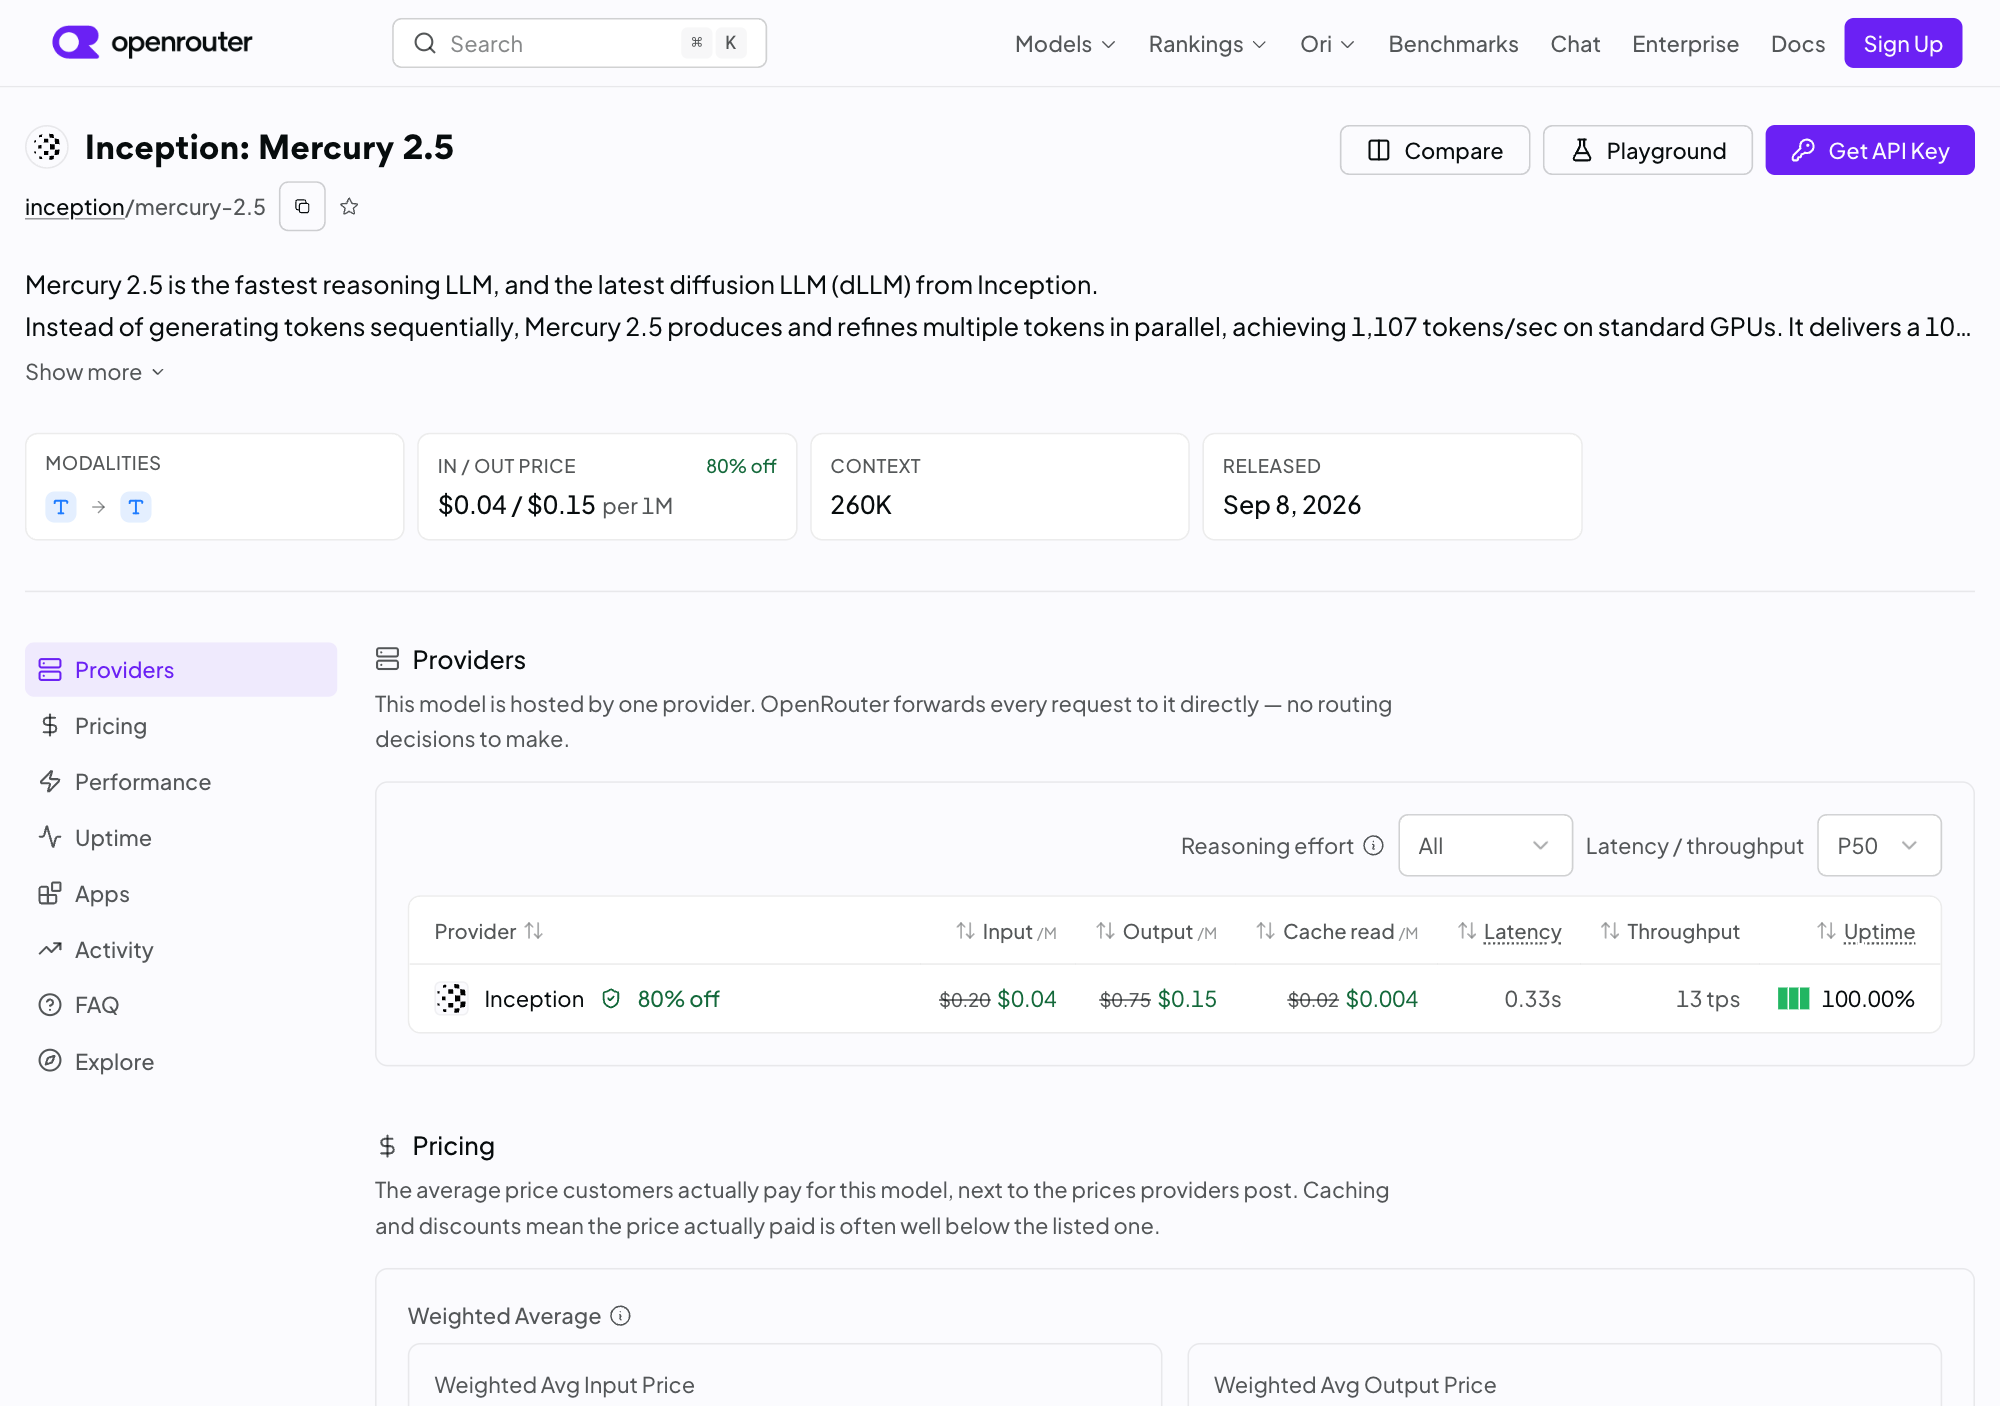
| 上线时间 | 2026-09-08 | 2026-09-02 |
| 上下文 | 260K(最大输出 65,536) | 1.0M |
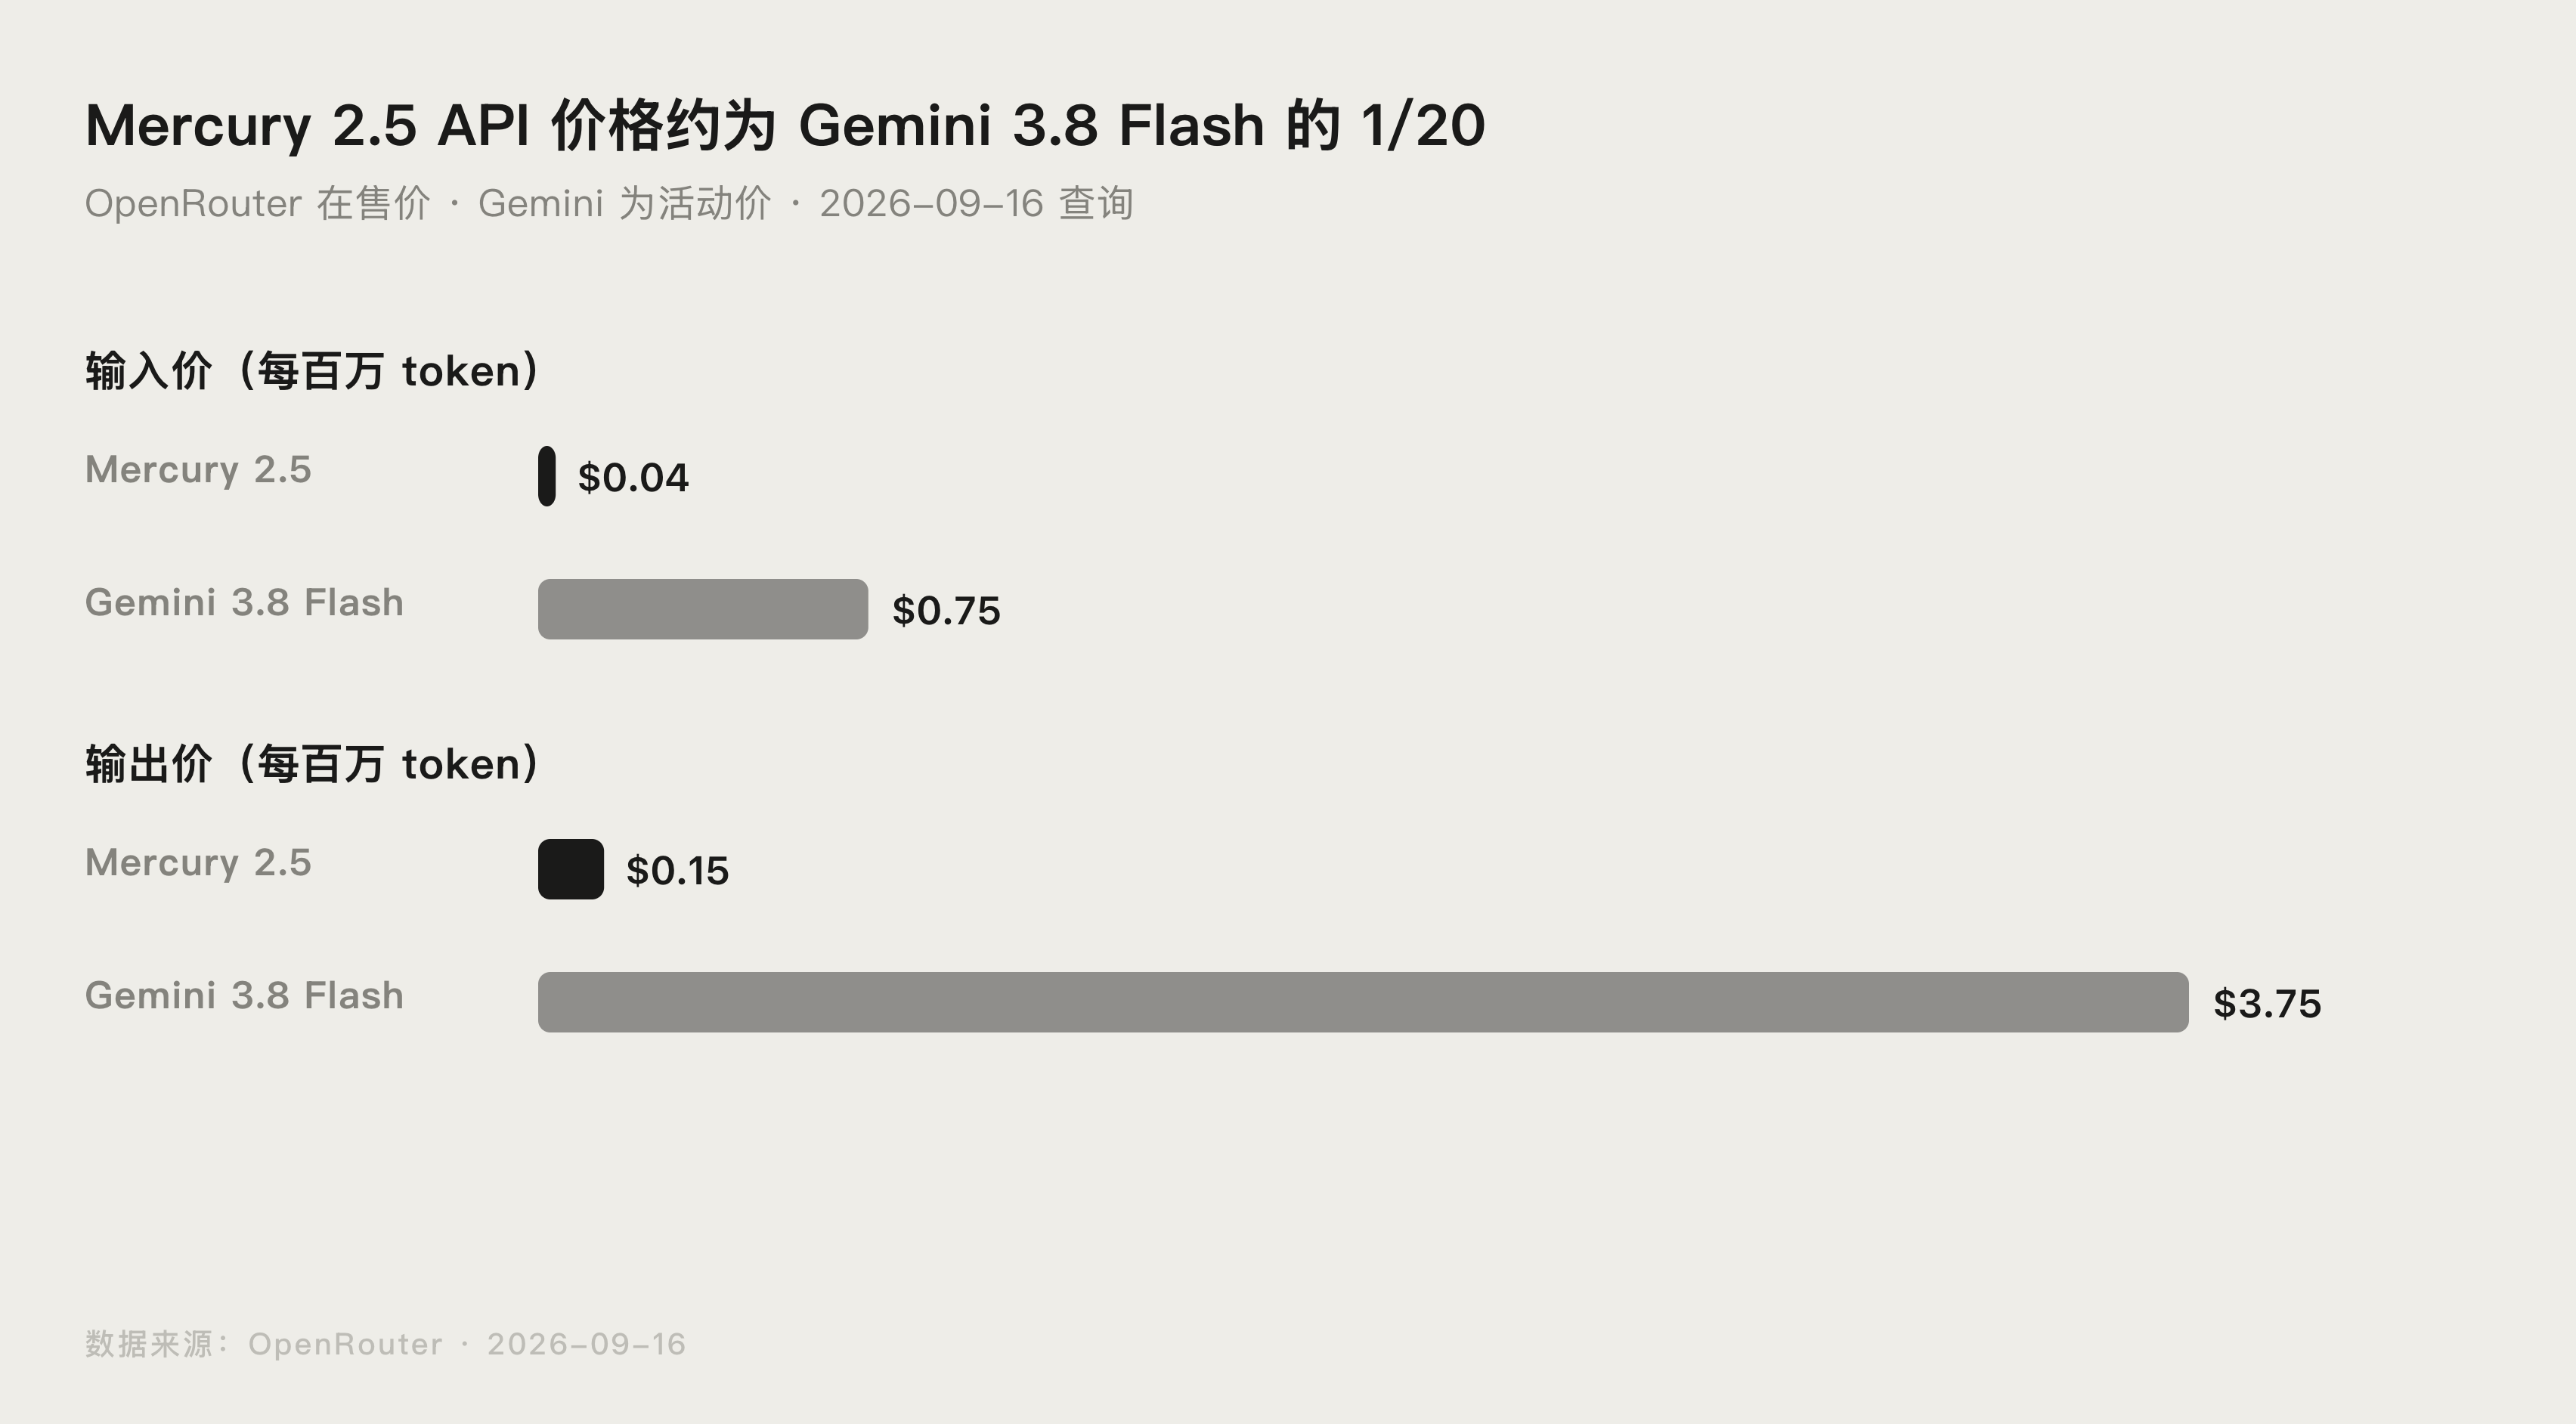
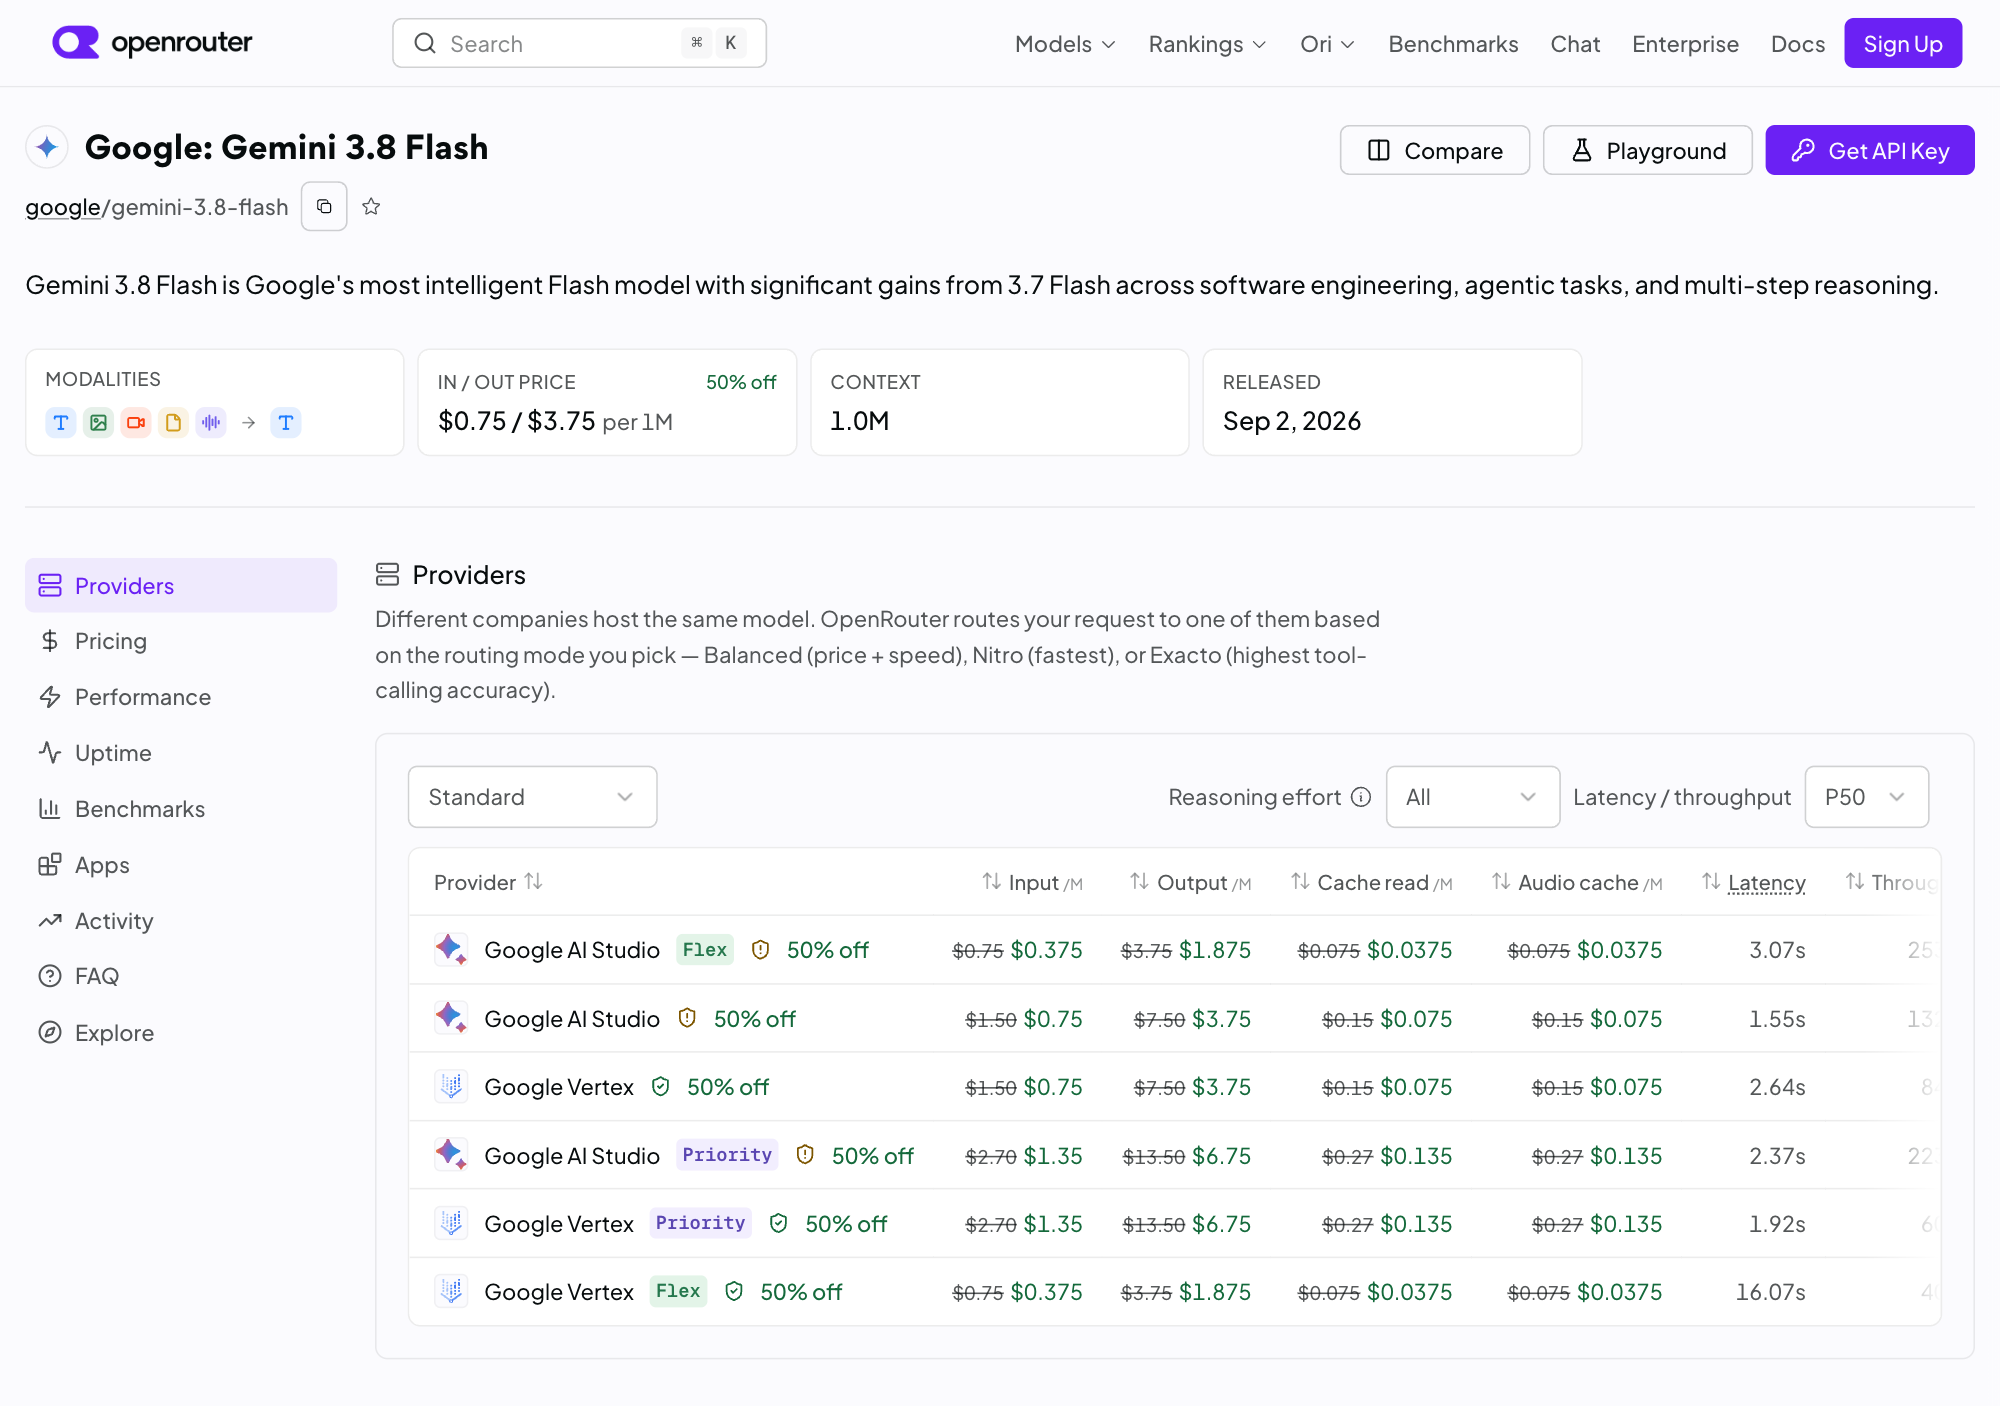
| 活动价(每百万 token) | $0.04 / $0.15(原价 $0.20/$0.75) | $0.75 / $3.75(原价 $1.50/$7.50) |
| 速度 | 官方 1107 tok/s,OpenRouter P50 约 437 | OpenRouter 最高档 P50 约 223 |
| 智能水平 | 对标性价比档(GPT-5.6 Luna Low 等) | Intelligence Index 41.2,Coding 76.3 |
| 工具调用错误率 | 约 2.24% | 0.46% 至 2.41% |
| 结构化输出错误率 | 约 5.36% | 0.20% 至 1.48% |
数据口径说明:价格与错误率来自两家在 OpenRouter 的模型页,Mercury 速度含官方基准和 OpenRouter 真实负载两个口径,Gemini 跑分来自 Artificial Analysis。折扣都有时效,下单前以页面实时价格为准。
价格:差多少,怎么算
按活动价算,输出 100 万 token 的成本是 Mercury 0.15 美元、Gemini 3.75 美元,差 25 倍;输入侧差约 19 倍。就算 Gemini 的 5 折活动结束回到原价 $1.50/$7.50,Mercury 回到原价 $0.20/$0.75,输出侧仍有 10 倍差距。
但绝对值要看你的量级:每天 1000 万输出 token,Mercury 一天 1.5 美元,Gemini 3 折价也要 37.5 美元,一个月差出 1000 美元以上;如果只是每天几十万 token 的个人项目,两者都在几毛钱量级,价格不该是决策主因。两款各自的价格细节见站内 Mercury 2.5 价格多少钱一个月?按量计费价格与省钱方案。
速度:扩散模型的优势区
这是两款模型最大的分水岭。Mercury 2.5 走扩散路线,先并行生成一段候选文本再迭代精修,官方基准 1107 tok/s,OpenRouter 真实负载 P50 也有约 437 tok/s。Gemini 3.8 Flash 是自回归模型,OpenRouter 上最快的 Priority 档 P50 约 223 tok/s。
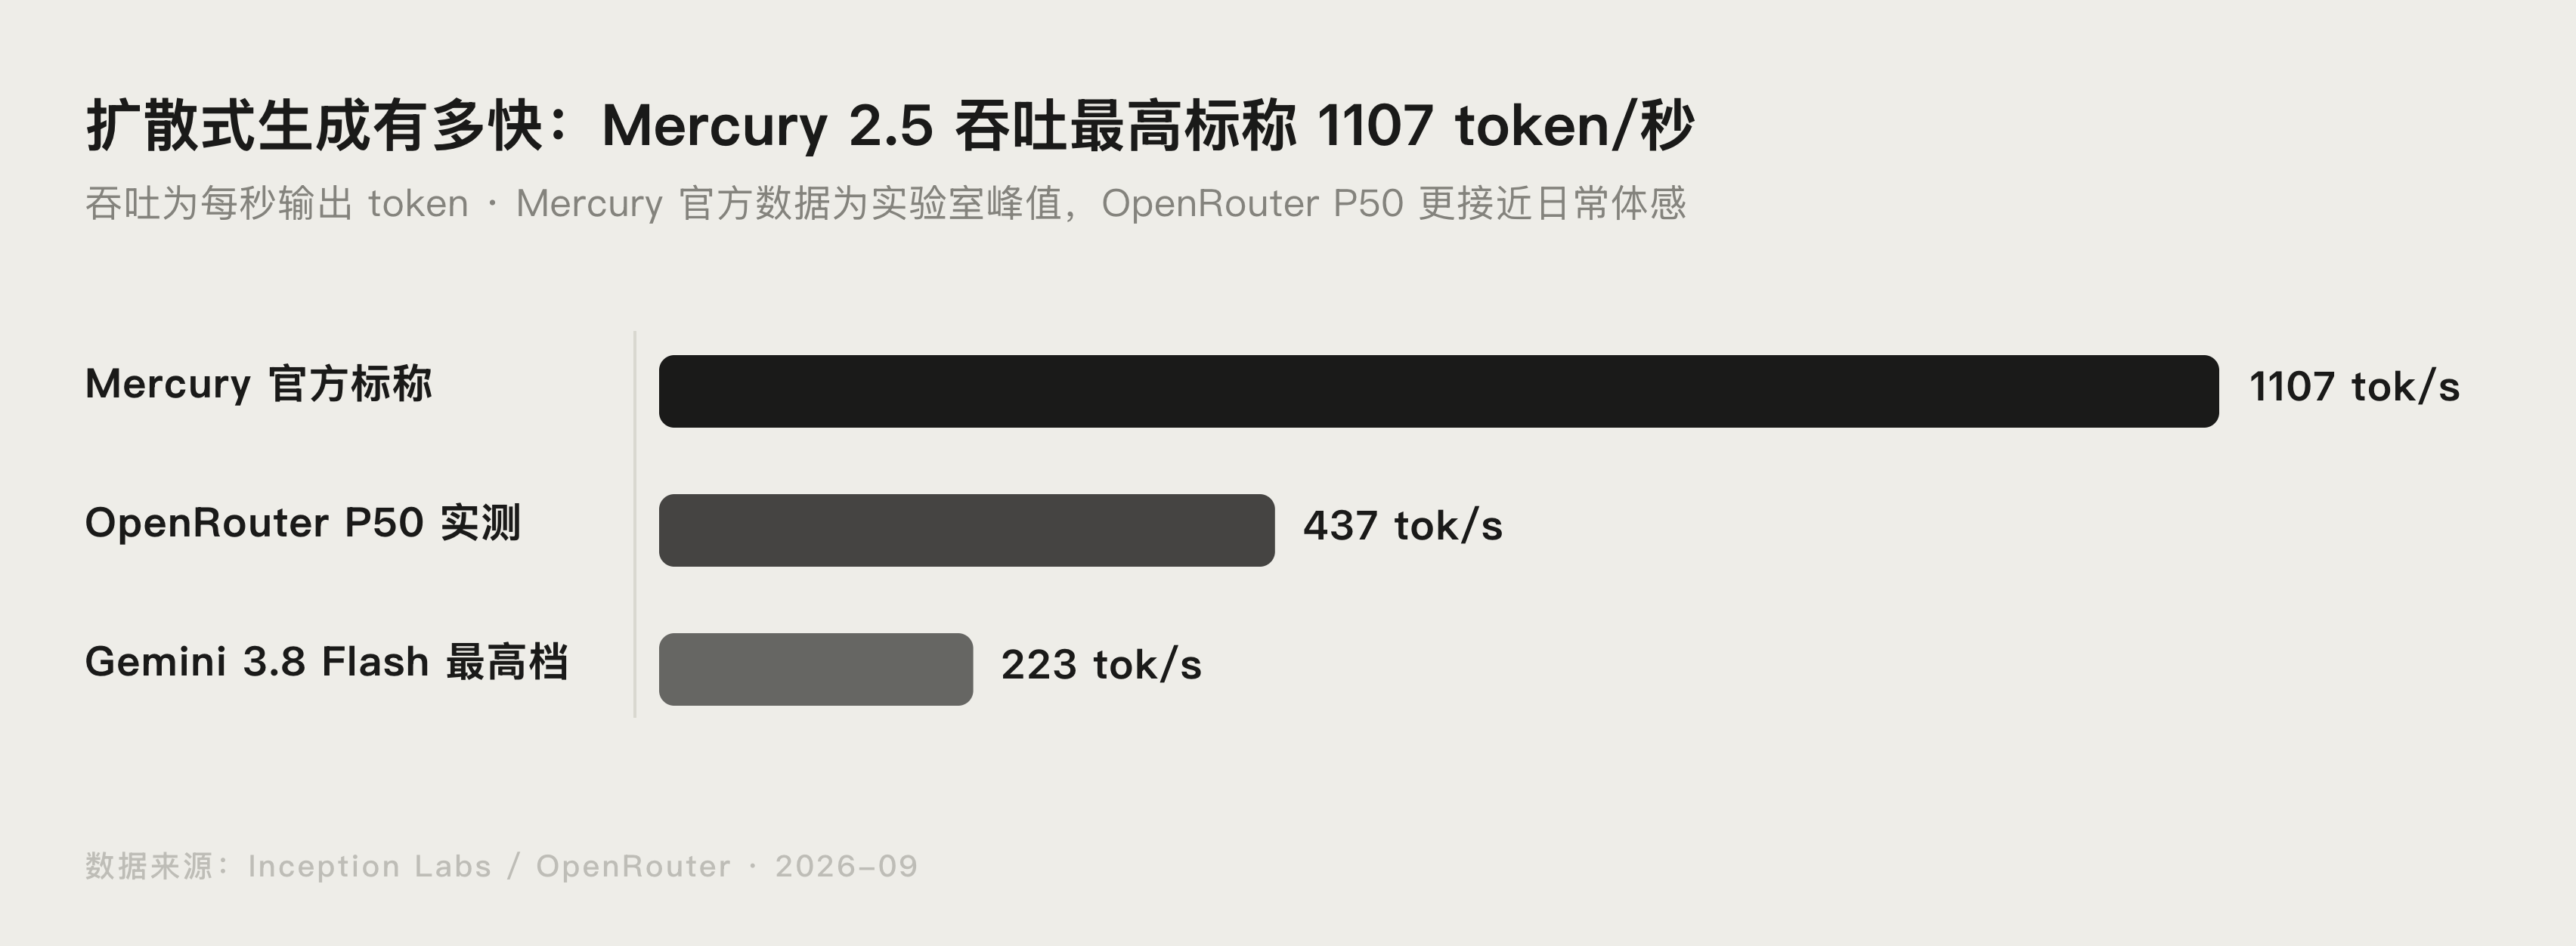
对用户感知的影响:同样是出 2000 字回答,Mercury 大约 5 秒出完,Gemini 要 9 秒往上。放在搜索 Agent、语音对话这类延迟层层叠加的链路里,几秒的差距会被放大成体验代差。扩散模型的原理和边界,在 Mercury 2.5 是什么?OpenRouter 上的扩散大模型 里有完整展开。
智能水平:Gemini 明显更高一档
Gemini 3.8 Flash 的 Artificial Analysis 口径是 Intelligence Index 41.2、Coding Index 76.3、GPQA Diamond 95.3%,在 OpenRouter 全模型里排在前列(Coding 超过 93% 的对比模型)。Mercury 2.5 的官方定位是质量对标 GPT-5.6 Luna (Low)、Gemini 3.5 Flash-Lite、Claude Haiku 4.5 这档性价比模型,没给同级跑分。
翻译成大白话:常规问答、摘要、格式化改写这类任务两者都能胜任;但复杂的代码重构、多步推理、需要严谨性的任务,Gemini 3.8 Flash 高出的那一档智能是实打实的。这也是它敢定 10 倍价钱的底气。
工程稳定性:Agent 场景必看
| 指标 | Mercury 2.5 | Gemini 3.8 Flash |
|---|---|---|
| 工具调用错误率 | 约 2.24% | 0.46% 至 2.41%(标准档 1.36%) |
| 结构化输出错误率 | 约 5.36% | 0.20% 至 1.48% |
跑 Agent 工作流的团队注意 Mercury 的结构化输出错误率约 5.36%,意味着每 20 次 JSON 生成可能有 1 次要重试,schema 校验和自动重试是必配;Gemini 在这两项上明显更稳,Vertex 档工具调用错误率低到 0.46%。以上错误率为 2026 年 9 月 16 日 OpenRouter 页面的实时口径,上线初期波动大,接入前再拉一次最新值。工具调用机制本身如果不熟,先看 Function Calling 是什么?一次讲透工具调用。
上下文与生态
上下文:Gemini 1.0M 对 Mercury 260K,差距约 4 倍。要整库代码分析、超长文档问答,Gemini 的窗口是硬优势。
生态:Gemini 3.8 Flash 背靠 Google AI Studio 和 Vertex 两套基础设施,接入面广,OpenRouter 流量榜上 Claude Code 等主流编码 Agent 的用量排在头部。Mercury 2.5 上线一周,走 OpenRouter 和 Inception 自家平台,生态还在起步期。接入的实操步骤见 Mercury 2.5 怎么用?OpenRouter 调用教程。
场景化推荐
- 搜索 Agent、语音管线、批量摘要流水线:选 Mercury 2.5,速度和成本是这两类场景的命门,质量在性价比档完全够用。
- 编码助手、复杂推理服务:选 Gemini 3.8 Flash,Coding Index 76.3 和 1M 上下文对代码场景是决定性的。
- 结构化抽取、重工具调用的 Agent:优先 Gemini,错误率低一个量级,省下的重试成本能抵消一部分价差。
- 预算极紧、任务简单的高并发场景:Mercury,没有第二选项。
迁移成本
两模型都走 OpenRouter 的 OpenAI 兼容接口,切换只需要改 model 字符串:inception/mercury-2.5 和 google/gemini-3.8-flash。真正的迁移成本在行为差异上:从 Gemini 换到 Mercury 要补 schema 校验和重试逻辑,长上下文任务要检查是否超出 260K;从 Mercury 换到 Gemini 主要是成本审批问题,代码几乎零改动。国内用户的 OpenRouter 充值路径两边通用。
常见问题
两款模型的折扣活动什么时候结束?
答:官方页面都没有标注截止日期。Mercury 活动价为原价 2 折左右,Gemini 5 折,建议把页面对比截图存档,账单突然变高先查价格。
Mercury 2.5 的智能真的够用吗?
答:官方口径对标 GPT-5.6 Luna (Low)、Claude Haiku 4.5 一档,日常问答、摘要、改写够用;超出性价比档能力的复杂任务它会露怯,先用自己的任务实测再全量切。
扩散模型写长文会乱吗?
答:扩散生成靠迭代精修保证连贯,短中篇幅没有明显问题;超长结构化写作建议先用 2000 字以上的真实任务对比两者,不要只看速度数字。
国内用户调用哪个更方便?
答:两款都可以通过 OpenRouter 调用,支付宝充值流程相同;Gemini 另有 Google AI Studio 直连入口,但同样需要自备可用网络。
能不能两个都接,动态路由?
答:可以,这是推荐做法。简单任务路由到 Mercury 省钱省时间,复杂任务回落到 Gemini 保质量,OpenRouter 支持按模型配置 fallback。
 京ICP备2024094994号-29