
Mercury 2.5 怎么用?OpenRouter 调用教程
不需要装新 SDK,也不用等内测名单:Mercury 2.5 在 OpenRouter 上走标准 OpenAI 兼容接口,把 model 换成 inception/mercury-2.5,现有代码几乎零改动就能调用。完整流程是 3 步:注册 OpenRouter、充值拿到 API Key、发起第一次请求,免费环节没有,按 token 计费但当前是活动价。
前置准备:账号、Key、余额
开始前确认三件事:
- 一个 OpenRouter 账号(邮箱即可注册)。
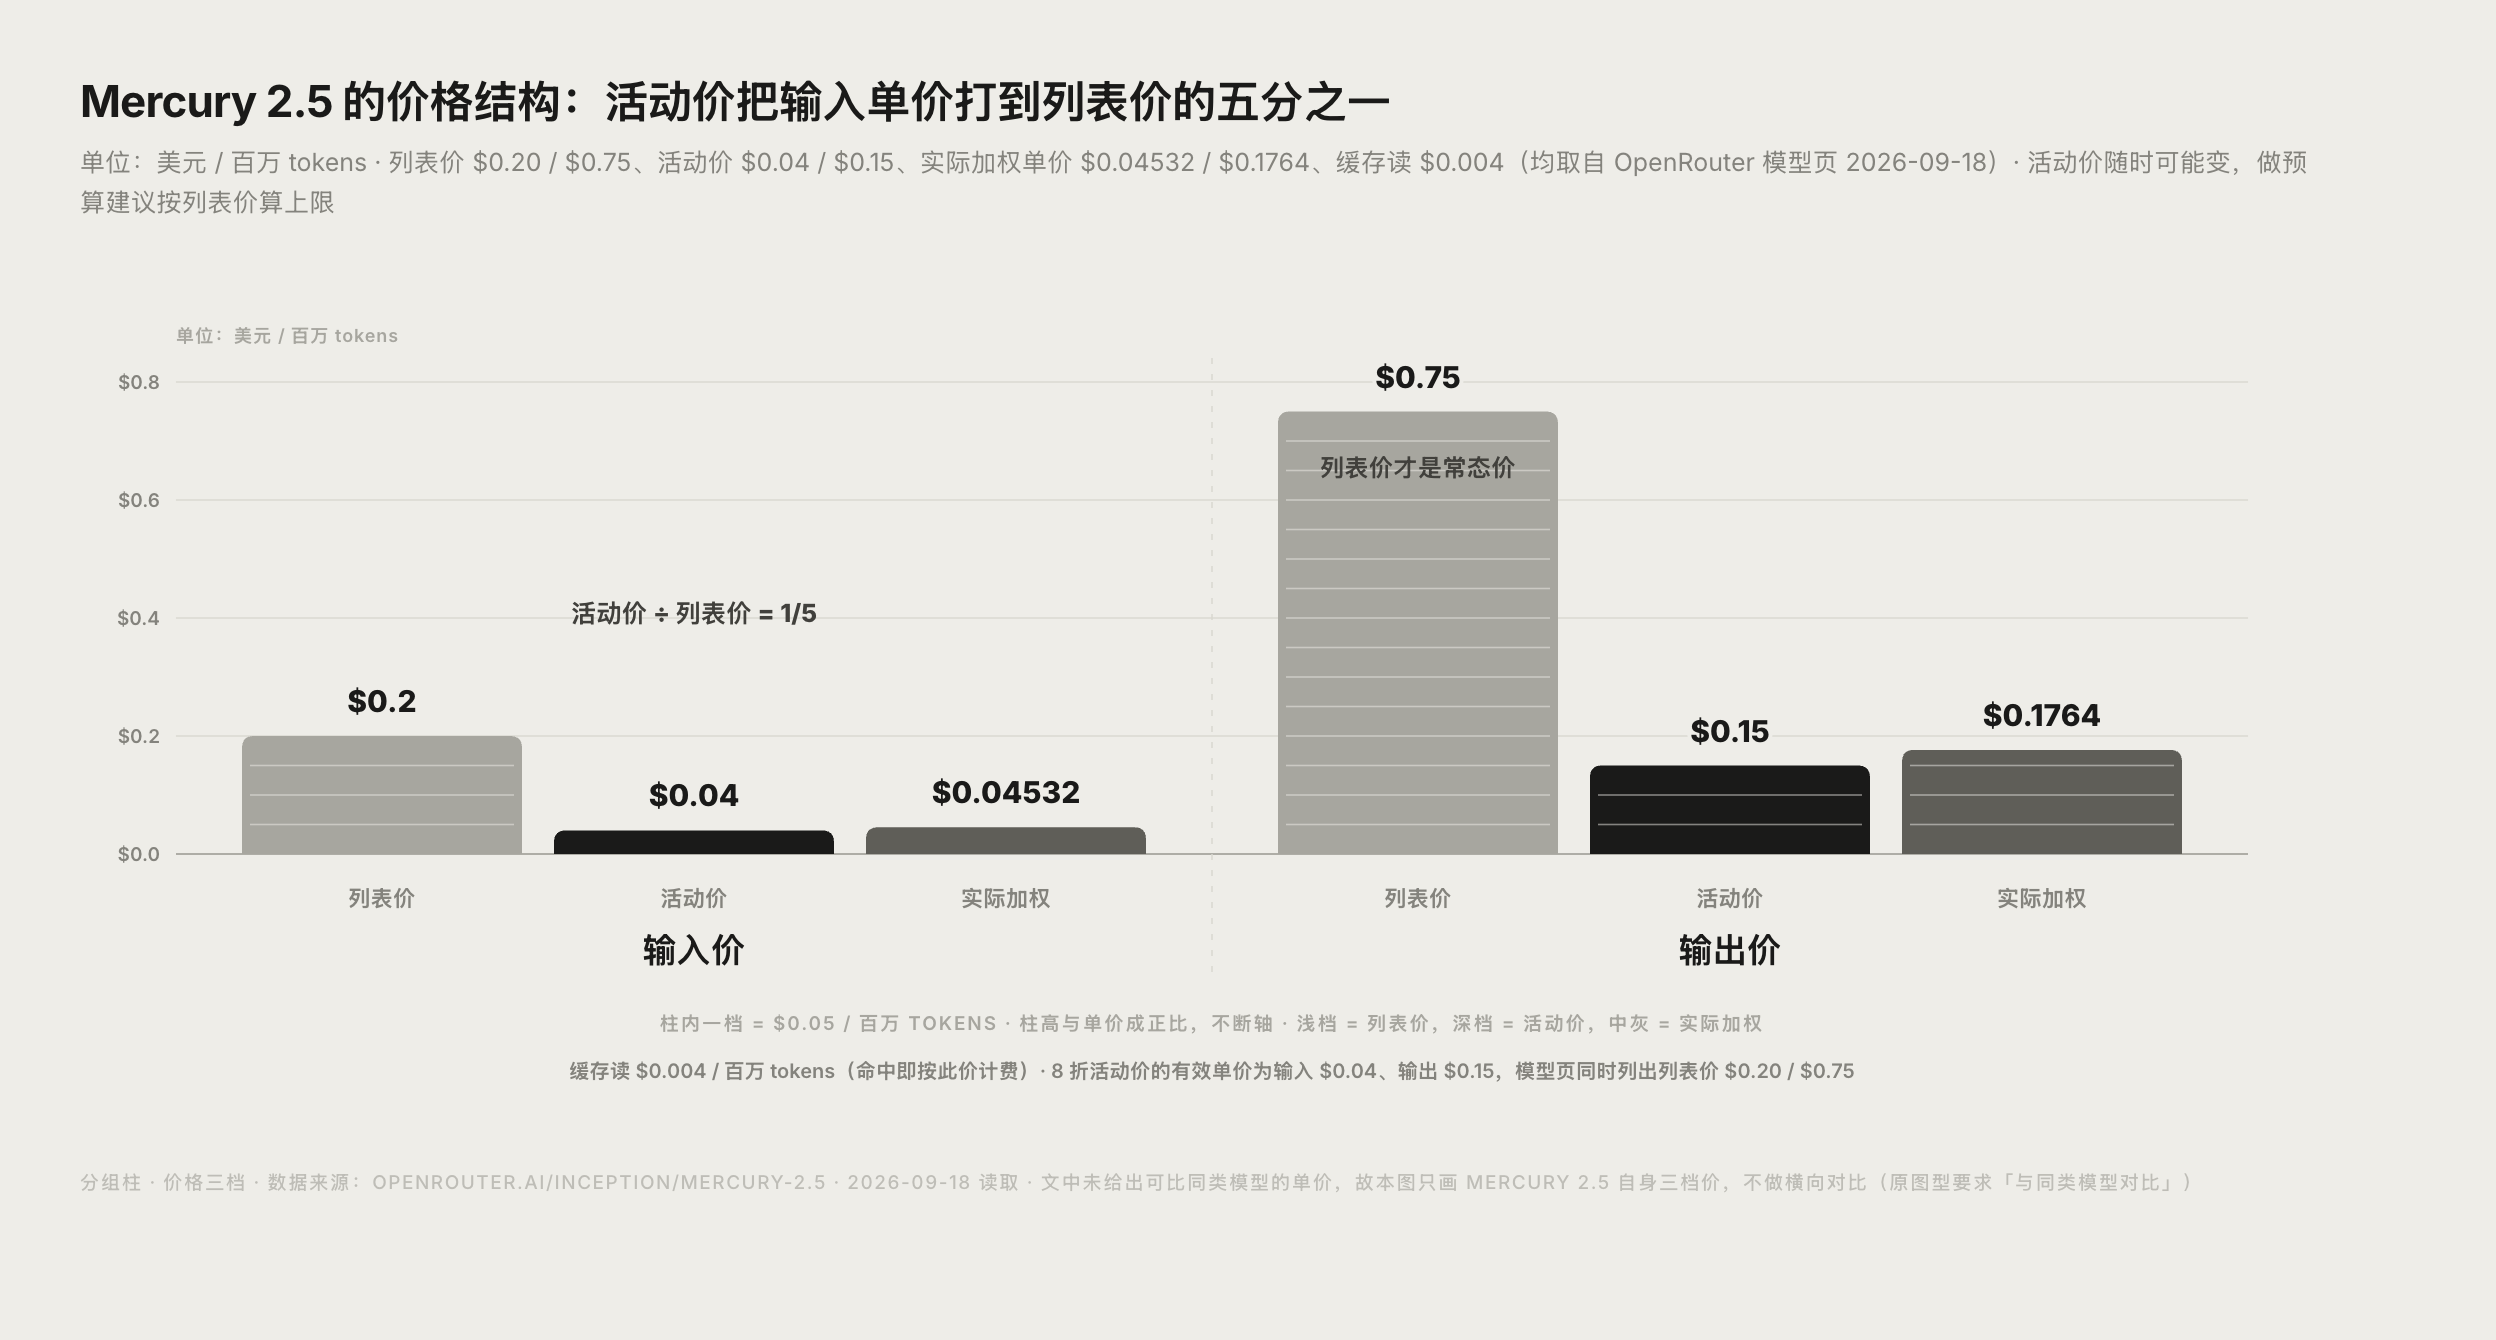
- 账户里有余额。Mercury 2.5 当前是 8 折活动价,输入 $0.04、输出 $0.15 每百万 token,缓存读 $0.004 每百万 token;充 5 美元足够跑通和长期测试。
- 本机能访问 openrouter.ai。国内用户推荐走支付宝充值路径,见 OpenRouter 使用教程:注册、支付宝充值到 API 调用全流程。
第一步:注册 OpenRouter 并创建 API Key
登录 openrouter.ai 后进入 Keys 设置页,新建一个 API Key。预期结果是拿到一串 sk-or-v1 开头的密钥,把它存到环境变量里:
export OPENROUTER_API_KEY=sk-or-v1-你的密钥
常见卡点是复制 Key 时带了空格,调用会报 401,重新完整复制即可。
第二步:确认模型页价格与限额
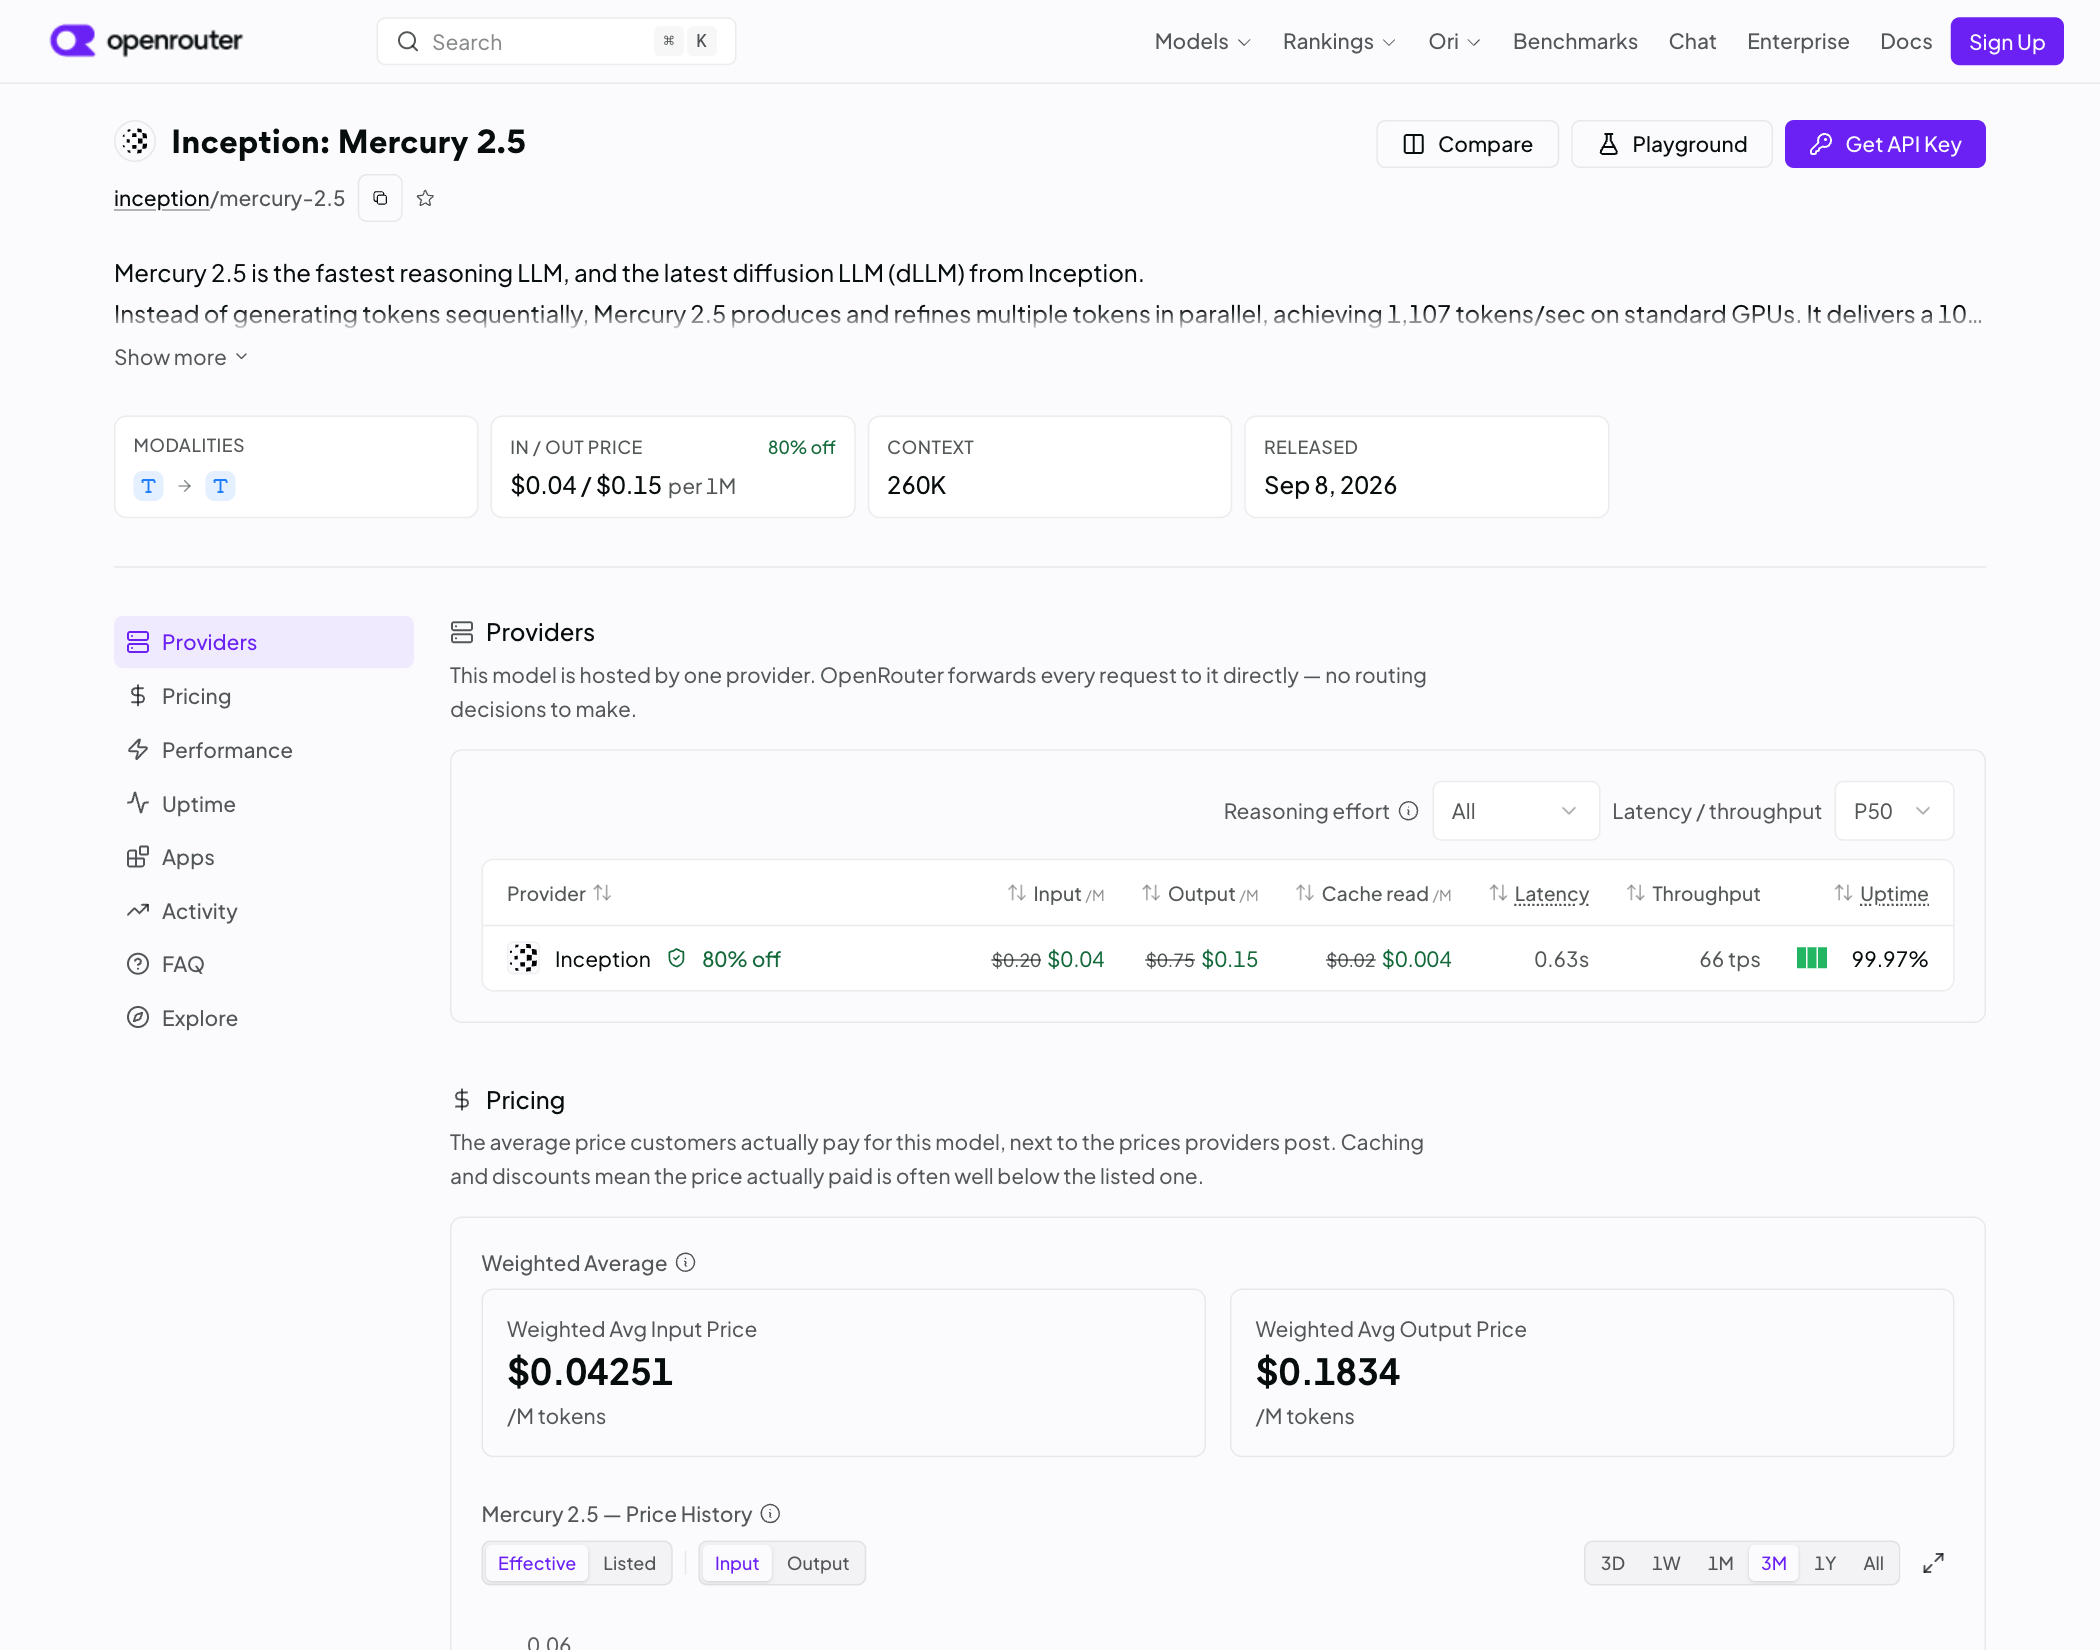
打开 Mercury 2.5 模型页核对四行信息:
- 价格:列表价 $0.20/$0.75,当前 8 折后的实际单价是输入 $0.04、输出 $0.15、缓存读 $0.004 每百万 token。
- 上下文:260K token。
- 最大输出:单次最多 65,536 个完成 token。
- 可用性:模型页的 Uptime 与 Availability 曲线,上线初期波动较大,生产接入前必看。
不想写代码的话,模型页右上角的 Playground 可以直接在网页里选 inception/mercury-2.5 对话测试,中文 prompt 也能跑,先把中文质量摸个底再决定接不接。
第三步:发起第一次调用
Mercury 2.5 兼容 chat/completions 端点,用 curl 最快验证:
curl https://openrouter.ai/api/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer $OPENROUTER_API_KEY' \
  -d '{
  "model": "inception/mercury-2.5",
  "messages": [
    {"role": "user", "content": "用一句话介绍你自己"}
  ]
}'
返回 JSON 里 choices[0].message.content 是回答正文,usage 字段能看到本次消耗的 token 数。跑通这一步,接入就完成了大半。
第四步:开启流式输出
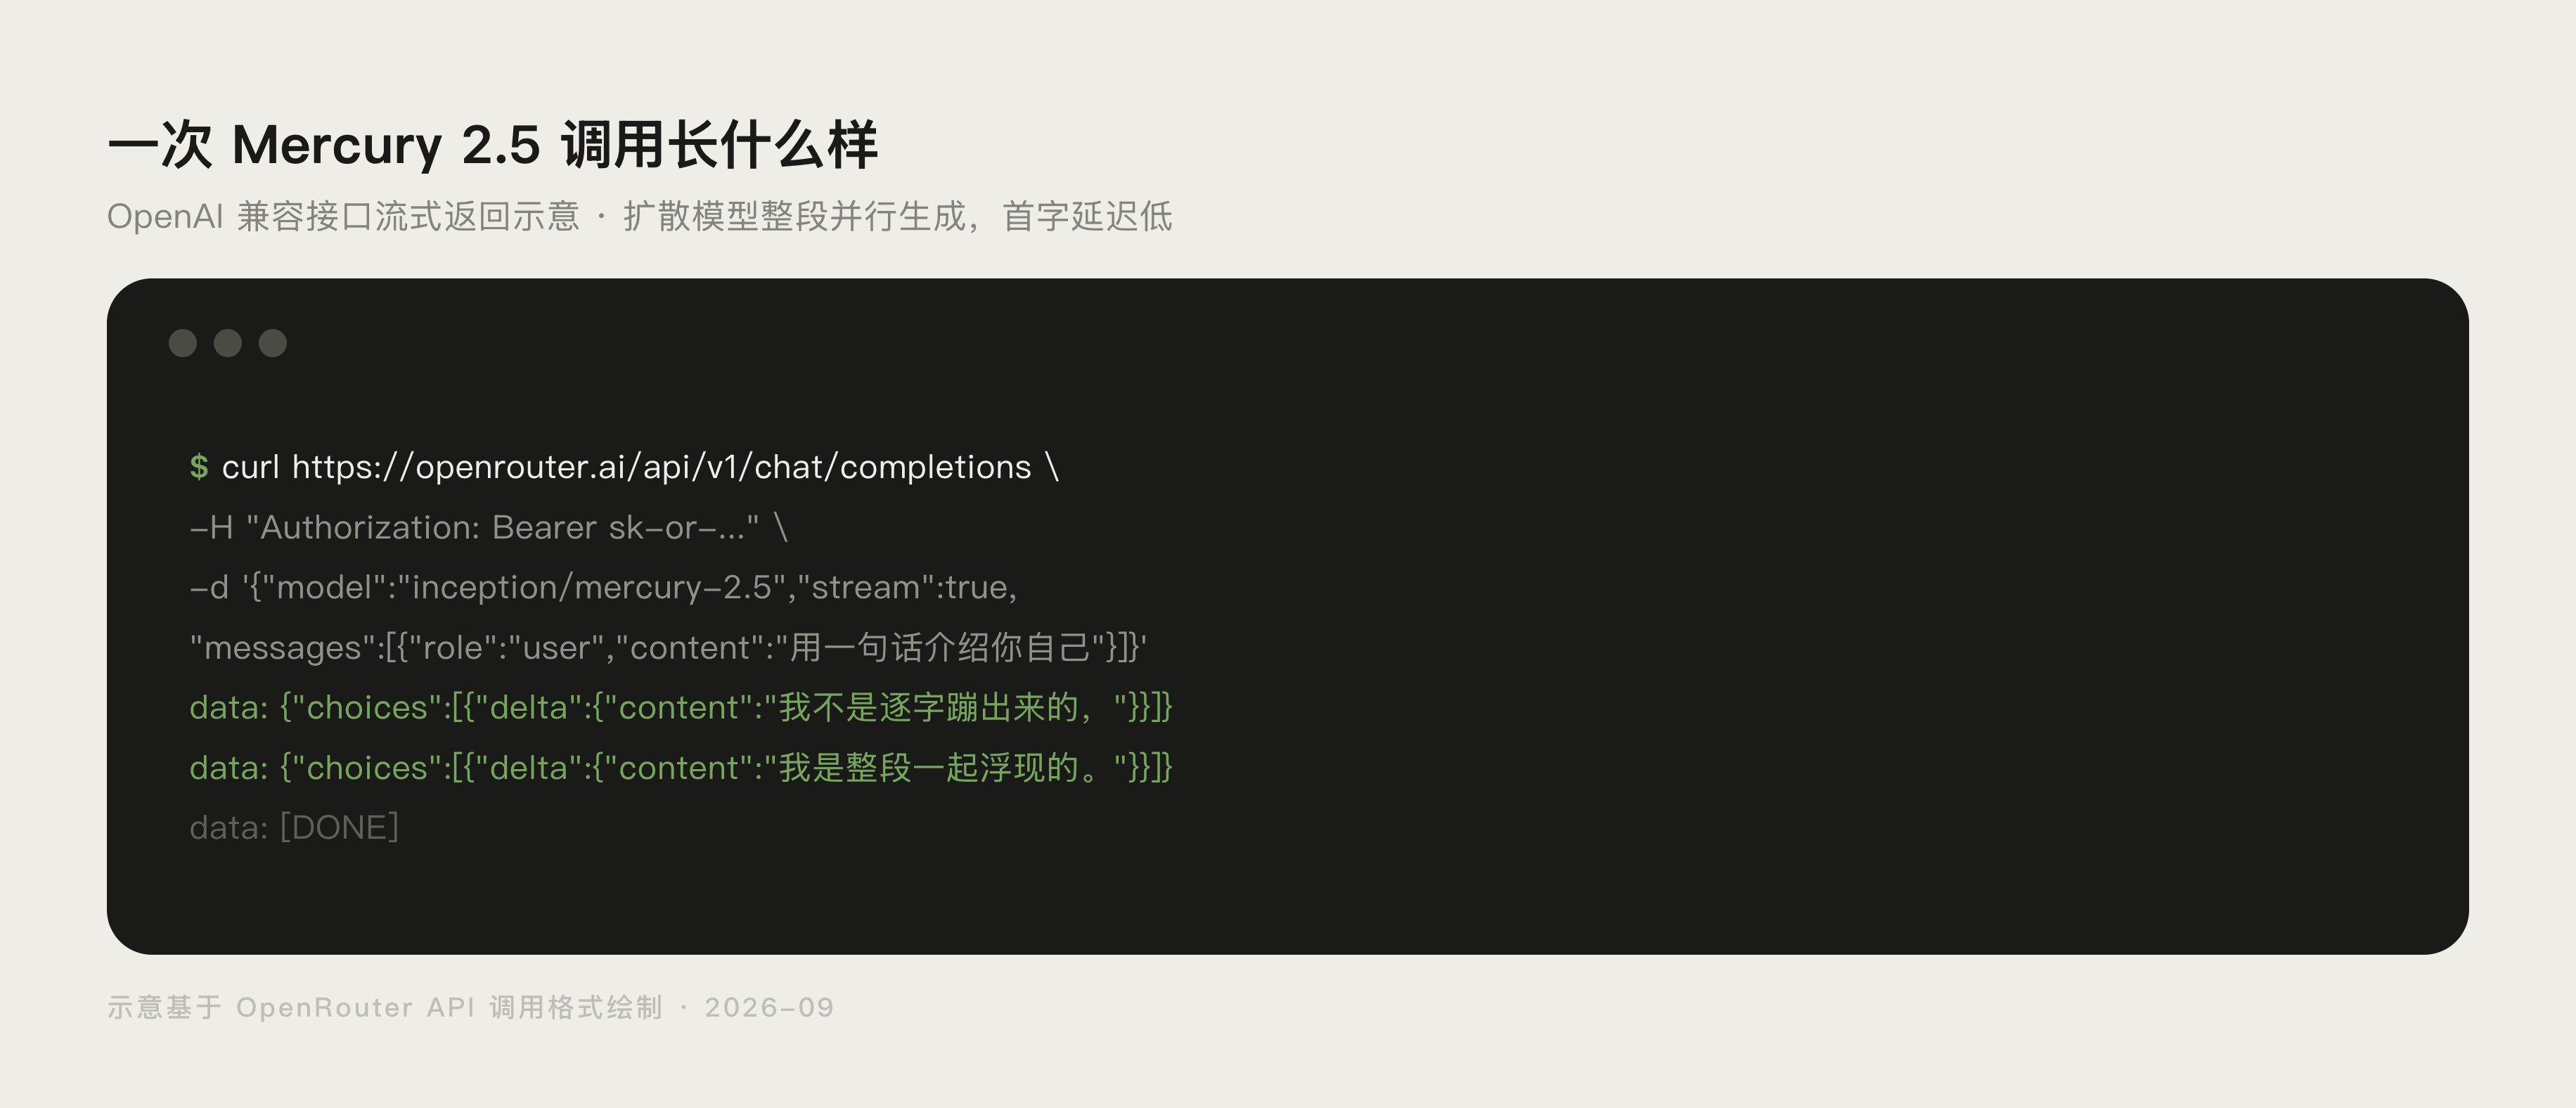
扩散模型的速度优势要靠流式才能被用户感知,加一个 stream 参数:
curl -N https://openrouter.ai/api/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer $OPENROUTER_API_KEY' \
  -d '{
  "model": "inception/mercury-2.5",
  "stream": true,
  "messages": [
    {"role": "user", "content": "Hello"}
  ]
}'
预期结果是服务端持续推送增量片段。官方对这款模型的定位是「最快的推理型 LLM」,称其在标准 GPU 上可达 1,107 tokens/秒;要注意这是模型侧的生成速度口径,经 OpenRouter 转发后的端到端吞吐会低不少,下文的实测统计会给出对照。
第五步:进阶参数
模型页公开支持的参数包括:
- reasoning:控制推理行为,可调推理等级,响应里通过 reasoning_details 拿到思考过程;多轮对话时要把它传回去。
- tools / tool_choice:函数调用,支持并行工具调用。
- response_format:按 JSON schema 强制结构化输出,注意该模型结构化输出有失败概率,建议拿到结果后做一次 schema 校验。
- temperature:默认 1;模型页还列出了 max_tokens、top_p、seed、stop 等采样参数。
采样类参数的完整支持范围以模型页 Parameters 表格为准,没列出的不要瞎传。
两种 SDK 写法:官方 SDK 与 OpenAI 兼容客户端
OpenRouter 提供 @openrouter/sdk(TypeScript)和 openrouter(Python)两个官方 SDK,也可以继续用 openai 这类第三方库:把 base_url 换成 https://openrouter.ai/api/v1,api_key 换成 OpenRouter 的 Key,model 换成 inception/mercury-2.5 即可,代码结构完全不变。流式、工具调用、reasoning 参数在两种写法里都能用,团队现有抽象层不用重写。
接入 Claude Code 等编码工具
凡是支持自定义 OpenAI 兼容 base_url 的工具(Claude Code、各类 CLI Agent、聊天客户端)都能直接把 OpenRouter 当供应商挂上,模型选 inception/mercury-2.5。OpenRouter 的模型页会按 token 量列出主要调用方,截至 2026 年 9 月 18 日,排在最前的是 Hermes Agent(约 4.8B tokens),其后是 PostQode、omp、pi、Reductor,可据此判断真实生产场景长什么样。
具体的通用接线步骤可参考站内 Ox Alpha 免费模型 API 接入教程,把模型名换掉即可。
验证成功:怎么确认跑通了
三个信号满足其一即算跑通:
- 非 stream 请求返回了完整 JSON,且 usage 里有 token 统计。
- stream 请求能看到增量片段连续到达。
- OpenRouter 后台 Activity 页出现了你自己的调用记录。
上线一周后的真实运行数据
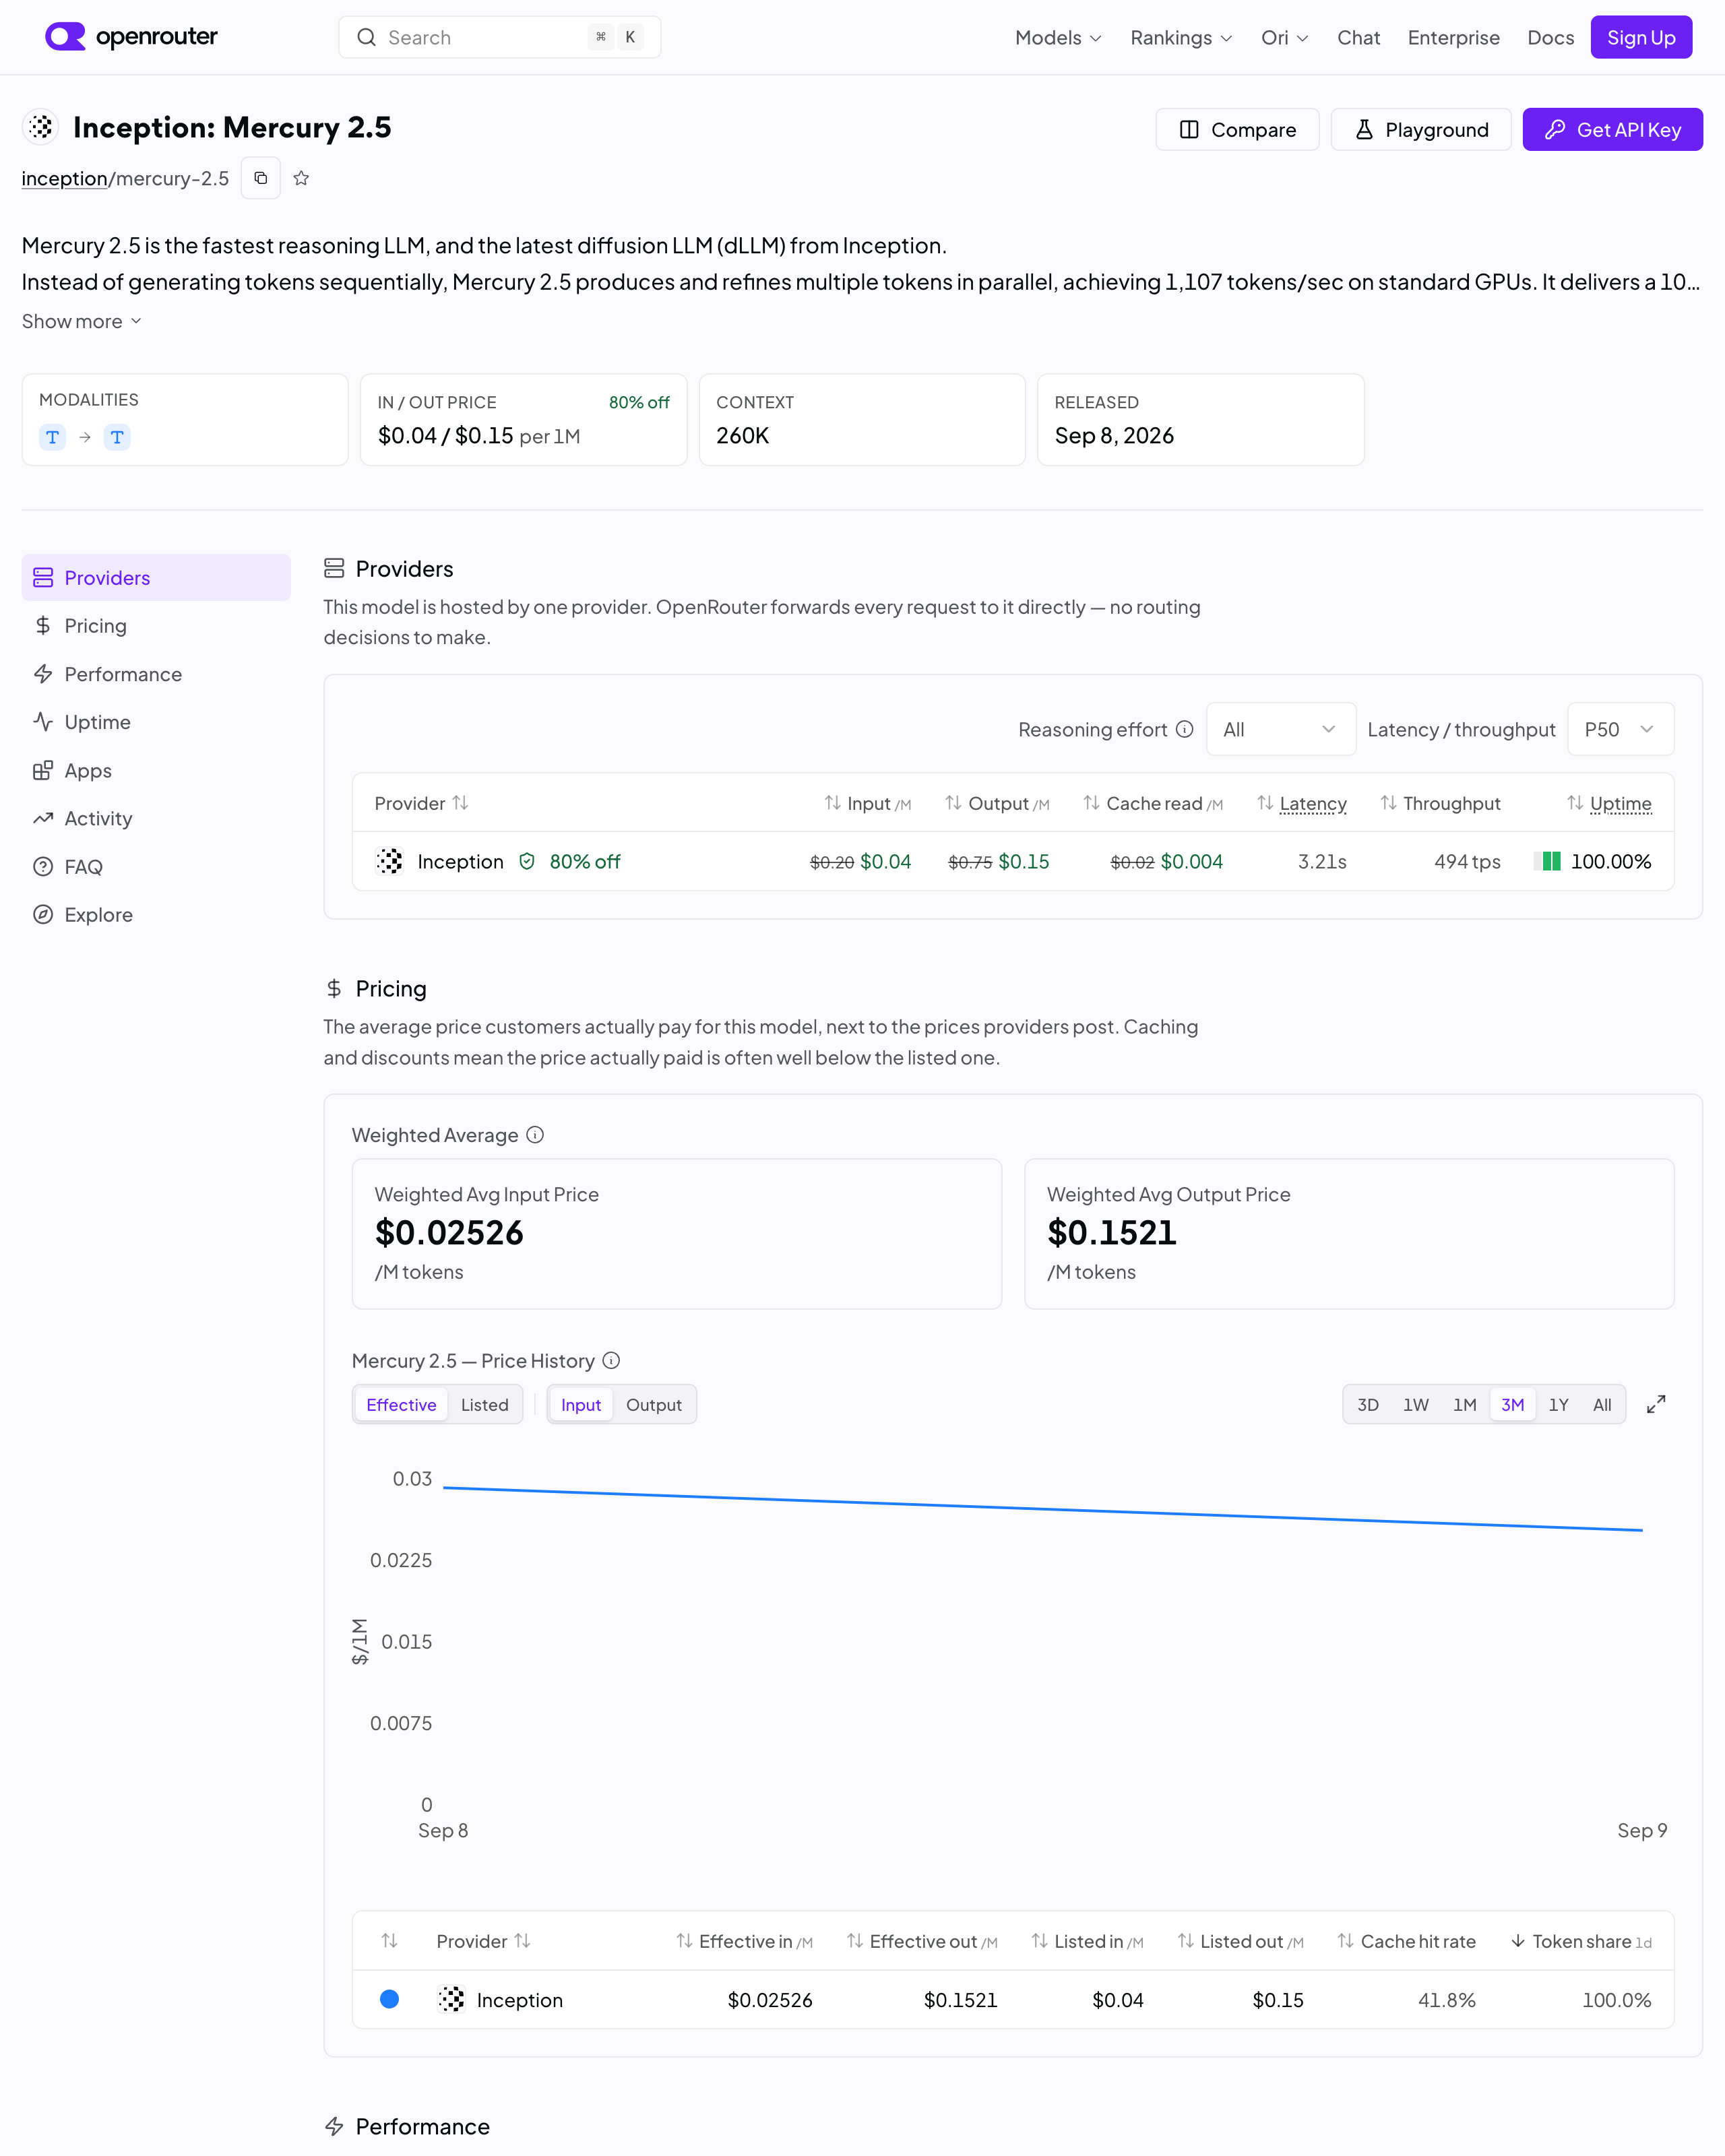
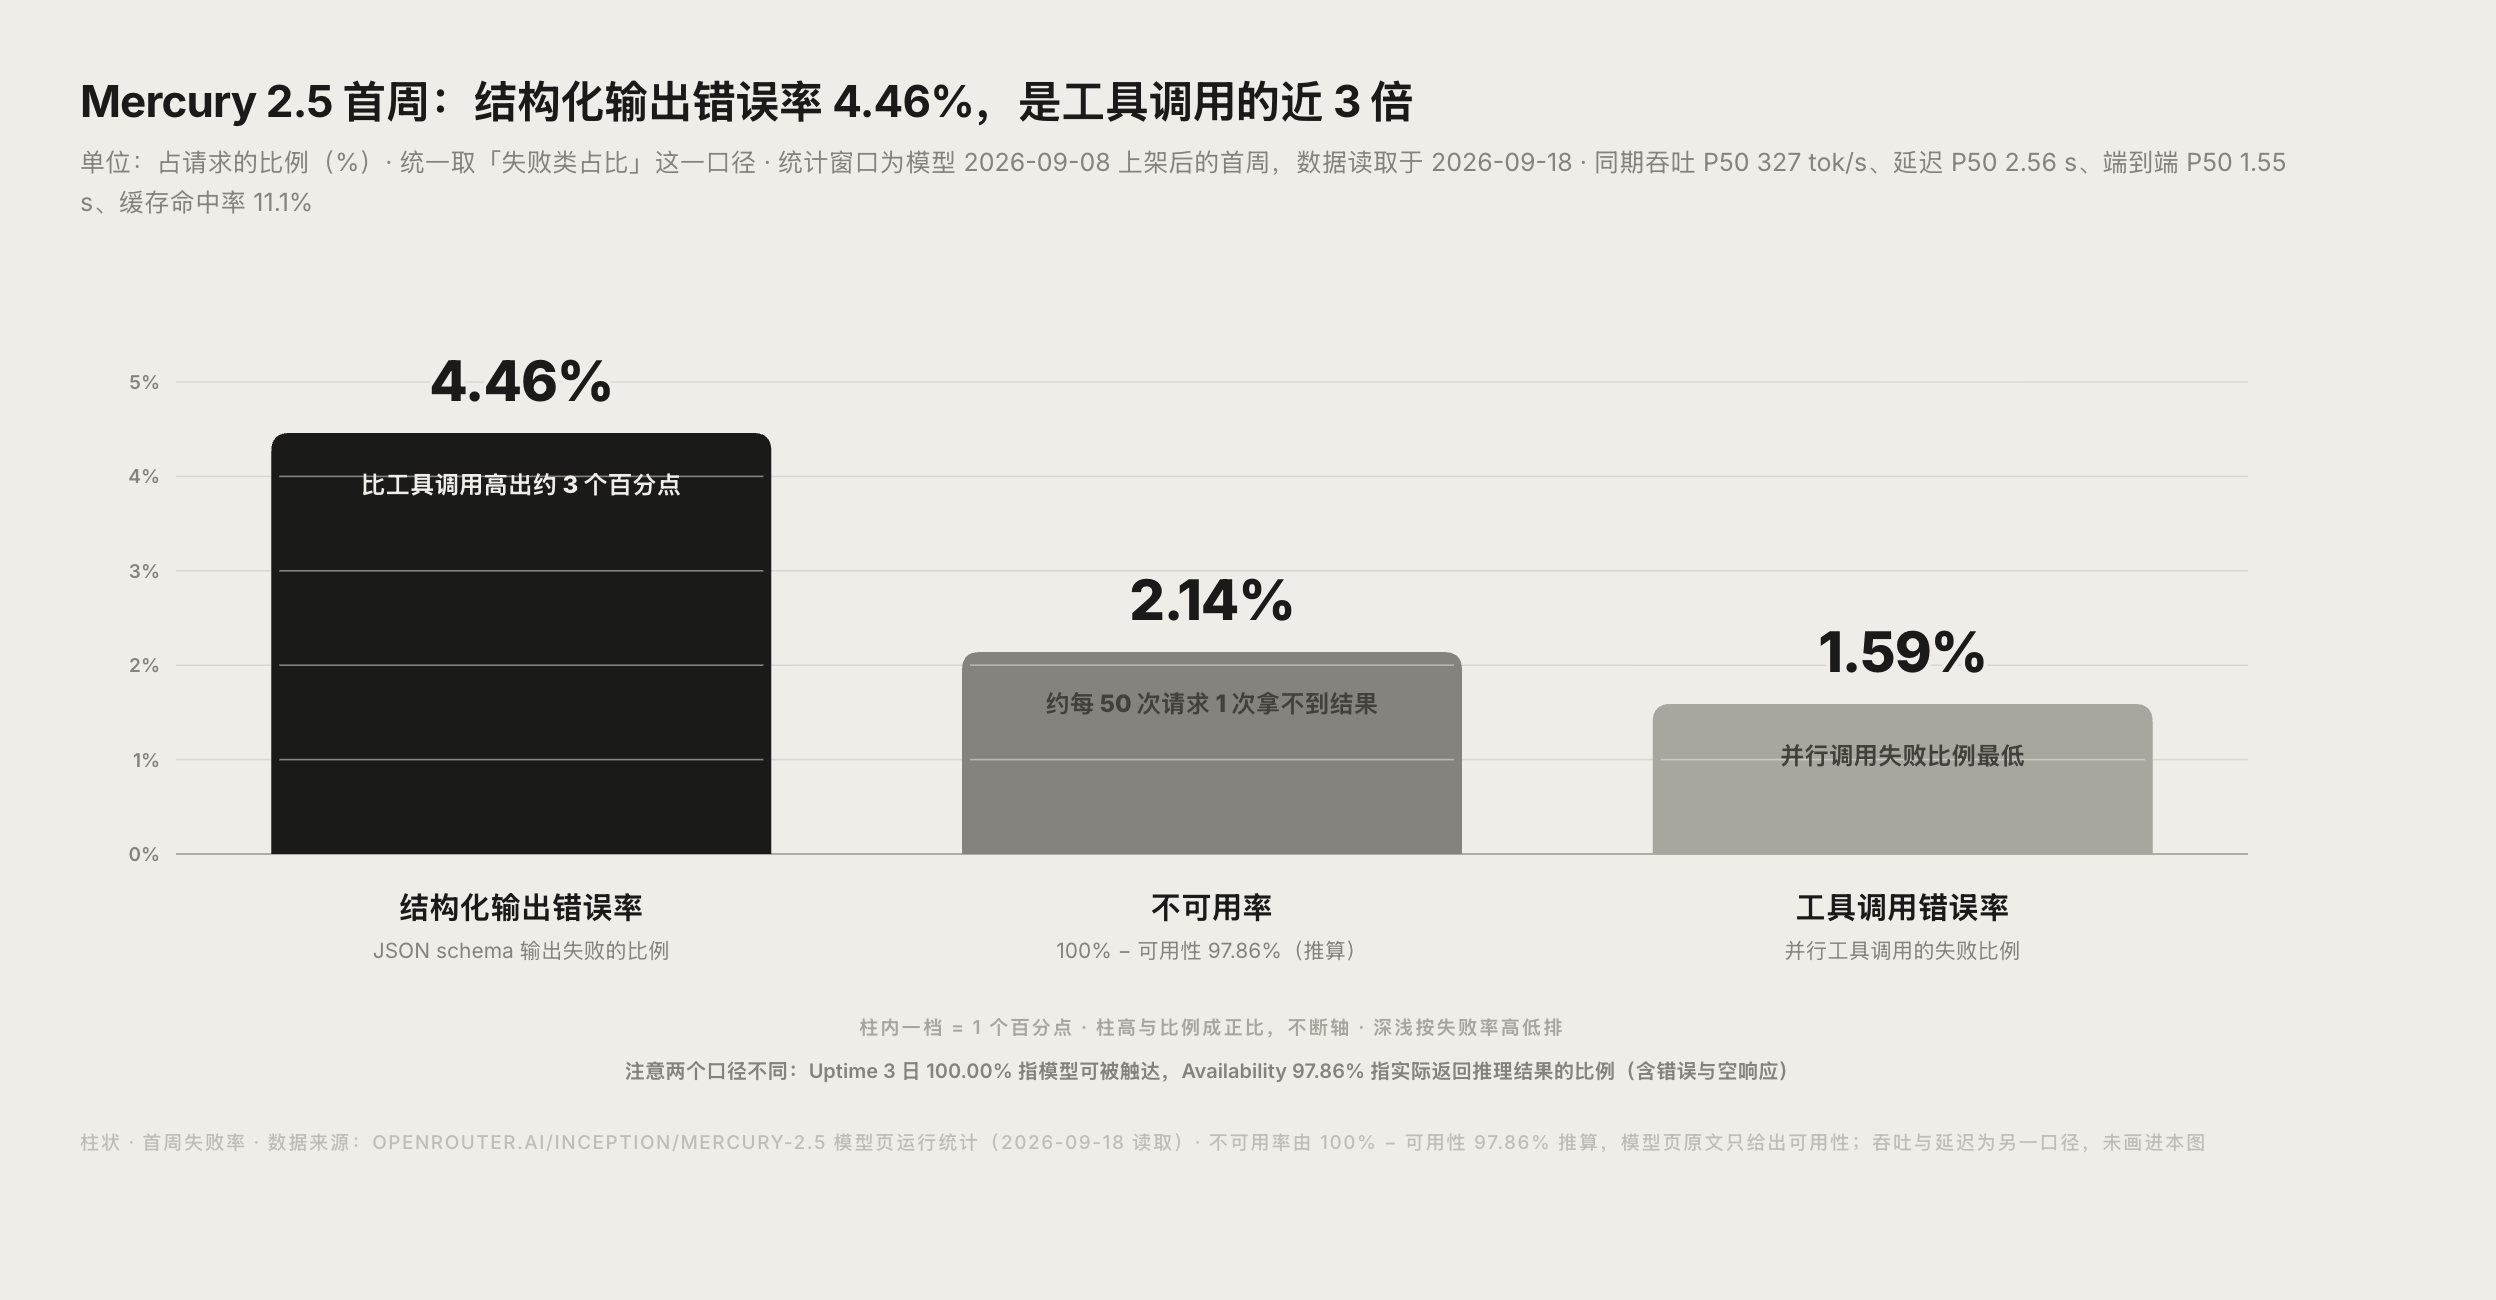
Mercury 2.5 于 2026 年 9 月 8 日上架,到 9 月 18 日已经积累了可查的运行统计。以下数字取自 OpenRouter 模型页(2026 年 9 月 18 日口径),是决定「要不要接进生产」最该看的一组:
| 指标 | 数值 | 说明 |
|---|---|---|
| 可用性 Uptime(3 日) | 100.00% | 模型可被触达 |
| 成功率 Availability(3 日) | 97.86% | 实际返回推理结果的比例,含错误与空响应 |
| 吞吐(P50) | 327 tokens/秒 | 与官方 1,107 tokens/秒的差距来自端到端转发与排队 |
| 延迟(P50) | 2.56 秒 | 单次请求往返 |
| 端到端延迟(P50) | 1.55 秒 | 含排队与网络 |
| 工具调用错误率 | 约 1.59% | 并行工具调用的失败比例 |
| 结构化输出错误率 | 约 4.46% | JSON schema 输出的失败比例,比工具调用高一截 |
| 缓存命中率 | 约 11.1% | 命中即按 $0.004 每百万 token 计费 |
| 实际加权单价 | 输入 $0.04532 / 输出 $0.1764 每百万 | 折后实际支付价,通常低于列表价 |
这组数字有两个直接结论。第一,缓存命中率只有约一成,说明大部分输入仍按未命中价计费,想省钱就得把长且稳定的系统提示做成可缓存前缀。第二,结构化输出的错误率比工具调用高约 3 个百分点,凡是拿 JSON 结果直接入库的场景,必须加一次 schema 校验与自动重试。
边界与前提:哪些情况先别接
- 可用性不是 100%。Availability 97.86% 意味着大约每 50 次请求会有 1 次拿不到结果,搜索 Agent、语音管线这类同步链路必须有降级与重试。
- 只有一家供应商。模型页说明该模型由单一供应商托管,OpenRouter 不做路由决策,也就是说这家上游抖动时没有替补可切。
- 活动价是 8 折,随时可能变。列表价 $0.20/$0.75 才是常态价,做预算时按列表价算上限更稳。
- 上下文 260K,但单次输出上限 65,536 token。要生成超长文档得自己分段。
- 国内访问仍有门槛。OpenRouter 本体可访问,但充值走支付通道、以及部分上游的合规要求,需要按站内教程确认。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 401 Unauthorized | Key 错误或带空格 | 重新复制 Key,检查 Authorization 头 |
| 402 Payment Required | 余额不足 | 后台充值,活动价下 5 美元可测试很久 |
| 429 Too Many Requests | 触发限速 | 降低并发,或稍后重试 |
| 返回 5xx 或超时 | 上游波动,上线初期常见 | 查看模型页 Uptime 曲线,加重试逻辑 |
| JSON 输出解析失败 | 结构化输出错误率约 4.46% | 加 schema 校验,失败自动重试一次 |
| 工具调用偶发失败 | 工具调用错误率约 1.59% | 校验工具入参,对失败调用做幂等重试 |
| 首包不够快 | 未开启 stream | 请求体加 "stream": true,让增量片段先到达 |
常见问题
调用 Mercury 2.5 需要换 SDK 吗?
答:不需要。OpenRouter 接口 OpenAI 兼容,只改 base_url 和 model 名两个地方,官方还提供 Anthropic Messages 和 Responses 格式端点。
有没有免费额度可以试?
答:Mercury 2.5 本身按量计费,页面未见免费档。想零成本体验可以在 OpenRouter 的 Playground 里少量试玩,或参考 [OpenRouter 是什么?免费额度、价格与 400+ 模型调用全解](https://www.ai345.info/ai-guide/openrouter-complete-guide) 选择其他免费模型。
国内用户怎么充值?
答:OpenRouter 支持支付宝充值,从后台 Billing 入口进入,具体步骤和常见坑见站内 OpenRouter 使用教程。
reasoning 参数怎么用?
答:在请求体里加 reasoning 字段控制推理等级,响应的 reasoning_details 数组返回思考过程;多轮对话时需要把完整 reasoning_details 传回去,模型才能接着想。
适合接入哪些业务场景?
答:官方定位是搜索 Agent、语音管线、编码子代理这类延迟敏感场景。想了解模型本身的定位和背景,先读 [Mercury 2.5 是什么?扩散大模型已上架 OpenRouter,最快 1107 token/秒](https://www.ai345.info/ai-guide/mercury-2-5-explained)。
怎么估算一次调用的成本?
答:看响应里 usage 字段的 prompt_tokens 和 completion_tokens,乘以当前单价(活动价输入 $0.04、输出 $0.15、缓存读 $0.004 每百万 token)即可,OpenRouter 后台也会按天汇总账单。
 京ICP备2024094994号-29