
Mercury 2.5 替代品怎么选:5 类场景与成本对照
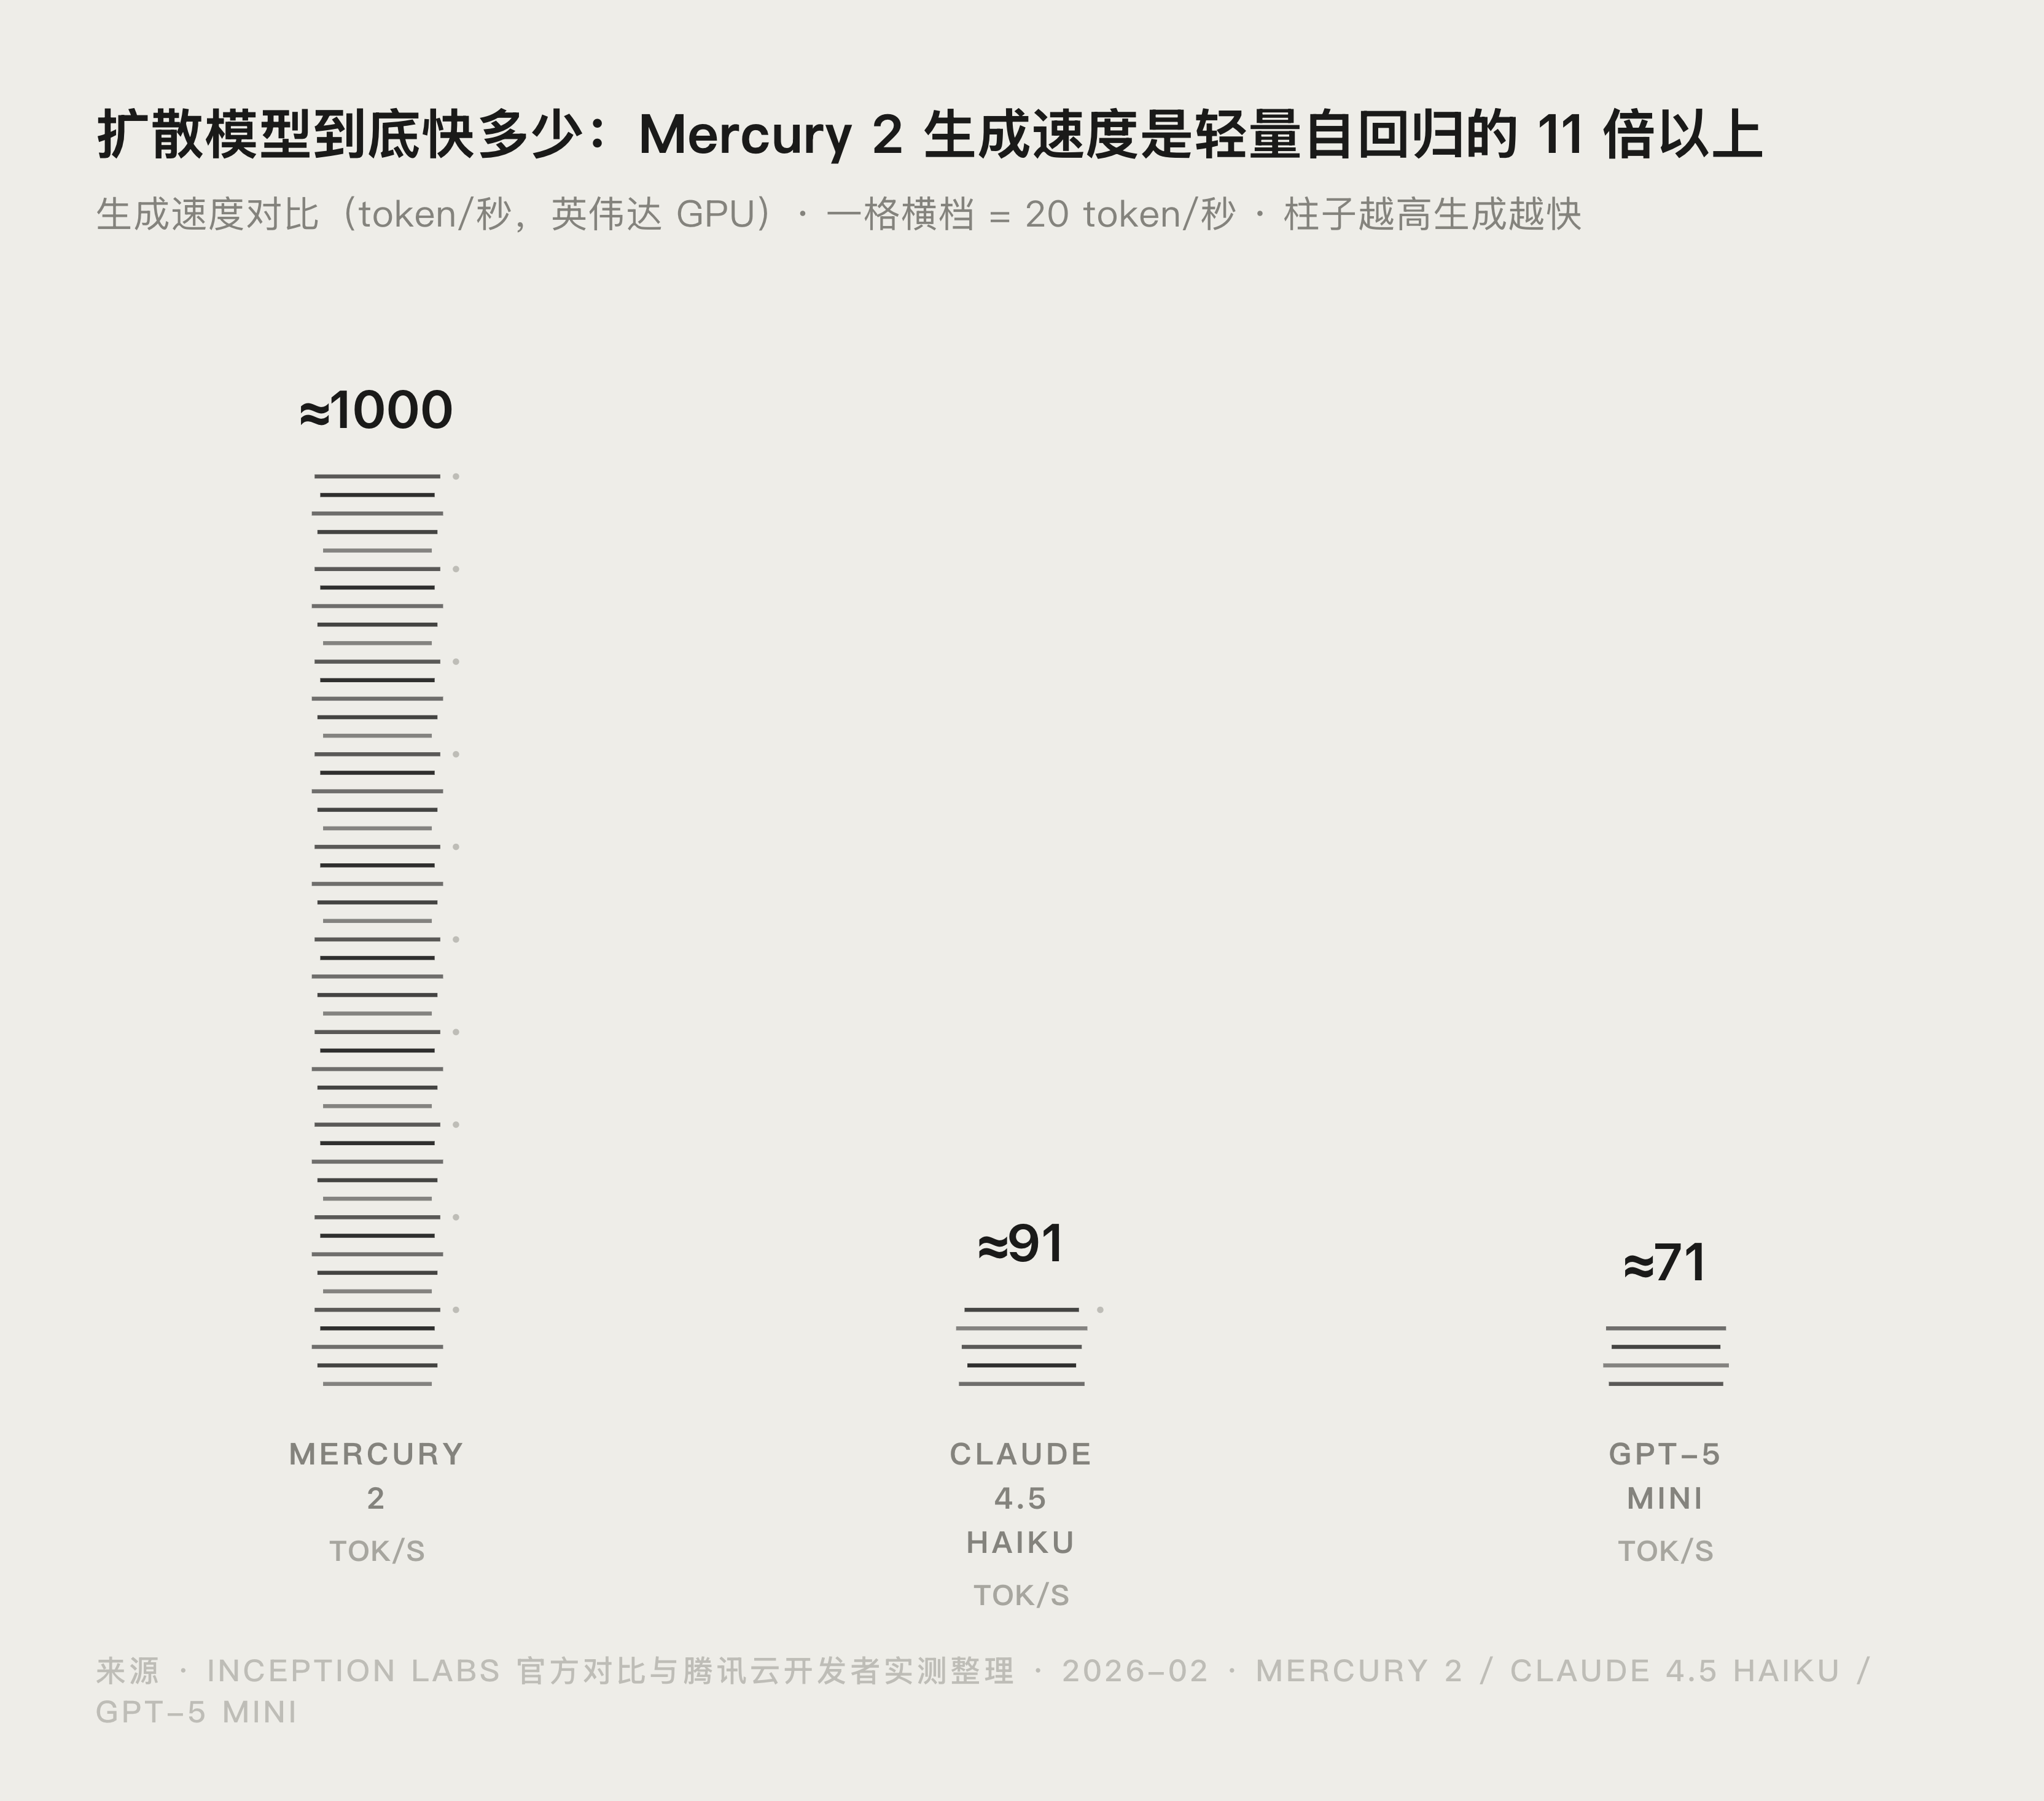
Mercury 2.5 是 Inception Labs 推出的扩散式大语言模型(在 OpenRouter 上可见),核心卖点是「用扩散替代自回归」带来的超高吞吐:每秒约 1000 token、端到端一轮只约 1.7 秒、输出每百万 token 约 0.75 美元,math 基准 AIME 2025 到 91 分。但如果你觉得它不合适(生态太嫩、复杂推理靠有限、中文/合规需要),本文从 5 类使用场景给替代方案并算清成本。
一句话结论:服务实时交互或大批量 RAG 选扩散系;低频要极深推理选 Gemini 3 系、轻量通用选 Claude Haiku 这类自回归;必须国内合规则走 GLM/DeepSeek。
五分钟看懂 Mercury 2.5 的底牌
它来自 Inception Labs(斯坦福、UCLA、康奈尔学者创立),站内 Mercury 2.5 是什么 有架构详解,这里只留判断替代品要用的底牌。和 GPT/Claude/Gemini 这些自回归模型「一个 token 一个 token 打」不同,它把扩散模型整套从图像搬到了语言:先铺一段草稿,所有位置同时改、同时优化,迭代收敛。这正是它快的主要来源。
| 维度 | Mercury 2 官方数据(扩散) |
|---|---|
| 生成速度 | 约 1000 token/秒 |
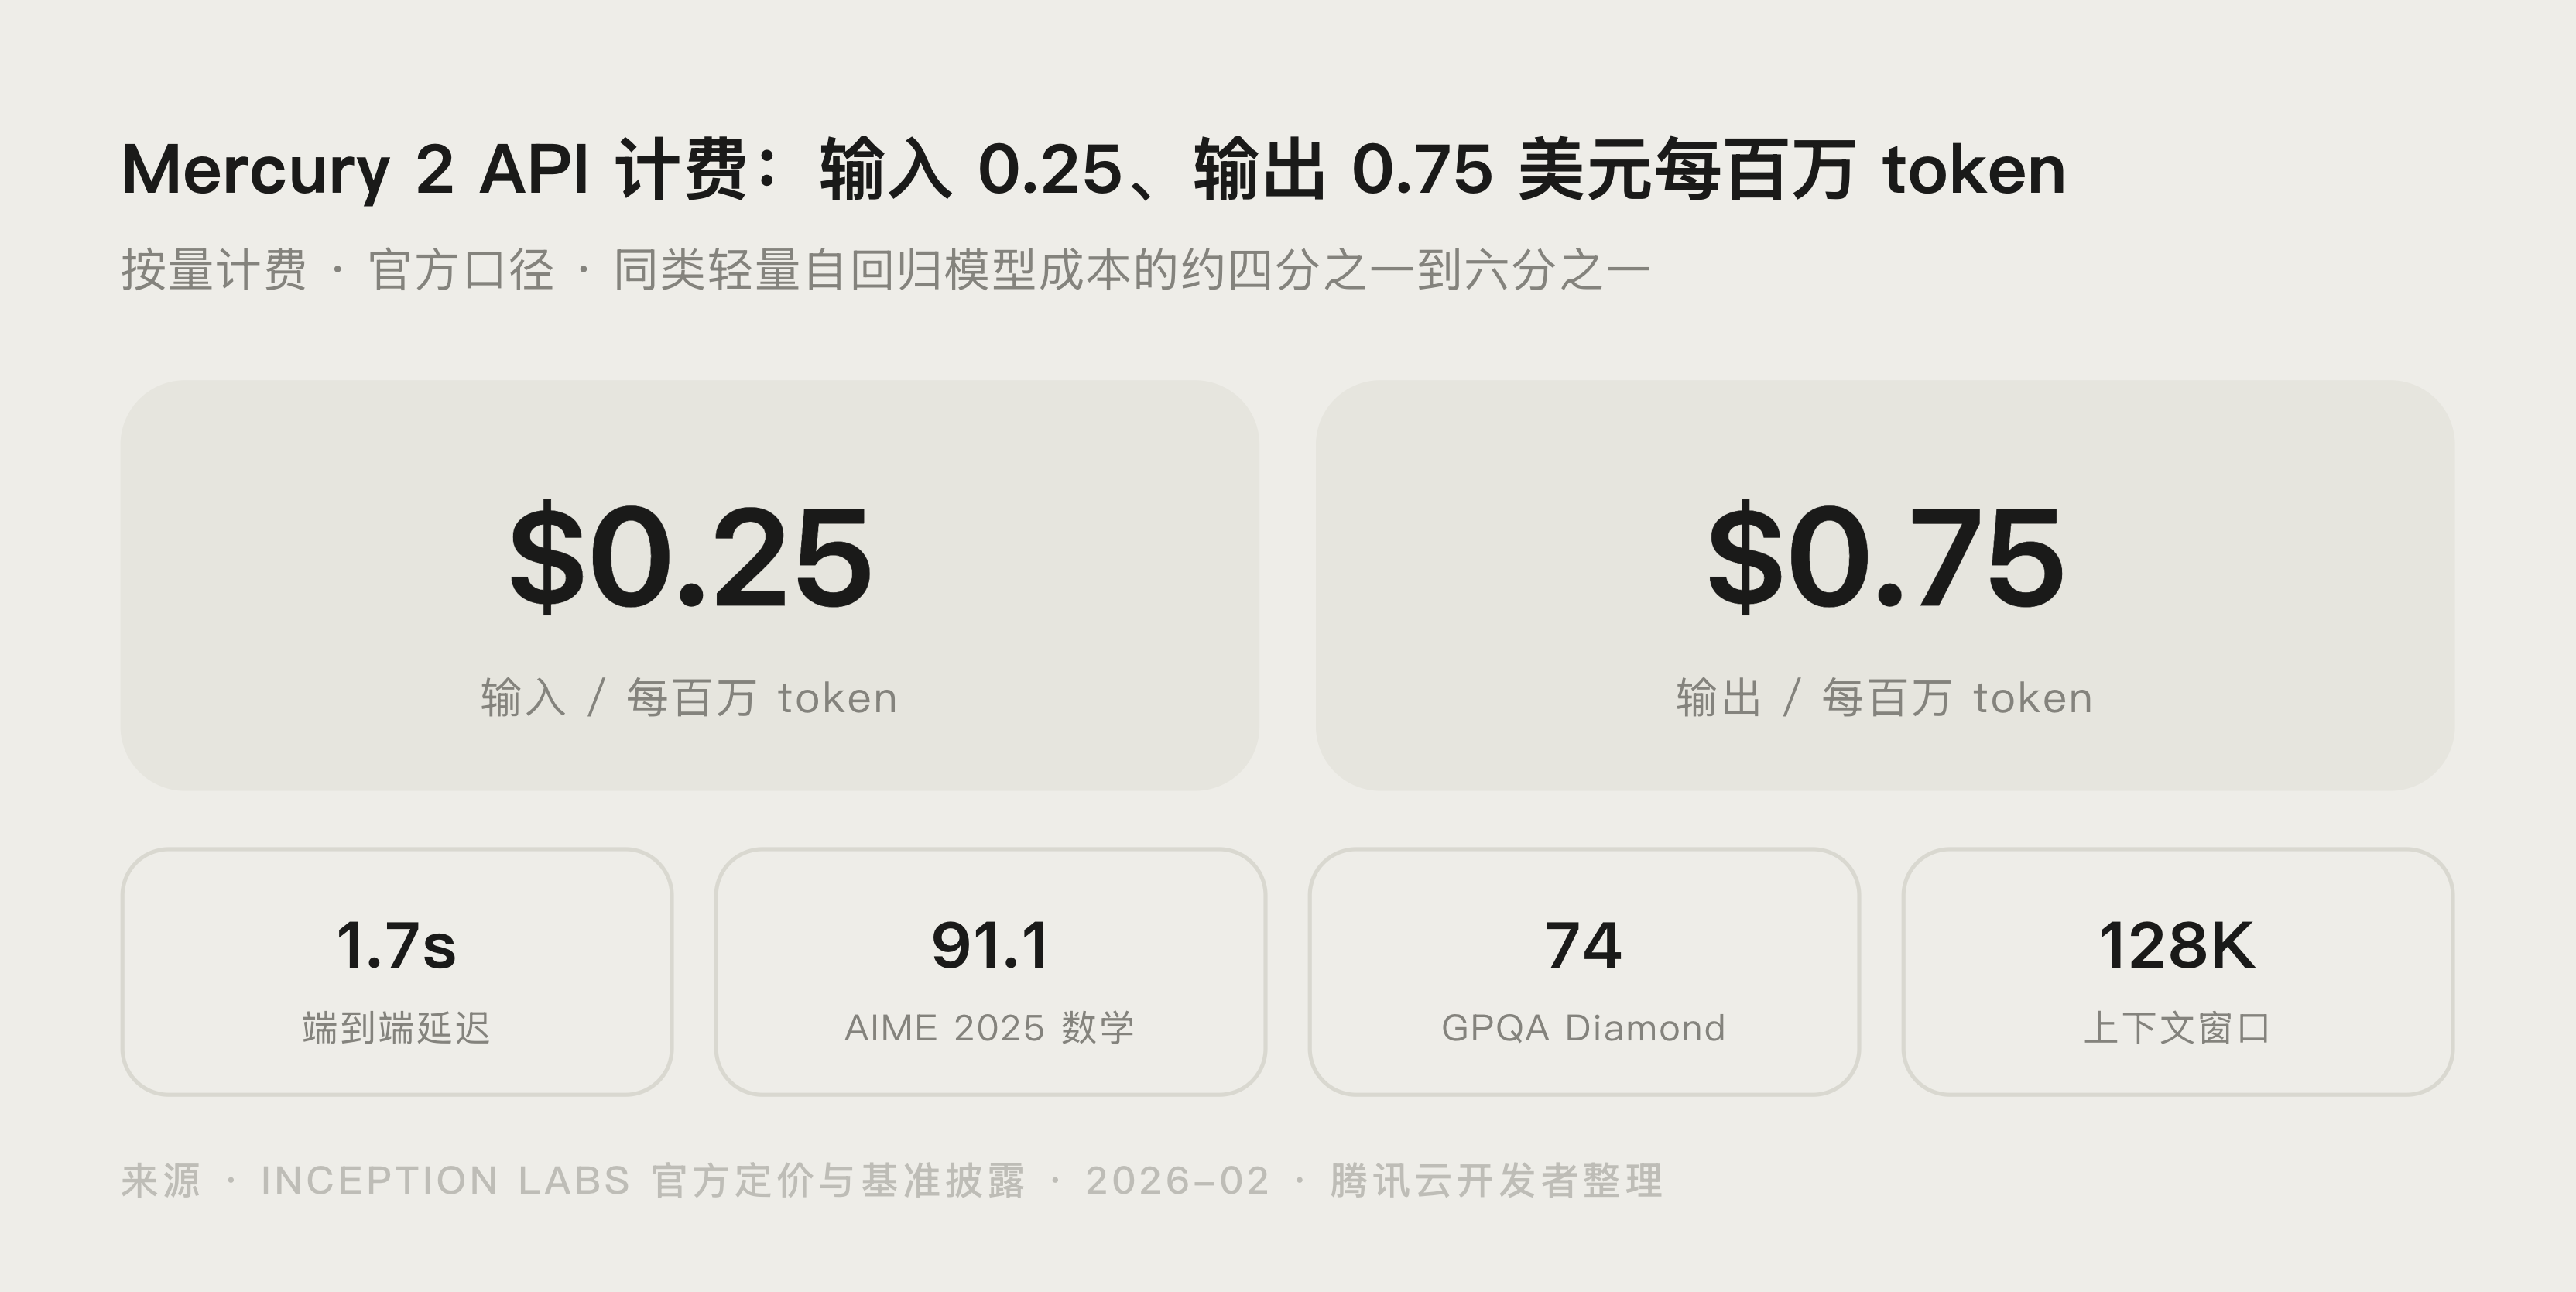
| 端到端延迟 | 约 1.7 秒(端到端) |
| 成本(输出) | 每百万 token 0.75 美元 |
| 成本(输入) | 每百万 token 0.25 美元 |
| Math 基准 | AIME 2025:91.1 分 |
| 研究生级问答 | GPQA Diamond:74 分 |
| 上下文 | 128K |
※ 上表数据来自腾讯云开发者社区对 Mercury 2 的实测解读(2026-03-05);Mercury 2.5 是 OpenRouter 上的最新版本,具体数值以官方发布为准,本表用于帮助理解扩散系的能力基线。原始数据见 腾讯云开发者对 Mercury 2 的实测解读。
替代品其实是按「你想要什么」分类,不是一款顶一款
没有单一模型能同时赢下「速度、推理深度、开源可自跑、国内合规」。下面按场景给:
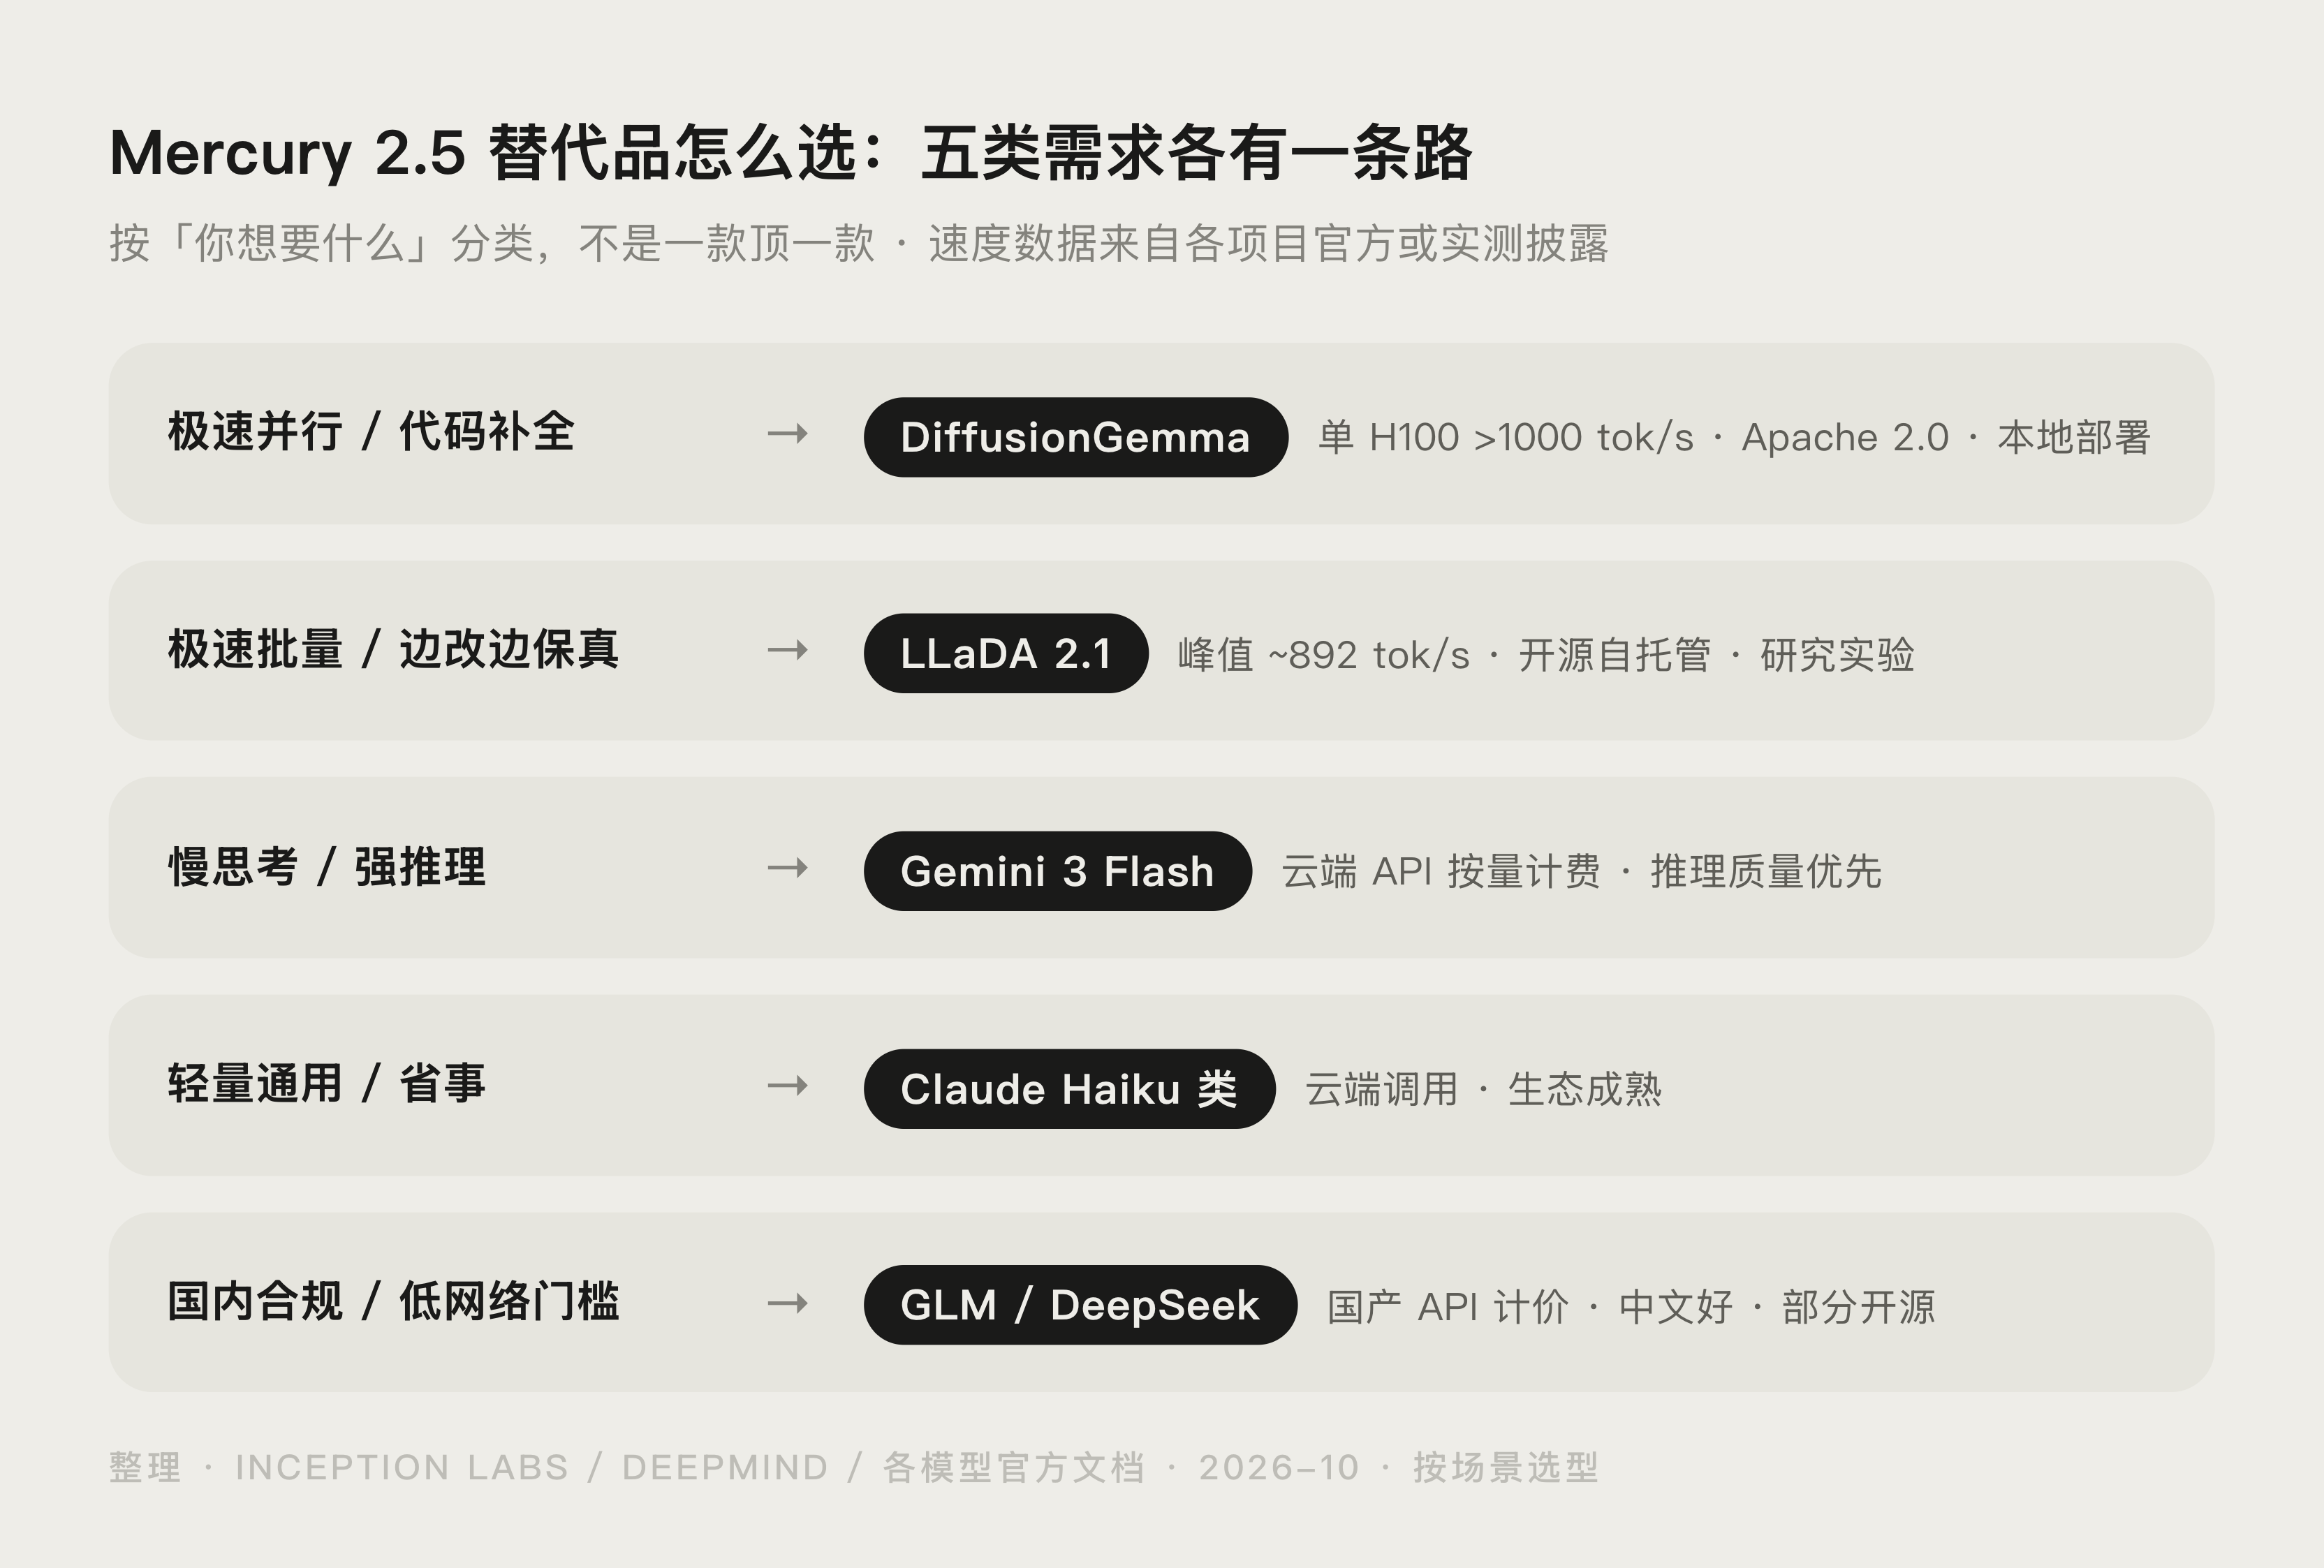
1. 追求极致速度 + 可控本地:扩散模型系
- DiffusionGemma(Google,2026-06-11 开源):26B MoE、激活约 3.8B,一次并行 256 token 画布,单张 H100 实测输出超 1000 token/秒,RTX 5090 上超 700 token/秒,相比同规模自回归最高提速 4 倍,Apache 2.0 可商用。
- LLaDA 2.1:这条赛道另一标杆,100B 级,峰值约 892 token/秒,边生成边纠错,双模式可切换。
它们的共同点:开源、可自托、对延迟敏感型代码补全和 RAG 友好;短板是复杂推理/生态不如自回归成熟。DiffusionGemma 的发布口径可对照 CSDN 对 Google 开源 DiffusionGemma 的解读。
2. 延迟敏感、且要强推理:Gemini 3 Flash 系
如果你要的不是「快到惊人」而是「不卡又能推理」,Gemini 3 Flash(Reasoning)在 GPQA Diamond 上能到 90 分(Mercury 2 是 74 分)。官方 API 有 flash 计费档,适合实时语音 agent、多 agent 系统中「要思考又别太慢」的中间层。站内已做过《Mercury 2.5 和 Gemini 3.8 Flash 哪个好?》对比(/ai-guide/mercury-2-5-vs-gemini-3-8-flash),可先看。
3. 轻量通用 + 省事:Claude Haiku 类
Haiku 这类轻量自回归模型速度也不差、生态成熟,接入用现有 OpenAI 兼容 SDK 就好。适合文档摘要、低成本多轮对话,不求一秒级高峰体验。要真正了解 Claude 生态上手难度,参考站内《Claude Code 提示词技巧》(/ai-guide/claude-code-prompt-tips)。
4. 国内合规 / 省接入成本:GLM、DeepSeek
国内业务、合规要求、或懒得申请人网络:选择国产通道(GLM、DeepSeek)是最省心的替代。它们的优势是对国内网络和备案更顺手,缺点是与扩散模型相比速度韧性一般。国内可用渠道、门槛详见站内《Mercury 2.5 国内能用吗》(/ai-guide/mercury-2-5-china-availability)。
一张 6 维度替代对象矩阵
| 需求场景 | 推荐替代 | 速度 | 价格参考 | 是否开源 | 接入场景 |
|---|---|---|---|---|---|
| 极速并行/代码补全 | DiffusionGemma | 单 H100 >1000 tok/s | 自托成本随 GPU | 是 (Apache 2.0) | 本地/私有部署 |
| 极速批量、边改边保真 | LLaDA 2.1 | 峰值 ~892 tok/s | 开源自托 | 是 | 本地研究/实验 |
| 慢神经元/强推理 | Gemini 3 Flash(Reasoning) | 中等 | 按 API 计费 | 否 | 云端 API |
| 轻量通用/省事 | Claude Haiku 类 | 快 | 按 API 计费 | 否 | 云上调用 |
| 国内合规/低网络 | GLM / DeepSeek | 中等 | 国产 API 计价 | 部分开源 | 国内云/私有 |
替换成本:从 Mercury 换过去要动什么
- 换成模型(API):改动小,SDK 换成对应官方 API 或接入网关,主要重测 prompt 效果;成本结构要重测,Mercury 按 token 计,DiffusionGemma 按 GPU 时长。
- 换成扩散系并自托管:要租 GPU、配推理栈(如 llama.cpp 或专项 runtime),成本全转移到运维;但数据和参数都自持,适合合规场景。
- 换成国内模型:需要权审内容和版权,中文支持通常更好但不一定能复现 Mercury 的速度;得在延迟与合规之间挪。
该选谁?按你的头像落座
- 你是 AI 助手写了大量 RAG/客服:追求吞吐和成本,首选 DiffusionGemma 或 LLaDA,跑在自己 GPU 上;本地没法挂就用 API 的 Gemini 3 Flash。
- 你是多 Agent 循环/搜索每跳都要快:Mercury 这类并行模型直接合适,若预算够选 Gemini 3 Flash 系保证推理;代码向 agent 要多看社区实测再定。
- 你是个人开发者做中文工具:先走 GLM/DeepSeek 试,避免合规和网络坑,功能验证完再考虑要不要切扩散。Mercury 本身的接入与计费可见 Mercury 2.5 价格多少钱一个月 与 Mercury 2.5 怎么用?OpenRouter 调用教程,单挑 Gemini 3.8 Flash 的对比见 Mercury 2.5 和 Gemini 3.8 Flash 哪个好。
常见问题
Mercury 2.5 和 Gemini 3.8 Flash 哪个更能打?
答:看要什么:Mercury 主打速度和 token 吞吐、成本低;Gemini 3.8 Flash 在高层推理和多模态生态上更完整。做实时问答先用 Mercury,做复杂多步推理优先 Gemini 3 Flash 系。站内有独立对比文可查。
开源扩散模型里 DiffusionGemma 和 LLaDA 选谁?
答:diffusionGemma 是专业产品导(Google,激活 4B、H100 超 1000 tok/s),偏代码补全和本地实时;LLaDA 是研究基线偏批量、边生成边改。都 Apache 系,按你 GPU 和任务吞吐选。
换到开源扩散模型硬成本贵不贵?
答:贵在有 GPU 成本(租云或本地),并且要自建推理栈;好处是不再按 token 付费、数据自持。小流量手滑用户可以先走官方 API 试,再决定要不要上 GPU。
做国内项目为什么要优先选 GLM/DeepSeek?
答:主要是合规与网络。GLM/DeepSeek 在国内网络延迟低、API 接入顺,无需代理,适合中文项目和强监管行业;扩散模型的并行又快,但生态和中文支持目前未必更好。
Mercury 2.5 到底贵不贵?表里的价格怎么来的?
答:Mercury(2 代)官方价格:输入 0.25 美元/百万、输出 0.75 美元/百万 token,约为对手的四成到六分之一,来源见腾讯云开发者解读。2.5 代以 OpenRouter 实时报价为准,定价会随版本浮动。
 京ICP备2024094994号-29