
LFM3-Omni-2B 本地部署:1.39GB 权重跑语音
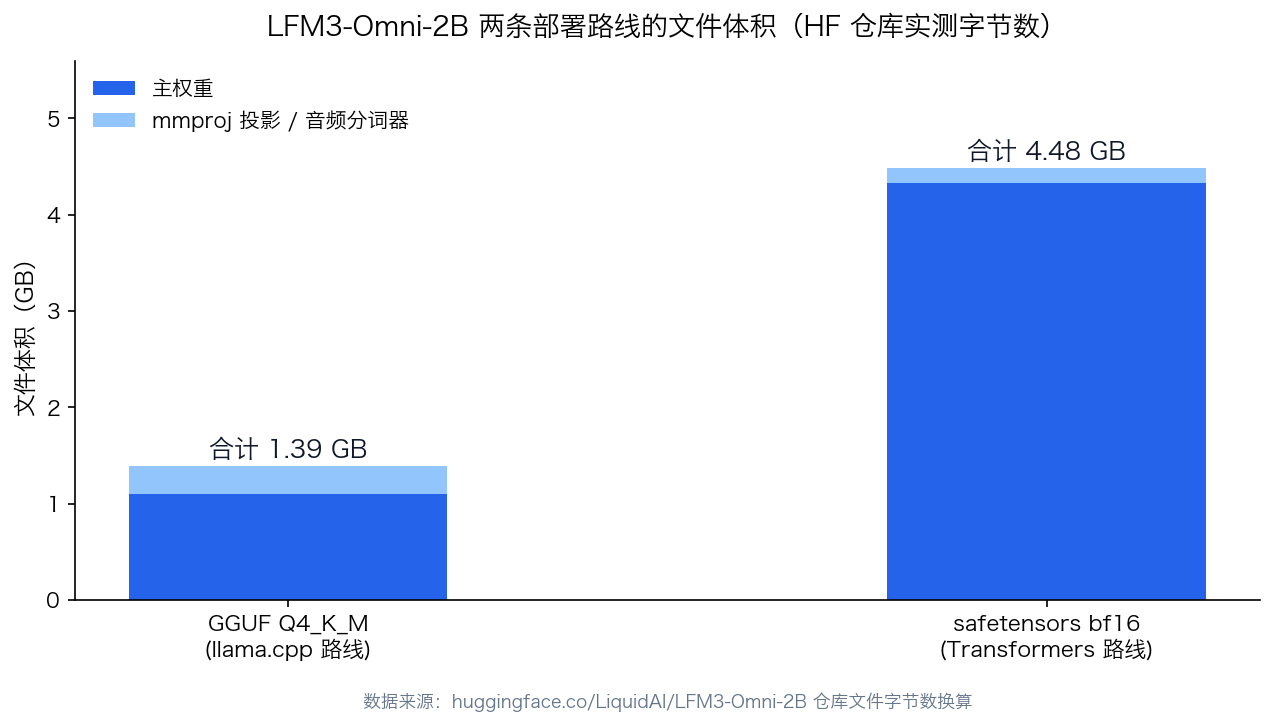
LFM3-Omni-2B 本地部署只有两条路,选错了会白折腾。走 llama.cpp 的 Q4_K_M,1.1 GB 权重加 0.29 GB 多模态投影,8 GB 内存的笔记本就能跑语音。走 Transformers 的 bf16,光权重就要 4.33 GB,还得挂在显卡上。
这个模型是 Liquid AI 2026 年 10 月 27 日发布的 LFM3 家族里的全模态型号,官方定位是一个端到端模型同时顶掉 ASR、视觉语言模型、LLM 和 TTS 四套东西。听中文、看图、看视频带原声,输出文本或 24 kHz 语音。
下面把两条路的门槛、命令、验证方法和踩坑点一次讲清,最后说清它和 LFM3-1.7B 文本模型该怎么分工,别在一台机器上装两遍重复的东西。
先看清它到底是个什么模型
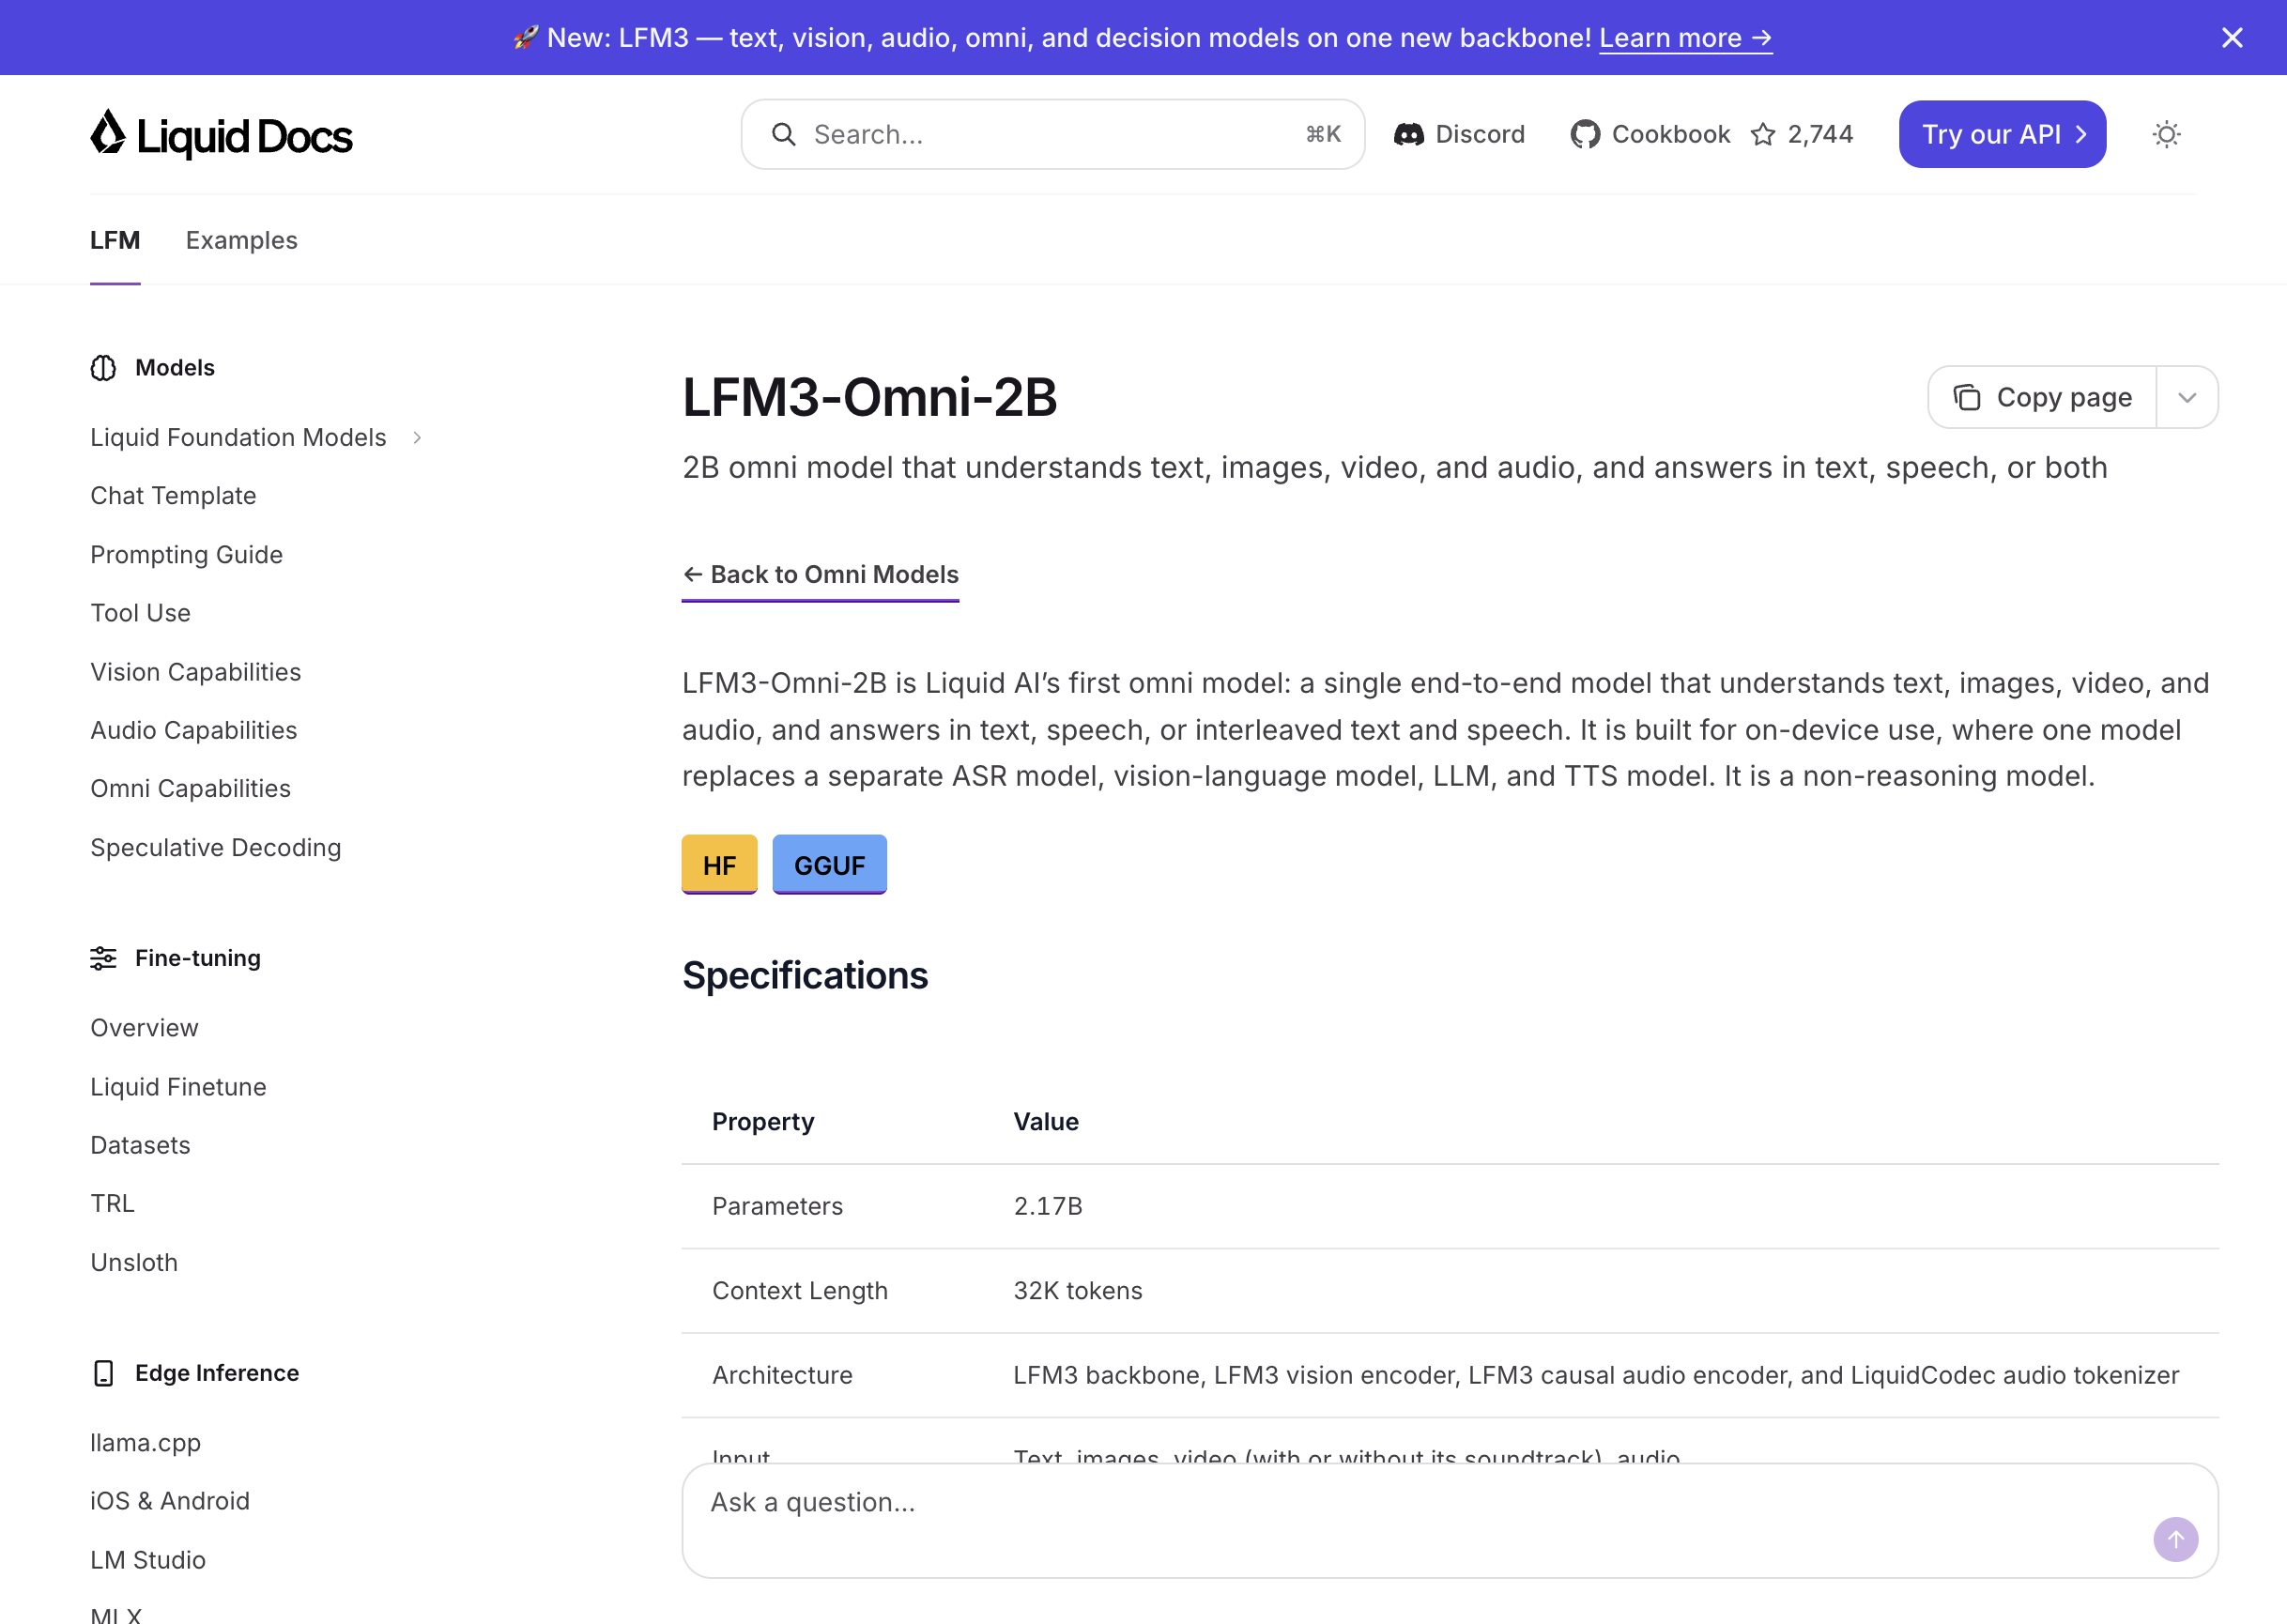
参数 2.17B,上下文 32K tokens,词表 128000(规格以官方模型页和 Liquid 官方文档为准)。架构是 LFM3 主干加三个附件:视觉编码器、因果音频编码器、LiquidCodec 音频分词器。
输入支持文本、图像、视频(带不带原声都行)、16 kHz 音频。输出是文本、24 kHz 语音,或者两者交织。图像和视频按原生分辨率处理,视频按每秒 2 帧采样,每 2×2 的 patch 块折成一个语言 token。
文本支持 16 种语言,含中文。语音支持 19 个语言和地区,也含中文。许可证是 LFM Open License v1.0。
有一个必须提前知道的设定,官方模型卡写得很直接,这是非推理模型,不支持 enable_thinking=True。你翻遍参数也找不到「深度思考」开关,想让它先想再答,得自己在提示词里要求。
硬件门槛:官方没给显存数字,但文件体积能算出来
官方文档没有公布 Omni-2B 的内存或显存要求。能查到的硬指标是 Hugging Face 仓库里每个量化文件的真实大小,这些数字我自己核过。
| 版本 | 主权重 | 多模态投影 mmproj | 合计下载 | 适合谁 |
|---|---|---|---|---|
| Q4_0 | 1.05 GB | 0.27 GB | 约 1.32 GB | 内存最紧,质量换空间 |
| Q4_K_M | 1.10 GB | 0.29 GB | 约 1.39 GB | 默认推荐,平衡点 |
| Q8_0 | 1.85 GB | 0.51 GB | 约 2.36 GB | 质量优先,4 位明显掉分时用 |
| F16 / BF16 | 3.47 GB | 0.95 GB | 约 4.42 GB | 显卡跑满精度,或做量化基准 |
按这张表选机器就够用了。8 GB 内存的轻薄本跑 Q4_K_M 有余量,16 GB 可以舒服地开到 Q8_0,要给视频加长音频留缓存就再往上走一档。
走 Transformers 那条路是另一套账:model.safetensors 单个文件 4.33 GB,再加 0.15 GB 的音频分词器。官方示例用 bfloat16,没有 GPU 时脚本会退回 float32,内存占用直接翻倍。所以没显卡就别走这条路。
路线一:llama.cpp 跑 GGUF,推荐大多数人走这条
这是官方明确写成「本地 CPU 和 GPU 推理」的那条路,也是唯一能出语音的路。SGLang 那条 GPU 服务路线只吐文本,这点官方写得很清楚。
第一步,把 llama.cpp 升到 v0.8.0 以上
版本号是硬门槛,低于 b11960 会直接加载失败。模型卡要求 v0.8.0(b11960)或更新版本。
macOS 用 Homebrew 一条命令:
brew install llama.cpp- 装完敲
llama --version确认版本号,别只看装成功没报错
Windows 和 Linux 去 llama.cpp 的 releases 页面下预编译包,文件名里带 cu12 的是英伟达显卡版,带 avx2 的是纯 CPU 版,带 vulkan 的能吃 AMD 和 Intel 显卡。
第二步,启动服务
一条命令搞定,-hf 会自动把权重、视觉投影和音频投影一起拉下来:
llama serve -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --reasoning off --temp 0 --port 8080
三个参数各有原因,少一个都会出怪问题。
--reasoning off 不能省。模型是非推理模型,不加这个参数服务端会按推理模型的模板去套,回复可能带上不该有的思考段。
--temp 0 对应官方的贪心解码建议,文本输出要稳定就压到 0。
--port 8080 是模型卡示例的端口。官方文档另一处写的是 9931,两个都对,差别只是谁先占了端口。你自己定了就一路用同一个。
服务起来之后,浏览器开 http://localhost:8080 就是网页聊天界面,同时它也提供 OpenAI 兼容接口,现有代码把 base_url 指过来就能用。
第三步,用命令行验证四类输入
先验语音转写。这里有个反直觉的点,系统提示词必须用 -sys 传,写成普通提示词的话模型会去描述这段音频,而不是转写它。
llama cli -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --audio speech.wav -sys "Perform ASR in Chinese." -p "<__media__>" --temp 0
<__media__> 是占位符,标记音频插在哪个位置,不能漏。
再验图片理解:
llama cli -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --image photo.png -p "Describe this image." --temp 0
然后验视频带原声,这条最能体现它和单模态模型的差别:
llama cli -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --video reading.mp4 -sys "Answer questions about the video using what you see and hear." -p "What happens here, and what can you hear?" --temp 0
视频这条路要先把 ffmpeg 装好并放进 PATH,没装会直接报解码错误,不是模型的问题。
最后验语音合成。这里容易翻车,因为 llama 命令没有 TTS 子命令,得用单独的 llama-tts,而且要手动下两个文件:
hf download LiquidAI/LFM3-Omni-2B-GGUF LFM3-Omni-2B-Q4_K_M.gguf mmproj-LFM3-Omni-2B-Q8_0.gguf --local-dir .llama-tts -m LFM3-Omni-2B-Q4_K_M.gguf -mm mmproj-LFM3-Omni-2B-Q8_0.gguf -p "你好,这是一段测试语音" -o out.wav --tts-lang zh --tts-voice female
--tts-lang 默认是 en,不显式指定中文就会按英文发音规则去读中文,出来的音频听不懂。--tts-voice 只有 female 和 male 两档,默认 female。
路线二:Transformers 跑 bf16,要显卡、要出语音时选这条
只有在两种情况下值得走这条路:你要拿到语音输出并且不想装 llama.cpp 生态,或者你要做微调和二次开发。
环境准备
官方要求 transformers>=5.20.2,这个版本号是硬性的,低版本不认 lfm3_omni 这个模型类型。我查过 PyPI,5.20.2 确实存在,截至目前最新是 5.22.1,所以直接装最新版更省事。
pip install "transformers>=5.20.2" accelerate torch torchvision torchcodec pillow soundfile librosa
torchcodec 专门负责解码视频和视频里的音轨,不装就用不了视频输入。
加载和调用
模型类名是 AutoModelForMultimodalLM,不是常见的 AutoModelForCausalLM。trust_remote_code=True 必须加,因为这个架构的实现代码随模型仓库一起发布。
官方给的调用骨架里有一个关键对象值得注意,processor.audio_tokenizer。它负责把模型生成的语音 code 还原成 24 kHz 波形,漏掉它就只能拿文本,拿不到声音。
设置 generation_mode 能强制输出形态:"text" 只出文本,"audio" 只出语音,"interleaved" 文本和语音交织。不传就让模型按系统提示词自己判断。
语音输出的默认参数是 audio_temperature=0.4、audio_repetition_penalty=1.2、audio_repetition_window=64,这几个值就写在 generation_config.json 里,我核过文件内容,跟文档一致。
系统提示词就是功能开关
这个模型没有一堆独立开关,切功能靠系统提示词。记住这几条固定写法,比啃文档快。
- 语音转写:
Perform ASR in Chinese. - 语音合成:
Perform TTS in Chinese.,再补上 female 或 male - 语音翻译:
Convert the speech in German to written English.,进出英文效果最好 - 语音对话:
Respond with interleaved text and audio. - 看图问答:
Answer questions about the provided image. Base every answer only on what can be seen. - 视频问答:
Answer questions about the video using what you see and hear.
想要纯文本聊天就完全不加系统提示词,或者写 Respond with text.。
视频要连原声一起听,得同时传 load_audio_from_video=True 和 processor_kwargs={"use_audio_in_video": True}。只传帧不传声音的话,模型看不到也听不到音轨,问「能听到什么」它答不上来。
把它接到现有代码里
llama serve 起的是 OpenAI 兼容接口,现成客户端改一个 base_url 就能用,指向 http://localhost:8080/v1,api_key 随便填,本地服务不校验。
音频走 input_audio 内容块,data 放 base64 字符串,format 写 wav、mp3 或 flac。格式字段跟真实文件对不上就会解出噪音。
要实时语音对话别用这个普通接口,去连 /v1/realtime 的 WebSocket,工具调用也在这条链路。普通接口是一问一答,得等整段音频生成完才能播,实时接口才能边生成边播。
什么活该交给它,什么活别交
适合它的活共性很强:输入必须带声音或画面,且判断不需要多步推理。会议录音转纪要、客服通话质检、拍了照问图里是什么、看监控视频判断有没有人。
不适合的也清楚。它是非推理模型,长链条思考做不了。32K 上下文扣掉输入余量,留给历史的空间有限,跨几百轮的对话撑不住。写代码、多步数据处理,用 LFM3-1.7B。
判断就一句:输入是不是非带音视频。是,它是 2B 级别里少见的单模型方案;不是,用文本模型更划算。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 启动就报模型类型不认识 | llama.cpp 版本太老,或 transformers 低于 5.20.2 | 升级到 v0.8.0(b11960)以上和 transformers 5.20.2 以上 |
llama-tts: command not found |
llama 命令没有 TTS 子命令 |
改用 llama-tts,手动下 .gguf 和 mmproj 两个文件 |
| 输出的中文语音听不懂 | --tts-lang 用了默认的 en |
显式加 --tts-lang zh |
| 语音输入被「描述」而不是转写 | 系统提示词没走 -sys |
加 -sys "Perform ASR in Chinese.",正文位置写 <__media__> |
| 视频输入直接失败 | PATH 里没有 ffmpeg | 装 ffmpeg,确认 ffmpeg -version 能跑 |
| 回复里冒出奇怪的思考段落 | 没关推理模式 | 服务端加 --reasoning off,没有其他开关 |
| 没显卡时内存爆掉 | Transformers 退回 float32 | 改用 llama.cpp 的 Q4_K_M,或换有显卡的机器 |
| 下载只有 1.1 GB,跑不了图 | 只拿了主权重,没拿 mmproj | 用 -hf 让它自动一并下载,或手写 mmproj 文件名 |
和 LFM3-1.7B 怎么分工,别装两遍
这两个模型经常被混着用,其实边界很清楚。
LFM3-1.7B 是纯文本模型,强在 Agent 和工具调用。它支持 256K 上下文,本地版本就是这个长度,API 版本 128K。它被专门后训练适配 OpenClaw、Hermes Agent、Pi 这类 agent harness,干的是整理收件箱、排日程、网络调研这类活。
Omni-2B 只有 32K 上下文,是非推理模型,强在多模态输入。它适合一条输入里同时带声音和画面的活。
所以分工可以这么定。后台常驻的文字 Agent、长时间会话、工具链调用,交给 LFM3-1.7B。语音转写、看图问答、看带声视频、语音回复,交给 Omni-2B。
有个细节能帮你判断要不要两个都装:Q4_K_M 下两个权重都是 1.10 GB,装两套只多占 1.1 GB。如果你的场景里文字 Agent 和语音入口并存,共存是完全可行的,不必二选一。想先看 LFM3 家族里另一个更偏纯文本的本地部署打法,可以参考 LFM2.5-24B-A2B 本地部署,那篇讲的是同一条 llama.cpp 路线上更大的模型怎么配硬件。
还有一条最省事的路:Ollama
不想碰命令行、只想先试试手感,可以直接用 Ollama。我查过官方模型库,lfm3-omni 确实在,标注体积 2.0 GB 到 2.4 GB 区间。
ollama run lfm3-omni
模型卡要求 Ollama 版本不低于 v0.40.12,macOS 下支持图片和音频输入。
这条路适合快速验证值不值得投入,但它对视频输入的支持不如 llama.cpp 完整。真要上生产、要稳定的服务和实时语音接口,还是回到 llama.cpp 那条路。
如果你也踩过音频模型的本机部署坑,可以顺手看看 MiniCPM-V 4.7 本地部署 和 Whistle 语音转文字模型,这三篇的坑点不太重合,对着看能省不少时间。
常见问题
LFM3-Omni-2B 到底需要多大显存?
官方没公布显存要求,这点得说清楚,别信网上现编的数字。能确定的只有文件体积:Q4_K_M 主权重 1.10 GB 加多模态投影 0.29 GB,合计约 1.39 GB;bf16 权重 4.33 GB。实际运行还要加上上下文缓存,跑 32K 长上下文时余量要留足。8 GB 内存跑 Q4_K_M 是安全的。
LFM3-Omni-2B 支持中文吗?语音也支持吗?
都支持。文本语言 16 种,含中文。语音支持 19 个语言和地区,含中文。但语音合成必须显式指定语言,`--tts-lang zh` 不能省,否则按默认英文发音读中文。
用 llama.cpp 能输出语音吗?
能,但不是用 `llama` 命令。官方明确 `llama` 没有 TTS 子命令,语音合成要走单独的 `llama-tts` 程序,并且要手动下载主权重和 mmproj 两个文件。`llama serve` 另外开了 `POST /tts` 接口。
llama.cpp 和 SGLang 我该选哪个?
要语音输出选 llama.cpp。SGLang 服务这个模型只出文本,文本、图像、视频、音频输入都收,但输出端没有语音,这是官方写明的限制。只在 GPU 上做批量文本推理才考虑 SGLang。
它和 LFM3-1.7B 是同一个模型吗?
不是,但在同一棵树上。两个都基于 LFM3-1.7B-Base,1.7B 是纯文本型号、上下文 256K、偏 Agent 工具调用;Omni-2B 是 2.17B 的全模态型号、上下文 32K、不擅长长会话。可以同时装,多占约 1.1 GB。
Ollama 装和 llama.cpp 装有什么区别?
Ollama 省事,`ollama run lfm3-omni` 一条命令,适合先试手感。llama.cpp 更完整,视频带原声、实时语音的 `/v1/realtime` WebSocket 接口都在这一侧。快速验证用 Ollama,上生产用 llama.cpp。
 京ICP备2024094994号-29