
Whistle 语音转文字模型是什么:16.9MB 端侧转写
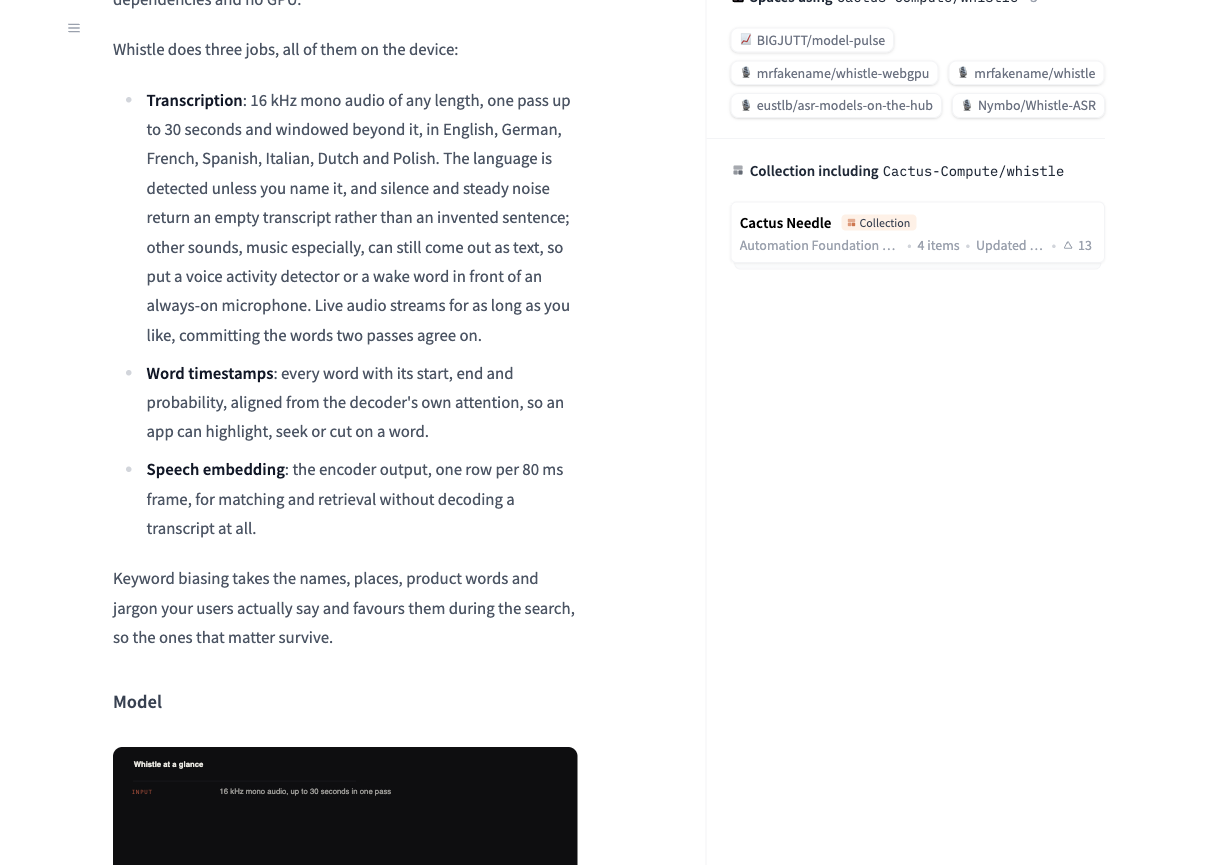
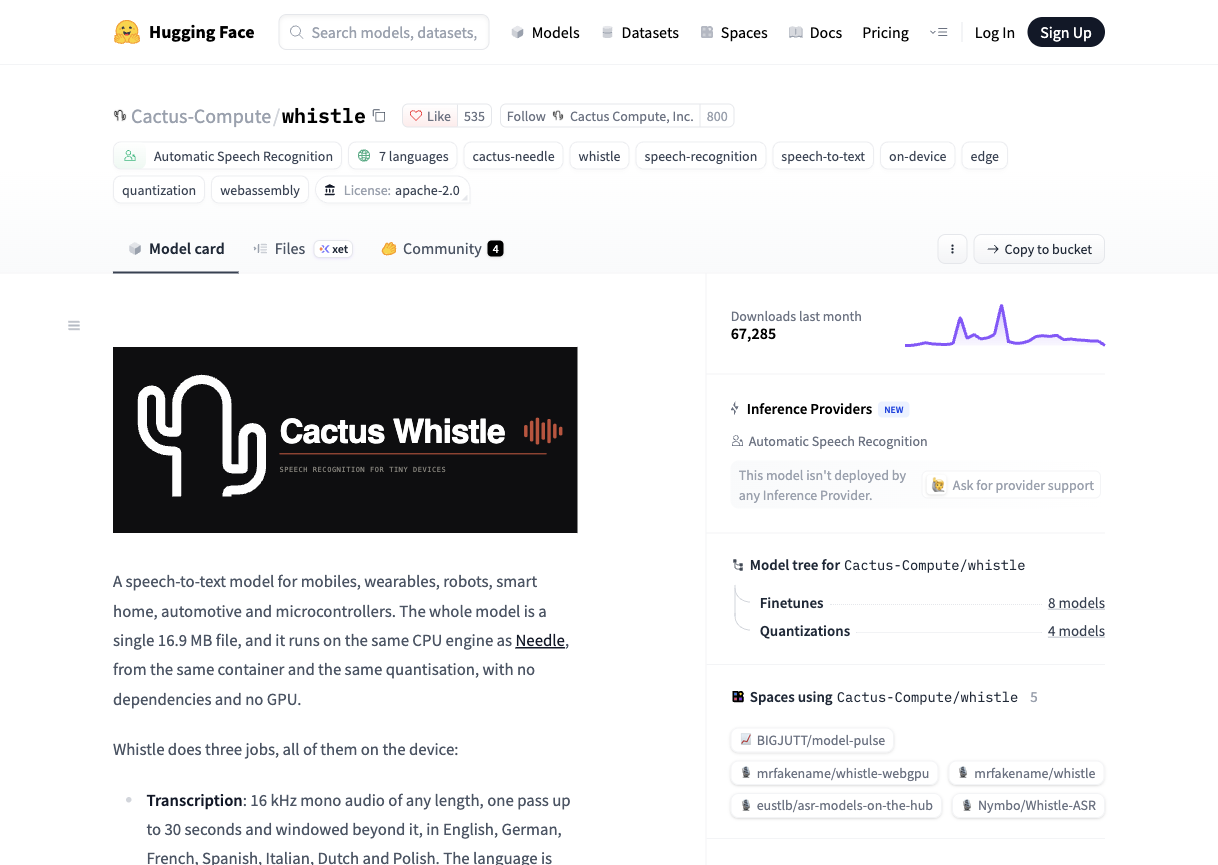
Whistle 是 Cactus Compute 团队做的超轻量语音转文字模型,整个模型、分词器、推理引擎打包成一个 16.9MB 的单文件,能直接在手机、手表、机器人甚至微控制器上离线跑。权重和许可放都在 Cactus-Compute/whistle 的 Hugging Face 模型页 上,模型卡标的是 Apache-2.0 协议。
它解决的不是精度,是离线设备根本没地方装模型。Whisper 常用版本动辄几百 MB,一块 8MB 闪存的单片机想都不敢想,16.9MB 才让端侧离线转写变成可以谈的方案。
它是什么级别的东西
先排除一个误会:它不是聊天机器人。Whistle 是自动语音识别模型,输入音频输出文本,没有对话能力也不做理解。作者 Cactus Compute 之前更出名的是同名的端侧部署框架,一套让模型跑在手机和可穿戴设备上的工具链,Flutter、React Native、Kotlin Multiplatform 都能接。
时间线很短:2026 年 9 月 30 日在 Hugging Face 上线,10 月 9 日在 Hacker News 拿到 505 分、115 条评论,是当天最高分,10 月上旬登顶 Hugging Face 语音识别分类 Trending 榜,发布首月下载量冲到 6.7 万次。
Trend 榜的热度代表讨论度,6.7 万的下载量说明已经有人真正往项目里接,不只是围观。
三个数字决定了它能干什么
16.9MB 是门槛数字
拿它和 Whisper 系列放一起,体积差了大约两个数量级:
| 模型 | 模型体积 | 典型部署设备 | 30 天下载(HF 语音榜同期) |
|---|---|---|---|
| Whistle | 16.9MB | 手机、手表、机器人、微控制器 | 67285 |
| Whisper large-v3 | 数百 MB 级 | 服务器、带独显的 PC | 399 万 |
| Whisper tiny 系(量化后) | 数十 MB 级 | 手机端 | 未单独统计 |
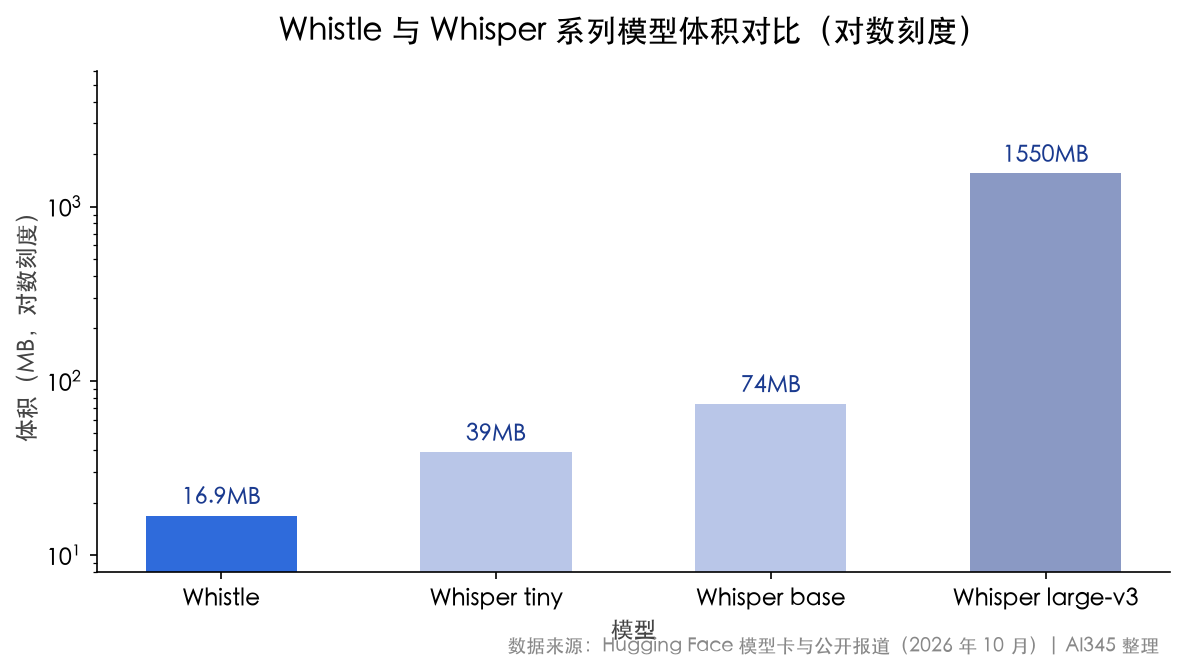
这张表最该看的是最后一列。Whisper large-v3 一个月下载量是 Whistle 的近 1800 倍,存量生态完全不在这边。Whistle 要解决的不是替换服务器上的 Whisper,是覆盖连 Whisper tiny 都装不进去的硬件。
单文件是第二个卖点:16.9MB 里装的不止权重,分词器和推理引擎一起打包,嵌入式开发者不用为推理依赖改构建,下载、加载、出结果。再加全程离线、音频不出设备,客服录音和工控巡检会在合规上直接用上这条。
和 Whisper 的边界在哪
两者不是同一个赛道上的竞品,分界线很清楚。
Whistle 站在设备稀缺这一侧。 板子只有几 MB 可用存储、功耗预算撑不住大模型、或者根本不能联网,这时候选型几乎没有余地,它加上同门的端侧框架是少数能落地的组合。
Whisper 站在精度和生态这一侧。 多语言、时间戳、大量现成封装,社区问题一搜就有答案。你要给一小时播客做逐字稿,16.9MB 的体积优势换不来任何东西,反而要在精度上妥协。
正确的问法不是「谁更好」,是「我的设备装不装得下 Whisper」。装得下就别折腾。
站内 GPT-Live-1 国内替代方案 横向对比过实时语音的几条路径,那是另一个需求,实时对话和离线转写别混着挑。
哪些设备能跑
体积小不等于好用,这条线要划清楚。
适合:唤醒词后的短句识别(台灯、遥控器、车机),几分钟的语音备忘,车间没网时的口头巡检记录。
不适合:一小时播客那种长音频,端侧芯片撑不住;容错率极低的法律和医疗转录,宁可上大模型加人工;多语种混说的会议记录,轻量模型切换能力天然受限。
截至本文更新,官方没有公布可核对的中文 WER 数据,语种清单也需以模型页当前说明为准。这是中文用户最容易踩的坑:一个以英文语料为主的轻量模型,中文准确率可能和英文差得远。要用,先拿自己的真实音频跑一段。
最快三步试起来
端侧模型试错成本低,不用等生态成熟。
- 去 Hugging Face 找 Cactus-Compute/whistle 的模型页,看清下载方式和推理要求,精度数据得自己去 Issues 和评论区找
- 拿一块和目标设备同档的硬件,用三到五分钟的真实业务音频验证,别用朗读稿,要有口音、有背景噪音
- 把结果和同一段音频在 Whisper 上的输出对齐比较,重点看专有名词和数字,这两类错了后面用不了
站内 Dessa 是什么 写过 Block 纯语音模型的定位,Gemini 3.8 Live API Key 配置 是云端实时语音的走法,三篇一起看,端侧、云端、纯语音三个方向就有轮廓了。
常见问题
Whistle 是 OpenAI 出的吗
不是。它由 Cactus Compute 团队发布,和 OpenAI 的 Whisper 没有关系,名字接近容易被误会。
Whistle 支持中文吗
官方没有公布可核对的中文 WER 数据,语种覆盖清单也需要以模型页当前说明为准。要用在中文场景,建议先自己拿真实音频跑一段验证,不要直接采信宣传口径。
16.9MB 的模型精度能追上 Whisper 吗
不能期待追平。它牺牲了体积换来的部署可行性,在安静环境下的短句识别上表现可用,长音频、多语种混说、专业术语这些场景与 Whisper 大模型的差距会很明显。
单片机能跑 Whistle 吗
社区讨论里把它定位成可以在微控制器上运行,但实际能不能跑要看你的芯片算力和可用内存。16.9MB 是模型文件体积,运行时还需要额外的内存和音频缓冲空间,具体门槛以官方部署文档为准。
Whistle 开源吗,商用可以吗
发布在 Hugging Face 的 Cactus-Compute 组织下,具体开源协议条款需要到模型页或对应仓库的许可文件里确认。商用前务必自己读一遍协议原文,不要依赖二手总结。
Whistle 和 Whisper 哪个适合做播客转写
选 Whisper。一小时级别的长音频需要稳定的算力和更好的长文本精度,这是 Whisper 的强项,也是 16.9MB 模型的边界外。
 京ICP备2024094994号-29