
Gemini 3.8 Live API Key 配置:5 步跑通语音
一句话:Gemini 3.8 Live 的 API Key 在 Google AI Studio 免费申请,拿到 Key 后按「填对 Base URL、事件模型名、先文本后流式」的顺序配置,5 步就能跑通实时语音。本文按零基础假设写,每步告诉你做什么、预期结果、卡在哪。
准备:你需要这三样
- 一个能访问 Google 的网络环境(大陆需先解决直连,详见 Gemini 3.8 Live 国内能用吗)。
- 一个 Google 账号(Gmail 即可)。
- 一个可运行的代码环境(本地 Node/Python 或在线 Notebook 都行)。
步骤一:进入 Google AI Studio 并拿 Key
打开 Google AI Studio(aistudio.google.com),用 Google 账号登录。
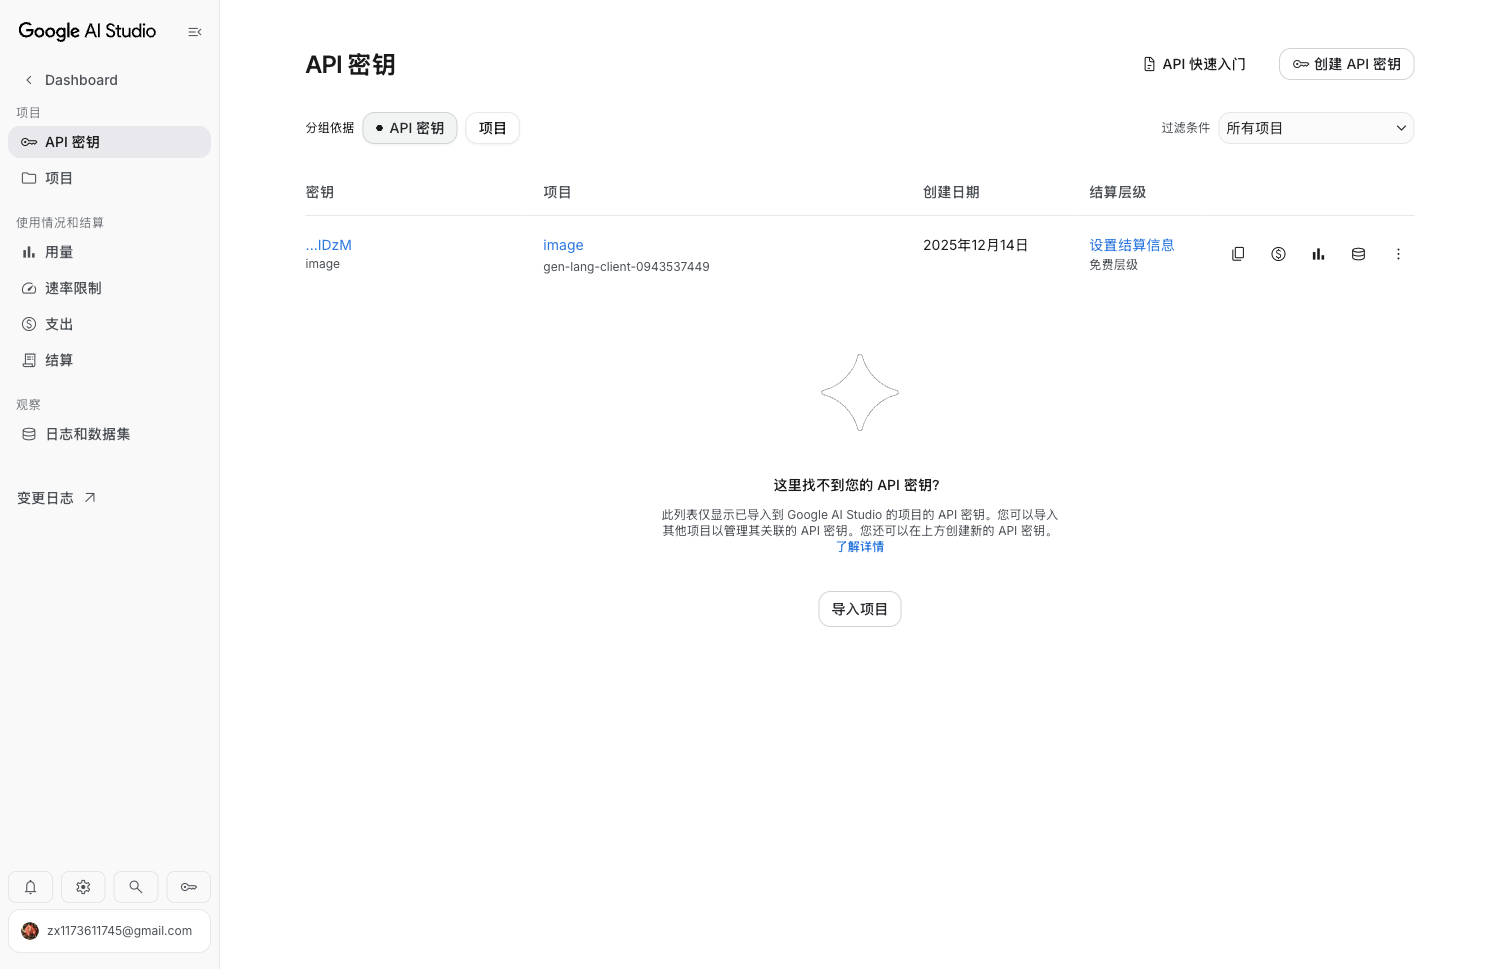
- 顶部菜单点 Get API key。
- 点 Create API key。
- 选择或新建一个 Google Cloud project。
- 点 Create API key in existing project 生成你的 Key。
- 生成后立即复制保存,之后可在 Dashboard 里再查看。
注意:Key 别写进代码仓库或贴到公开日志,建议用环境变量 GEMINI_API_KEY 存。想系统了解整个 AI Studio 玩法见 Google AI 与 Gemini 教程。
步骤二:确认 3.8 Live 的模型名
调用时不是填展示名,而是填接口侧的模型 ID。Gemini 3.8 Live 相关的两个:
gemini-3.8-live:实时语音双工,主打近实时对话。
gemini-3.8-live-extended-thinking:偏多步推理、复杂任务执行。
实际可用列表以你的项目在 AI Studio 「模型」面板为准,版本号可能带后缀(如日期戳)。选错模型名常见的报错是 model not found。
步骤三:先用文本打通鉴权(最小验证)
语音链路长,排障变量多。正确顺序是先用文本建一次请求,确认 Key 和地址没错,再开流式跟实时语音。
示例(Python,安装 google-genai):
from google import genai

client = genai.Client(api_key="你的_KEY")
resp = client.models.generate_content(
    model="gemini-3.8-live",
    contents="说一句你好"
)
print(resp.text)
能返回内容,说明 Key 有效、地基打通。
步骤四:开流式 / 实时语音会话
文本验证通过后,再上 Live 的 WebSocket 双工链路。
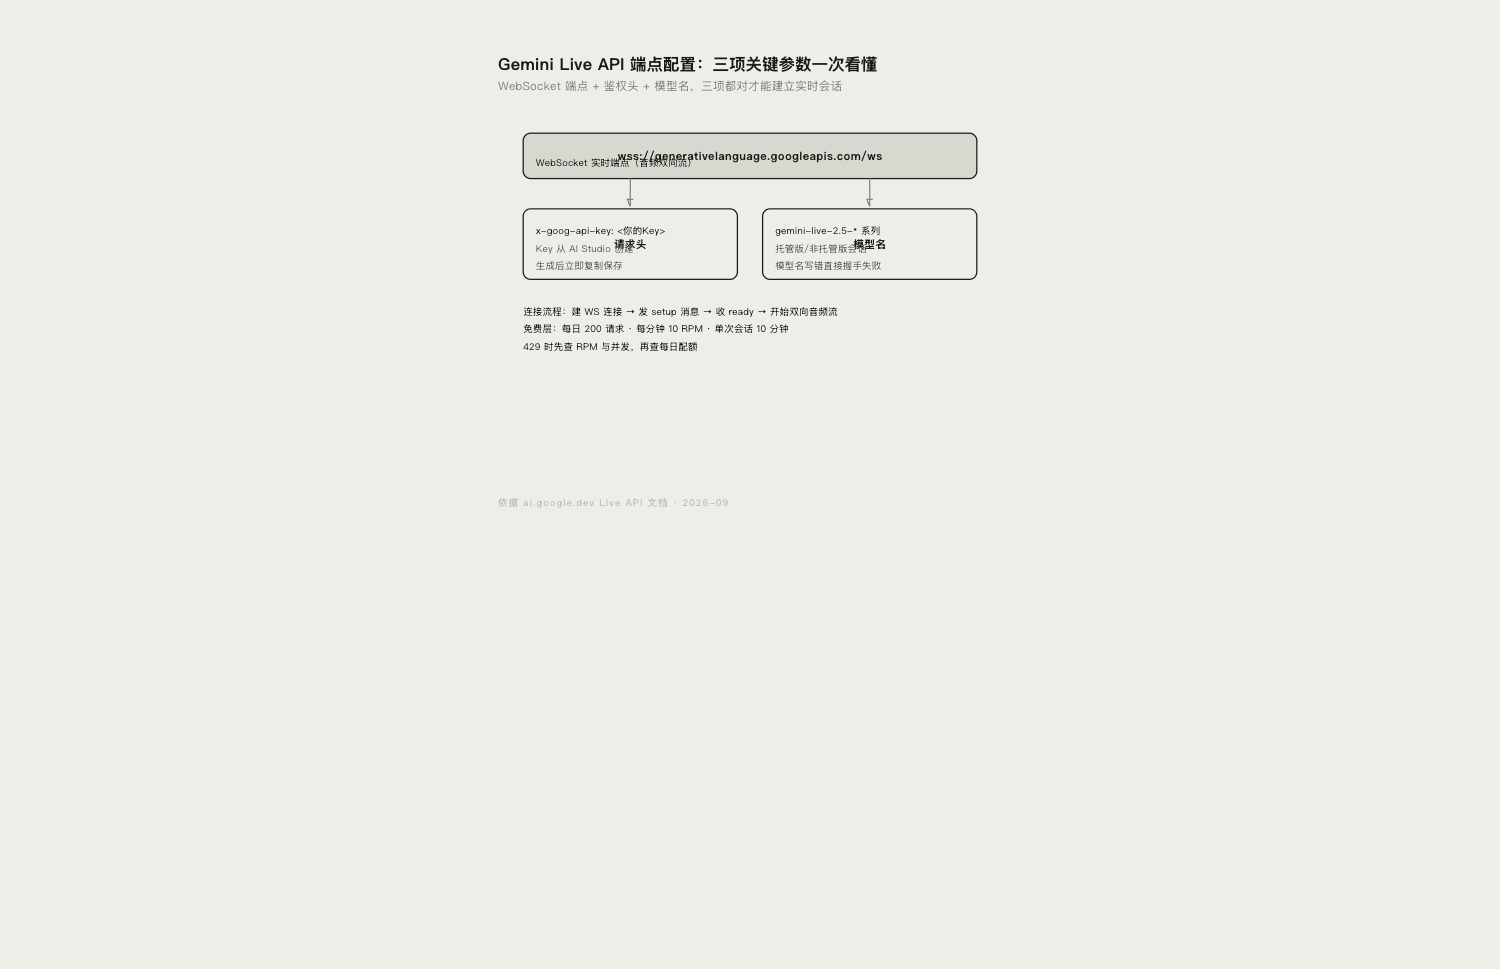
- Base URL 指向 Live API 对应的端点地址,鉴权头用 Bearer 你的 Key(端点与字段以 Gemini Live API 官方文档 为准)。
- 建立 WebSocket 连接后发送 setup,包含
model字段。 - 逐片上传麦克风采集的音频与参数,监听服务端返回的
serverContent。 - 收到事件后按类型处理:音频、转写文本、工具调用。
常见卡点:WebSocket 返回 101 后一直收不到 serverContent,多半是会话参数没配对或音频格式不符。
步骤五:验证跑通 + 看报错
跑出一条完整问答即成功。若报错,对照:
API_KEY_INVALID:Key 复制不全或末尾多了空格,回 AI Studio 重新复制。model not found:模型名写错,核对文档实际 ID。401(WebSocket 握手):鉴权头格式或 Base URL 不对。429限流:免费额度用尽或并发过高,稍等再试或升级。
免费额度与配额说明
Google AI Studio 免费层对模型有 RPM(每分钟请求)、TPM(每分钟 token)、RPD(每日请求)三类限制,随模型不同而异;超额会触发限流错误。配额按项目而非按 Key 应用,每日请求数在太平洋时间午夜重置。想做得细可看 Gemini 学生认证教程 里的额度细节。
进阶:语音通道常见踩坑
把文本打通之后,再上实时语音,最容易翻车的有几处:
- 采样率与声道不匹配:WebSocket 上传的音频帧格式要和模型期望的一致,前后统一,否则收不到 serverContent。
- 会话参数没配对:setup 里的 model 字段写错或漏了某个 required 参数,连接就建不起来。
- 打断事件没监听:要识别流里的 interrupt 事件,否则用户插话时对话会乱序。
- 视觉上下文要显式打开:想传摄像头帧或截图,需要在 setup 里声明支持图像输入,不声明默认纯语音。
进阶:多语言与工具调用
Gemini 3.8 Live 原生支持多语言对话:语言数量接近上百种,实际以账号所在地区与模型支持为准,接口里通过在消息里混入语言片段来触发。
工具调用是它的另一个发力点:语音对话过程中,模型可以异步触发你定义的函数(订票、查数据、改工作流),对话不因后台任务停顿。想验证工具调用,先在 setup 里注册函数声明,再在对话里让它调一次。
连不上的通用排查顺序
如果每次都卡在某一步,按这个顺序过一遍,锁定的问题最快:
- 能否直连 Google / AI Studio 页面(网络层)。
- API Key 是否能单独发一个文本请求(鉴权层)。
- 模型名是否在当前面板可用(模型层)。
- WebSocket 端点与 ws 路径是否与文档一致(连接层)。
- 音频与参数格式是否匹配(媒体层)。
一步一层试,能少走很多绕路。国内网络限制的兜底见 Gemini 3.8 Live 国内可用性。
最后更新
2026 年 9 月。模型名与端点以 Google AI 官方文档为准,若版本迭代以文档最新为准。
AI345
常见问题
Gemini 3.8 Live 的 API Key 要从哪里申请?
答:在 Google AI Studio(aistudio.google.com)登录 Google 账号,Get API key 后再到 Create API key 生成,保存到环境变量即可,详见步骤一。
3.8 Live 的模型名在接口里写成什么?
答:实时对话用 `gemini-3.8-live`,复杂任务用 `gemini-3.8-live-extended-thinking`,具体以 AI Studio 模型列表为准。
调用时报 model not found 是什么原因?
答:多半是模型名没输对或用了历史版本名。到 AI Studio 查当前可用的模型 ID,复制到代码里再试。
Flow 里报 API_KEY_INVALID 怎么处理?
答:回 AI Studio 重新复制一遍完整 Key,检查首尾有没有空格或多余的引号,再替换环境变量。
免费额度多少,多久重置?
答:免费层对 3.8 Live 的请求有 RPM/TPM/RPD 限制,额度按项目算,每日请求数在太平洋时间午夜重置,超限会触发 429。
 京ICP备2024094994号-29