
Kimi K3.1 Pro对比DeepSeek V4.1 看这7项
别急着比分数。Kimi K3.1 Pro 在 2026 年 11 月 5 日开放完整权重之后,中文媒体齐刷刷把它和 DeepSeek V4.1-Flash 摆在一起,但这两款根本不在同一价格带。结论先给清楚:要总分最高、中文最稳、开箱就能跑复杂 Agent 任务,选 Kimi K3.1 Pro,代价是贵八倍;要便宜到可以无脑跑批量、要自己部署在自有卡上,选 DeepSeek V4.1-Flash。只把分数拉出来比,会误导你。
两条判断线,一句话能分完
一句话的判断线是这样。
输出为主的批量任务、离线清洗、跑 eval、接在自己的 Coding 工具里,选 DeepSeek V4.1-Flash。它输出的价格是 Kimi 的八分之一左右,谷时更低。
需要模型自己想清楚再动手的复杂任务、中文长文档、要冲榜单分数给客户看的场景,选 Kimi K3.1 Pro。它在第三方综合指数上高出约 14 分,中文榜第一,编程智能体的实战分数也是开源里最好的那一档。
先把名字理清,V4.1 有两个在售版本
很多人搜「DeepSeek V4.1」的时候,其实没意识到这个名字底下有两个东西。
按 DeepSeek 官方 API 文档,现在只有两个模型名:deepseek-flash 和 deepseek-v4-pro。前者对应 DeepSeek-V4.1-Flash-1017,是 10 月 17 日上线的版本;旧名字 deepseek-v4-flash 仍然可用,但请求已经被路由到它并按其价格计费。后者对应 DeepSeek-V4-Pro-0813,是另一条参数更大、价格更高的线,输入 1.32 美元、输出 3.96 美元每百万 token(高峰价)。
中文语境里说「DeepSeek V4.1」,绝大多数时候指 V4.1-Flash。本文也按 Flash 口径比,因为这才是和 Kimi K3.1 Pro 真正常被放在一起选的那个。
7 项总对比表
下面每一项都对齐了官方或第三方的原始口径,表格里不放估算值。
| 维度 | Kimi K3.1 Pro | DeepSeek V4.1-Flash-1017 |
|---|---|---|
| 参数结构 | MoE 总 2.8 万亿,单次激活约 1040 亿 | MoE 总 552B,输入侧激活约 8B、输出侧约 16B |
| 上下文 | 1,048,576 token | 1M token,最大输出 384K |
| 原生多模态 | 支持读图 | 支持读图(Vision) |
| AA 智能指数 v5 | 46.5 | 32.6 |
| SuperCLUE 2026 年 11 月 | 61.46,国内第一 | 58.95,国内第二 |
| API 价格(每百万 token) | 输入 2 美元,输出 10 美元 | 输入 0.3 / 0.15 美元,输出 1.2 / 0.6 美元(高峰 / 谷时) |
| 权重与部署门槛 | 约 1.56TB,最低一组 8 卡企业级 | 总参 552B、激活 8B/16B,门槛低一个量级 |
分数差 14 分,但有一项 DeepSeek 反超
Artificial Analysis 在 10 月重构了 Intelligence Index,出到 v5。这一版最大的变化是 60% 的评测权重压在了私有测试集或隐藏答案上,用来压缩公开题库被训练数据污染的空间。
编码这 25% 里有个新东西值得单独说。Cognition 同一天发布的 FrontierCode 2.0 独占 15%,它把 132 项任务全换成真实开源仓库,模型提交的改动不看单元测试过不过,而由仓库维护者按「是否愿意合并这个 PR」打分,任何阻塞性检查失败直接记 0。
在这个口径下,DeepSeek V4.1-Flash-1017 拿到 28%,是所有已发布权重模型里最高的一个。Kimi K3.1 Pro 是 25.5%,谷歌 Gemini 4 Argon 25.7%,GPT-6 Luna 25.2%。也就是说,真要按「代码改动能不能被接受」这个最贴工程实际的标准,DeepSeek 反超了。
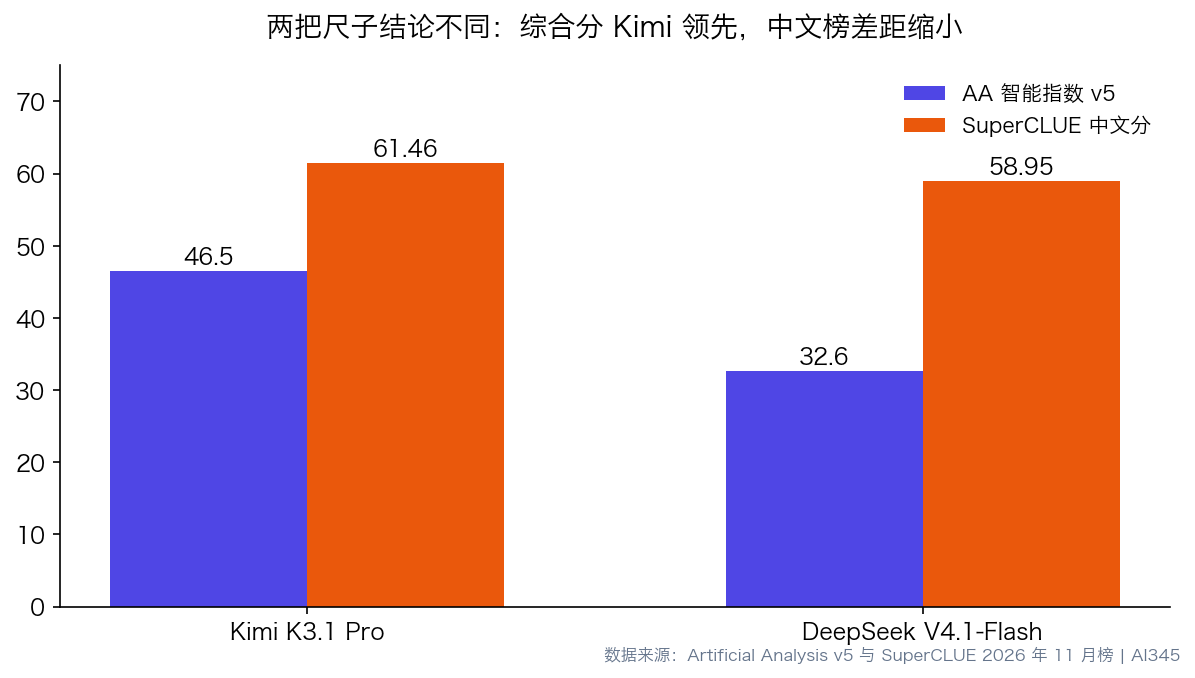
但拉到综合指数,Kimi 46.5、DeepSeek 32.6,差距约 14 分。IT之家同期报道把这个数字取整写成 46 和 32,方向一致。
另一个方向的证据来自 Vals AI 用 Terminal-Bench 4.0 做的独立测试。Kimi K3.1 Pro 得分 63.64%,在 59 个模型里排第三,前面只有 Claude Opus 5.5 和 Sonnet 5.5。作为对照,上一代 Kimi K3 这项只有 13%。这个跨度比总分差距更能说明 K3.1 Pro 这轮提升的重点在哪。
版本之间的差异可以看这篇 Kimi K3.1 Pro 和 K3 对比 的逐项拆解。
中文场景差 2.51 分,落在幻觉控制上
SuperCLUE 的 2026 年 11 月通用大模型榜是国产模型唯一值得看的中文尺子,这一轮 19 个国内外模型参评,覆盖智能体编程、数理推理、超长上下文、精确指令遵循、幻觉控制五项。
榜单第一是 Gemini-4-Argon,73.62 分,第二是 GPT-6.1-Sol 的 71.76 分,两个都是闭源。国内这边 Kimi K3.1 Pro 61.46 排第一,DeepSeek-V4.1-Flash-1017 58.95 第二,智谱 GLM-5.3 50.66 第三。
2.51 分怎么理解。它不构成碾压,只是同一档里略好。真要落到体感上,差别在两项上最容易看出来。
一是幻觉控制。Kimi 这项 67.78,在国内模型里优势明显。做中文长文档摘要、合同条款核对、政策文件问答这类不能编的任务,编造率哪怕低一点都有价值。
二是超长上下文。这一项 Gemini-4-Argon 拿到 95.63,是全场最刺眼的单项分,说明国产模型在百万级上下文里「真能捞到东西」的能力和头部闭源还有距离。两家都标 1M,别把标称当能力。
价格是八倍差,但账单结构不一样
明面上的数字,Kimi K3.1 Pro 输入 2 美元、输出 10 美元每百万 token(见 Kimi 官方定价页),三项费率比 K3 各降约 33%,按人民币口径是输入 13 元、输出 68 元,缓存命中输入 1.3 元。另外有个 Highspeed 版,输出速度提升 2 到 3 倍,价格翻倍。这部分定价可以先看 Kimi K3.1 Pro 价格是多少。
DeepSeek V4.1-Flash 走的是峰谷计价。官方文档写的单价是输入(缓存未命中)高峰 0.3 美元、谷时 0.15 美元,输出高峰 1.2 美元、谷时 0.6 美元,缓存命中输入高峰 0.006 美元、谷时 0.003 美元。谷时价是峰时的一半,高峰时段为 UTC 01:00 到 04:00 和 06:00 到 10:00,换算北京时间就是工作日 9 点到 12 点、14 点到 18 点,中国法定节假日除外,周末和节假日全天算谷时。
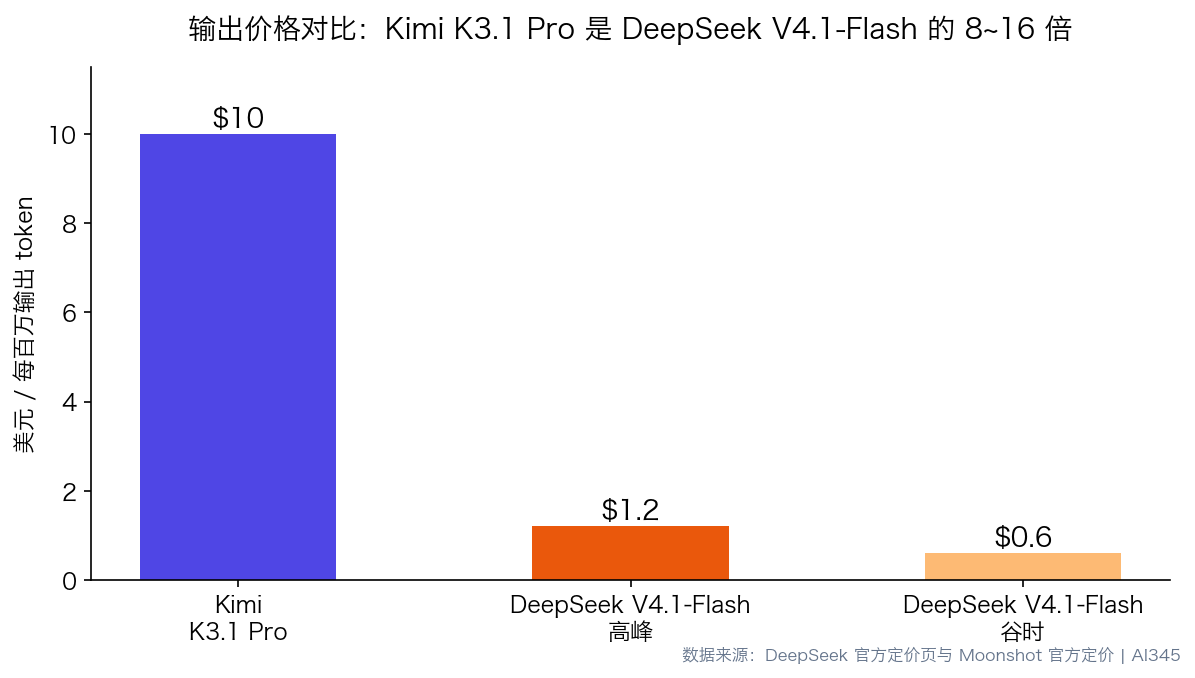
只看输出侧,Kimi 10 美元,DeepSeek 高峰 1.2 美元,谷时 0.6 美元。差距在八倍到十六倍之间。
但真实账单还要补两个变量。
第一是缓存。Kimi 的 K3 系列缓存写入按 TTL 单独计费,命中价另算;DeepSeek 缓存命中价压到 0.006 美元。长对话、固定前缀多的 RAG 场景,两家的账单曲线形状完全不同,不能只乘输出单价。
第二是中间层的补贴。OpenCode 在 10 月 31 日把 DeepSeek V4.1 Flash 的额度提到 100 美元等值,卖给 10 美元月费的 Go 订阅用户。这种杠杆会把账面差价直接抹掉,选型时必须一起看。
部署门槛才是真分水岭
价格差八倍还不是最狠的,真分水岭在能不能自己部署。
Kimi K3.1 Pro 的权重 11 月 2 日上传 Hugging Face,11 月 4 日正式公开,同步上架魔搭社区。格式是量化感知训练得到的 MXFP4,112 个文件合计约 1.56TB。官方 vLLM 方案的最低配置是一组 8 卡张量并行:两个 GB300 托盘、一台 8 卡 B300,或者一台 8 卡 MI355X。消费级显卡和单台 8 卡 H100 都放不下。
国产卡这条线倒是跟得很快。华为计算称昇腾基于 vLLM Ascend 与 SGLang 同步做了 0 day 适配,支持 Atlas 800 A3、Atlas 900 A3 SuperPod 和昇腾 950 超节点系列。
DeepSeek V4.1-Flash 是 552B 总参、激活 8B 与 16B 的结构,权重体积和显存需求按参数量算低一个量级。官方没有给出统一的消费级部署方案,具体最低配置以官方仓库为准,但两者不在同一个难度上,这一点没有争议。
许可证也得看一遍。Kimi 主体沿用 MIT 写法,个人和公司可以免费使用、修改、分发、商用,只加了两条限制。一是做模型 API 售卖、且集团任意连续 12 个月总营收超 2000 万美元,商用前要另签协议;二是用它做的产品月活超 1 亿或月收入超 2000 万美元,界面上要醒目标注 Kimi K3.1 Pro。公司内部自用、通过官方产品和认证推理服务商使用,都不受限。
下载和部署的完整步骤看这篇 Kimi K3.1 Pro 权重下载与本地部署。
四类人怎么选
- 独立开发者、小团队做 Agent 产品。选 DeepSeek。理由不是分低一点无所谓,是你的预算决定了能不能多跑几轮 eval 再定方案。
- 要中文写作、中文合同、中文客服质量的团队。选 Kimi。2.51 分和 67.78 的幻觉控制在长文档上更容易体感出来。
- 要自己部署在自有卡上的。先看卡,再看模型。没有 8 卡企业级 GPU,Kimi 这条路直接走不通,不用浪费时间比分数。
- 已经在 Claude Code、OpenCode 或豆包工作里的。两家都能接,豆包工作 10 月 29 日已经把 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 三款第三方模型开给团队版和企业版客户,按 AI 点数扣,你可以在同一个界面里做 A/B。
如果你是拿它做模型横评给客户看,可以顺手对照这篇 Kimi K2.8 Preview 和 DeepSeek V4.1 Flash 的对比,那篇的口径和这次不一样,正好能看出半年里尺子变了多少。
迁移成本,换过去要改什么
API 层最轻。DeepSeek 官方同时提供 OpenAI 格式和 Anthropic 格式的 base_url,换到 Kimi 主要改 base_url 和模型名(Kimi 官方定价页上的模型名是 kimi-k3.1-pro)。协议兼容的细节建议以 Kimi 官方 quickstart 为准,本文不替你保证。
账单结构会变,这个要重算。DeepSeek 有峰谷价,把批处理任务排到谷时能省一半;Kimi 没有时段折扣,但缓存 TTL 默认 5 分钟、缓存写入单独计费,固定前缀多的场景要重新算一遍命中率,否则会以为「换过去贵了八倍」,实际可能只贵三倍。
自己部署的门槛是硬变。从 Flash 换到 K3.1 Pro,等于从「几张卡能塞」换成「必须凑一组 8 卡」,这笔账比 API 差价大得多,也更难回头。
常见问题
DeepSeek V4.1 和 V4.1-Flash 是同一个吗
不是同一个名字的两个写法。官方 API 现在的模型名是 deepseek-flash 和 deepseek-v4-pro,deepseek-flash 对应 DeepSeek-V4.1-Flash-1017。中文报道里说的「DeepSeek V4.1」通常指 Flash 这一支。
Kimi K3.1 Pro 开源了能免费用吗
下载权重不等于免费调用。权重可以免费下载,公司内部自用不受附加条款限制,但你要有 8 卡企业级 GPU 的机器才跑得起来。走 API 是按量付费,输入 2 美元、输出 10 美元每一百万 token。
两个都能在网页上免费用吗
Kimi 官网和 App 有免费额度,DeepSeek 也有自己的网页端,但两家都没有公布与这两个模型对应的具体免费次数和限额。想把能力用满,还是得走 API。
中文写作到底差多少
SuperCLUE 2026 年 11 月榜上 Kimi 61.46、DeepSeek 58.95,差 2.51 分。这个差距在短问答里几乎感觉不到,在长文档和需要少编造的任务上更容易看出来,Kimi 的幻觉控制分是 67.78。
1M 上下文谁更能用
两家都标 1M,但标称和能用不是一件事,DeepSeek 官方写明最大输出 384K。长上下文的效果建议拿你自己的文档各跑一次,别只看标称数字。
现在换哪家更划算
看你的输出量。输出为主的批量任务,DeepSeek 高峰价约是 Kimi 的八分之一,谷时更低。输出少、靠模型自己想清楚的复杂任务,在 AA 的 Terminal-Bench 测试里 Kimi 平均每题花 4.57 美元,比 Claude Opus 5.5 的 13.20 美元便宜得多,但仍远高于 DeepSeek。
 京ICP备2024094994号-29