
Kimi K3.1 Pro 价格多少钱:人民币表格与用量测算
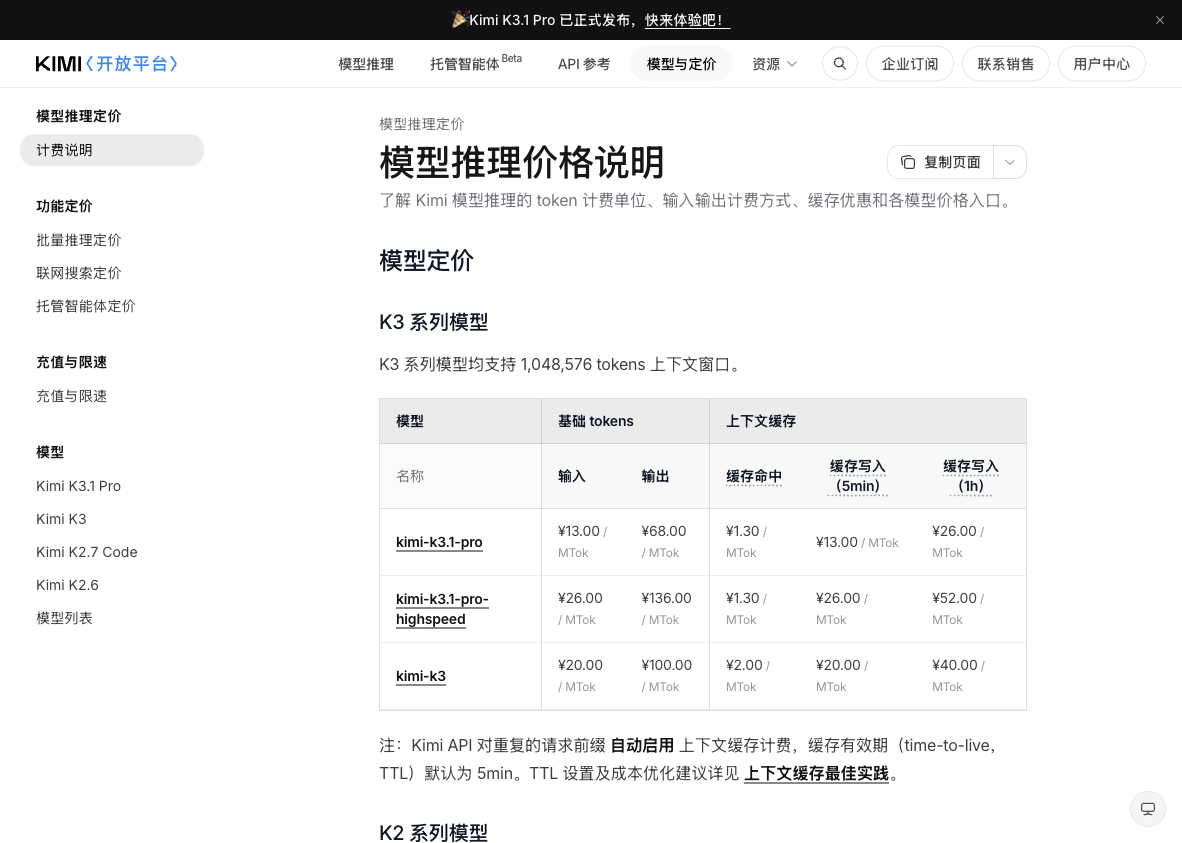
直接说数。Kimi K3.1 Pro 的官方人民币定价是:输入 13 元每百万 token,输出 68 元每百万 token,缓存命中 1.30 元每百万 token。Highspeed 版输入 26 元、输出 136 元,缓存命中价不变。
这个价格放在它自己的产品线上是反常的。上一代 K3 是输入 20 元、输出 100 元,新模型反而便宜了约三成。放在外部对比,媒体口径是「与 GPT-6.1 Sol 持平,是 Claude Opus 5.5 的一半」,这一条我按报道引用,官方页面上没有直接写竞品对比。
先说清楚一件事:这张表来自 Kimi 官方定价页,不是媒体转述。三方报道里那些数字我核对过,方向对,但有细节偏差,下面会标。
官方价格表,五个价格位
Kimi 的 K3 系列计费有三个维度(规则见 官方计费逻辑说明):基础 tokens(输入、输出)、缓存命中、缓存写入。缓存写入还分 5 分钟和 1 小时两档 TTL。
| 模型 | 输入 | 输出 | 缓存命中 | 缓存写入 5min | 缓存写入 1h |
|---|---|---|---|---|---|
| kimi-k3.1-pro | 13.00 元 | 68.00 元 | 1.30 元 | 13.00 元 | 26.00 元 |
| kimi-k3.1-pro-highspeed | 26.00 元 | 136.00 元 | 1.30 元 | 26.00 元 | 52.00 元 |
| kimi-k3 | 20.00 元 | 100.00 元 | 2.00 元 | 20.00 元 | 40.00 元 |
| kimi-k2.7-code | 6.50 元 | 27.00 元 | 1.30 元 | 无 | 无 |
| kimi-k2.6 | 6.50 元 | 27.00 元 | 1.10 元 | 无 | 无 |
所有价格单位都是每百万 token(1 MTok = 1,000,000 tokens)。
海外平台(Moonshot AI 定价页)是美元计价,同一组模型:标准版输入 2.00 美元、输出 10.00 美元、缓存命中 0.20 美元;Highspeed 输入 4.00 美元、输出 20.00 美元;K3 输入 3.00 美元、输出 15.00 美元。海外页面上有一句额外说明,价格不含税,具体税额按你所在辖区在结账时计算。
媒体口径和官方口径的两处出入
第一处是缓存命中价。163 的报道写「Highspeed 输入 token 缓存命中的部分定价保持一致」,这跟官方一致,两个版本的缓存命中都是 1.30 元。这条是对的。
第二处是「价格翻倍」这个说法。官方数据里 Highspeed 的输入和输出确实是标准版的 2 倍,但缓存命中价没有跟着翻,还是 1.30 元。所以严格说不是「全项翻倍」,是「基础 tokens 翻倍、缓存命中不变」。如果你有大量重复前缀,实际溢价会低于 2 倍。
这条差异在实操里挺重要,下面测算部分会算给你看。
什么用量花多少钱:五档实际测算
光看单价没体感,直接算。假设一次调用输入 8000 token、输出 2000 token,这个比例接近日常的问答和代码修改场景。
第一档:试用。 100 次调用,总输入 80 万 token、总输出 20 万 token。输入 0.8 × 13 = 10.4 元,输出 0.2 × 68 = 13.6 元,合计约 24 元。
第二档:个人日常用。 每天 100 次,一个月 3000 次。输入 2400 万、输出 600 万。输入 24 × 13 = 312 元,输出 6 × 68 = 408 元,合计约 720 元一个月。
第三档:接进 Claude Code 写代码。 编码场景的输出 token 会明显变多,而且输入里要带代码库上下文。按每次输入 5 万、输出 1.5 万算,每天 50 次,一个月 1500 次。输入 7500 万 token,输出 2250 万 token。输入 75 × 13 = 975 元,输出 22.5 × 68 = 1530 元,合计约 2500 元。
第四档:长上下文任务。 一次性把 50 万 token 的代码库或文档塞进去,输出 2 万 token。单次成本:输入 0.5 × 13 = 6.5 元,输出 0.02 × 68 = 1.36 元,约 7.9 元一次。同一份材料问 10 个问题,缓存命中后输入按 1.30 元算,后 9 次每次输入只要 0.65 元,10 次总成本从 79 元降到 6.5 + 9 × (0.65 + 1.36) 约 24.6 元。
第五档:批量生产内容。 每天生成 100 条 1500 token 的文章,月产 3000 条,输出 450 万 token。输出 4.5 × 68 = 306 元。加上提示词输入,整体月成本约 400 元上下。
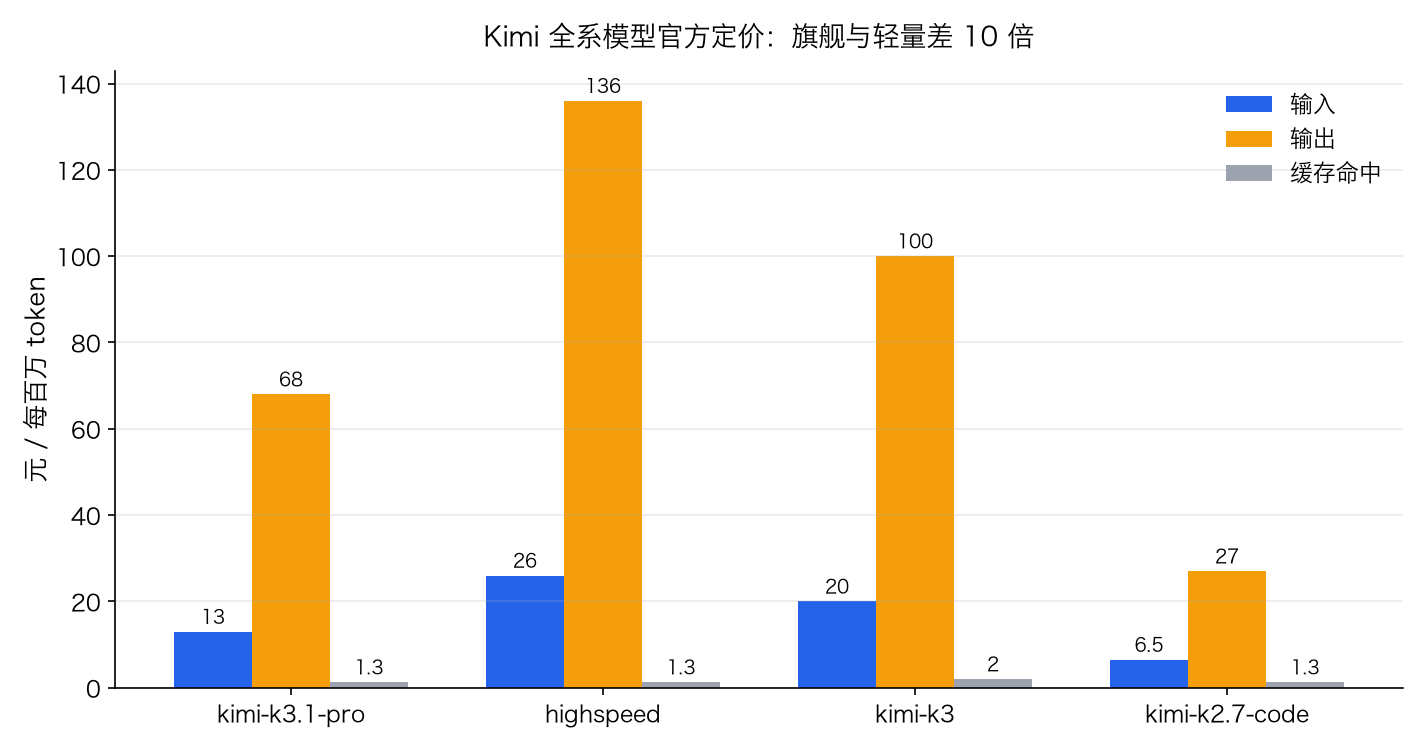
这几档测算能看出一个规律:输出价是账单的主要变量。输入 13 元、输出 68 元,比例接近 1 比 5。同样是一百万 token,走输入还是走输出,成本差 5 倍。所以省钱的第一优先级不是砍输入,是控制输出长度。
具体做法:给 max_tokens 设个合理上限,别留默认的 131072。K3.1 Pro 的 max_completion_tokens 默认值是 131072,最大能设到 1048576。默认值意味着模型有可能写到 13 万 token 才停,按 68 元算一次就 8.9 元。设成 4000 就锁住了上限。
缓存怎么用才真省钱
K3 系列的缓存规则跟 K2 不一样,值得单独说。
缓存是自动启用的,不用你手动创建。你对重复的请求前缀发请求时,系统会把满足条件的前缀写进缓存,之后命中部分按 1.30 元计费,而不是 13 元。便宜十倍。
但写入要花钱,而且分两档 TTL:
- 5 分钟档:写入 13 元每百万 token,跟输入同价。适合连续追问、间隔短的对话。
- 1 小时档:写入 26 元每百万 token,是 5 分钟档的两倍。适合间隔可能超过 5 分钟的场景。
怎么选:官方建议按业务请求间隔判断。连续追问用默认 5 分钟就够。如果间隔经常超过 5 分钟,传 prompt_cache_options.ttl 选 1 小时,避免缓存过期后同样的前缀要重新付一次写入费。
还有个坑要说清楚:缓存按块存储,不足一整块的部分写不进去,会按缓存未命中计费。所以你的 prompt 结构如果每次前缀都变(比如把时间戳放在最前面),缓存永远命中不了,等于白付写入费。
另一个容易踩的:切换 reasoning_effort 档位会破坏前缀缓存命中。会话开始前就把档位定下来,中途切换等于每次都要重新写一遍缓存。
免费的路子在哪
只想用、不开发的话,API 这个价格跟你没关系。
官方公告写得很清楚,发布当天起可以通过 kimi.com 网页、Kimi App、Kimi Work、Kimi Code 和 Kimi API 五个渠道使用 K3.1 Pro 和 K3.1 Pro Highspeed。前四个都是产品形态,不是按 token 计费的 API。
这里有个必须澄清的误解。Kimi 开放平台的 API 是纯按量计费,官方明确写「不提供订阅制方案」,并且提醒用户注意跟 Kimi 会员、Kimi Code 这些产品区分开。也就是说,买了会员不等于有 API 额度,充了 API 也不等于有会员权益。两套账。
至于 API 侧有没有免费额度:新用户注册认证会送 15 元代金券,但这张券不能用于 K3.1 Pro。官方在常见问题里专门列了这条。想调 K3.1 Pro,国内必须充值解锁,最低 10 元。
所以完整的省钱路径是这样:
- 先确认你是要用还是开发。只聊天写东西,去 kimi.com 用,不花钱。
- 要调 API,先充 10 元解锁,用小额跑通流程再放量。
- 跑通之后看账单结构,输出占比高就限
max_tokens,输入占比高就设计好前缀让缓存命中。 - 有大量重复上下文(同一代码库、同一份文档反复问),优先考虑 1 小时缓存档。
和竞品比处在什么位置
按 163 的报道口径,K3.1 Pro 的美元定价与 GPT-6.1 Sol 持平,是 Claude Opus 5.5 的一半。这个对比我在官方页面上没找到原文,属于媒体口径,引用时请按这个来源看。
按官方美元价,K3.1 Pro 是输入 2 美元、输出 10 美元。要自己跟别家比的话,注意几个容易比错的地方:
- 有的厂商按「输入缓存未命中 / 命中」分两套价,对外宣传只报低价那档。Kimi 是把两档都列全,命中价 0.20 美元,未命中 2.00 美元。
- 有的厂商把缓存写入单独收费,有的打包在输入里。Kimi 是单独列,写入 2.00 美元(5min)或 4.00 美元(1h)。
- 输出价的倍数差是最容易被忽略的。输入便宜但输出贵,长输出场景反而更贵。
比总成本要用你自己的真实 token 结构去算,别只看输入价。
便宜的一半在同门里
如果你的任务不需要 K3.1 Pro 这个档位的智能,K2.7 Code 的输入 6.5 元、输出 27 元明显更便宜,是 K3.1 Pro 的一半。纯编码场景可以考虑。
但时间线要记住:官方模型列表 写明 K2 系列 2026 年 10 月 31 日起停止向新注册用户开放,12 月底全部下线。现在选 K2.7 Code 是短期省钱,年底还得迁。
价格敏感又想要 K3.1 Pro 能力的话,还有个折中方案:用标准版跑主力任务,只在交互式、人在等的环节切 Highspeed。因为两个版本的参数约束完全一致,切换只改 model 名字,不用改代码逻辑。
K3.1 Pro 相比 K3 具体强在哪、值不值这个价,Kimi K3.1 Pro 和 K3 区别对比 有逐项数据。
API 怎么接、Claude Code 怎么配,Kimi K3.1 Pro API 接入教程 里有完整代码。只想确认哪些渠道已上线,Kimi K3.1 发布状态追踪 按渠道列了。
常见问题
Kimi K3.1 Pro 多少钱一百万 token?
官方人民币价:输入 13.00 元、输出 68.00 元、缓存命中 1.30 元、缓存写入 13.00 元(5 分钟 TTL)或 26.00 元(1 小时 TTL)。Highspeed 版输入 26.00 元、输出 136.00 元,缓存命中仍为 1.30 元。
Kimi K3.1 Pro 免费吗?
看你怎么用。在 kimi.com 网页、Kimi App、Kimi Work、Kimi Code 里用是产品形态,不按 token 收费。调 API 是纯按量计费,没有订阅制,新用户送的 15 元代金券不能用于 K3.1 Pro,国内需充值最低 10 元解锁。
K3.1 Pro 比 K3 贵吗?
不贵,反而便宜。K3 是输入 20 元、输出 100 元,K3.1 Pro 是输入 13 元、输出 68 元,输入便宜 35%、输出便宜 32%。
Highspeed 版价格翻倍,缓存也是双倍吗?
不是。Highspeed 的输入和输出是标准版的 2 倍(26 元 / 136 元),但缓存命中价两者相同,都是 1.30 元每百万 token。有大量重复前缀的场景,实际溢价低于表面上的 2 倍。
Kimi API 有免费额度吗?
K3.1 Pro 没有。新用户注册认证赠送 15 元代金券,官方明确说明不可用于 Kimi K3.1 Pro。想调用必须先充值,国内最低 10 元,海外最低 1 美元。
 京ICP备2024094994号-29