
Kimi K3.1 Pro Highspeed 和普通版区别:附成本表
先把结论放前面:Highspeed 和普通版的智能完全一样,区别只有两个,输出速度快到大约 2 到 3 倍,价格贵到正好 2 倍。 甜点场景是聊天框里等答案、Agent 一轮轮跑工具调用;不适合的是长文档批量生成这类「慢一点也无所谓、但量大」的活儿。
这个判断依据来自官方文档和三条独立的媒体核实。月之暗面在 2026 年 10 月 24 日凌晨发布 K3.1 Pro,Highspeed 是同步上线的另一个模型 ID(Kimi API 官方文档、北京商报报道)。官方原文是「同等智能,输出速度约 2 到 3 倍」,没有公布 Highspeed 单独的能力测评,也没有公布它的具体 token 每秒数字。这两项到发稿时官方都没公布。
一张表看两个版本的全部差异
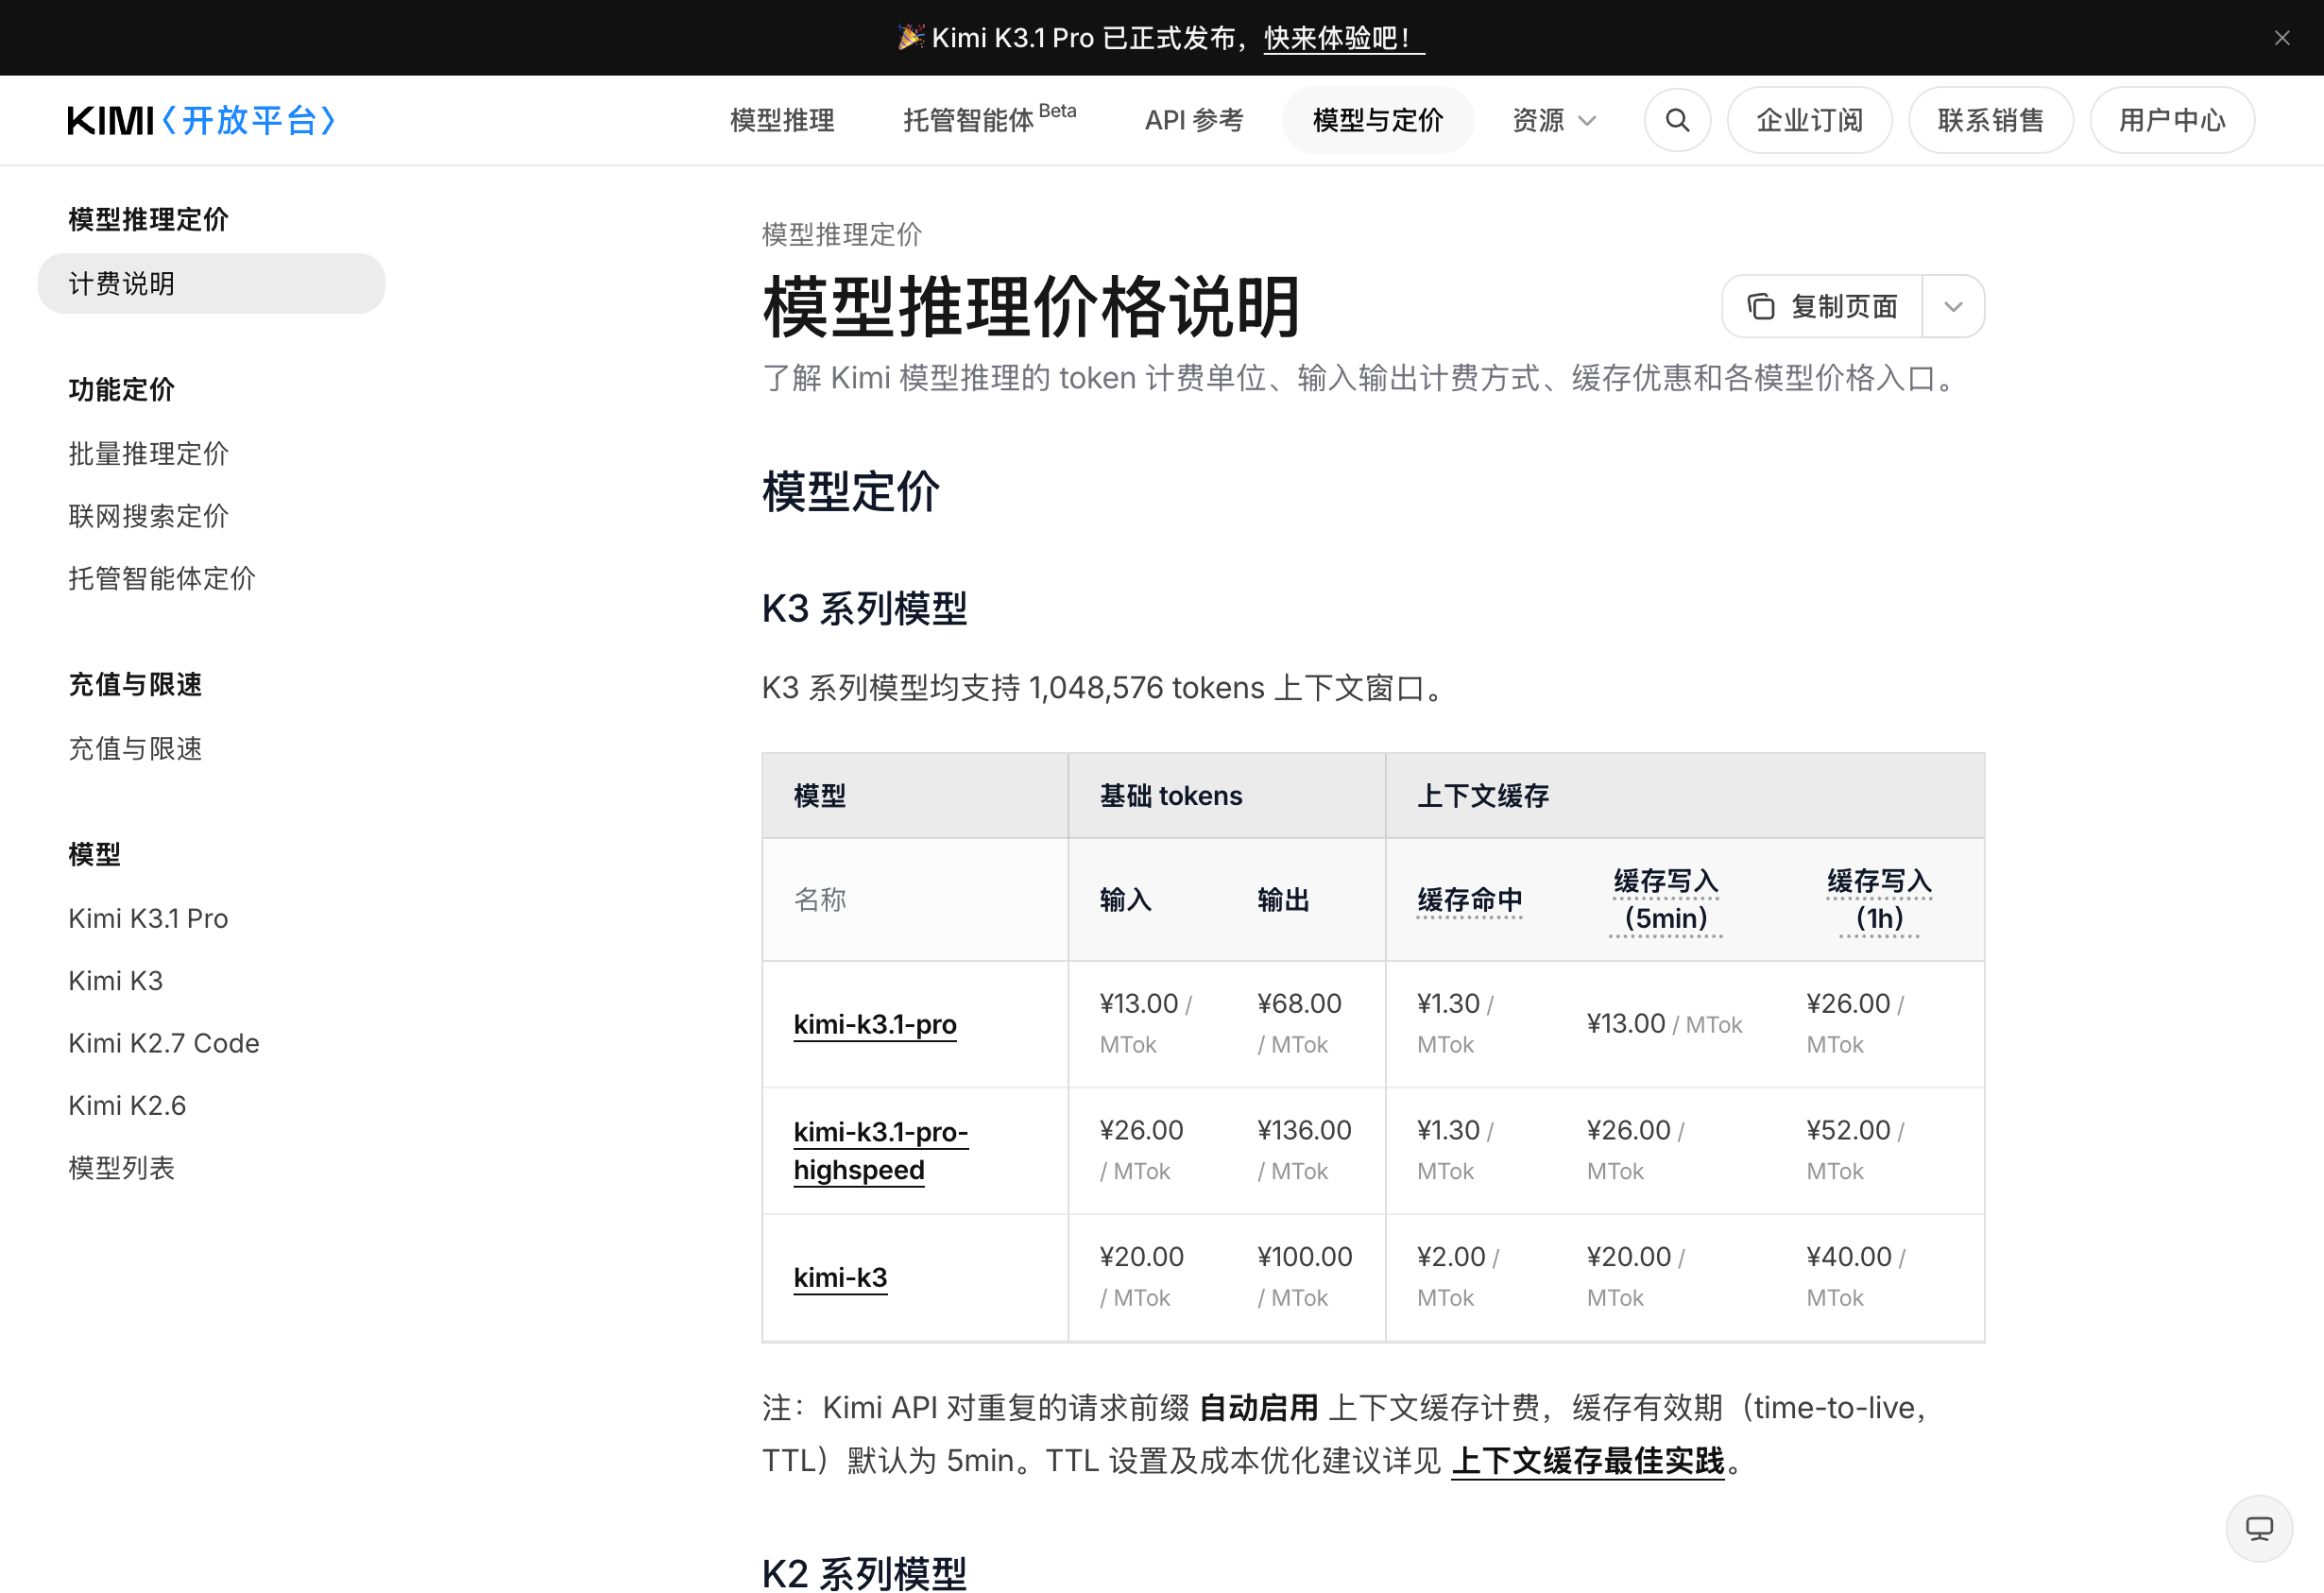
先把能查到的差异一次列完,剩下的全是空白。表格里的价格是官方公布的人民币单价,单位是每百万 tokens。
| 对比维度 | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
|---|---|---|
| 模型 ID | kimi-k3.1-pro |
kimi-k3.1-pro-highspeed |
| 智能水平 | 基准线 | 官方称同等智能 |
| 输出速度 | 基准线 | 约 2 到 3 倍(官方口径) |
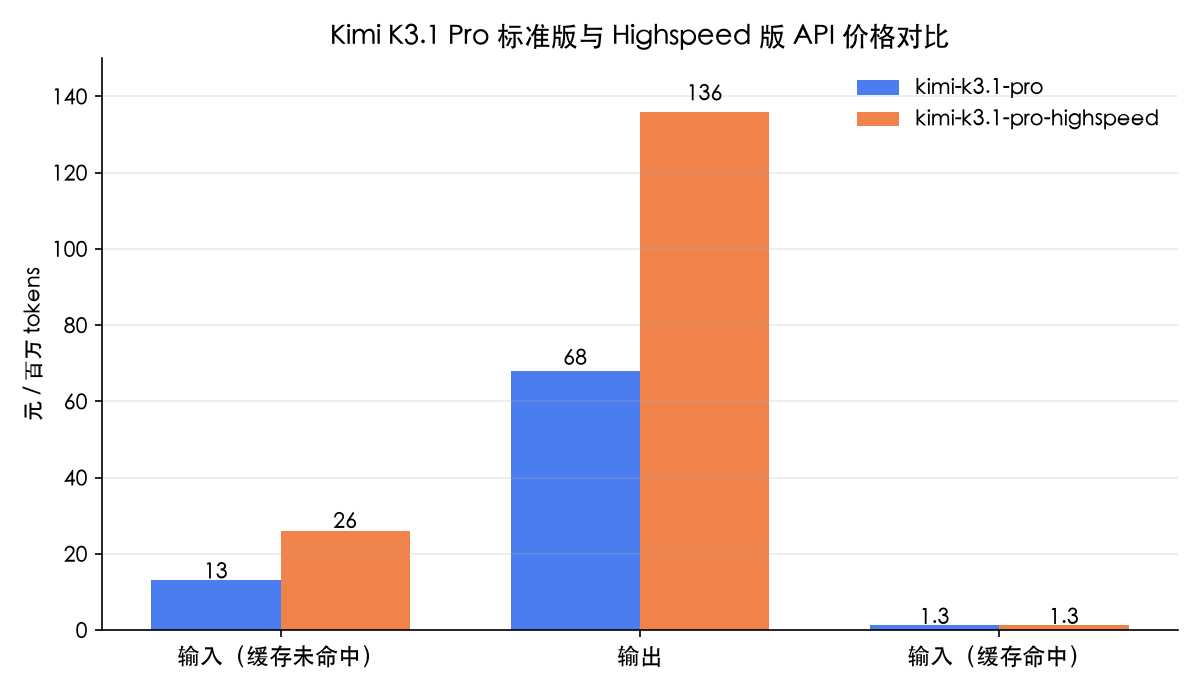
| 输入价格(缓存命中) | 1.3 元 | 1.3 元 |
| 输入价格(缓存未命中) | 13 元 | 26 元 |
| 输出价格 | 68 元 | 136 元 |
| 上下文窗口 | 1,048,576 tokens | 1,048,576 tokens |
| 参数规模 | 3 万亿级(激活参数官方未公布) | 官方未单独公布 |
| 原生视觉输入 | 支持 | 官方未单独说明 |
| 推理强度档位 | low / high / max | 官方未单独说明 |
| 开放权重 | 11 月 4 日前发布 | 官方未单独说明 |
| 可用入口 | kimi.com、App、Kimi Work、Kimi Code、API | 同左(官方口径一致) |
这张表里最值得注意的一行是缓存命中价格:两边都是 1.3 元,没变。 也就是说,Highspeed 的溢价全部压在「新内容」上,未命中的输入翻倍,输出翻倍,命中的输入一分不多。如果你的活儿是同一个长上下文里反复追问,这个细节能省下相当一部分钱。
价格这笔账:翻倍到底翻多少
单价翻倍听起来抽象,换成实际任务才有感觉。按官方公布的单价算三种典型用法,假设缓存全部未命中(这是最保守的算法)。
第一种,一问一答的轻量咨询。 输入 2000 tokens、输出 2000 tokens,四个来回。普通版总共约 0.33 元,Highspeed 约 0.65 元。一顿早饭钱的差距,你换来的是四个来回各自少等几秒,这个交换多数人是愿意的。
第二种,单次长文生成。 输入 2000 tokens、输出 30000 tokens,就是让它写一份两万字左右的材料。普通版约 2.07 元,Highspeed 约 4.11 元。差价两块钱,换来的时间取决于你本来要盯多久屏幕。
第三种,Agent 连续跑工具。 这是最该算的场景。假设一轮对话里模型要输出 40 万 tokens 的思考过程和中间结果(这个量级在重型 Agent 任务里不算夸张),普通版约 27.23 元,Highspeed 约 54.47 元。差价 27 元,买的是把原来可能一两个小时的等待压到一半甚至三分之一。
| 典型用法 | 输入 tokens | 输出 tokens | 普通版成本 | Highspeed 成本 | 差额 |
|---|---|---|---|---|---|
| 轻量咨询,4 来回 | 8000 | 8000 | 约 0.33 元 | 约 0.65 元 | 0.32 元 |
| 单次两万字长文 | 2000 | 30000 | 约 2.07 元 | 约 4.11 元 | 2.04 元 |
| 重型 Agent 任务 | 20000 | 400000 | 约 27.23 元 | 约 54.47 元 | 27.24 元 |
这三个数字都是按公开单价直接乘出来的,不含缓存命中优惠,也没有算缓存写入费用。真实账单会比这个低,接口在重复前缀上自动启用缓存计费,默认 TTL 是 5 分钟,具体见官方价格页。
还有一笔账容易漏:Artificial Analysis 算过,K3.1 Pro 完成同样任务比 K3 多用约 14% 的输出 token。也就是说,你不只是在普通版和高速版之间选,你还在「新一代更啰嗦」这个既定前提下选。基准变了,但两个版本的相对关系没变。
那 2 到 3 倍的速度,体感是什么
这一节我得诚实一点:官方没给 tokens 每秒的数字,我也没找到 Highspeed 的第三方吞吐测试,所以这里只能讲定性的体感,不能编数字。
能确认的是 K3.1 Pro 普通版本身已经比 K3 快了不少。有实测文章的作者原话是「这次我没有开高速模式,普通 Pro 的速度就已经让我满意」,还补了一句「虽然肯定还达不到各家 flash 那种感觉,但是完全是正常偏快的思考速度」(量子位系实测报道)。
K3 时代的慢是出了名的。极客公园那篇报道里的形容是慢到「可以流畅阅读它的英文思考过程」,到 K3.1 Pro 思考过程大多一闪而过(极客公园报道)。
所以真实的体感阶梯是这样:K3 特别慢,K3.1 Pro 普通版回到正常偏快,Highspeed 在这之上再乘 2 到 3。如果你是冲着「摆脱 K3 那种慢」来的,普通版就够了;你要的是「比别人都快」,才需要考虑高速版。
这也是一个容易误解的地方。Highspeed 和 K3 到 K3.1 的提速是两件不同的事,别把两个倍数乘起来算。前一个倍数来自后训练和推理优化,后一个倍数来自版本选择,官方对后者单独解释过吗?没有,技术博客主要谈的是训练侧的 RL 投入,推理端做了哪些调整官方没有展开。
智能真的「同等」吗:官方没说的那一半
官方口径是「同等智能」,但这四个字的边界值得说清楚。
已确认的是,智能指数的所有分数、Terminal-Bench 的 65.7%、OfficeQA Pro v2 的 64.4%、BenchCAD 的 92.7%,这些数字都是给 K3.1 Pro 这个基座报的,Highspeed 没有单独跑分。从工程角度看这合理,同底座换推理加速,能力不变是预期内的。
但「预期内」不等于「已验证」。加速方案通常会引入取舍,比如更激进的并行、更短的思考预算、cache 复用策略的差异,这些在官方文档里都没提。我查了 Kimi 平台的限速文档,那里只有按账户累计充值金额分层的并发、RPM、TPM、TPD 表,没有针对 Highspeed 单独设限,也没提到 Highspeed 有额外配额。Highspeed 到底在哪一层做了加速、有没有精度妥协,官方没公布。
对使用者来说,实操建议很直接:拿你自己的一个真实任务,两个版本各跑一遍,对比输出质量。别用网上的「同一个 prompt 出图好不好看」来判,那个变量太多。
五个场景,直接对号入座
场景一:聊天框里等答案,你人在屏幕前
选 Highspeed。判断依据是「等待成本归你」。你在写东西、在改代码、在跟模型来回对需求,这几秒钟直接换算成你的注意力损耗。这种情况下输出通常也不长,单价翻倍的实际金额很小。
场景二:Agent 一轮轮跑工具,中间不等你
这是 Highspeed 最值钱的场景。Agent 的特点是一轮对话里反复调工具、反复读结果,输出 token 量巨大,而且每一轮都得等上一轮结束。速度翻倍意味着整条链路的墙钟时间大幅缩短,而你付的倍数钱相对总成本来说完全可接受。有开发者做过对比,同样的任务 K3.1 Pro 花了 20 分钟,换 K3 估计要 40 分钟到 1 个小时。
场景三:批量跑几千条,跑完再看
选普通版。这类活儿的约束是成本和时间窗,不是你的注意力。晚上挂上去第二天看结果,快慢差别对你没有价值,价格翻倍是纯损失。
场景四:反复追问同一个长文档
选普通版,但把缓存配置做对。命中缓存的输入两边都是 1.3 元,这一档没有溢价。如果两次请求的间隔可能超过 5 分钟,记得把 prompt_cache_options.ttl 设成 1h,避免缓存过期后重复写入白花钱。这条在官方 quickstart 里有写,很多人漏掉。
场景五:订阅会员,不是按 API 计费
这件事跟 API 单价完全无关,得单独说,因为它踩的人最多。
订阅用户要注意:会员额度跟 API 单价是两套账
API 降价了三分之一,但订阅用户的体感是反的。10 月 24 日上线后,社区里大量反馈额度消耗异常快:有 199 元档用户让模型安装一个 Skill 就消耗掉 5 小时限额的 70%,另一位测算正常使用 1 小时就用掉 5 小时滚动额度的 27%(科创板日报报道)。还有用户说 Highspeed 用起来「真的很舒服」,但 5 小时的额度撑不到 2 小时。
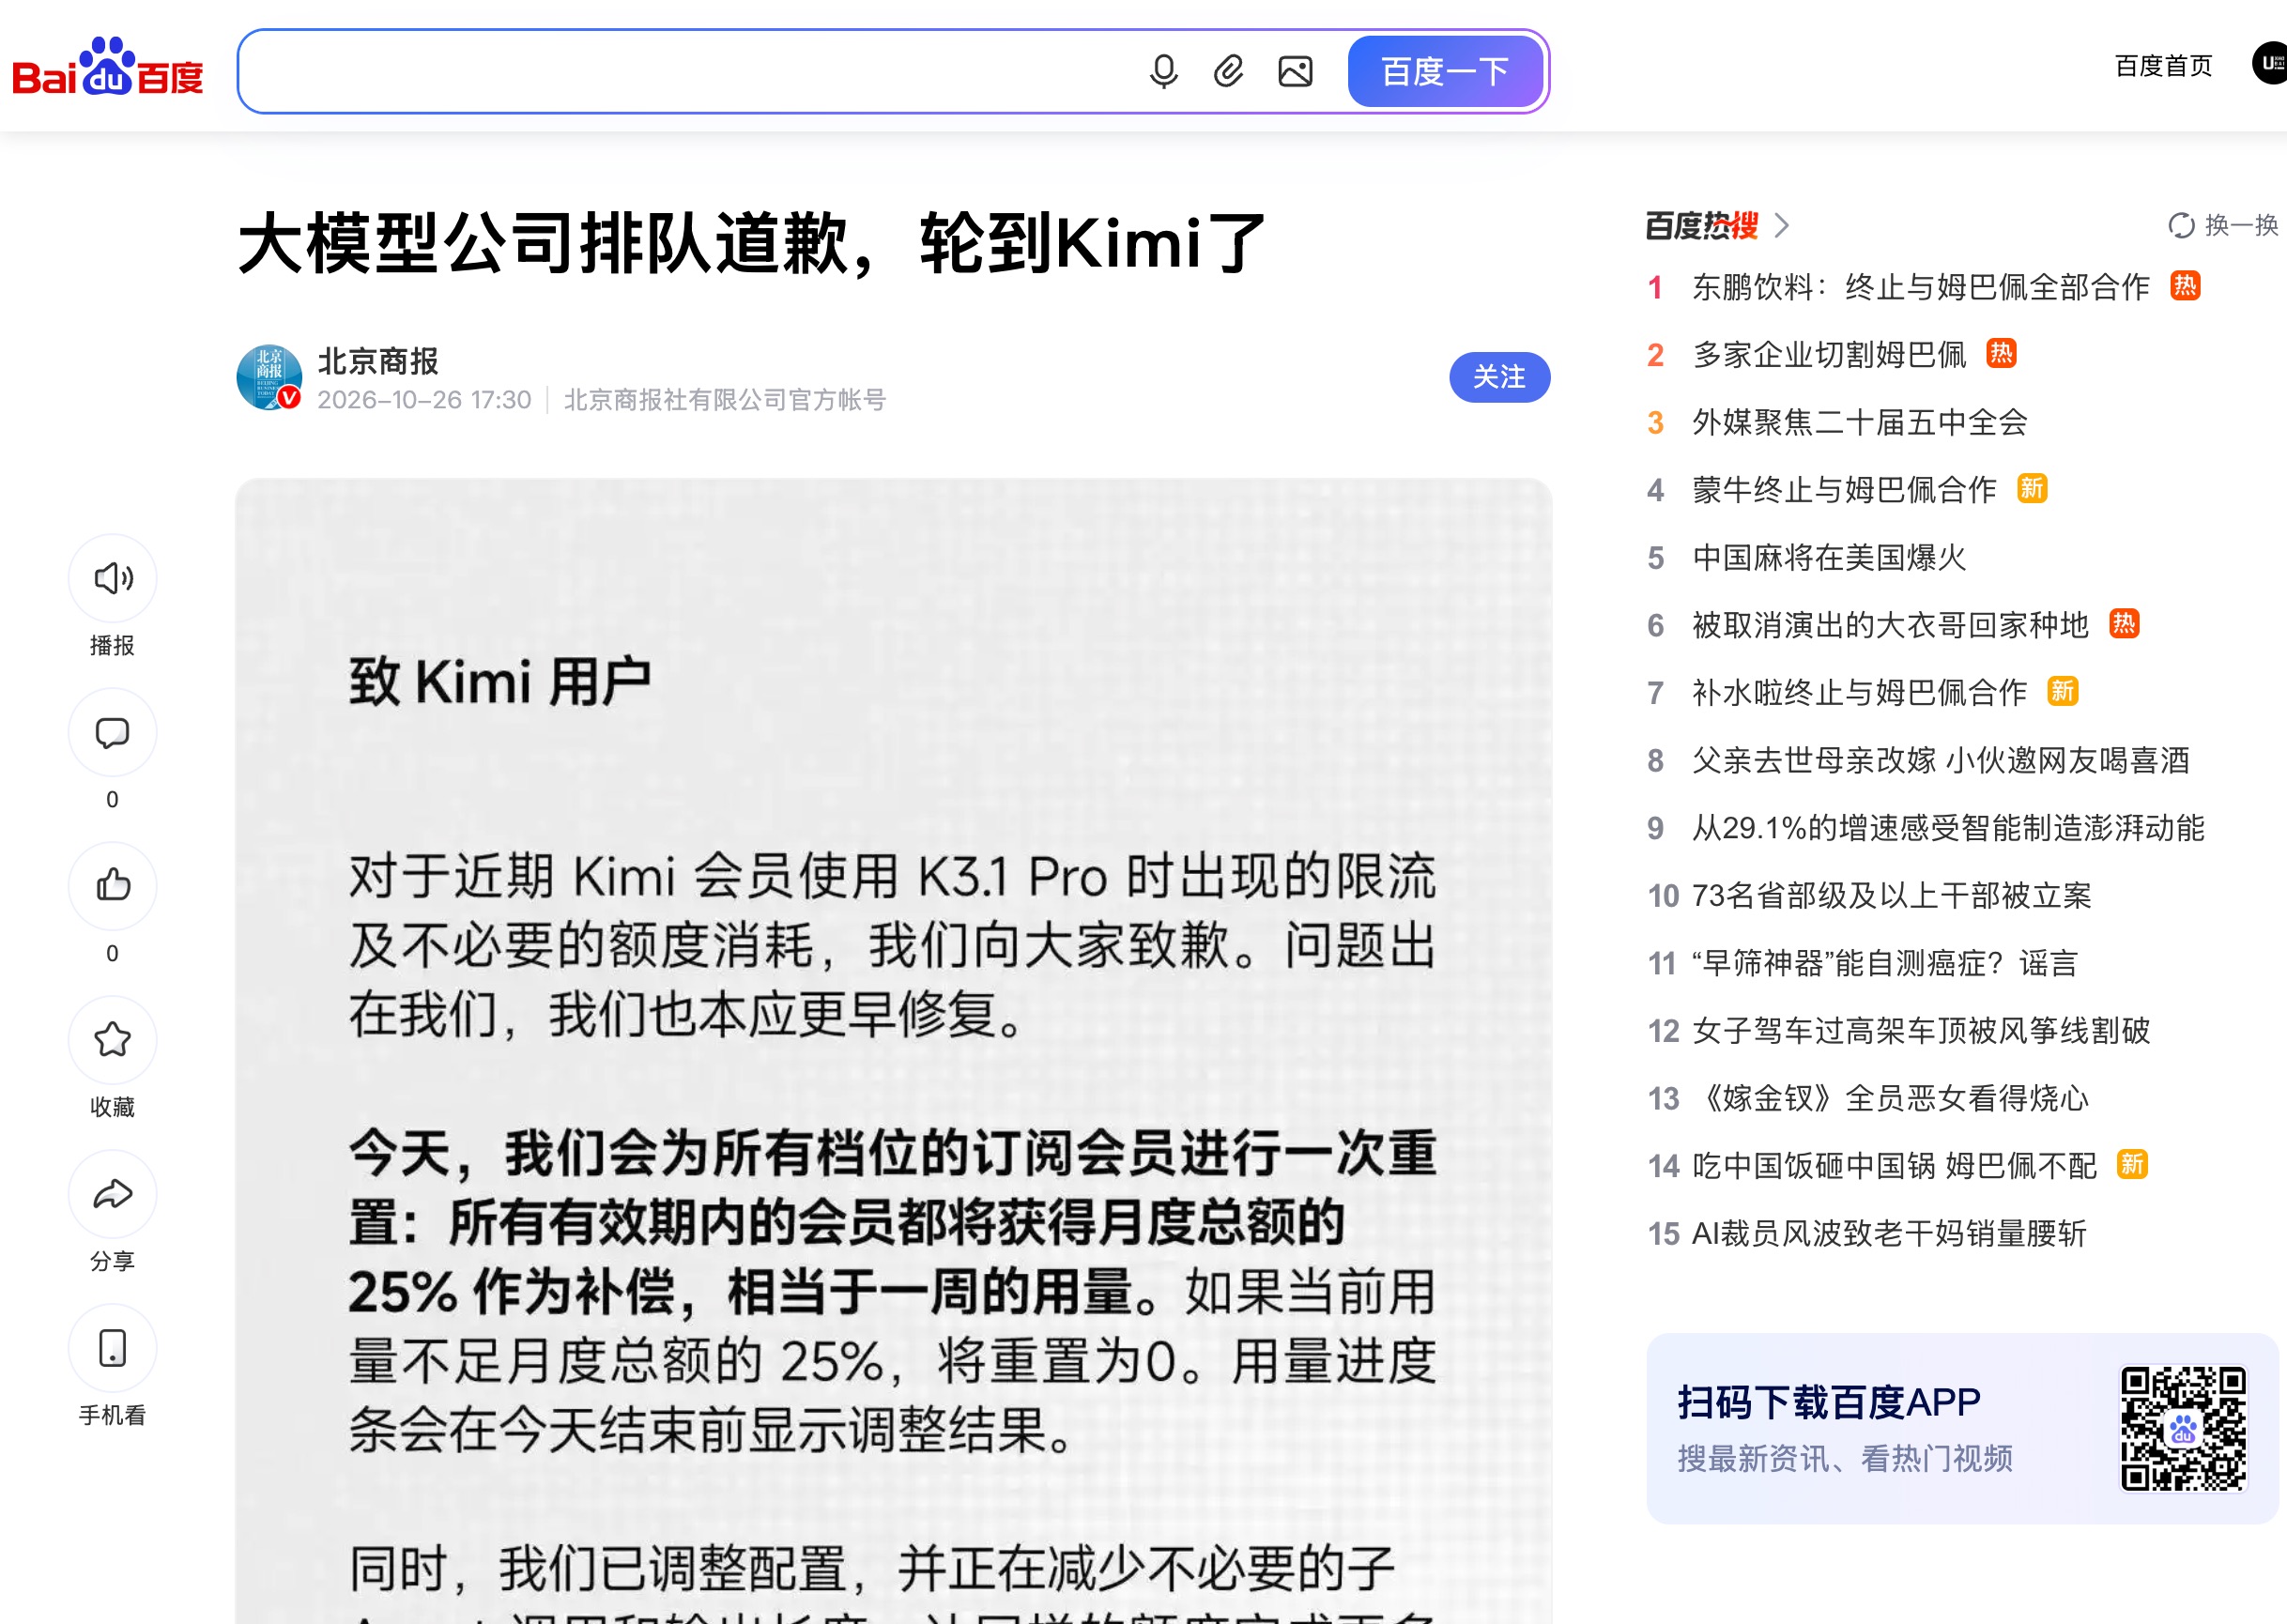
10 月 26 日凌晨,Kimi 就限流和不必要的额度消耗致歉,对所有有效期内的订阅会员按月度总额的 25% 补偿一次,已用不足 25% 的直接清零(北京商报报道)。官方同时说明已调整配置,在减少不必要的子 Agent 调用和输出长度。
这条对选型的含义是:在会员体系里,Highspeed 的「价格」不是单价倍数,而是它更快烧完的那个 5 小时窗口。 如果你在用 199 元档这种中低档会员,把 Highspeed 当默认选项会很痛苦,建议只在明确要赶时间的任务里手动切过去。用 API 的话反而是另一回事,价格透明、按量付费,不存在窗口概念。
怎么真正用上 Highspeed
五个入口都能选到它,官方口径是「即日起,可通过 kimi.com、Kimi App、Kimi Work、Kimi Code 和 Kimi API 使用」。
AI 写到这里必须补一句实操细节:kimi.com 网页版的模型选择器里,Highspeed 是作为一个独立模型项出现的,不是普通版上的一个开关。 找不到就往模型列表下拉,别在对话设置里翻。
API 侧最简单,改一个字符串就行:
completion = client.chat.completions.create(
    model="kimi-k3.1-pro-highspeed",
    messages=[{"role": "user", "content": "分析这份财报的关键风险"}],
)
base_url 用 https://api.moonshot.cn/v1,和普通版完全一致,不用换域名。完整的参数写法、视觉输入和工具调用配置,在API 接入教程里已经拆过了,这里不重复。
有个门槛要提醒:K3.1 Pro 是旗舰模型,需要在开放平台充值后才能调用,最低充值 10 元,新用户注册赠送的 15 元代金券不能用于这个模型。充值金额同时决定你的限速档位。调用太猛碰到 429 的话,429 排查笔记里有现成的退避参数。
和 K3、和海外旗舰放一起看
如果纠结的不只是 Highspeed,而是「要不要从 K3 升上来」,那是另一个问题。K3.1 Pro 和 K3 的逐项对比已经列了完整差异表。一句话:底座没换,用 14% 的额外输出 token 和三分之一的降价,换来智能指数从 44 到 55 的跃升,这笔买卖对绝大多数人划算。
和海外旗舰的关系也值得摆一下。Artificial Analysis 智能指数上 K3.1 Pro 是 55 分,排全球第四,前面是 Claude Opus 5.5、Claude Sonnet 5.5 和 Muse Wonder Full。整体价格大约是 GPT-6 Astra 的五分之一。有意思的是,如果你拿 Highspeed 去比,单价翻倍后大概是 GPT-6 Astra 的五分之二,仍然更便宜,而速度差距被大幅压缩。这可能是和海外旗舰正面比时,Highspeed 最容易被忽略的价值点。
想把整体价格结构搞清楚,K3.1 Pro 价格测算那篇把人民币表格和用量算法都列全了。
一个反常识的建议
多数对比文章会告诉你「按需选择」,这话等于没说。我给一个更硬的判断标准:
看你的等待时间能不能并行。 如果模型在跑的时候你能去干别的,选普通版,省下的钱是确定的。如果你必须盯着屏幕等结果才能往下走,选 Highspeed,省下的时间也是确定的。这两种情况没有一个通用的最优解,但判断只需要问自己一句:这会儿我是不是被卡住了。
还有一个补丁:先用普通版估 token 量。等你摸清自己那类任务的真实消耗,再决定哪些迁移到 Highspeed,别一上来就把所有调用切换过去,收到第一张账单才发现不对。
常见问题
Kimi K3.1 Pro Highspeed 和普通版智能水平一样吗
官方口径是「同等智能」,智能指数、Terminal-Bench 等所有公开分数都是给 K3.1 Pro 基座报的,Highspeed 没有单独跑分。从工程逻辑看同底座加速不该改变能力,但官方没有公布 Highspeed 的具体加速方案,也没有说明是否有精度取舍。建议拿自己的真实任务两个版本各跑一遍对比。
Highspeed 具体快多少,有 tokens 每秒的数据吗
官方只说「输出速度约 2 到 3 倍」,没有公布 tokens 每秒的绝对值,第三方也还没有吞吐测试。能确认的是 K3.1 Pro 普通版本身已经比 K3 明显快,Highspeed 是在这个新基线之上再乘 2 到 3。
Highspeed 的 API 价格是普通版几倍
输出价格 136 元每百万 tokens,是标准版 68 元的 2 倍;输入未命中缓存 26 元,也是 13 元的 2 倍;输入命中缓存两边都是 1.3 元,没有溢价。同一段长上下文反复追问的场景,成本差距会比想象中小很多。
会员套餐里用 Highspeed 会不会更费额度
会,体感明显。10 月 24 日上线后有 199 元档用户反馈让模型装一个 Skill 就吃掉 5 小时限额的 70%,也有用户说 Highspeed 的 5 小时额度撑不到 2 小时。10 月 26 日官方已致歉并按月度总额 25% 补偿全体订阅会员,同时调低了子 Agent 调用和输出长度的冗余。用会员的话建议只在赶时间时手动切 Highspeed。
Highspeed 支持多长的上下文,能传图和视频吗
上下文窗口和标准版一样是 1,048,576 tokens。标准版支持原生视觉输入,图片走 base64 或 ms:// 文件 ID,视频走 files 接口上传后引用;Highspeed 的视觉支持情况官方文档没有单独列出,默认应与标准版一致,但调用前建议先用一张图测一次再上生产。
什么时候必须用普通版而不能用 Highspeed
三种情况:批量离线生成、成本敏感的大规模调用、以及需要开到 max 推理强度的复杂推理解题。官方在标准版文档里明确推理强度支持 low / high / max 三档且默认 max,Highspeed 的推理强度档位官方没有单独说明,重型推理任务留在标准版更稳妥。
 京ICP备2024094994号-29