
GPT-6 API 接入教程:5 步上手与缓存省钱配置
接入 GPT-6 API 一共 5 步:创建 API Key、选对模型 ID、发起首次调用、配置 prompt caching、用 Dashboard 验证成本。前置条件只有一个 OpenAI 账号和可用的支付方式,Sol/Luna 的新价格(Sol 输入 $2/输出 $10,Luna 输入 $0.10/输出 $0.50,每百万 token)在平台自动生效,无需申请。本文基于 OpenAI 2026 年 9 月 22 日官方公告与文档整理。
价格与缓存数据来源:OpenAI 官方公告。接口细节以 platform.openai.com 文档为准。
接入前的准备
开始之前确认三件事:
- 一个可登录的 OpenAI 账号(注册入口 platform.openai.com)
- 可用的国际支付方式,用于 Billing 充值
- 稳定的网络环境。注意 OpenAI 服务不对中国大陆地区提供服务,可用性以官方支持地区列表为准,请通过合规方式使用
如果你还在 Sol 和 Luna 之间犹豫,先记住一句:日常业务和编程用 Sol,海量轻量任务用 Luna。详细的选型对比看这篇 GPT-6 Sol 和 Astra 哪个好。
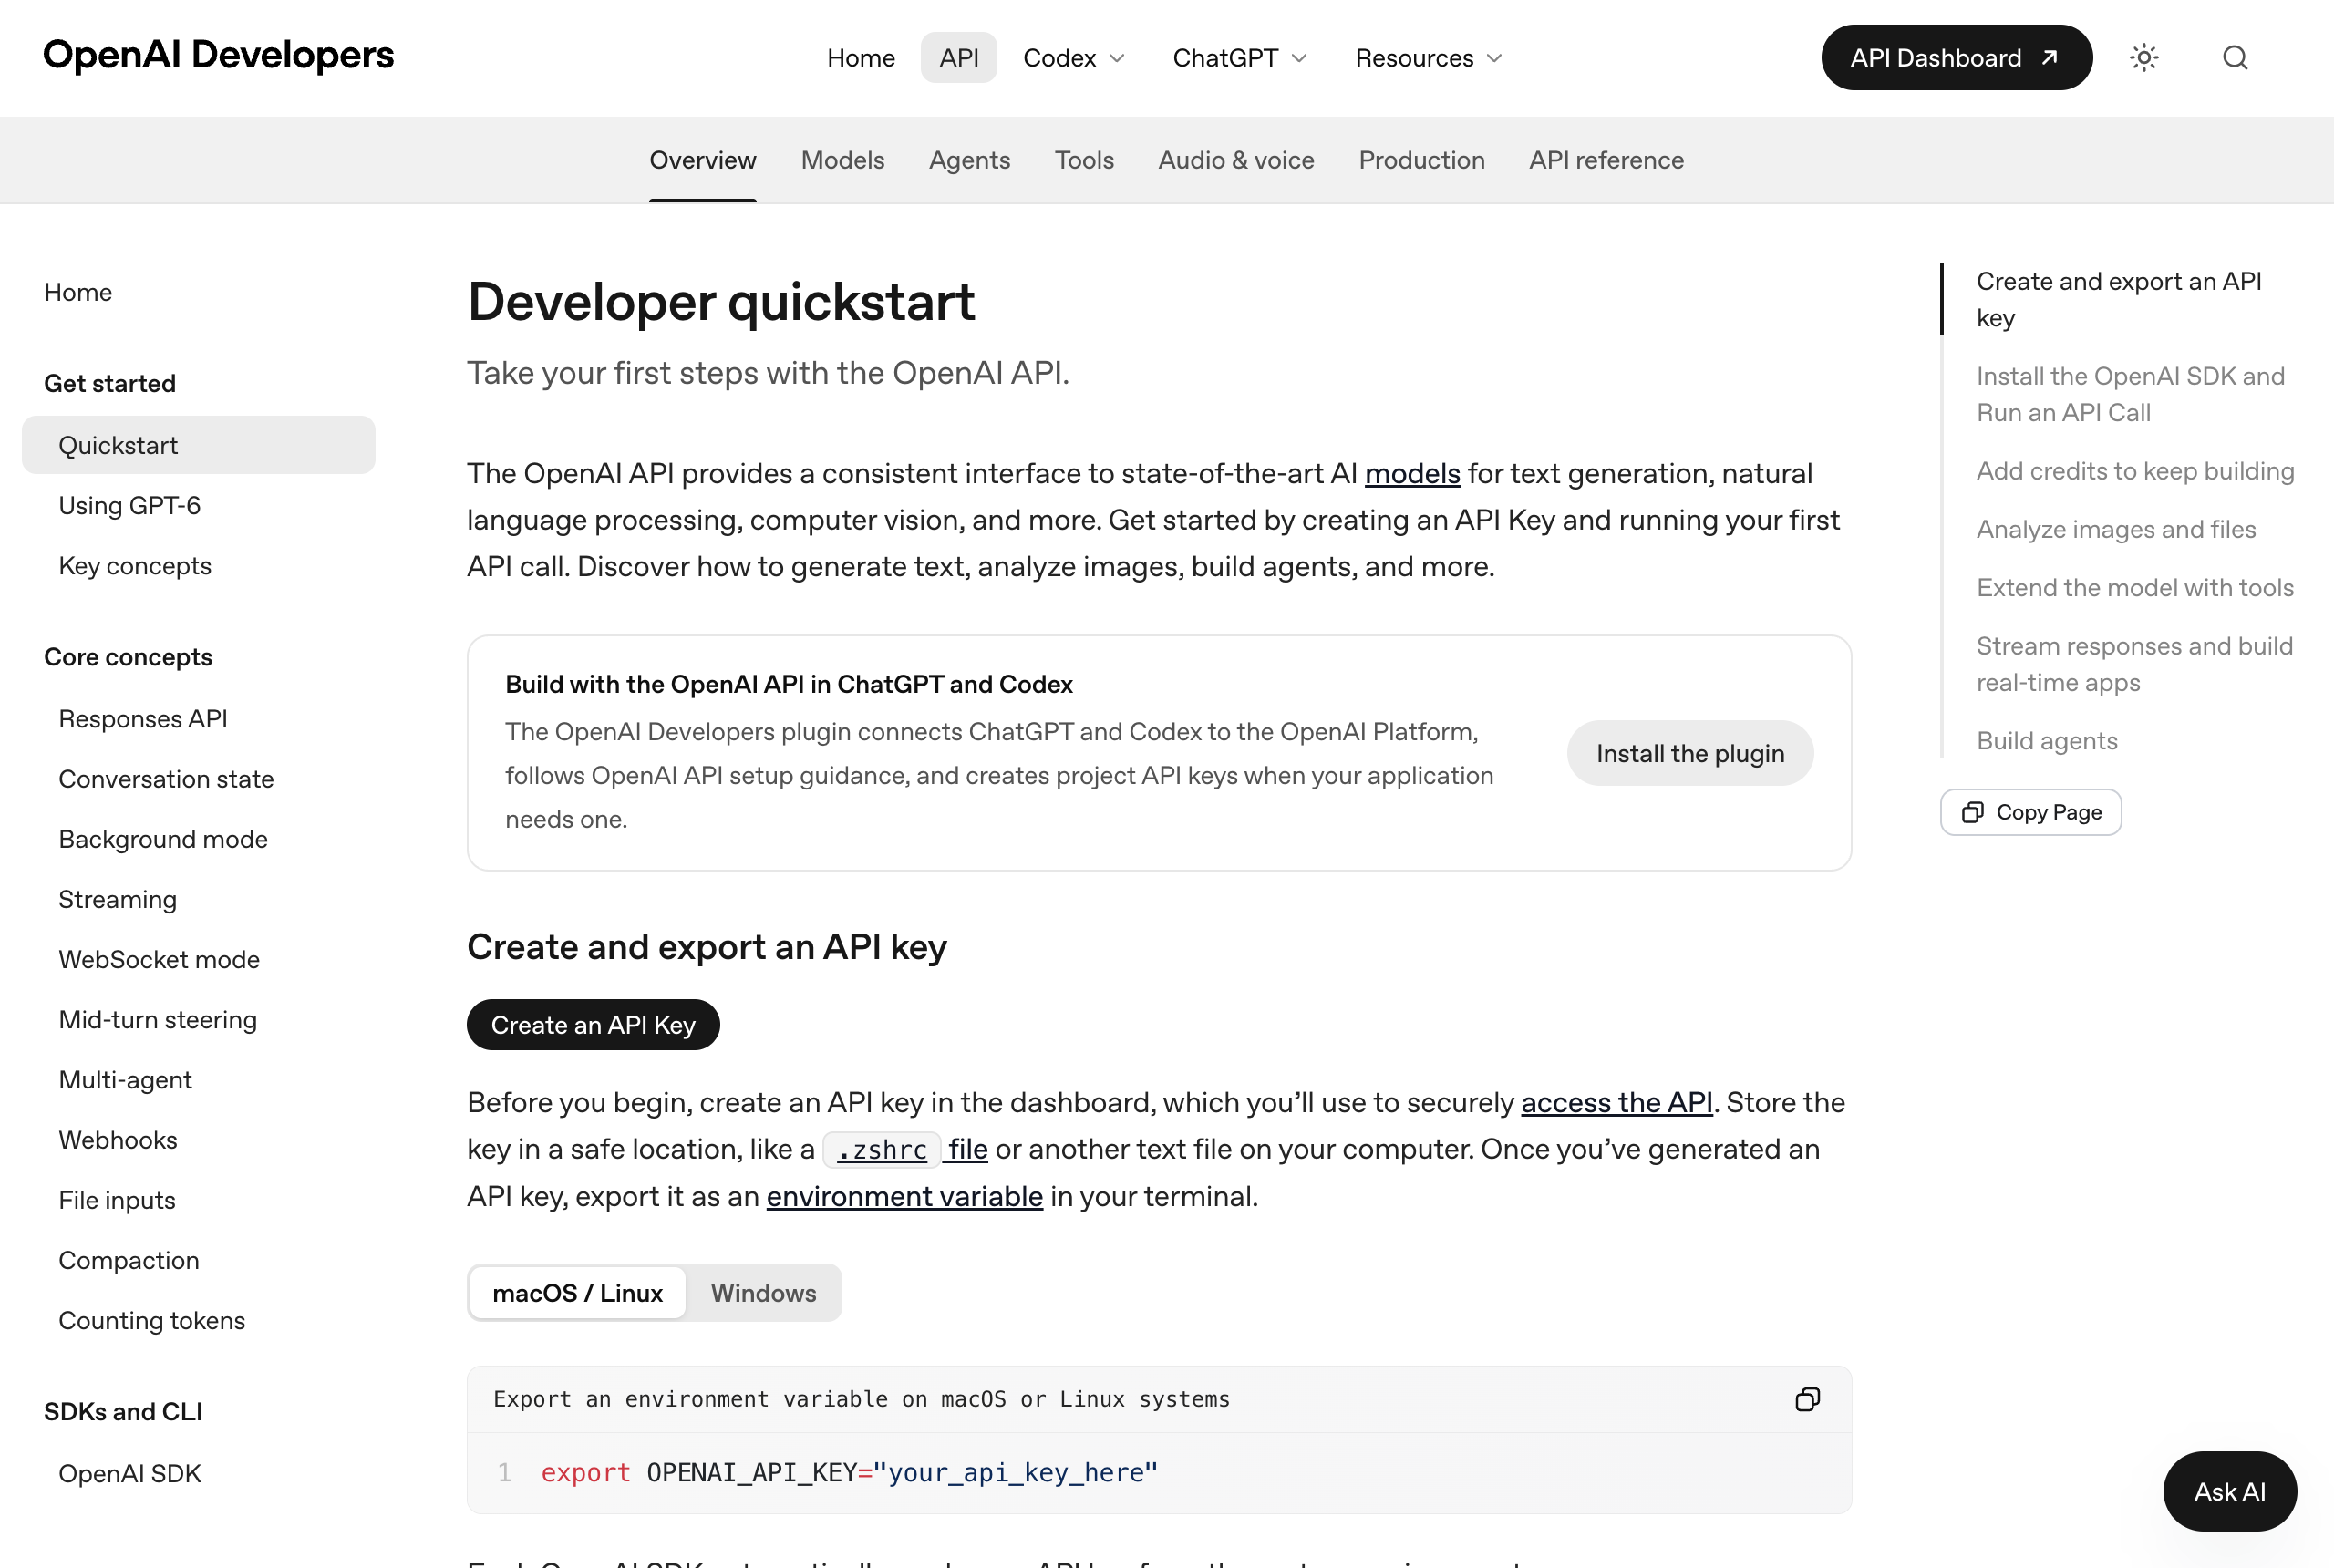
第 1 步:创建 API Key
登录 platform.openai.com,进入 API Keys 页面,点击 Create new secret key,命名后生成。
两个常见卡点:
- Key 只在生成时完整显示一次,立刻复制保存,丢了只能重新生成
- 先在 Billing 页完成充值,否则首次调用会报余额不足
把 Key 存到环境变量 OPENAI_API_KEY,不要写死在代码里,避免泄漏。
第 2 步:选对模型 ID
调用时的 model 参数决定你用哪个档位。按官方命名习惯,GPT-6 系列的模型 ID 形如 gpt-6-sol 和 gpt-6-luna;发起调用前,先请求一次模型列表接口(/v1/models)确认当前可用的准确 ID,以列表返回为准。
| 任务类型 | 建议档位 | 理由 |
|---|---|---|
| 业务工作流、Agent 编排 | Sol | AutomationBench 每任务 $0.27,得分超过竞品旗舰 |
| 编程与代码 Agent | Sol | DeepSWE 1.1 得分 68.8%,成本低约 80% |
| 分类、抽取、摘要、简单对话 | Luna | 输入 $0.10 每百万 token,海量调用可承受 |
| 最复杂的专业任务 | Astra | 全场景最强,需要最深推理时才上 |
另外要理解 effort(推理力度)这个参数:从低到高一般分为 low 到 max 多档,任务越难档位越高、成本也越高。9 月 22 日更新后,中途调整 effort 不会破坏已建立的缓存,这让按任务难度动态调档变得没有额外代价。订阅套餐的额度限制是另一套体系,见 GPT-6 Astra 每周额度与省额度技巧。
第 3 步:发起首次调用
先用 curl 验证连通性:
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6-sol", "messages": [{"role": "user", "content": "用一句话介绍 GPT-6 Sol"}]}'
再用 Python SDK 写进代码:
from openai import OpenAI

client = OpenAI()  # 自动读取环境变量 OPENAI_API_KEY

resp = client.chat.completions.create(
    model="gpt-6-sol",
    messages=[{"role": "user", "content": "用一句话介绍 GPT-6 Sol"}],
)
print(resp.choices[0].message.content)
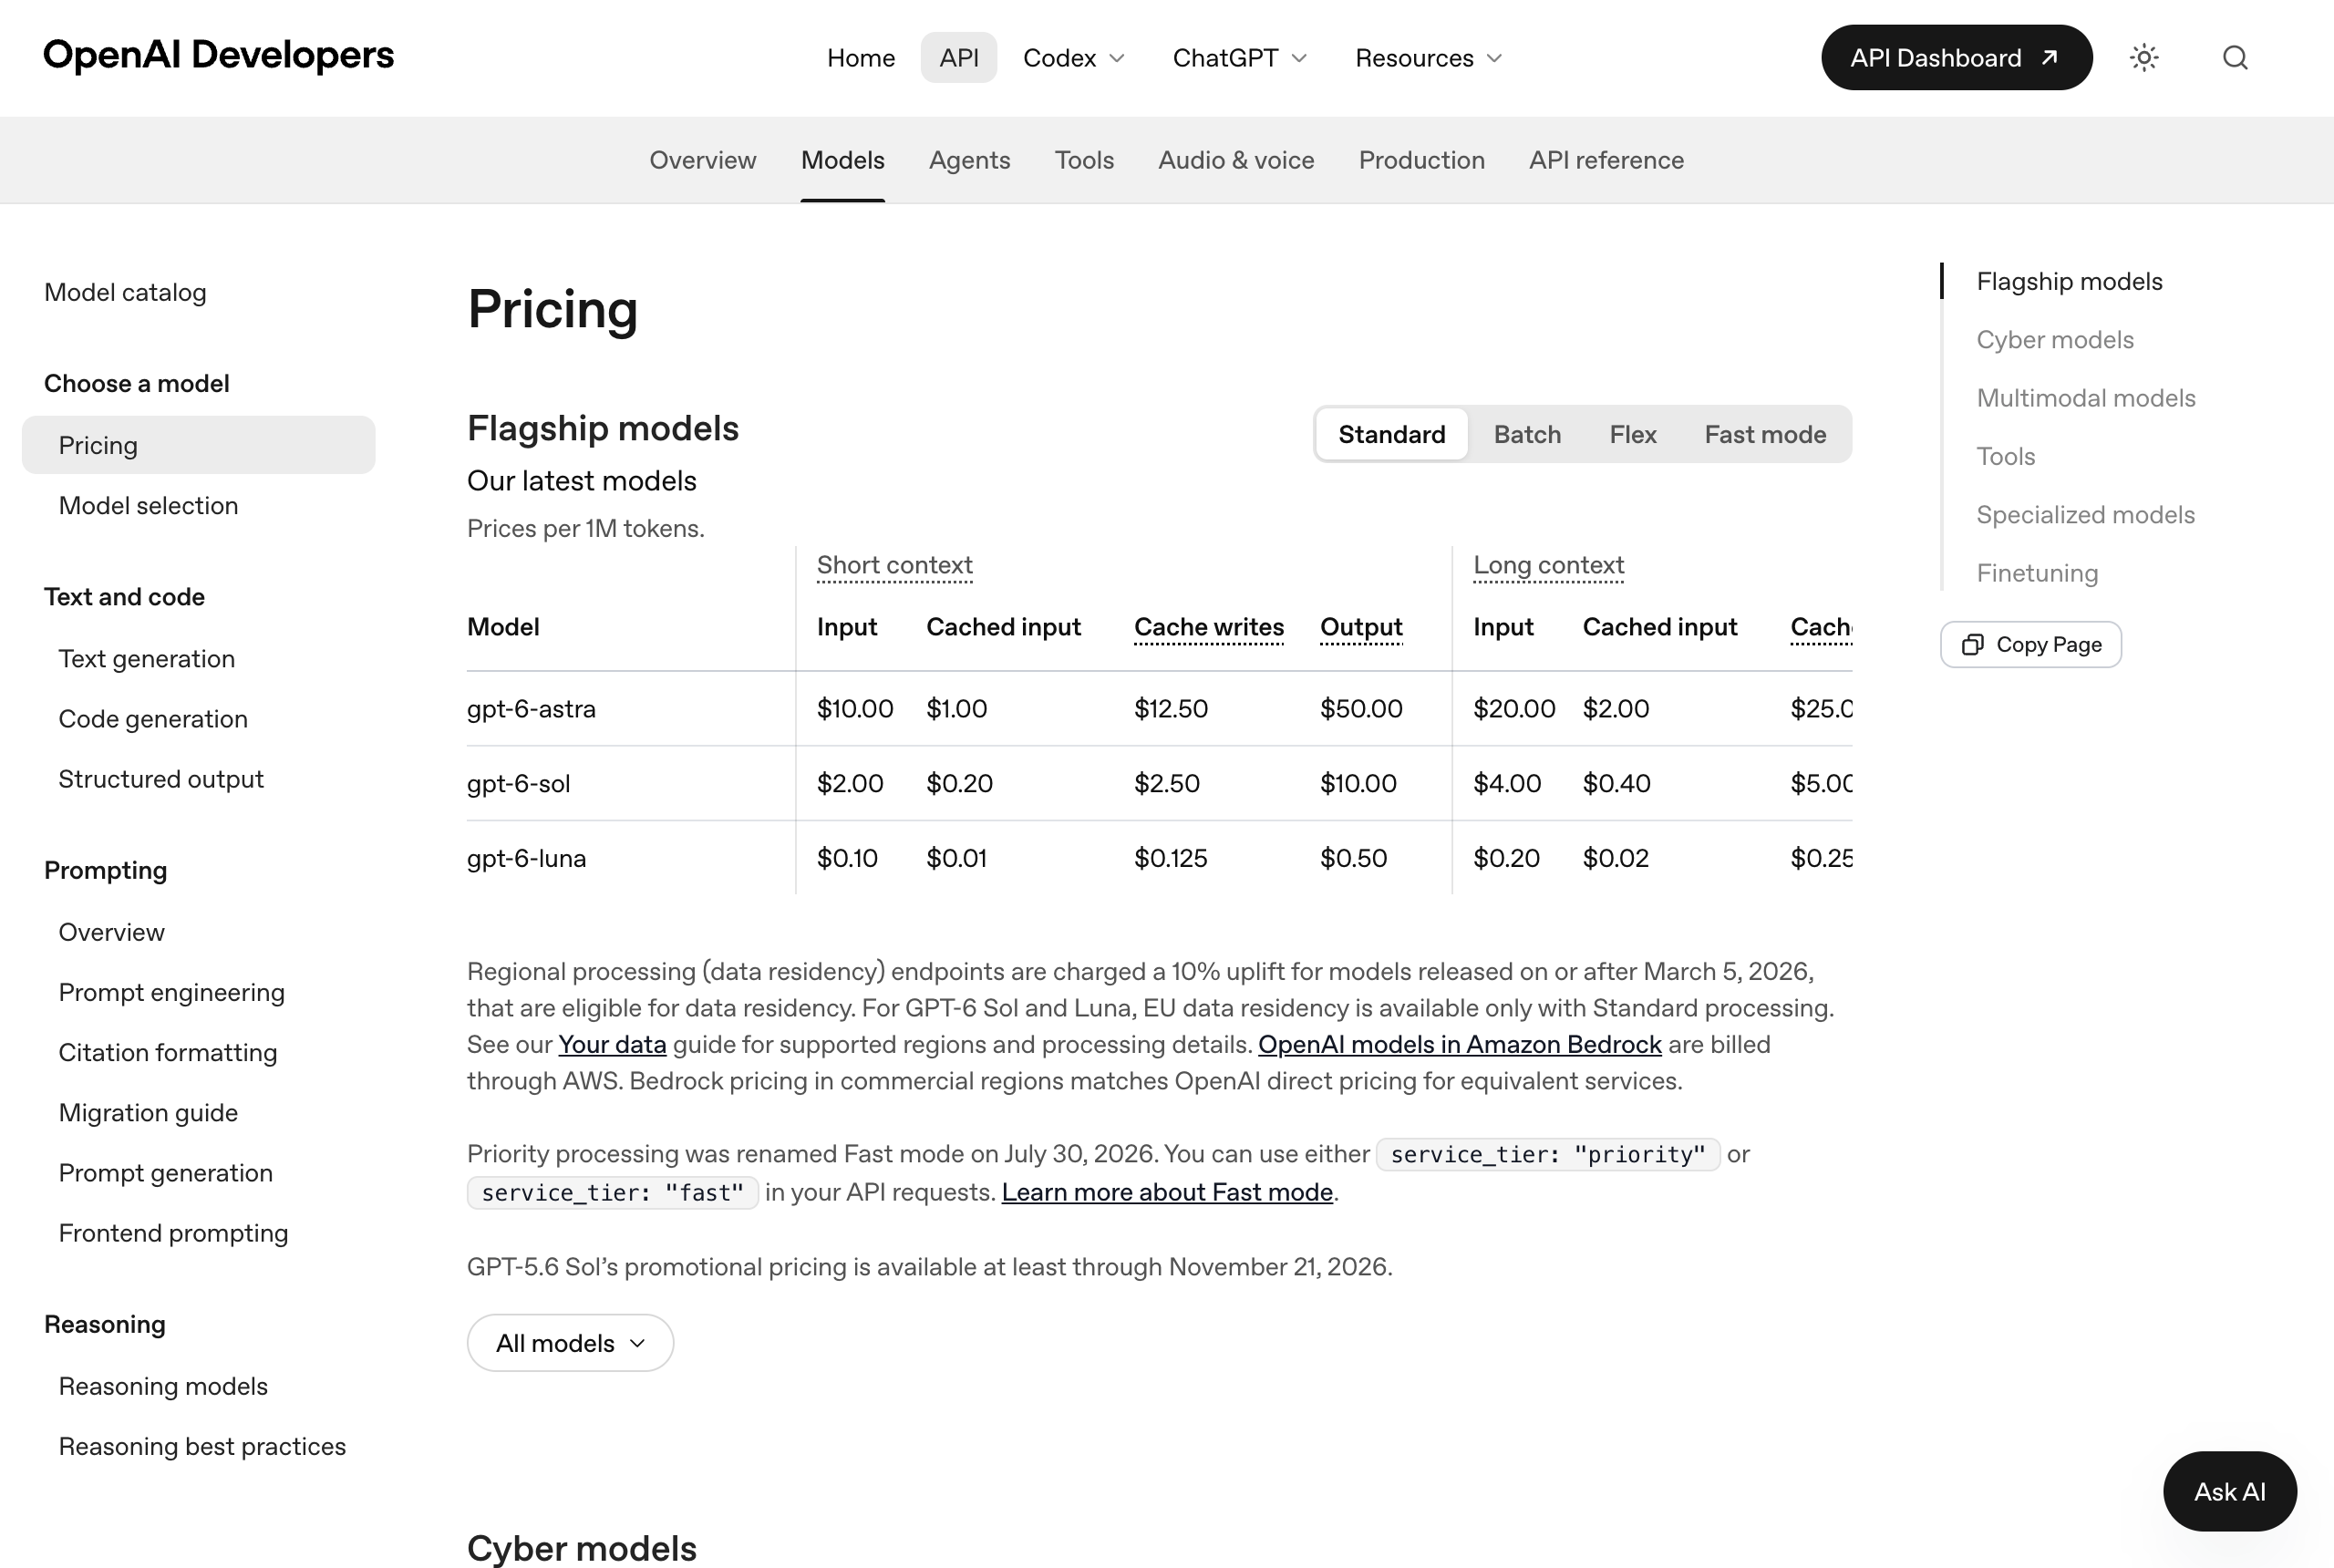
验证成功的标志:响应里返回了正常的 content 内容,且 Usage 字段能标注本次消耗的 token 数。把 Usage 里的数字对照第 2 步的价格算一遍,确认计费档位正确。
第 4 步:配置 prompt caching 省钱
9 月 22 日同步更新的缓存能力是本次接入最值得做的优化,缓存输入读取享受 90% 折扣。三个实操要点:
- 保持请求前缀稳定:把固定的系统提示词、工具定义放在 prompt 开头,动态内容放后面,命中率会自然提高,默认策略已比之前更激进
- 需要精确控制时使用显式缓存前缀断点:自己指定缓存到哪里为止,适合多租户或多人设的复杂应用
- 放心动态调参:调整 reasoning effort、按需开关工具,都不会破坏已有缓存,Agent 场景可以大胆按任务难度切换档位
官方给的效果参考:GitHub 的数据显示,这些改进让数月来需要新鲜处理的 prompt token 占比下降了超过 50%。对长对话和 Agent 重放场景,等于输入成本再砍一半以上。
第 5 步:验证与监控
两个官方工具把成本管起来:
- Prompt Caching Dashboard:看缓存命中量随时间的变化,判断优化是否生效
- 官方缓存诊断工具:解释哪些请求本可以命中缓存却没有命中、怎么修
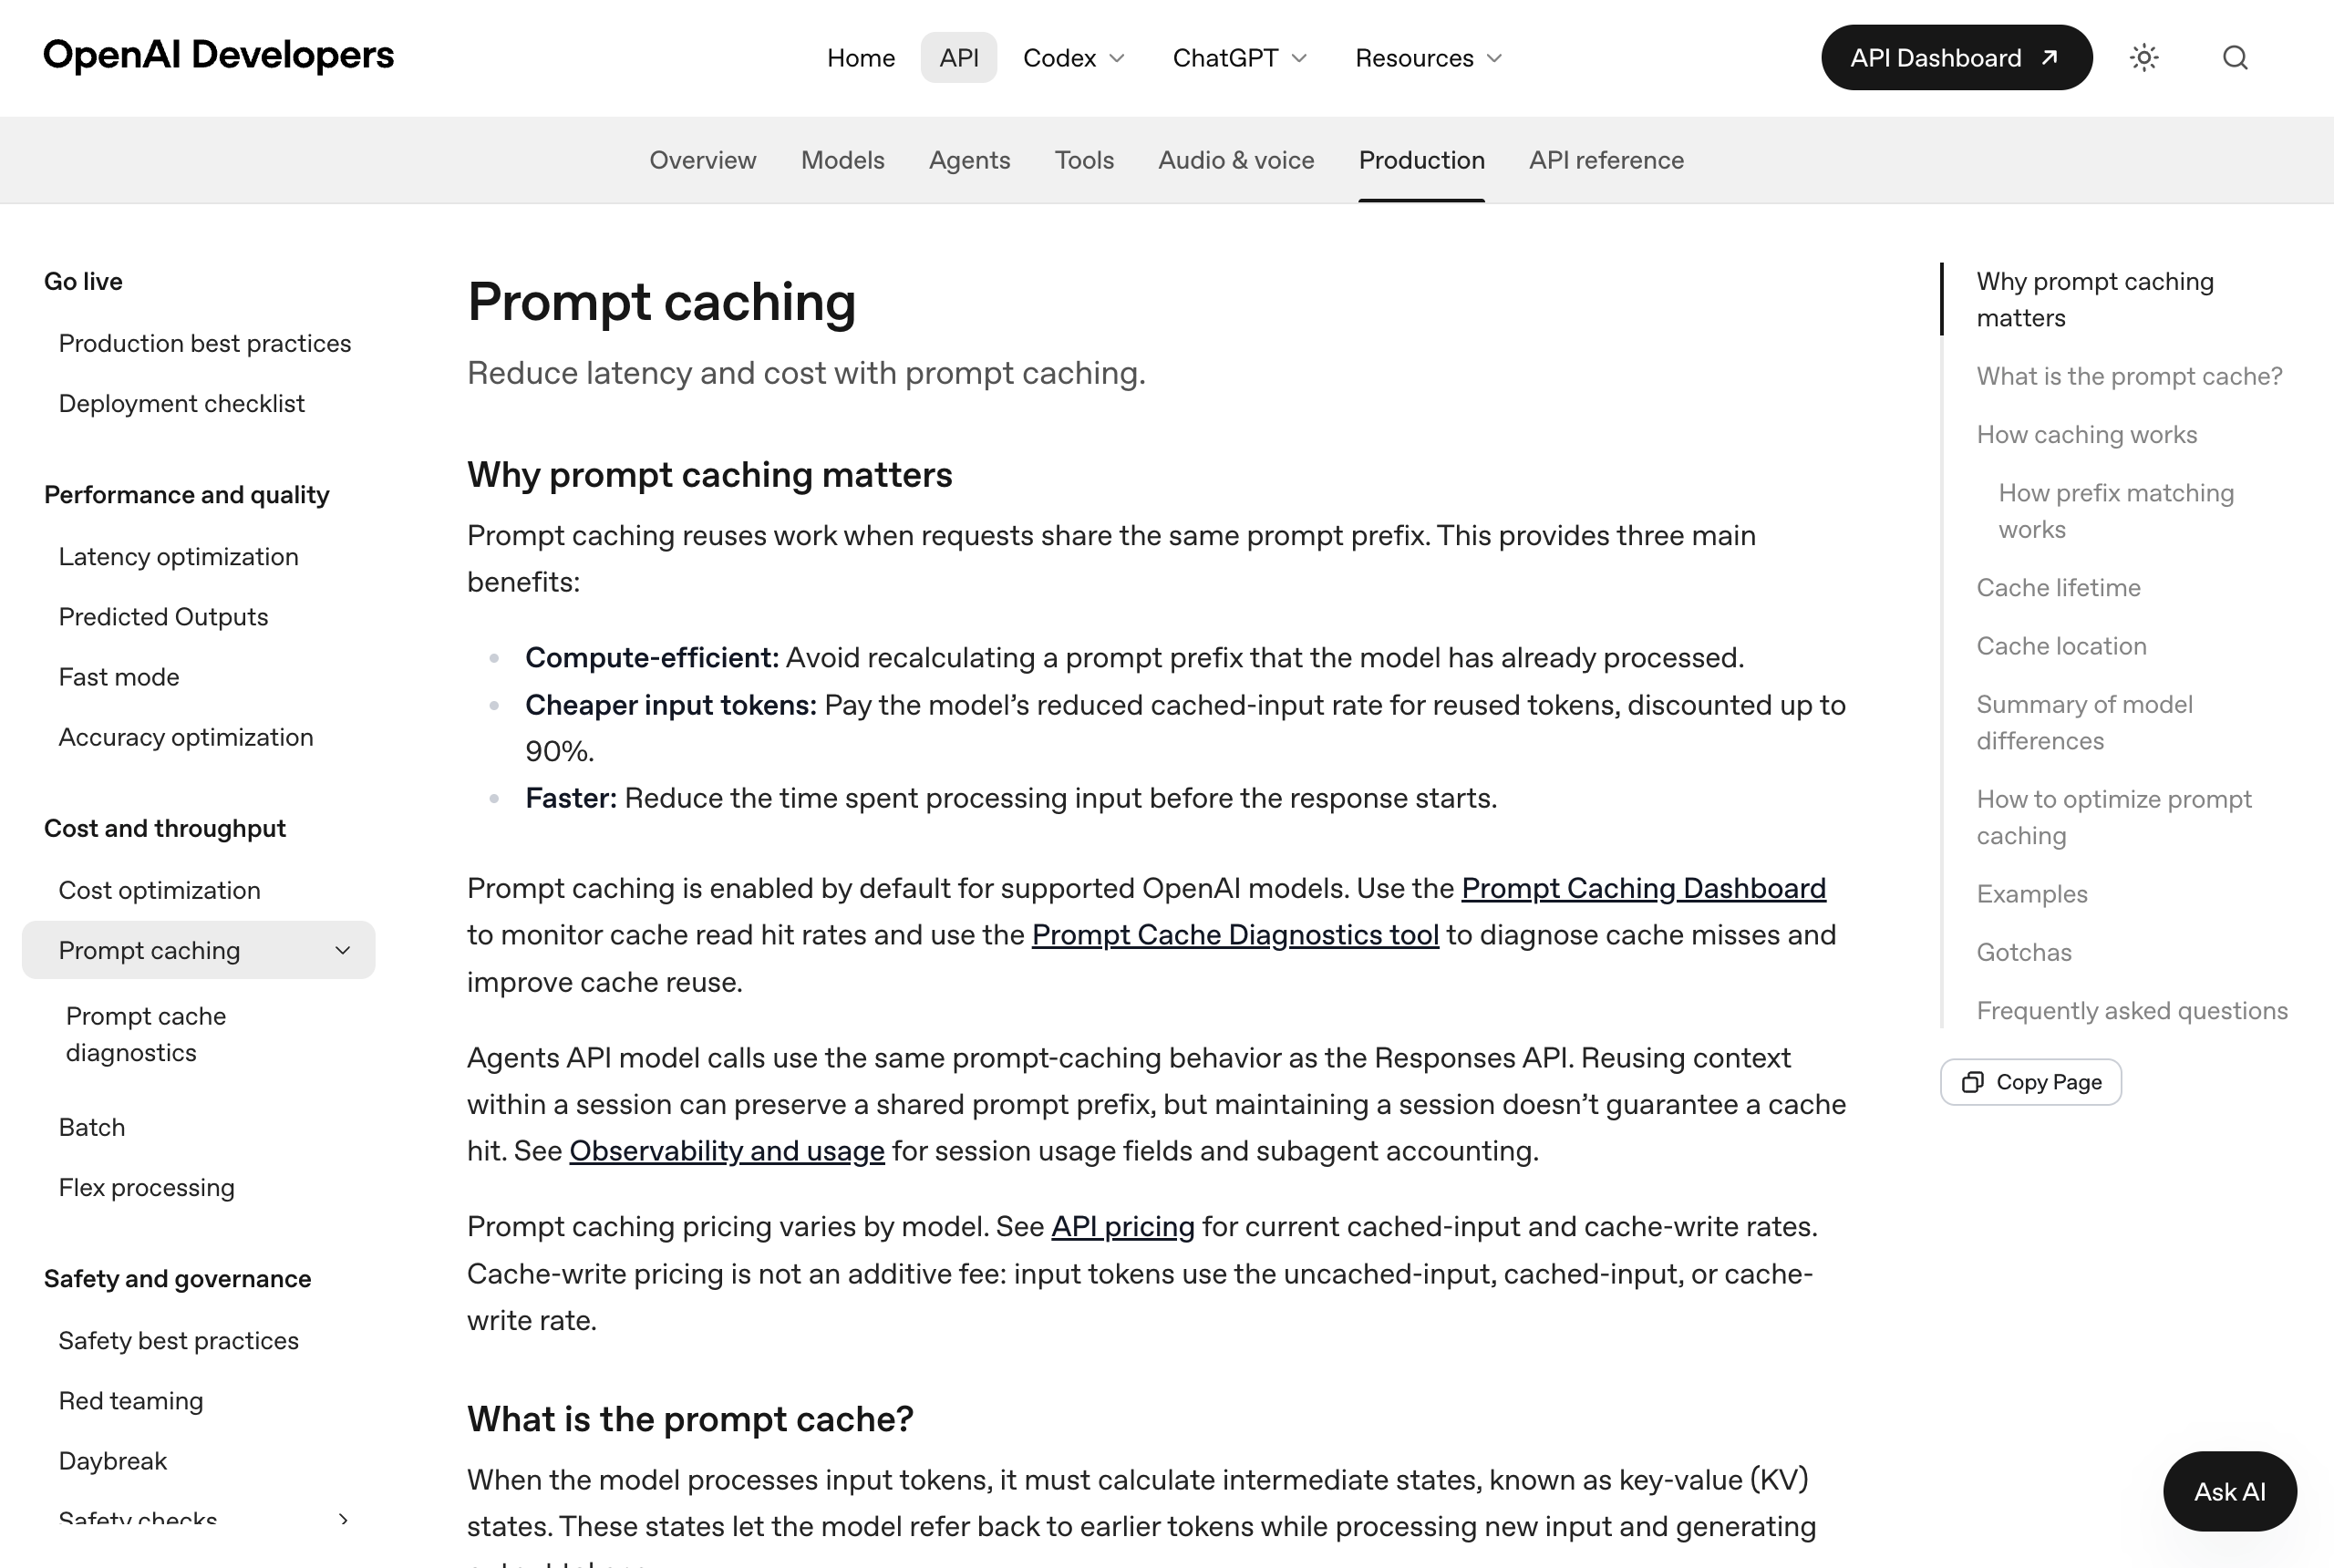
上线后建议每周看一次账单单价和缓存命中率,出现异常波动先检查模型 ID 和前缀是否被改动。想压成本的完整思路,可以配合 GPT-6 API 价格那篇一起看。
给一个量级感受:假设客服机器人每天处理 1000 次请求,平均每次输入 2000 token、输出 300 token,用 Luna 每天输入约 $0.2、输出约 $0.15,一个月不到 11 美元;同样的量换到 Sol,输入每天 $4、输出每天 $3,一个月 210 美元。轻量对话场景选 Luna、重任务选 Sol 的成本差就是这么大。
常见报错速查
| 错误现象 | 常见原因 | 解法 |
|---|---|---|
| 401 Unauthorized | Key 无效或没传入 | 重新生成 Key,确认 Authorization 头格式 |
| 429 Rate limit | 触发限流或余额不足 | 检查 Billing 余额,降低并发或稍后重试 |
| Model not found | 模型 ID 拼写错误 | 用 /v1/models 列表确认准确 ID |
| 缓存命中率低 | 请求前缀每次都在变 | 固定系统提示词到开头,或设置显式前缀断点 |
| 账单高于预期 | effort 档位过高或输出过长 | 调低 effort,控制 max tokens |
上线前的检查清单
切流量之前,把这五项过一遍:
- 模型 ID 是从 /v1/models 列表确认过的,不是凭记忆写的
- OPENAI_API_KEY 存在环境变量里,代码和日志里搜不到明文 Key
- 用一条真实请求核对过 Usage 字段和计费单价,确认落在 Sol 或 Luna 的档位上
- prompt 前缀固定且稳定,缓存命中率在 Dashboard 里能看到明显数字
- 配置了 429 重试和余额告警,避免线上静默失败
常见问题
GPT-6 Sol 和 Luna 的模型 ID 到底怎么写?
答:以 /v1/models 接口返回的列表为准,一般形如 gpt-6-sol 和 gpt-6-luna。不要凭记忆硬写,模型 ID 拼错会直接报 Model not found。
从 GPT-5.6 迁移要改代码吗?
答:接口结构不变,通常只改 model 参数。建议同时重校 effort 档位,因为 GPT-6 的合理档位可能和前代不同。
prompt caching 需要额外付费或申请吗?
答:不需要。默认策略自动生效,缓存命中的输入读取直接按 90% 折扣计费,显式前缀断点是可选的进阶控制。
国内开发者能直接调用 GPT-6 API 吗?
答:OpenAI 服务不对中国大陆地区提供服务,可用性以官方支持地区列表为准。请通过合规方式接入,本站不提供也不建议违规途径。
 京ICP备2024094994号-29