
GPT-6 Sol 和 Astra 哪个好:跑分对比与选型
先给结论:要全场最好的结果、预算不敏感,选 GPT-6 Astra;跑业务工作流、高频编程和高并发任务,选 GPT-6 Sol,官方数据显示它在 AutomationBench 上以 33.2% 得分反超 Astra low 档的 30.3%,每任务成本只有 Astra 的约四分之一。下面用官方数据逐项拆开讲。
数据来源统一说明:本文全部跑分与成本倍数取自 OpenAI 2026 年 9 月 22 日的官方发布公告,涉及 Astra 的对比基准为其 9 月 3 日发布时及本次公告披露的数据。
一张总表看懂 Sol 和 Astra 的区别
| 维度 | GPT-6 Astra | GPT-6 Sol |
|---|---|---|
| 定位 | 全场景最强旗舰 | 高性价比主力档 |
| 发布时间 | 2026 年 9 月 3 日 | 2026 年 9 月 22 日 |
| 训练方式 | GPT-6 一代方法 | 与 Astra 相似的方法 |
| AutomationBench 1.0.6 | 30.3%(low),每任务成本为 Sol 的 3.9 倍 | 33.2%(xhigh),$0.27/任务 |
| Agents' Last Exam V1 | 公告未单列本次分数 | 56.4%(max),高于 Opus 5 最高分 |
| DeepSWE 1.1 | 公告未单列本次分数 | 68.8%(max) |
| OSWorld 2.0 offline | 全场最佳计算机使用模型 | 60.5%(xhigh) |
| 事实性 | 系列基准水平 | 错误率约为 GPT-5.6 Sol 一半,接近 Astra |
| 对齐 | 系列最强对齐 | 继承 Astra 对齐改进 |
| 适合人群 | 深度研究、最难的专业任务 | 日常业务、高频 Agent、团队规模化 |
注意表格里的空缺不是漏写:本次公告没有单列 Astra 在 DeepSWE 等基准上的具体分数,这里不替官方编数字。
跑分对比一:业务工作流(AutomationBench)
AutomationBench 1.0.6 用 Zapier 的 47 个工具测试端到端业务工作流,覆盖销售、营销、运营、客服、财务和人力,是最贴近真实办公场景的基准。官方给出的对比:
| 模型(档位) | 得分 | 每任务成本 |
|---|---|---|
| GPT-6 Sol(xhigh) | 33.2% | $0.27 |
| Claude Fable 5.1 w/ Opus 5 Fallback(max) | 31.4% | 大于 Sol 的 8.9 倍(fallback 未计入) |
| GPT-6 Astra(low) | 30.3% | 3.9 倍 |
| Claude Opus 5(max) | 26.9% | 11.1 倍 |
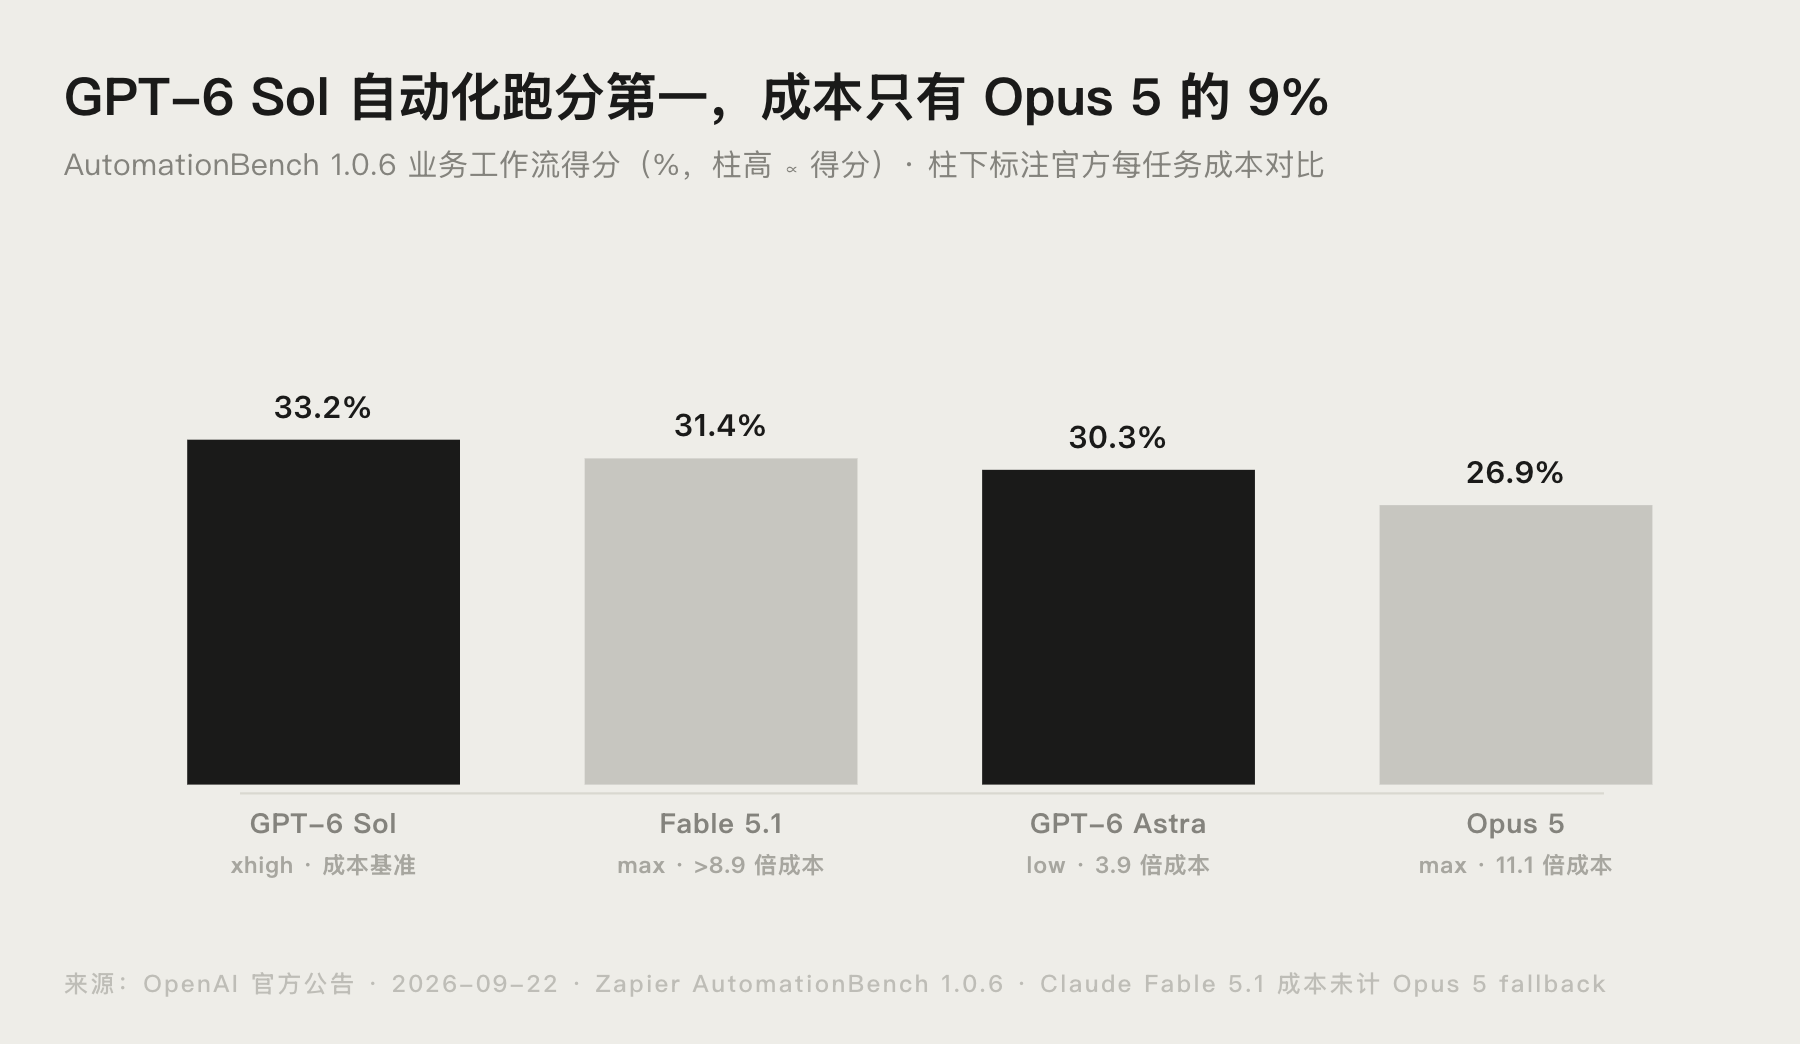
这一组数据里最反直觉的是:Astra 即使只开 low effort,得分仍低于 Sol 开 xhigh,成本却是 3.9 倍。也就是说在业务工作流这个具体场景里,旗舰的低价档并不划算,专用中档模型的性价比明显更高。
诚实起见补一句官方标注:Fable 5.1 那行的成本不含约 40% 任务触发的 Opus 5 fallback 费用,它的真实成本比表里更高。
为什么 Sol 能用更少的钱做到这一步
官方把原因讲得很清楚:一是训练方式,Sol 和 Luna 用与 Astra 相似的方法训练,等于把旗舰的能力压缩进更小的体积;二是基础设施,缓存和推理效率的改进让服务成本下降,OpenAI 把省下的钱直接变成了降价。所以 Sol 的便宜不是阉割出来的低价,而是同一代技术在不同成本档位上的复用。
怎么组合用:三个档位混合调度
对 Agent 应用来说,三档位并存才是最优解,而不是二选一:
- 关键决策节点(策略规划、复杂推理、计算机使用操作)路由给 Astra
- 中间的工作步骤(工具调用、信息整理、代码修改)路由给 Sol
- 海量的轻量步骤(分类、抽取、格式化、简单回复)路由给 Luna
这种按步骤分档的路由方式,配合缓存输入 90% 折扣,整体成本可以比单用 Astra 低一个数量级,而关键步骤的质量不受影响。
跑分对比二:编程(DeepSWE 与 FrontierCode)
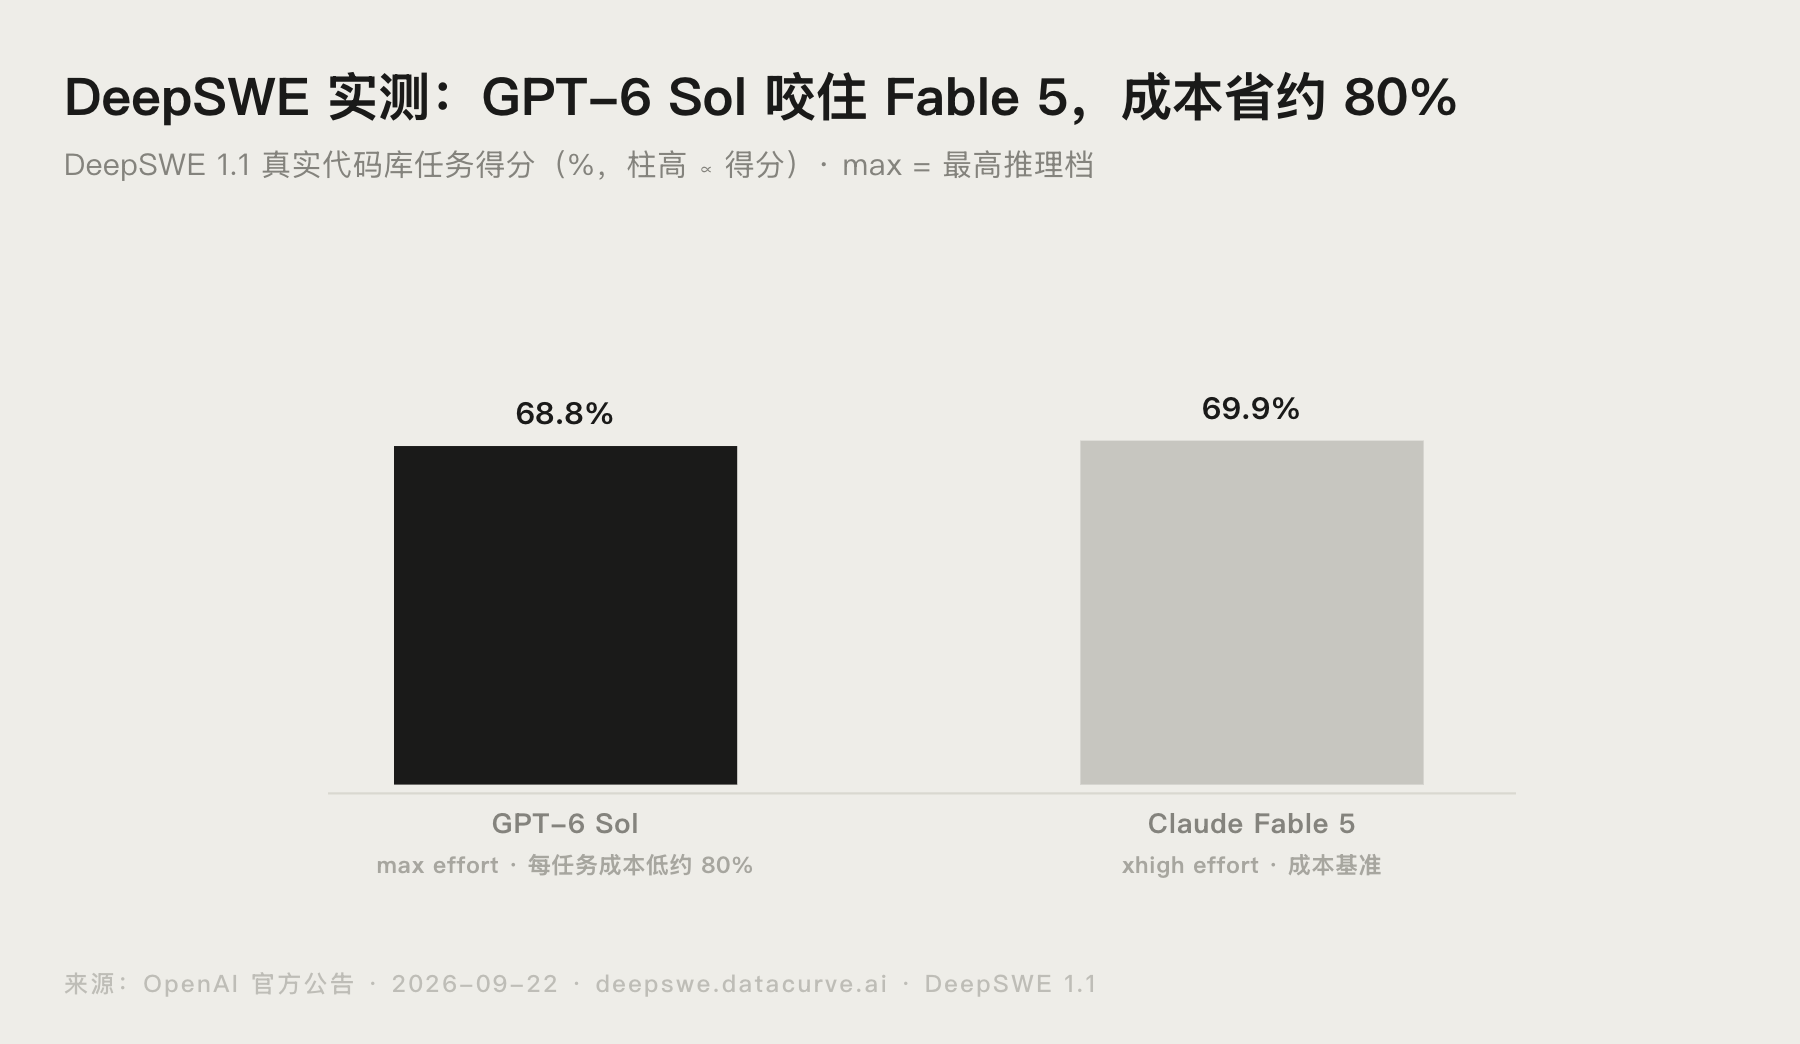
DeepSWE 1.1 测试真实代码库里的复杂软件工程任务。GPT-6 Sol 在 max effort 下得分 68.8%,只比 Claude Fable 5 最高分(xhigh 档 69.9%)低 1.1 个百分点,每任务成本低约 80%。
FrontierCode 1.1(Cognition 出品,考察代码能否直接合并进真实代码库)上,GPT-6 Sol 水平匹配 Fable 5.1 xhigh,成本更低。
这两个基准Astra 没有出现在本次对比表中,官方的表述是 Sol/Luna 把 Astra 的编程能力带进了更便宜的档位。对开发者来说,可直接执行的结论是:除非你的任务明确需要 Astra 级别的推理深度,编程场景 Sol 是当前性价比最优的 GPT-6 档位。
跑分对比三:计算机使用与事实性
计算机使用是 Astra 保留最牢固的阵地。官方明确 GPT-6 Astra 仍然是世界最佳的计算机使用模型;OSWorld 2.0 offline 上,Sol xhigh 拿到 60.5%,与 Opus 5 medium 的 60.3% 相当,成本低约 80%。
事实性方面两者差距已经很小:Sol 的事实错误率约为 GPT-5.6 Sol 的一半,接近 Astra 水平。对客服、内容生成这类容错率敏感的场景,Sol 基本够用。
场景化推荐:如果你是这几类人
- 深度研究、战略分析、最难的单一任务:选 Astra。它是全场景最强,用最好的模型做最重要的决策,单位智力成本最低。旗舰档内部还有 Pro 和标准版之分,不确定的话先看 GPT-6 Astra Pro 与 Astra 的区别
- 业务自动化、高频 Agent 工作流:选 Sol。$0.27 每任务的成本让以前不敢跑量的流程敢跑了
- 海量轻量任务(分类、抽取、摘要、简单对话):直接看 Luna,输入 $0.10 每百万 token,比 Sol 又低一个量级
- ChatGPT 订阅用户:两个模型的区别体现在套餐档位和额度上,选套餐前建议看 GPT-6 Astra 每周额度与省额度技巧
- 还在纠结订阅本身值不值:看这篇 ChatGPT Plus 值得买吗的无广实测
从 Astra 换到 Sol 要注意什么
迁移成本不高,但有四个实际动作:
- 换模型 ID:API 里把 model 参数换成 Sol 对应的模型标识,其余接口结构不变
- 重校 effort:Astra 上的 low 档到了 Sol 上建议直接试 xhigh,官方对比口径显示这才是 Sol 的合理档位
- 保留缓存配置:prompt caching 的前缀组织可以原样沿用,缓存命中继续享受 90% 折扣
- 用数据验证:切流量前先跑 5% 的灰度,用 Prompt Caching Dashboard 观察成本和命中率变化
反过来,如果你已经在用 GPT-5.6 Sol,升级到 GPT-6 Sol 几乎是零成本的,价格还便宜一半,这类用户没有理由不换。旗舰与中档的能力边界讨论也可以延伸到上一代,见 GPT-5.6 Sol 是什么的解读。
常见问题
GPT-6 Sol 能完全替代 Astra 吗?
答:不能。官方明确 Astra 仍是全场景最强模型,尤其是计算机使用(OSWorld)和需要最深推理的任务。Sol 是性价比档位,不是平替。
Sol xhigh 和 Astra low 哪个划算?
答:AutomationBench 上 Sol xhigh 得分 33.2% 高于 Astra low 的 30.3%,成本只有约四分之一。在业务工作流场景,Sol xhigh 明显更划算。
Astra 和 Sol 的 API 价格差多少?
答:GPT-6 Sol 是每百万 token 输入 $2、输出 $10。本次公告未列出 Astra 具体单价,准确价格以 platform.openai.com 定价页为准。
两个模型在安全性上有差别吗?
答:Sol 和 Luna 继承了 Astra 的对齐改进,官方对齐评测显示两者都优于 GPT-5.6 对应型号,编程工作中的误导性陈述率有所下降。Astra 仍是对齐最强的型号。
我应该现在就从 Astra 迁移到 Sol 吗?
答:分情况。任务以业务工作流和编程为主的,建议切 5% 灰度实测成本和得分后再放量;依赖计算机使用和最深推理的保留 Astra。两者并存调度是当前官方数据支持的最优解。
 京ICP备2024094994号-29