
GPT-5.6 Sol 是什么?在 MIT 独立跑量子实验的模型
GPT-5.6 Sol 是 OpenAI 2026 年 9 月 8 日官方案例里被重点展示的模型:接入编码代理 Codex 后,它替 MIT 工程量子系统组(EQuS)自主完成了六比特超导量子芯片的常规校准测量,研究员可以整夜不盯。它回答的不是「AI 能不能做科研」,而是更实际的问题:AI 代理能接管科研流程里的哪一段脏活,边界又在哪里。
案例里到底发生了什么
主角之一是 MIT 工程量子系统组(EQuS)的研究生 Beatriz Yankelevich。她的实验室研究超导量子比特:芯片被冷却到接近绝对零度的稀释制冷机里,用微波脉冲操控。芯片造好之后,所有实验都通过软件进行,这正好是 AI 代理的天然试验场。
官方在案例开头补了一个容易被忽略的背景数字:准备和运行一个量子比特实验可能耗费数月,期间要做几百到几千次预备测量。这也解释了为什么「让代理接管重复测量」这件事值得认真投入。
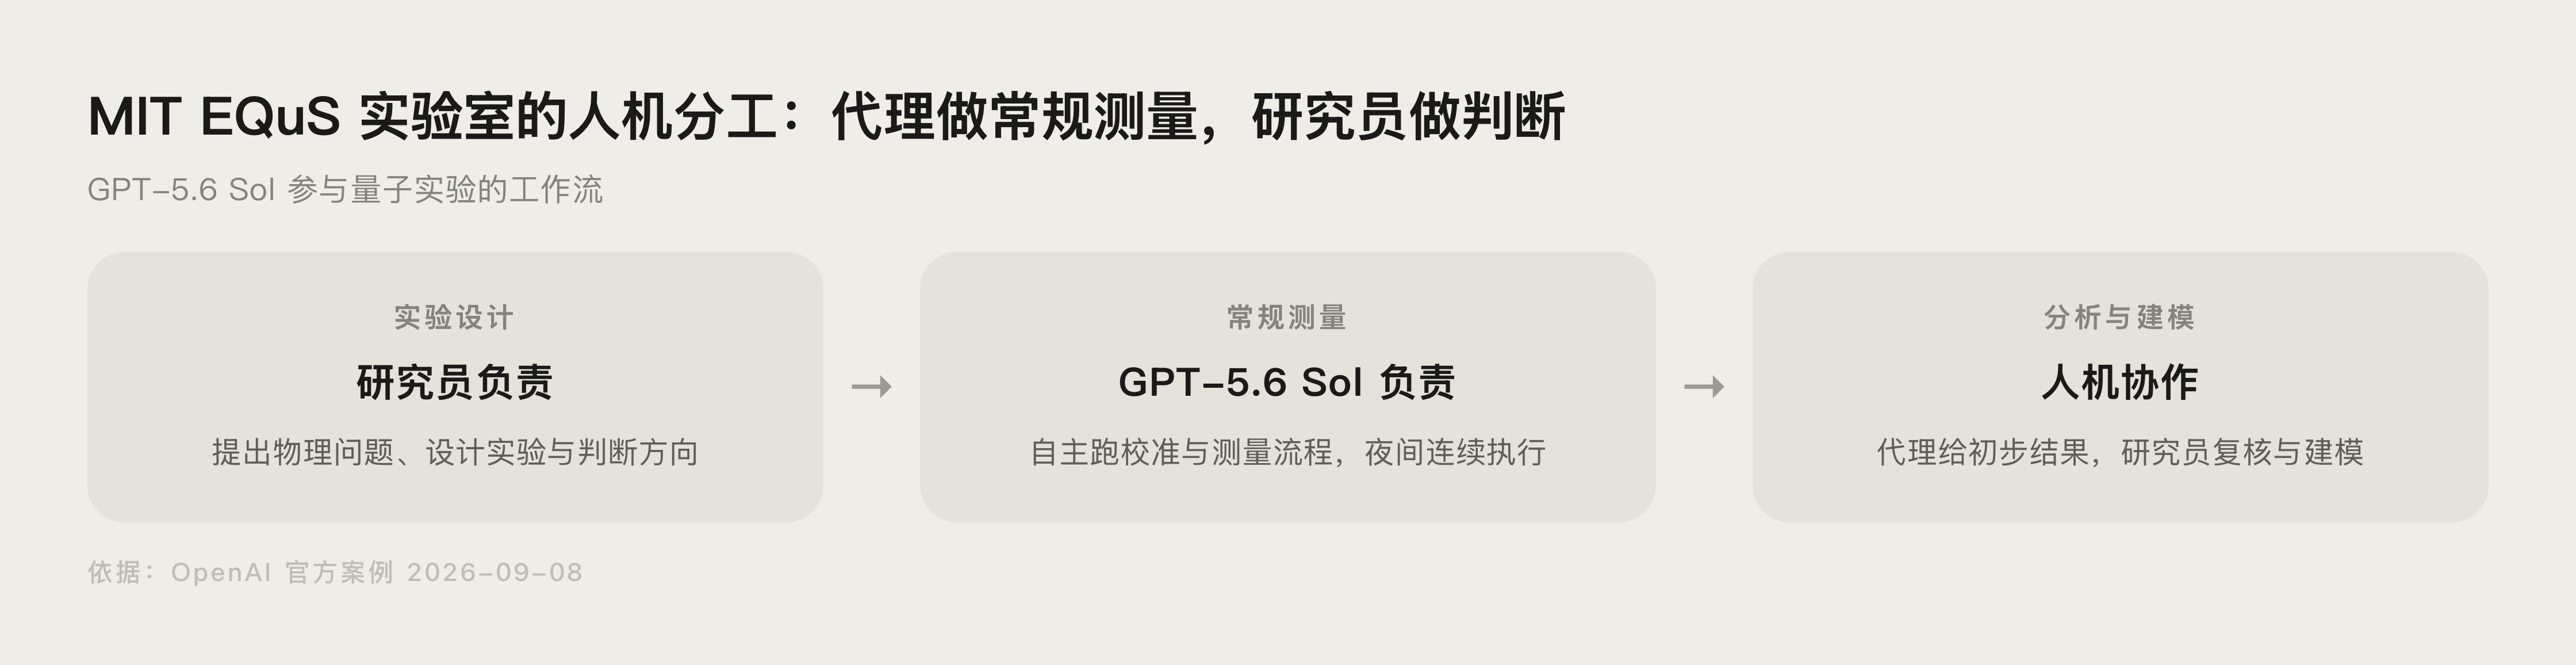
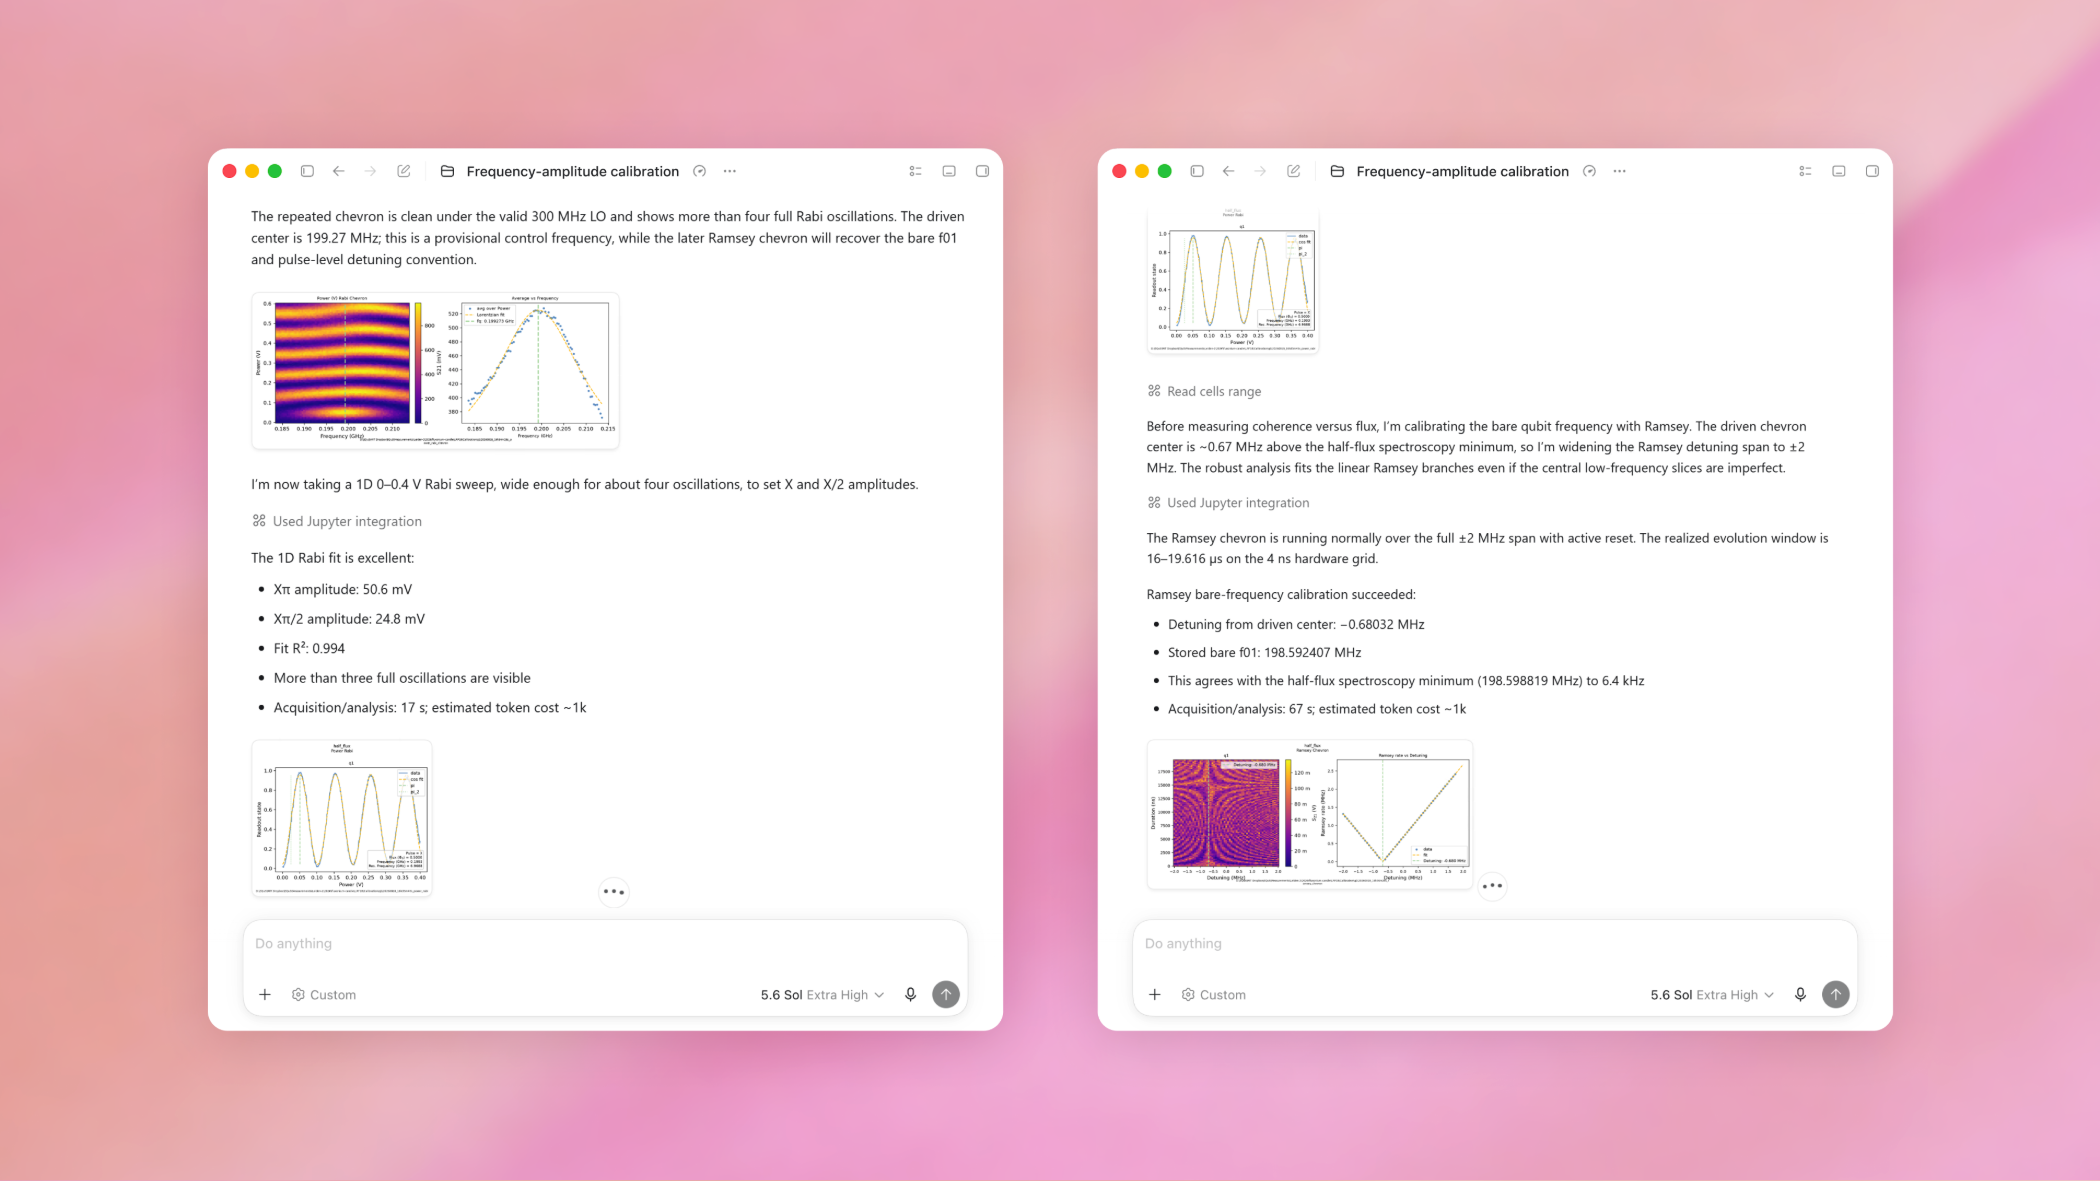
她给 Codex 配了测量专用的 skills(说明每种实验怎么跑、怎么评估),然后让 GPT-5.6 Sol 去校准一颗未校准的六比特芯片。结果是:
- 模型自己选测量参数、操作硬件、分析返回的数据。
- 信号清晰时,几乎不用人干预就完成了整套标准测量。
- 信号弱或有噪声时,它找参数变慢,有时需要有经验的研究员介入。
按官方描述,它的循环是:选参数、操作硬件、分析数据,然后判断是继续细化这一项测量,还是把结果存下来给下一项用。
它跑通的测量具体是哪几类
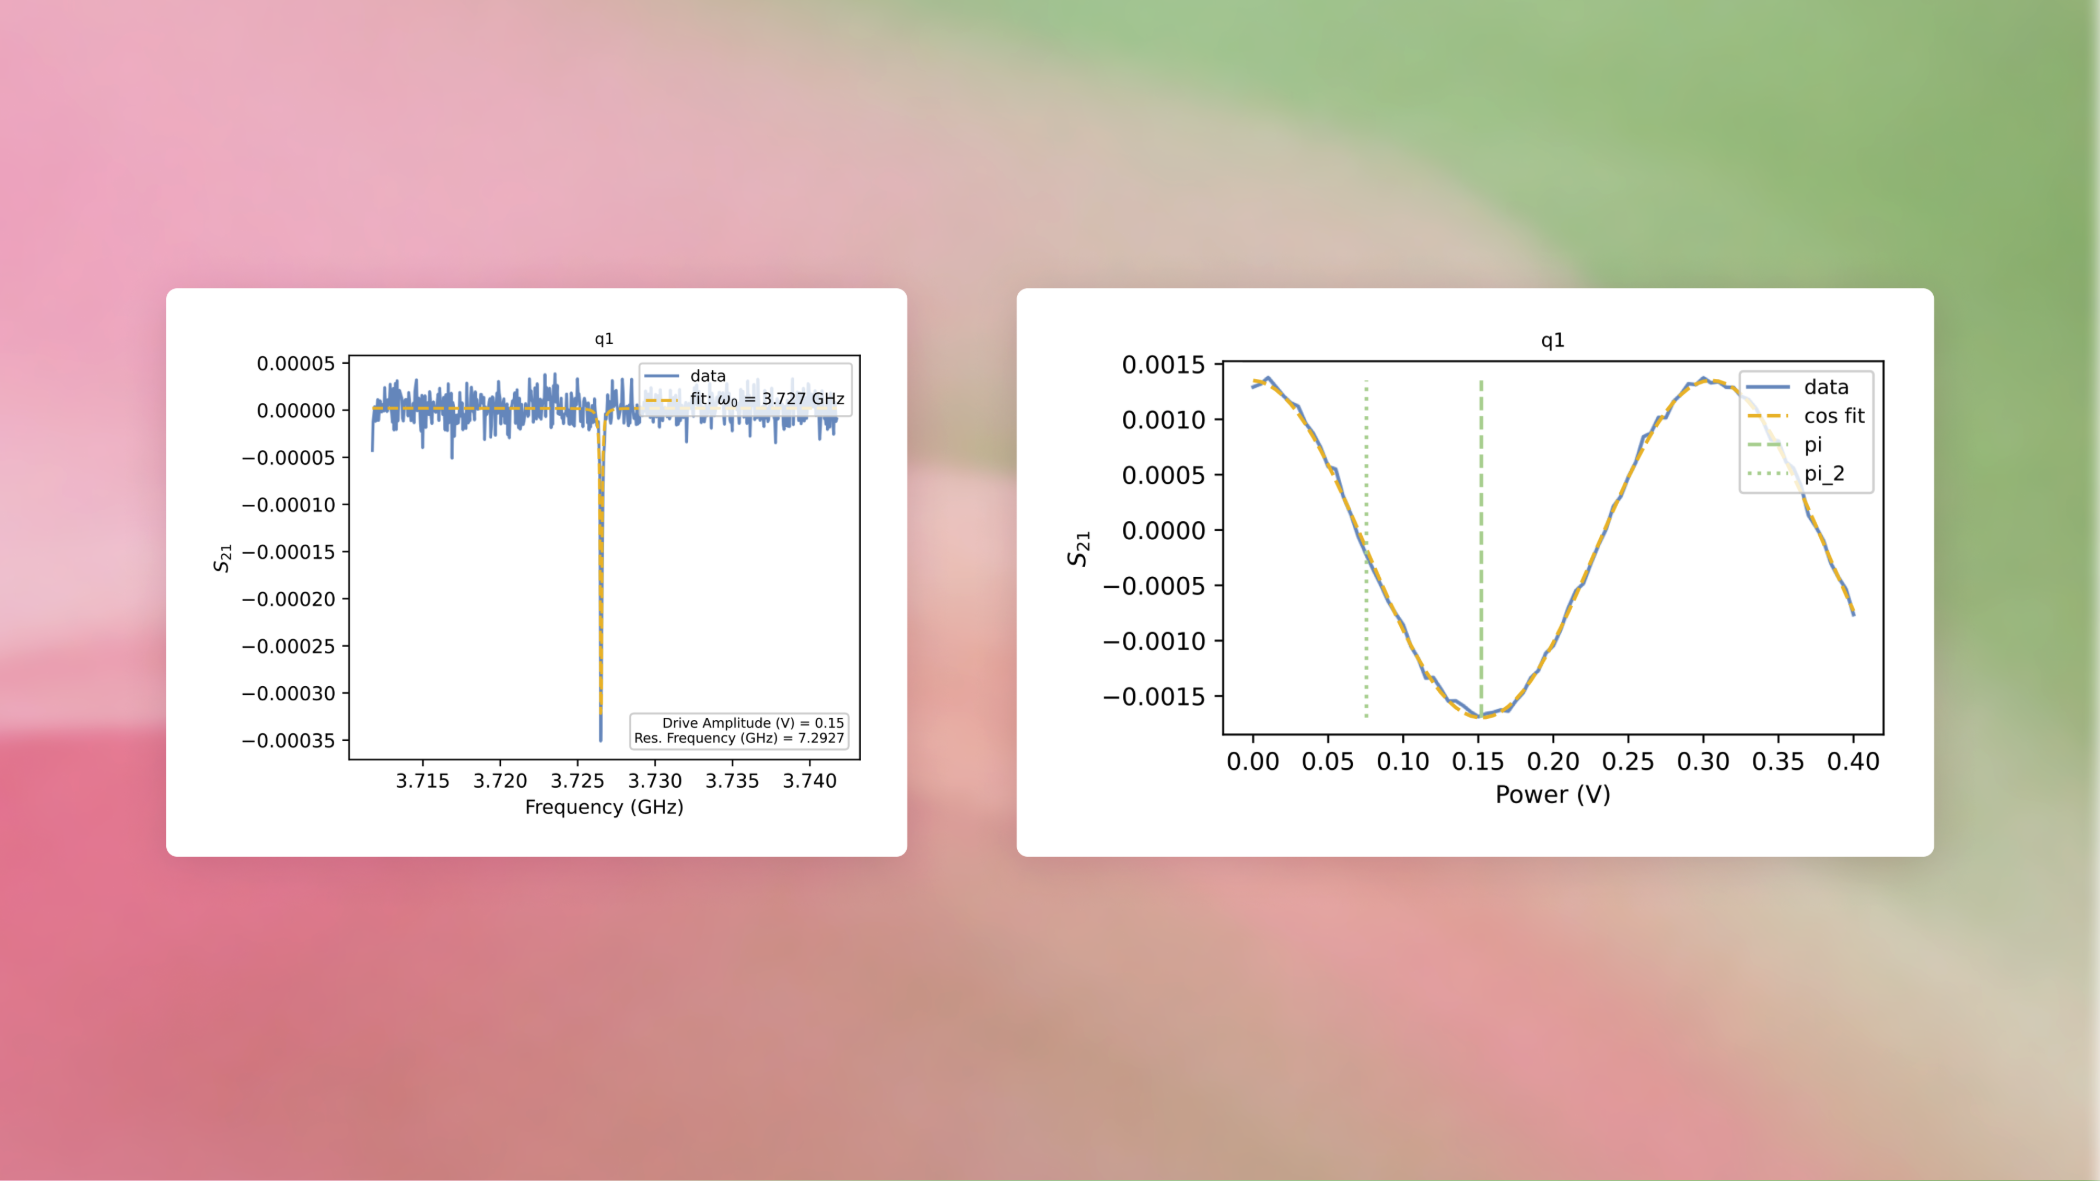
官方公布的三组校准图,对应三类互相依赖的标准测量,这也是整件事最容易被含糊转述的部分:
- 找跃迁频率:确定每个量子比特的谐振频率,这是后续一切精确控制的前提。
- 校准控制与读取脉冲:包括随驱动功率变化的 Rabi 振荡拟合,决定操控和读出的准确度。
- 测量子信息保持时长:包括弛豫与相干测量,回答「这个比特能把信息留住多久」。
三类测量是串联关系:前一步的结果决定下一步的参数,遇到量子比特属性漂移还要回头重测。官方把这种组合概括为「软件可控 + 反复测量 + 动态决策」,并明确点出这正是它适合 AI 代理的原因。
为什么这事有价值
一颗标准芯片的完整表征,过去要耗掉一位研究员好几天,其中大部分是重复性的校准测量。EQuS 现在已经常态化用代理跑这类测量。按 Yankelevich 的说法,代理可以整夜跑测量,她在洁净室工作时用手机就能查看进度、随时纠偏;她自己的时间转向了解读结果、设计实验和规划下一步。
这里的关键词是「边界清晰」。官方在案例结尾坦率写了局限:有经验的研究员仍然可能比当前模型更快找到最优校准设置,解读模糊的物理结果仍是难点。这不是「AI 取代科学家」的故事,而是「AI 接管流程明确的重复环节」的故事。
GPT-5.6 Sol 在 5.6 家族里是什么位置
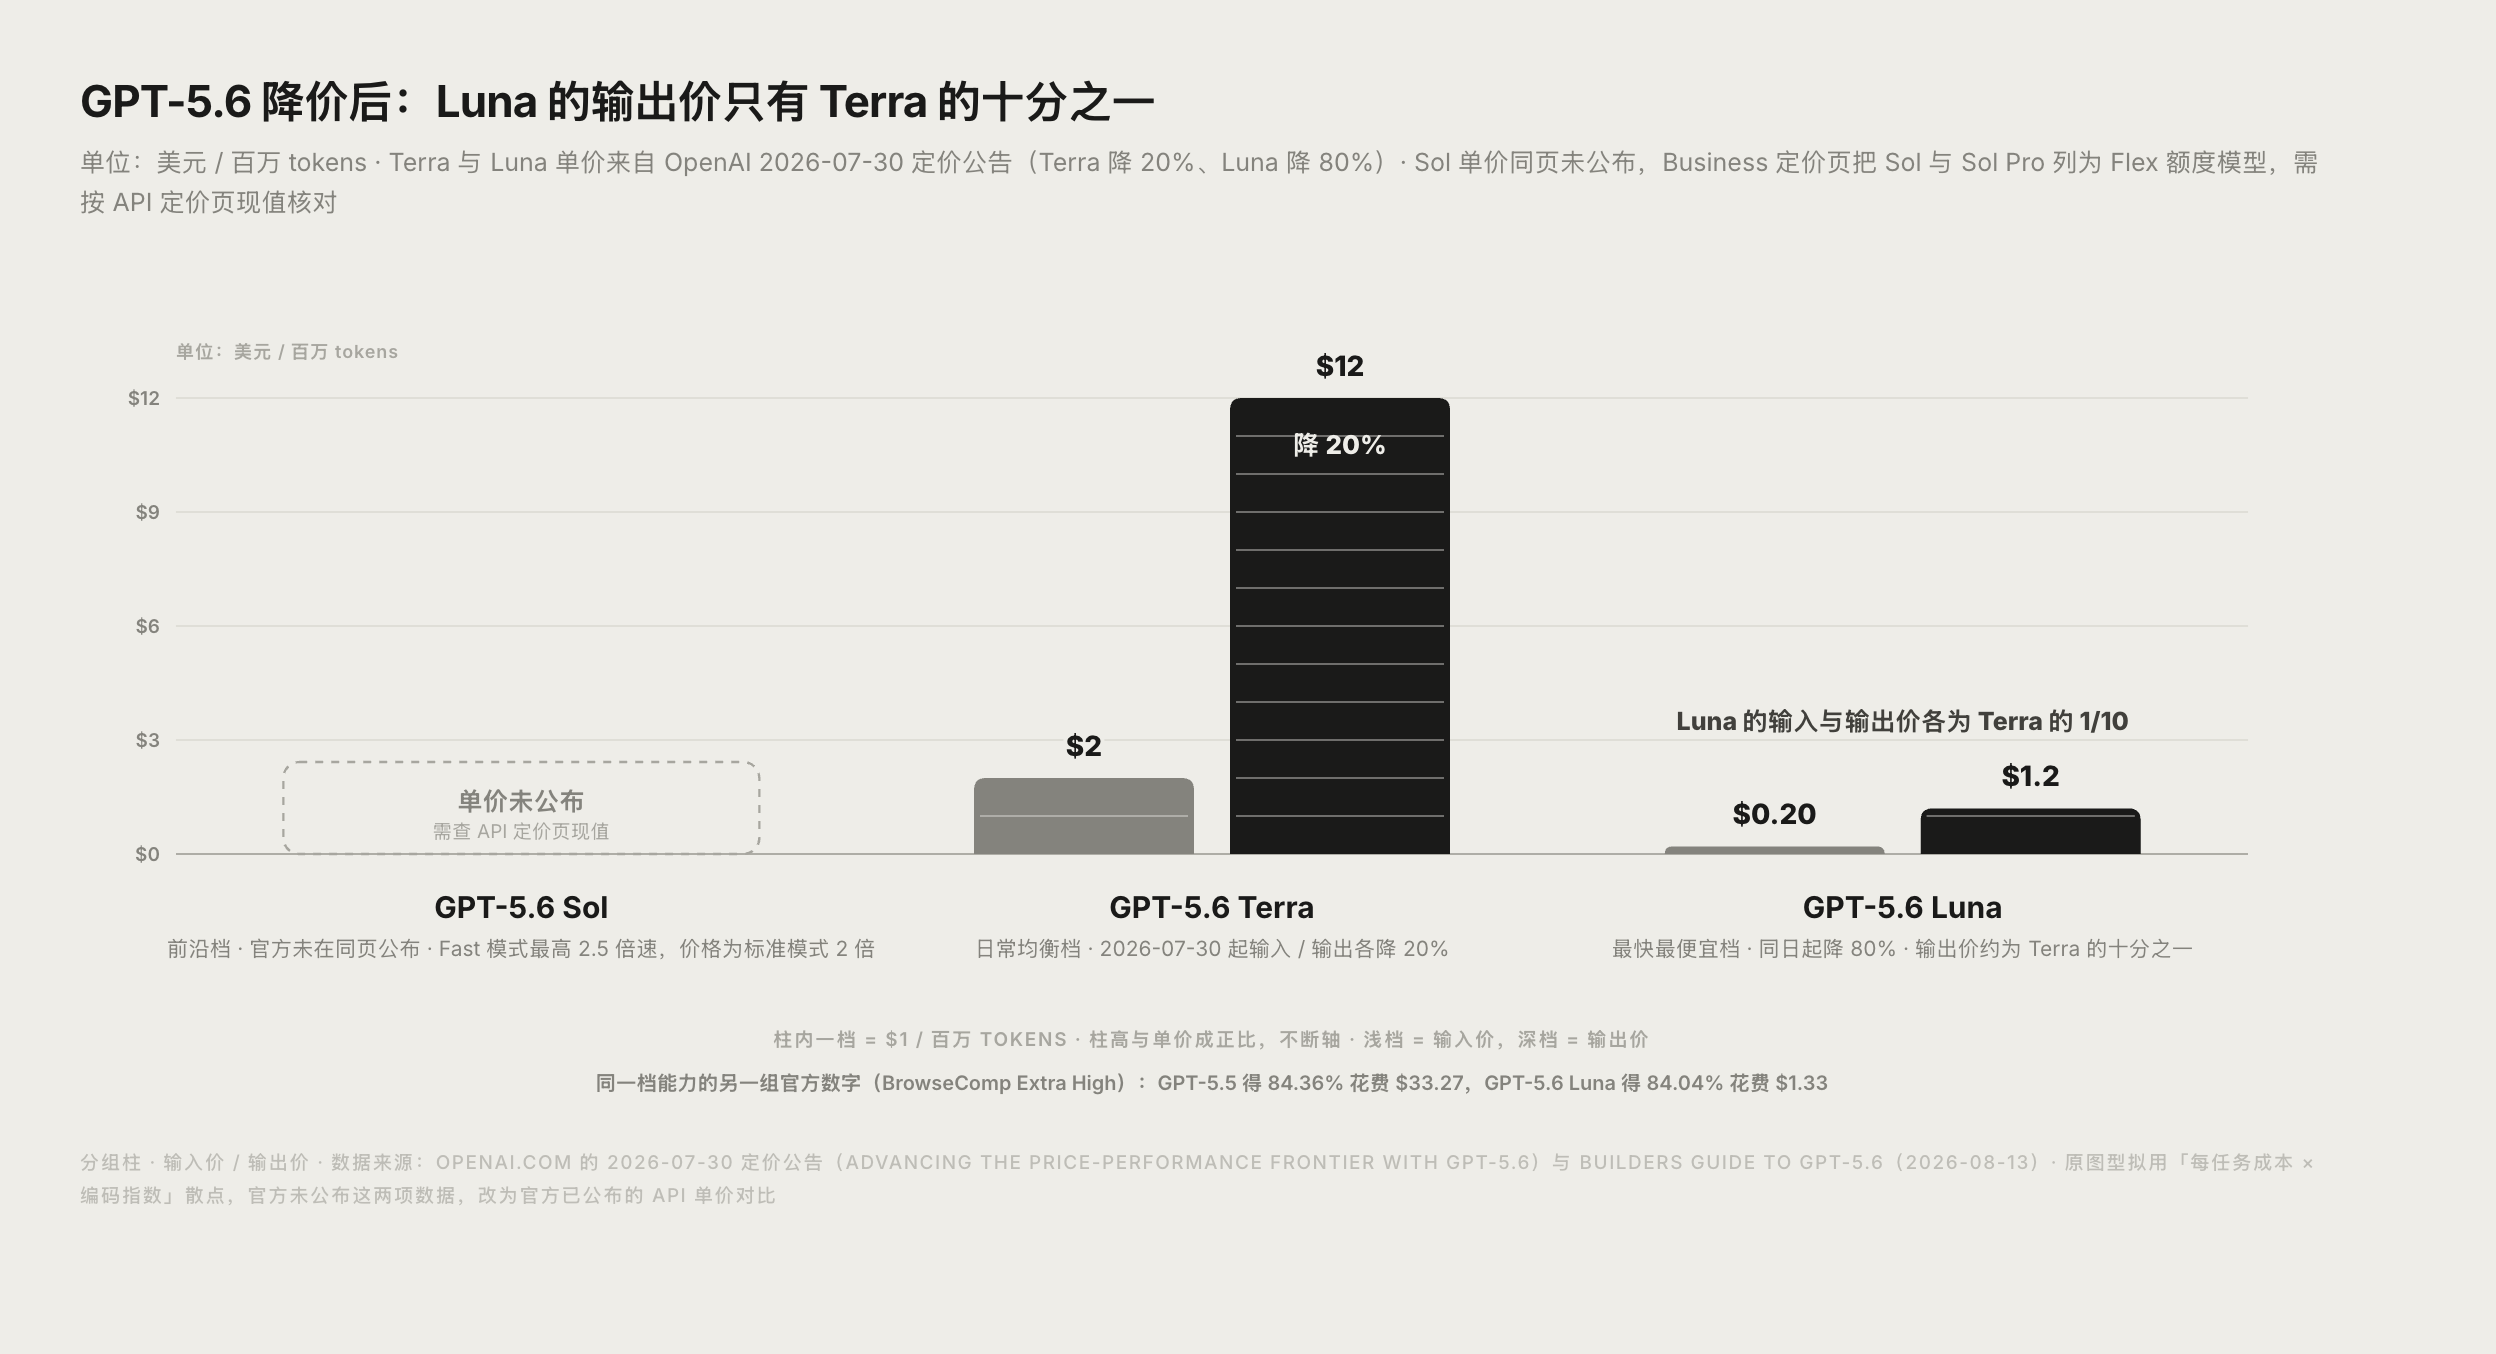
Sol 不是 OpenAI 唯一在跑的 5.6 模型。按官方 builder's guide(2026 年 8 月 13 日)和 7 月 30 日定价公告,这一代主力分三档,另外在 Business/Enterprise 定价页里还能看到 GPT-5.6 Sol Pro 这个入口:
| 型号 | 定位 | API 单价(每百万 tokens,输入 / 输出) | 官方口径 |
|---|---|---|---|
| GPT-5.6 Sol | 前沿档,能力上限最高 | 本次公告未调整,需到 API 定价页核对现值 | Fast 模式最高 2.5 倍速,价格为标准模式 2 倍 |
| GPT-5.6 Terra | 日常均衡档 | $2 / $12 | 2026 年 7 月 30 日起降价 20% |
| GPT-5.6 Luna | 最快最便宜档 | $0.20 / $1.20 | 同日起降价 80% |
几个能直接感知档位差距的公开数字(均来自官方页面):
- BrowseComp 这个「搜冷门事实」基准上,三个月前 GPT-5.5(Extra High)拿 84.36%、总花费 $33.27;上线时 GPT-5.6 Luna(Extra High)拿 84.04%,花费 $1.33。
- 在 ARC-AGI-3 上,GPT-5.6 Sol 用标准 harness 得 13.3%;打开推理保留与压缩(retained reasoning + compaction)后升到 38.3%,输出 token 还少了约 6 倍。
- 在 Agents' Last Exam 上,Sol 用 low 推理强度就超过了 GPT-5.5 的 high 推理强度(官方口径,harness 保持一致)。
对普通用户来说,这张表的意义很直接:Sol 是「难题交给它」的那一档,日常批量活可以往下走 Terra 或 Luna。
边界与前提:这次结论能推到哪
看官方页面时容易被忽略的几条限制,单独列出来:
- 弱信号场景不成立。案例只证明了「信号清晰时几乎不用人干预」。噪声大、结果含糊时,模型找参数会变慢,需要资深研究员兜底。
- 实验设计不在能力范围内。官方明确写的是常规测量流程可以交给代理,但实验设计和模糊物理结果的解读仍由研究员负责。
- 它是通过 Codex 接入实验室软件实现的,不是 ChatGPT 里的一个开关。普通用户能体验到的是同源的「长任务自主循环」能力,不是量子实验本身。
- 没有独立产品发布页。OpenAI 把 Sol 作为 GPT-5.6 系列在 Codex 场景下的型号来展示,市面上把它讲成「新模型发布」的多半是二次转述。
- 有账号与额度门槛。Sol 属于付费 API 档;在 ChatGPT Work 和 Codex 里,Free 与 Go 用户可用的上限是 Terra,Luna 要 Plus、Pro、Business、Enterprise 才能选。
对普通 Codex 用户意味着什么
- 你可能已经在用同款能力。Sol 是通过 Codex 调用的,日常让 Codex 跑长任务、自主改代码再自测的体验,和案例里跑测量的机制同源:给足技能说明和目标,让它自己循环执行、检查、修正。
- 案例验证的用法值得抄:先给代理写清「怎么跑、怎么判断好坏」的 skills,再放权。案例里模型表现好坏,很大程度取决于测量说明写得清不清。
- 不要指望它在目标模糊的任务上自动驾驶。弱信号、结果含糊的场景,人的判断仍然不可替代,这与绝大多数人用编码代理的体感一致。
想调优日常 Codex 输出质量,看站内 GPT-5.6 降智了吗?回答变短的真相与让输出变好的 6 个方法。
放进 OpenAI 的产品线里看
GPT-5.6 在 2026 年成为 OpenAI 的主力模型系列之一(随后有 GPT-6 Astra,5.6 家族内部又分了 Sol、Sol Pro、Terra、Luna)。Sol 这个版本号出现在应用案例里,说明 OpenAI 在按场景打磨变体,而不是发一个大模型就完事。
关心各家模型价格与定位的,可参考站内 Grok 4.6 价格、发布时间与 API 接入全解:半价追平 GPT-5.6?;想理解怎么科学评价一个模型,读 ARC-AGI 是什么?一文讲透 GPT-6 Astra 的 99.9% 与 Omen Alpha 盲测。
技术细节想要一手来源,OpenAI 同时发布了技术案例研究 PDF,含完整校准曲线。
常见问题
GPT-5.6 Sol 是新发布的独立模型吗?
答:官方案例把它作为 GPT-5.6 系列在 Codex 场景下使用的型号来展示,没有单独的产品发布页。把它理解为按场景打磨的 5.6 变体比较稳妥。
它能自己设计量子实验吗?
答:不能。常规测量流程它跑得很好,但实验设计和模糊结果的解读仍由研究员负责,官方明确写了这是当前边界。
普通 ChatGPT 用户能用上 Sol 吗?
答:案例是通过 Codex 调用的,OpenAI 没有宣布 ChatGPT 内的单独入口。Codex 用户在长任务里体验到的能力与其同源。
这次实验用的是多少比特的芯片?
答:一颗未校准的六比特标准超导芯片,是 EQuS 用来做工艺基准测试的常规型号。
用 GPT-5.6 Sol 要花多少钱?
答:官方 7 月 30 日公告只公布了 Terra($2 / $12)与 Luna($0.20 / $1.20)的 API 单价,并说明 Sol 价格未调整、未在同一页列出,需要到 OpenAI 的 API 定价页按最新值核对。Business/Enterprise 方案里 Sol 与 Sol Pro 属于按需购买额度的模型。
哪里能看到完整技术细节?
答:OpenAI 随案例发布了技术案例研究 PDF,内含完整的校准测量曲线和数据,链接在正文里。
 京ICP备2024094994号-29