
GPT-5.3-Codex-Spark 下线怎么办?迁移与替代方案
GPT-5.3-Codex-Spark 将于下周退役,Codex 负责人 Tibo 在 9 月 14 日公布了这一消息。答案先给出来:对绝大多数用户来说不需要提前做什么,Codex 客户端的默认模型会自动切换;只有在自己代码里写死了 gpt-5.3-codex-spark 模型名的 API 调用,才需要在下线前手动换成 5.6 代的模型,否则会收到模型不存在的报错。
先确认:你会不会受这次下线影响
对号入座一下:
- 用 Codex CLI、Codex IDE 插件或 ChatGPT 里 Codex 入口的用户:不受影响,模型列表会自动更新,无需操作。
- 在自己项目里通过 API 调用、且模型名硬编码为
gpt-5.3-codex-spark的开发者:受影响,下线后调用会直接报模型不存在,需要在下周前改配置。 - 用第三方中转或代理服务且底层接了 Spark 的:受影响,等中转服务商自行切换,或换直连官方。
- 把 Spark 写进评测脚本、CI 回归用例、成本对比文档的团队:受影响程度最容易被低估,代码能跑、文档和基线却会集体失效,建议一并清理。
官方口径:为什么退役,怎么说
官方的理由很直白:Spark 的使用量持续下降,而 OpenAI 手里已经有明显更强的模型,Tibo 的原话是「该给未来腾地方了」。他还在同一条动态里自嘲了一句:「我到现在都不相信我们真的上线过一个名字这么长的模型。」
值得注意的是措辞:官方给的是「下周退役」,没有精确到某一天。所以行动建议按最保守的方式排,也就是把迁移做完的时间点压在消息发布后一周内。官方模型支持口径见 OpenAI 帮助中心,模型代际说明以 OpenAI 官方文档为准。
Spark 是什么,为什么只活了 7 个月
Spark 今年 2 月 12 日发布,主打一个字:快。最高约 1200 tokens/s 的输出速度,128k 上下文,官方发布口径还包括往返成本降低约 80%、首 token 延迟降低约 50%。它还是 OpenAI 第一个跑在 NVIDIA 技术栈之外的生产模型,底层算力来自 Cerebras 的晶圆级芯片 WSE-3,同时也是那份 750 兆瓦、总价超过 200 亿美元算力订单的首次交付(详见 AIbase 的报道)。
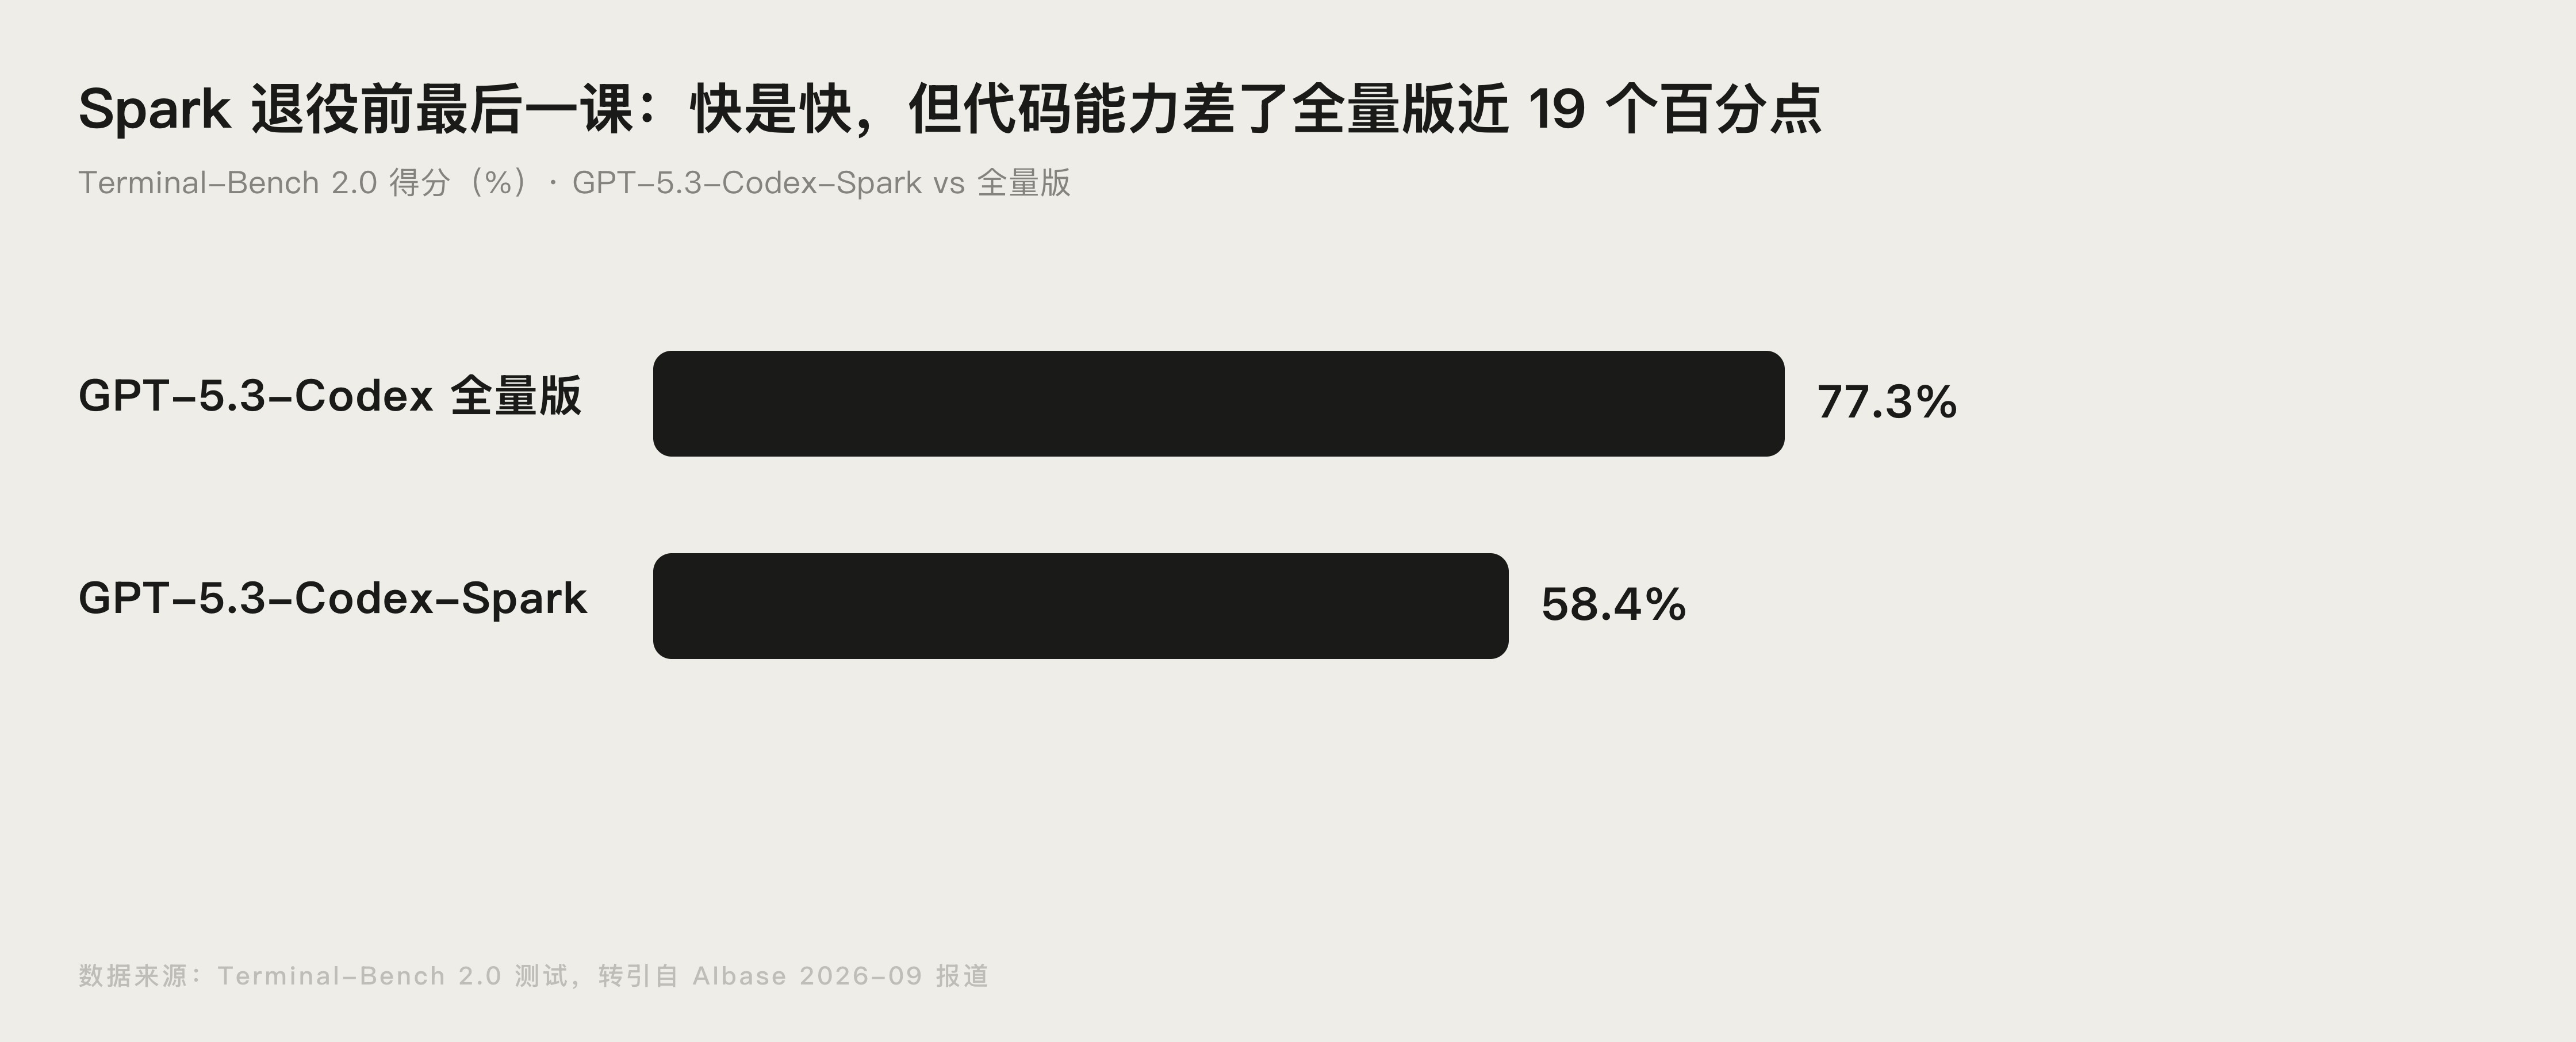
但它的问题也很典型:为了塞进单颗晶圆,它本质上是个为极致速度妥协的蒸馏小模型。三个公开数据可以说明问题:
| 指标 | GPT-5.3-Codex-Spark | GPT-5.3-Codex 全量版 |
|---|---|---|
| Terminal-Bench 2.0 | 58.4% | 77.3% |
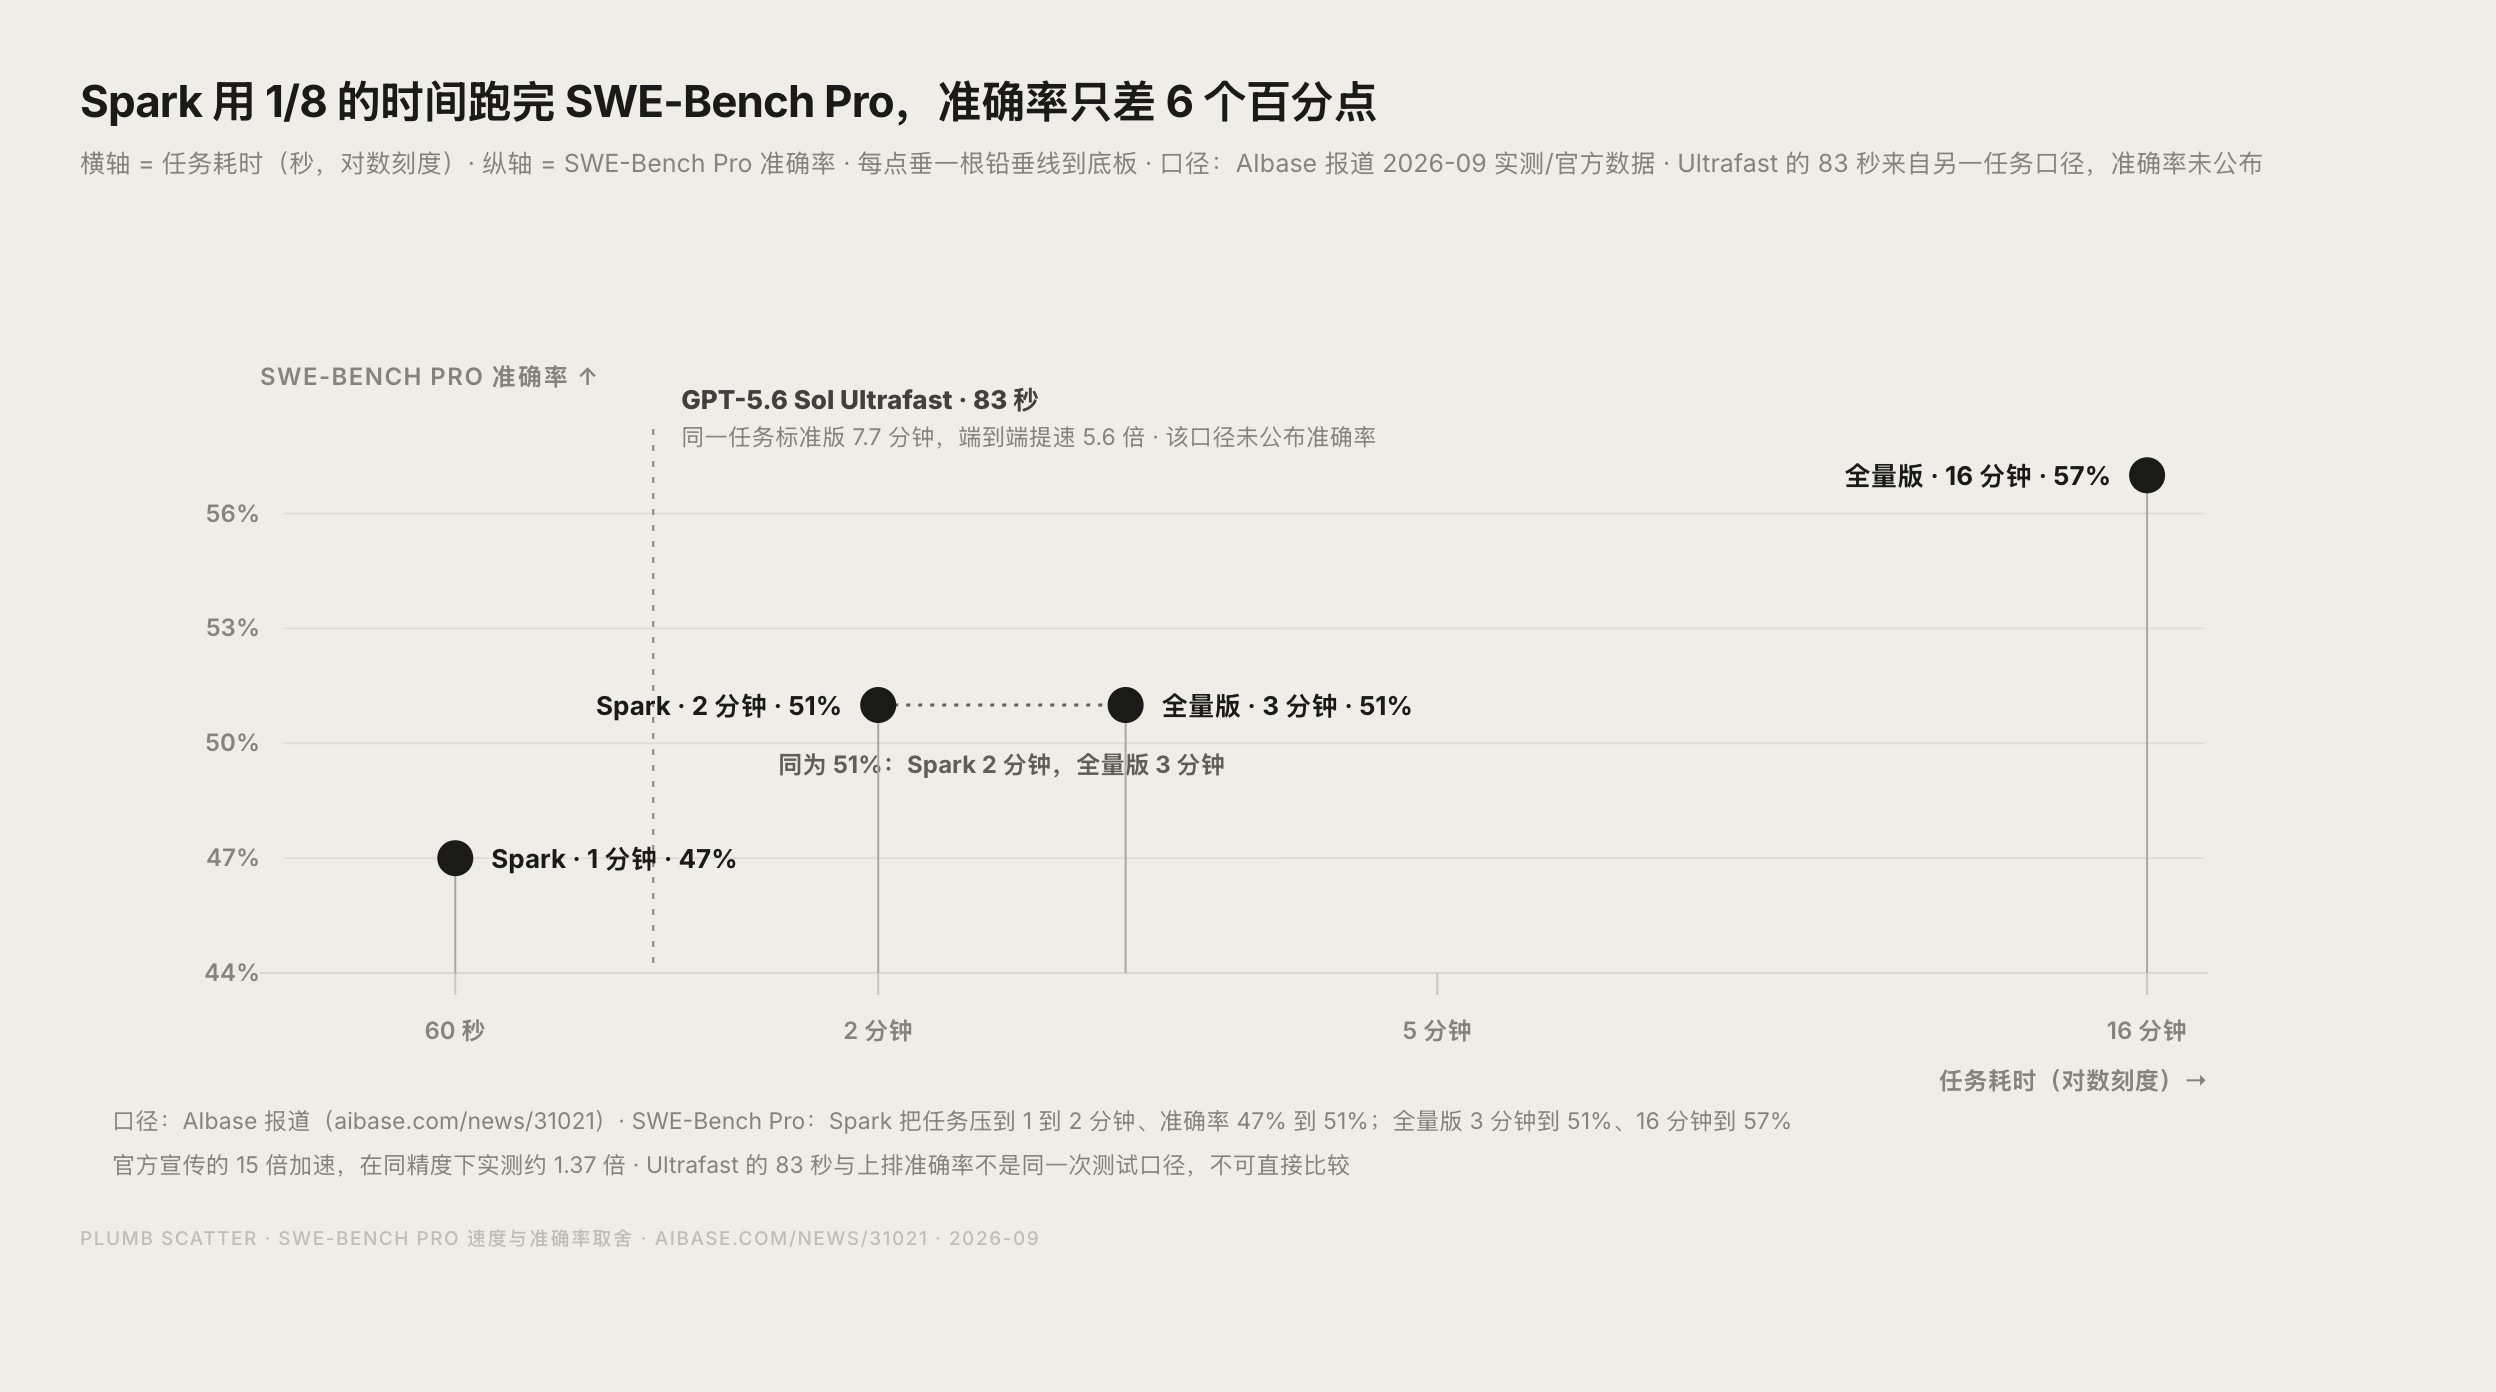
| SWE-Bench Pro 准确率 | 47% 到 51%(任务压缩到 1 到 2 分钟) | 3 分钟到 51%,16 分钟到 57% |
| 宣称的速度优势 | 宣传为 15 倍 | 同精度下实际约 1.37 倍 |
开发者普遍反馈它会编造不存在的 API 端点、JSON 输出格式不稳定。培训机构 Turing College 的点评传得很广:「没有智能的速度,只是失败得更快。」
压垮它的最后一根稻草是 8 月 13 日 Cerebras 推出的 Ultrafast 模式:不再用缩水小模型,而是把旗舰 GPT-5.6 Sol 按层切分、铺在多颗 CS-3 节点上形成流水线跑出 750 tokens/s,智力与标准版相当。官方对比数据是:同一任务在标准版平均耗时 7.7 分钟,Ultrafast 只用 83 秒,端到端提速 5.6 倍。Cerebras CEO Andrew Feldman 的说法是「速度和智能不再是二选一」。专门的「快模型」从此失去了存在的理由。
怎么迁移:按你的使用场景三选一
| 你的场景 | 替代选择 | 理由 |
|---|---|---|
| Codex 客户端日常编程 | 什么都不用做,跟随默认模型 | 官方会自动切换到 5.6 代 |
| API 写死了 Spark 模型名 | 改成 5.6 代的模型(如 GPT-5.6 Sol) | 质量与速度兼顾,社区实测反馈好 |
| 就是要极限速度 | Cerebras Ultrafast 模式的 GPT-5.6 Sol | 750 tokens/s,且智力不打折 |
具体操作只有三步:
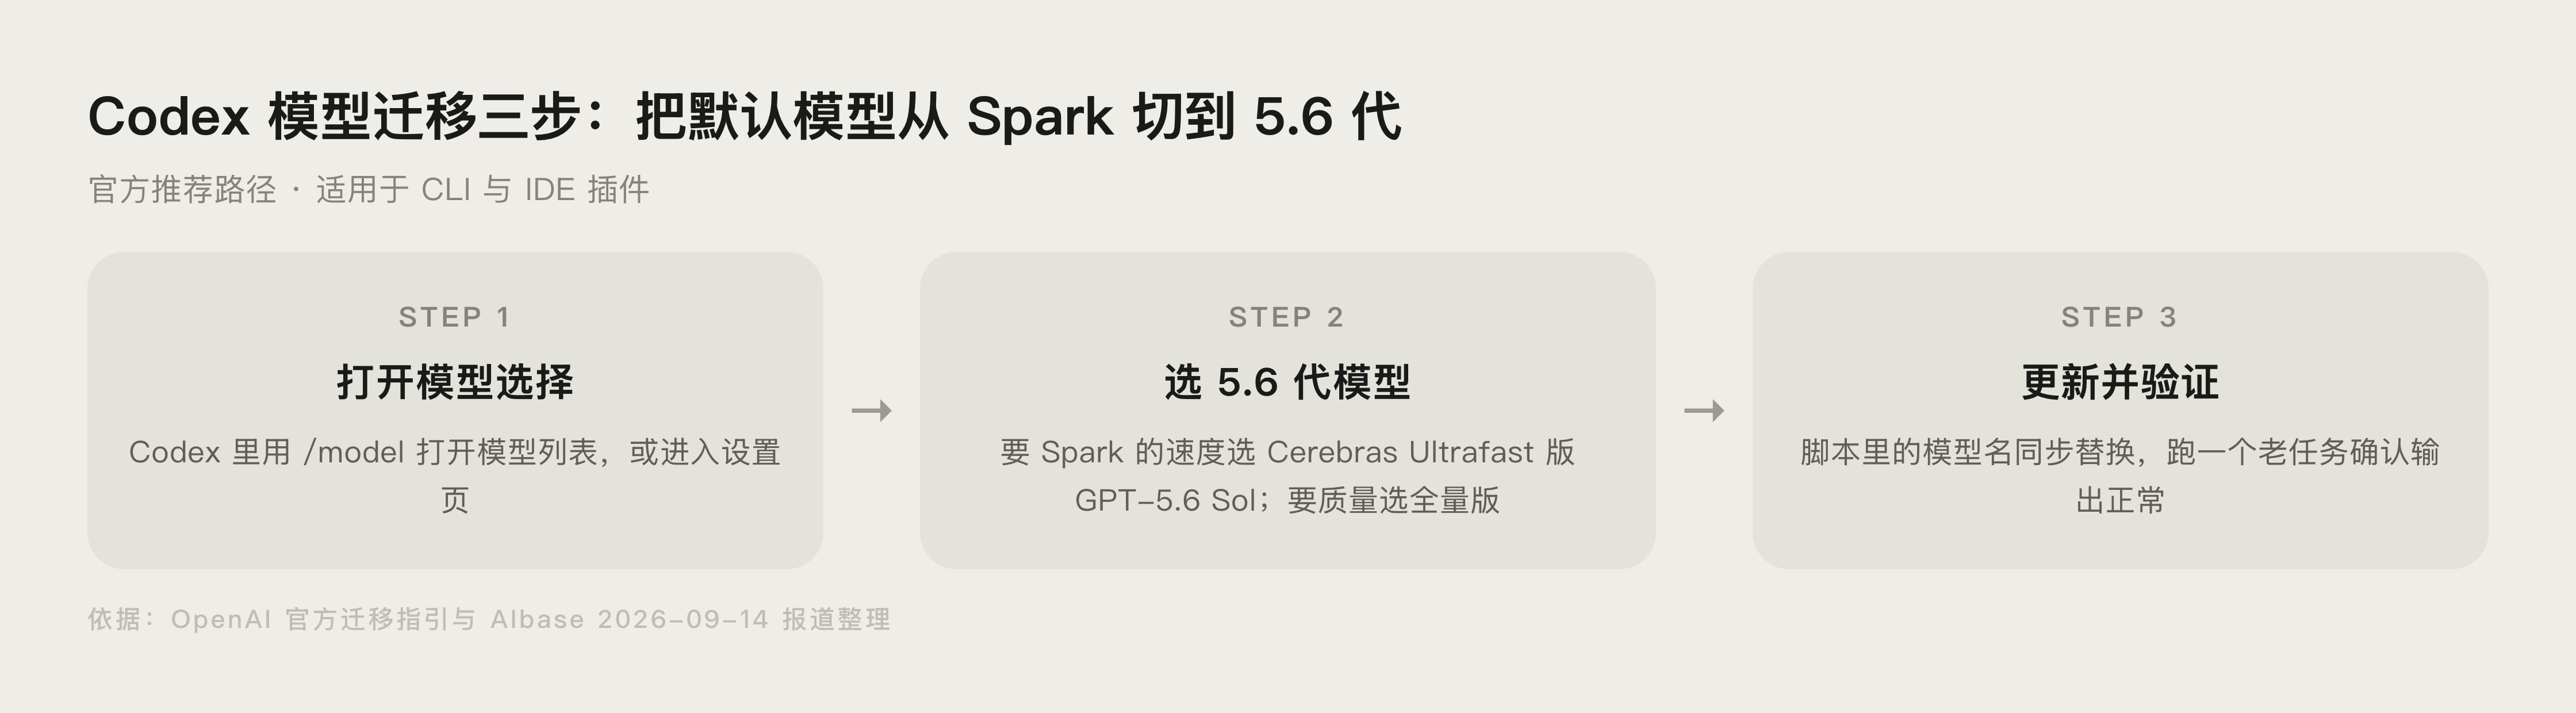
- 全局搜索代码和配置文件里的
gpt-5.3-codex-spark,替换为 5.6 代模型名。 - 跑一遍冒烟测试,重点看之前 Spark 场景的响应速度是否可接受。
- 下线日之后观察日志,确认没有残留调用在报错。
迁移时最容易踩的四个坑
- 只搜了主模型名,漏掉带后缀的变体:把
spark作为关键词做一次不带连字符的模糊搜索,顺手把注释、README、示例代码和.env.example一起改掉。 - 只看速度不看准确率天花板:Spark 在 SWE-Bench Pro 上的准确率长期卡在 47% 到 51% 区间,迁移时先确认你的场景原本有没有依赖它的速度来换质量,不要默认「换个更聪明的模型就万事大吉」。
- 忘了中转和代理层:如果你是通过第三方网关调用的,模型名可能同时写在网关配置里,直连侧改完了照样报模型不存在。
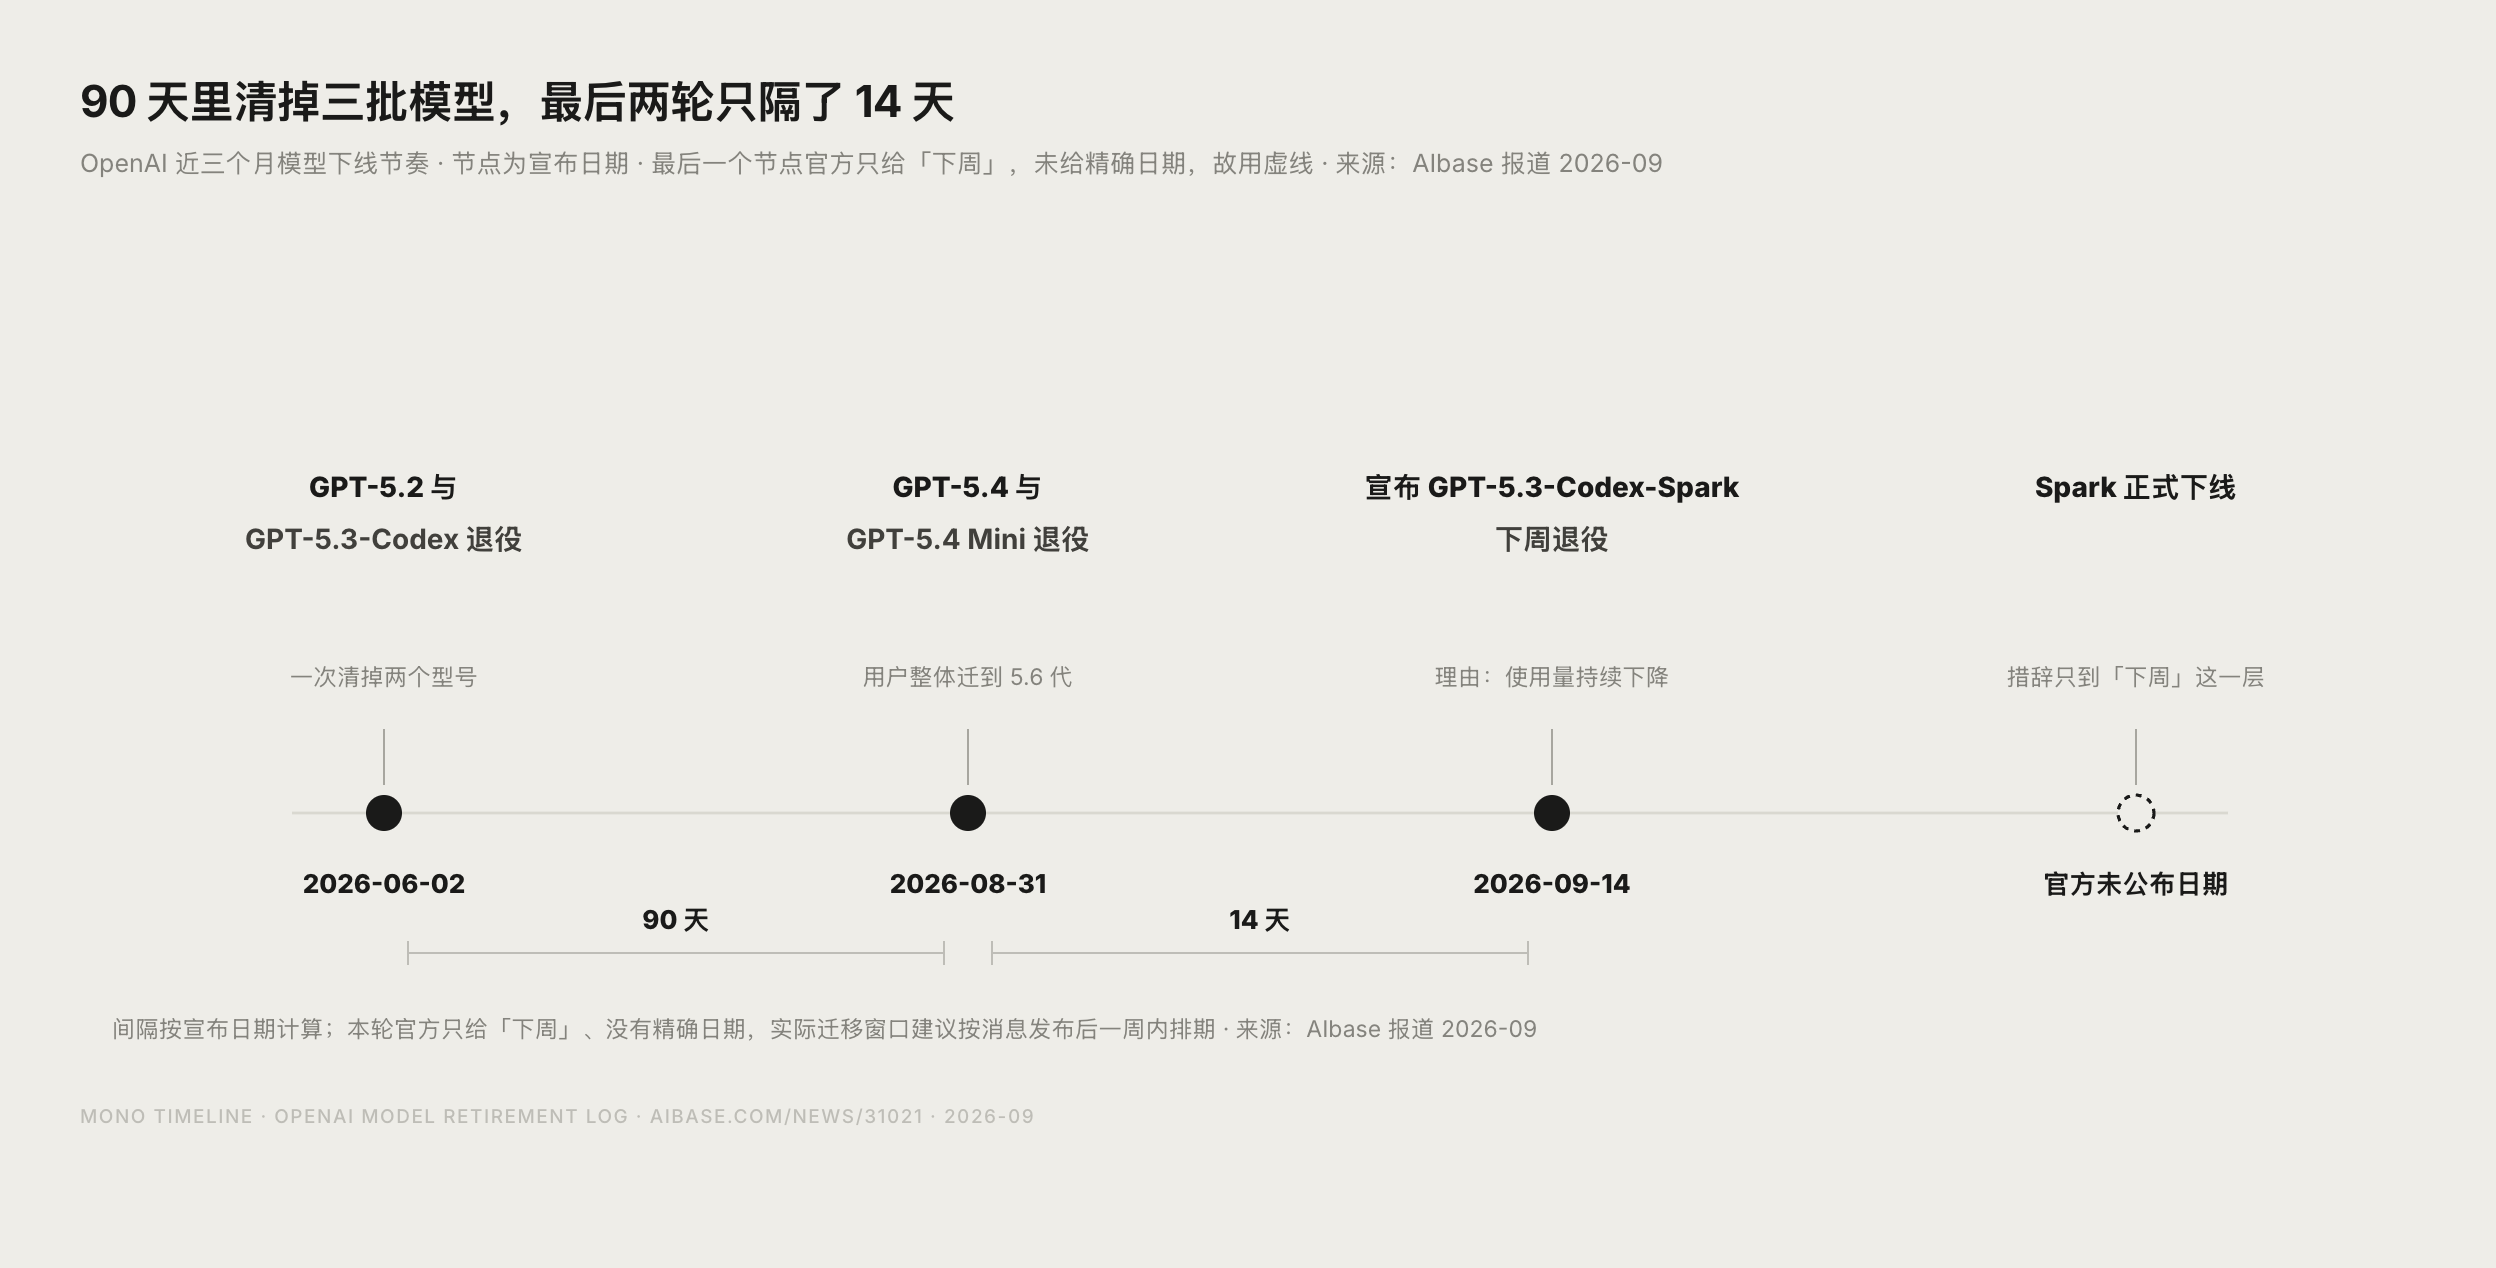
- 没有把模型名配置化:过去三个月 OpenAI 已经清掉三批旧模型,把模型名硬编码在业务代码里,等于每次下线潮都要重新做一遍今天这个动作。这次顺手改成「从配置中心读模型名」,下次改一行配置就行。
顺带检查:OpenAI 的模型下线节奏在加快
这不是孤立事件。过去三个月的清理时间线如下:
| 时间 | 下线模型 | 迁移方向 |
|---|---|---|
| 6 月 2 日 | GPT-5.2、GPT-5.3-Codex | 迁到更新一代 |
| 8 月 31 日 | GPT-5.4、GPT-5.4 Mini | 用户整体迁移到 5.6 代 |
| 9 月(本次) | GPT-5.3-Codex-Spark | 迁到 5.6 代或 Ultrafast 通道 |
Codex 正在进入 Sol、Terra、Luna、Astra 的全新命名时代。对开发者来说,这轮下线的真正启示不是「哪个模型被砍了」,而是「模型名不能再当常量用」。如果你的工程里到处是硬编码模型名,这次一并治理。
计划把编码模型换成国产方案的话,可以参考这篇 GLM-5.3 深度评测,里面有与 Claude/GPT 的实测对比;
Codex 用得多的话,Codex 额度规则详解和重连 5 次报错的排查方法也建议收藏,想弄清 5.6 代里 Sol 这条线的定位可以看 GPT-5.6 Sol 解读。
常见问题
GPT-5.3-Codex-Spark 什么时候下线?
答:Codex 负责人 Tibo 于 9 月 14 日宣布下周退役,官方没有给出精确日期,具体以 OpenAI 官方公告为准。建议按一周内完成 API 侧迁移来排期。
下线后调用会发生什么?
答:模型名会失效,API 调用返回模型不存在的错误。Codex 官方客户端用户无感,会自动切到新模型。
替代 Spark 的最佳选择是什么?
答:官方推荐迁移到 5.6 代模型。要接近 Spark 的速度体验,选 Cerebras Ultrafast 模式下的 GPT-5.6 Sol,750 tokens/s 且智力不打折;要质量,用 5.6 代全量模型。
为什么这么快就下线?
答:官方口径是使用量持续下降,加上手里已有明显更强的模型。公开数据也支持这个解释:Spark 在 Terminal-Bench 2.0 只有 58.4%,远低于全量版的 77.3%,而 8 月 13 日的 Cerebras Ultrafast 模式让旗舰模型直接获得了高速推理,专门的缩水快模型失去了价值。
我还有办法继续用 Spark 吗?
答:没有官方渠道。它是托管模型,下线即从模型列表移除,本地没有开源权重可部署,只能迁移到替代模型。
如果我只用 ChatGPT 里的 Codex 入口,需要做什么?
答:不需要做任何操作。模型列表由官方维护,会自动切换到新模型;但如果你的工作流里保存过固定的模型参数或截图基线,建议顺手检查一遍。
 京ICP备2024094994号-29