
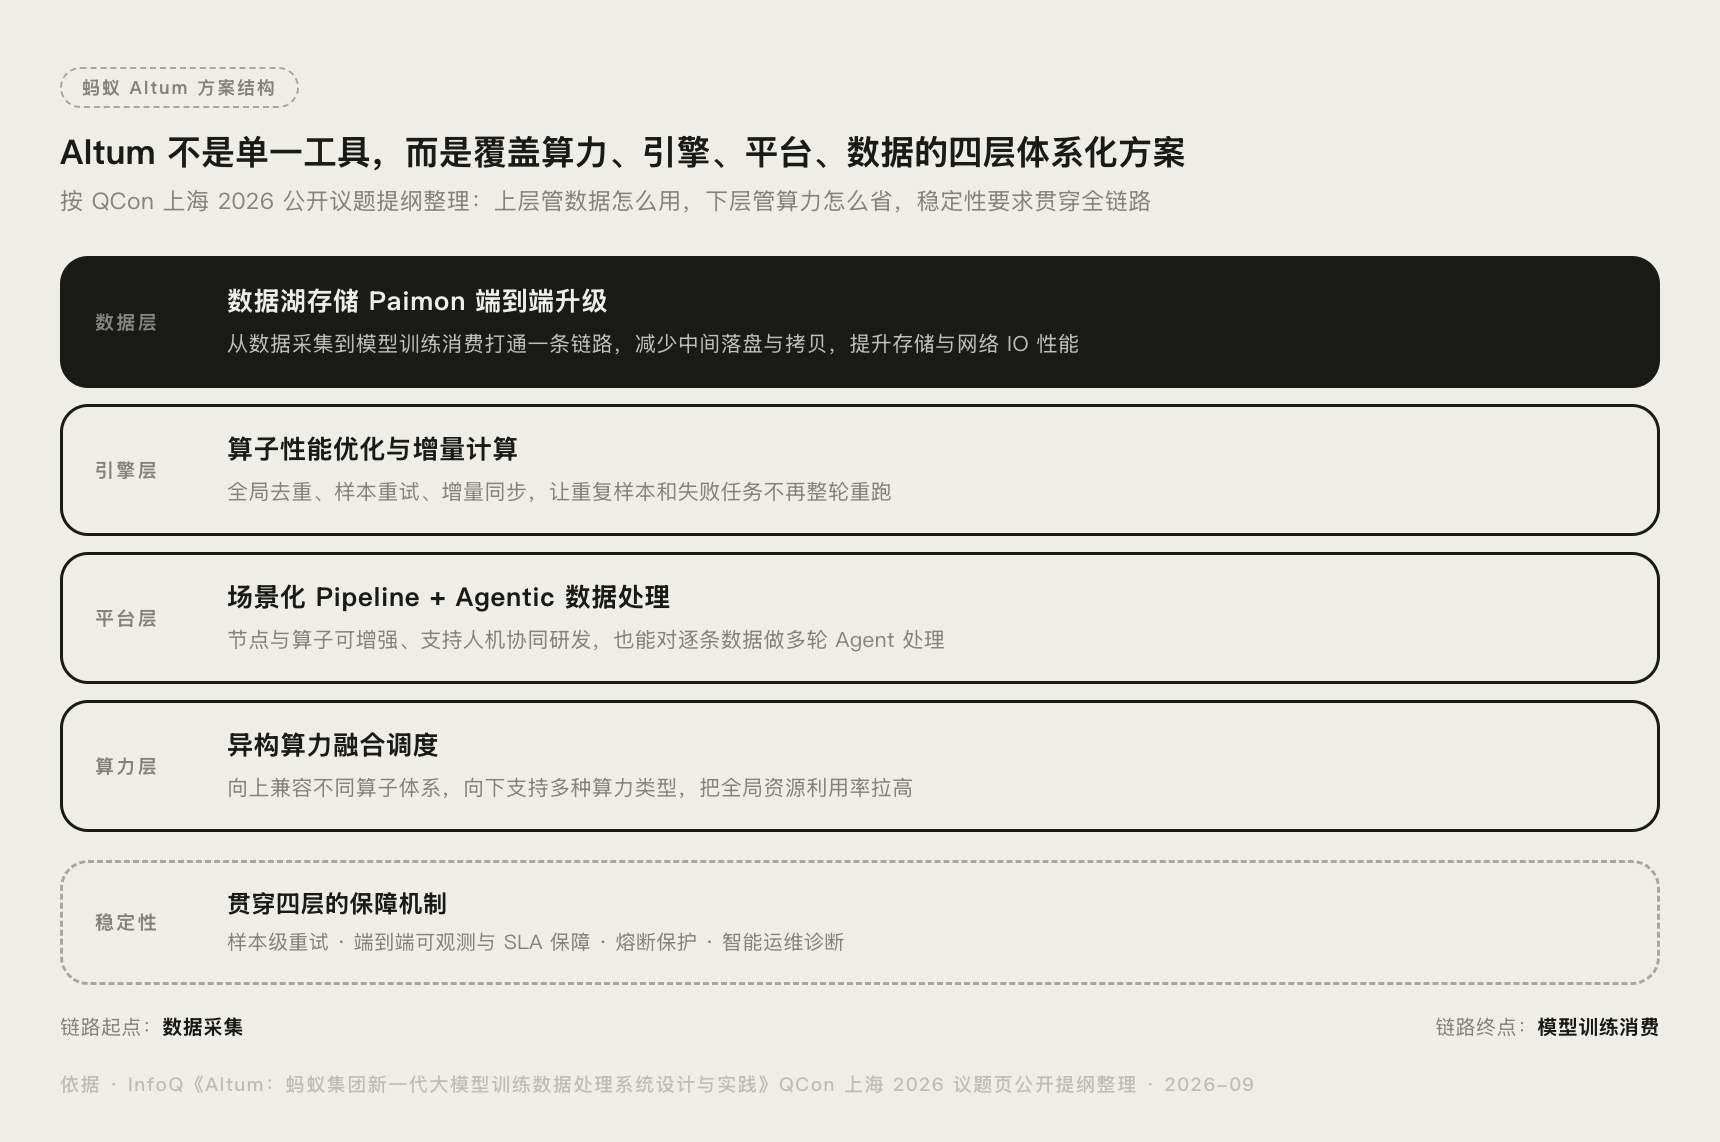
蚂蚁Altum是什么?一套系统解决训练数据三大难题
蚂蚁 Altum 是蚂蚁集团新一代大模型训练数据处理系统,技术负责人为蚂蚁集团实时智能技术负责人王鑫。它瞄准大模型训练数据处理里的三个老问题:GPU 效能低、任务不稳定、数据交付慢,完整设计将在 10 月 22 日 QCon 上海站首次公开分享。
一句话结论:Altum 不是模型,也不是对外产品,而是蚂蚁把算力、引擎、平台、数据四层收进同一套体系的大模型训练数据处理系统。目前公开的只有议题提纲,架构细节、代码和开源计划都还没公布。
本文信息来自公开的 QCon 议题页与蚂蚁公开的技术分享,我们未接触 Altum 系统本身,关键事实都标了来源。
蚂蚁 Altum 是什么?
| 项目 | 说明 |
|---|---|
| 定位 | 蚂蚁集团新一代大模型训练数据处理系统,内部系统建设实践 |
| 技术负责人 | 王鑫,蚂蚁集团实时智能技术负责人 |
| 首次公开分享 | QCon 上海 2026,专题「AI Infra:算力效率决定规模化落地」 |
| 时间地点 | 2026 年 10 月 22 日至 24 日,上海建工浦江皇冠假日酒店 |
容易混淆的是:百灵(Ling、Ring、Ming)是蚂蚁的模型产品线,Altum 是训练这些模型之前处理数据的系统,也不是能下载的软件。
Altum 要解决的三个难题
议题页的口径是:训练数据规模持续提升、模型迭代加快,业界在 GPU 效能、任务稳定性、数据交付时效上面临巨大挑战。
| 难题 | 实际表现 | 代价 |
|---|---|---|
| GPU 效能 | 去重、清洗、过滤本身吃算力,重复样本照样进训练 | 算力浪费,成本高 |
| 任务稳定性 | 中间某个环节失败,整轮任务跟着重跑 | 烧卡、交付被拖长 |
| 数据交付时效 | 从数据采集到能被训练消费,链路长、环节多 | 模型迭代被数据卡住 |
我们整理过大模型训练数据的来源与加工流程,任何一道工序变慢或重跑,最后都会出现在 GPU 账单上。
Altum 的四层体系化方案
提纲把整体方案描述为「涵盖算力、引擎、平台、数据等多个层次的体系化方案」。
数据层:基于数据湖存储 Paimon 的端到端升级
提纲对这一层的要求是「从数据采集到模型训练消费的端到端优化,提升存储与网络 IO 性能」。Apache Paimon 是 Apache 顶级流式湖仓格式,支持实时更新与多种 Merge Engine。蚂蚁不是临时选它:2024 年 7 月 Flink 中文社区的分享已明确要用 Paimon 建实时湖仓。
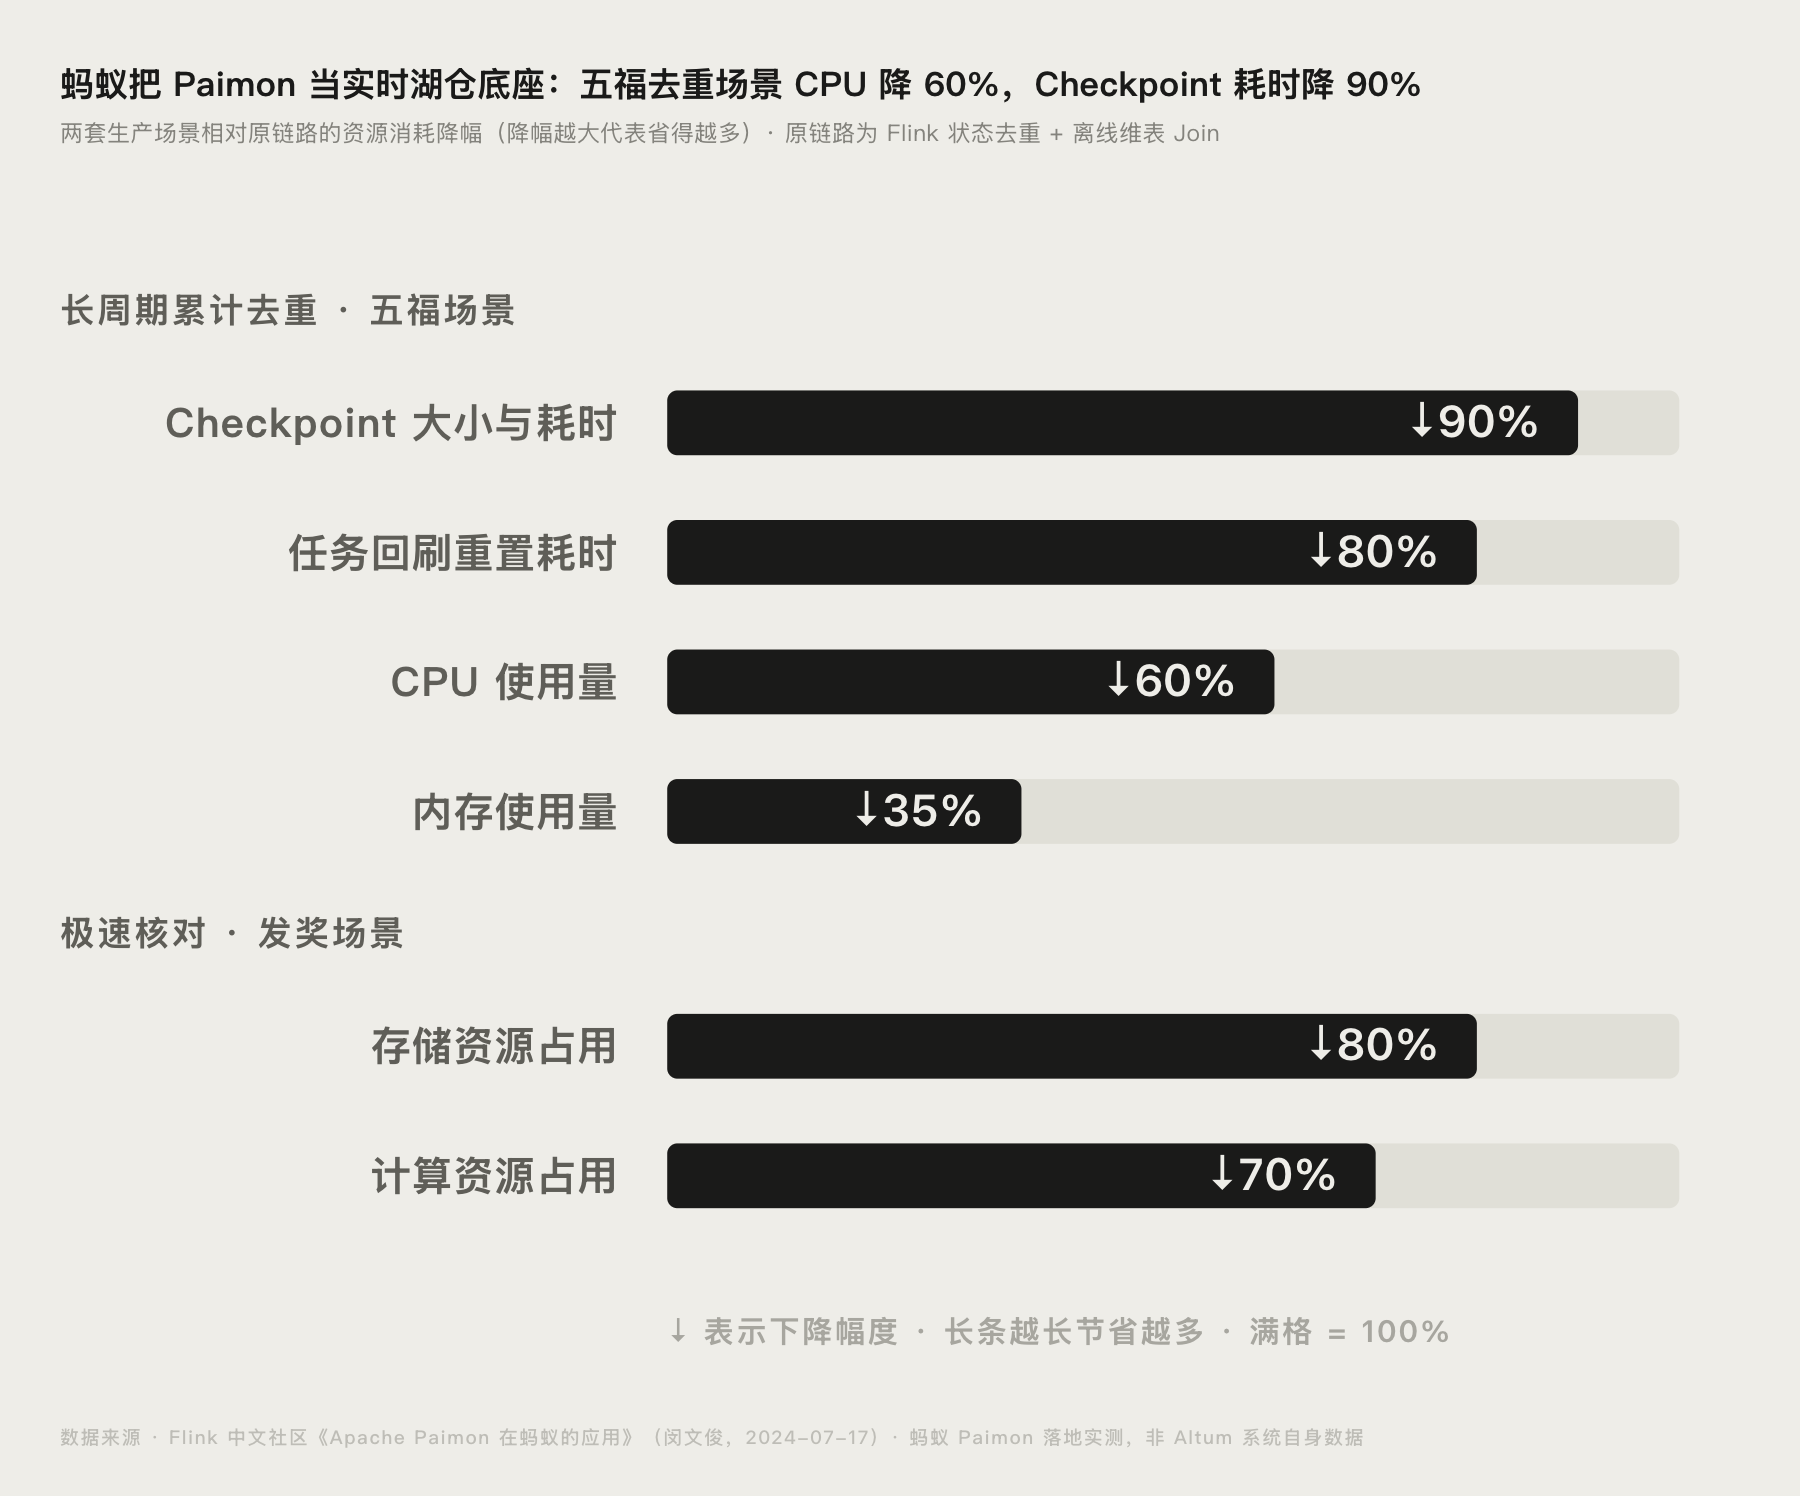
那场分享给了两组生产数据:五福去重场景 CPU 使用量降约 60%、内存降约 35%、Checkpoint 耗时降 90%、回刷耗时降 80%;发奖核对用 Partial-update 增量合并,约省 80% 存储与 70% 计算资源。这两组数字属于蚂蚁实时湖仓业务,不是 Altum 自身指标,但说明把去重与状态维护交给湖存储层是已经验证过的降本路径。
引擎层:算子性能优化与增量计算
全局去重避免同一份数据被反复处理,样本重试让失败的样本自己重跑,增量同步让新增数据不触发全量重算,都是为了让重复劳动别占着 GPU。
平台层:场景化 Pipeline 与 Agentic 数据处理
一端是端到端场景化 Pipeline,包含场景化研发范式、节点与算子增强、人机协同研发;另一端是 Agentic 数据处理,支持对逐条数据做多轮 Agent 处理。传统流水线是「一条规则过一遍全集」,Agentic 则是对单条数据做多轮判断。
算力层:异构算力融合调度
提纲原文是「向上兼容不同算子体系、向下支持多种算力类型,提升全局资源利用率」。数据处理任务对硬件要求差异很大,异构调度要做的是统一排队、按能力分配,而不是让 GPU 空转等数据。
稳定性:样本级重试最实用,但有两个没说透的取舍
提纲列了四件事:样本级重试、端到端可观测与 SLA 保障、熔断保护、智能运维诊断。样本级重试最实用,任务失败只重跑失败样本,理论上能根治「全量重跑烧 GPU」。
议题页还主动写出了两个实践痛点:跨引擎调度的统一抽象会牺牲引擎特有能力,做不到「零损失抽象」;样本级重试的降本空间受幂等约束与熔断阈值限制。这两条才是判断成熟度的关键。
已经落地在哪:阿福和百灵
提纲最后一部分写的是「在阿福、百灵等内部场景的落地效果」。
- 阿福:蚂蚁集团旗下的 AI 健康助手应用,网页端可直接打开。
- 百灵:蚂蚁自研大模型品牌,官网展示 Ling(通用)、Ring(推理)、Ming(多模态)三条产品线,最新是 2026 年 7 月 24 日发布的 Ling-3.0-flash。
阿福要求数据快速迭代,百灵要求数据规模与质量,Altum 得同时满足「快」和「大」。蚂蚁在模型侧开放动作明显,例如开源的 LLaDA-Image 图像生成编辑模型。
Altum 和 Data-Juicer、NeMo Curator 有什么不一样
| 维度 | 蚂蚁 Altum | 阿里 Data-Juicer | NVIDIA NeMo Curator |
|---|---|---|---|
| 定位 | 内部训练数据处理系统 | 开源一站式数据处理系统 | 开源 GPU 加速数据加工框架 |
| 覆盖范围 | 算力到数据共四层 | 算子与流水线 | stage 编排 |
| 是否开源 | 未公布 | 是,已集成阿里云 PAI | 是 |
这不是性能对比:后两者是能下载的开源工具,Altum 是内部系统,没有公开数字可以直接对齐。想跟百灵产品线,可以看Ling 3.0 Flash VL 多模态模型解读。
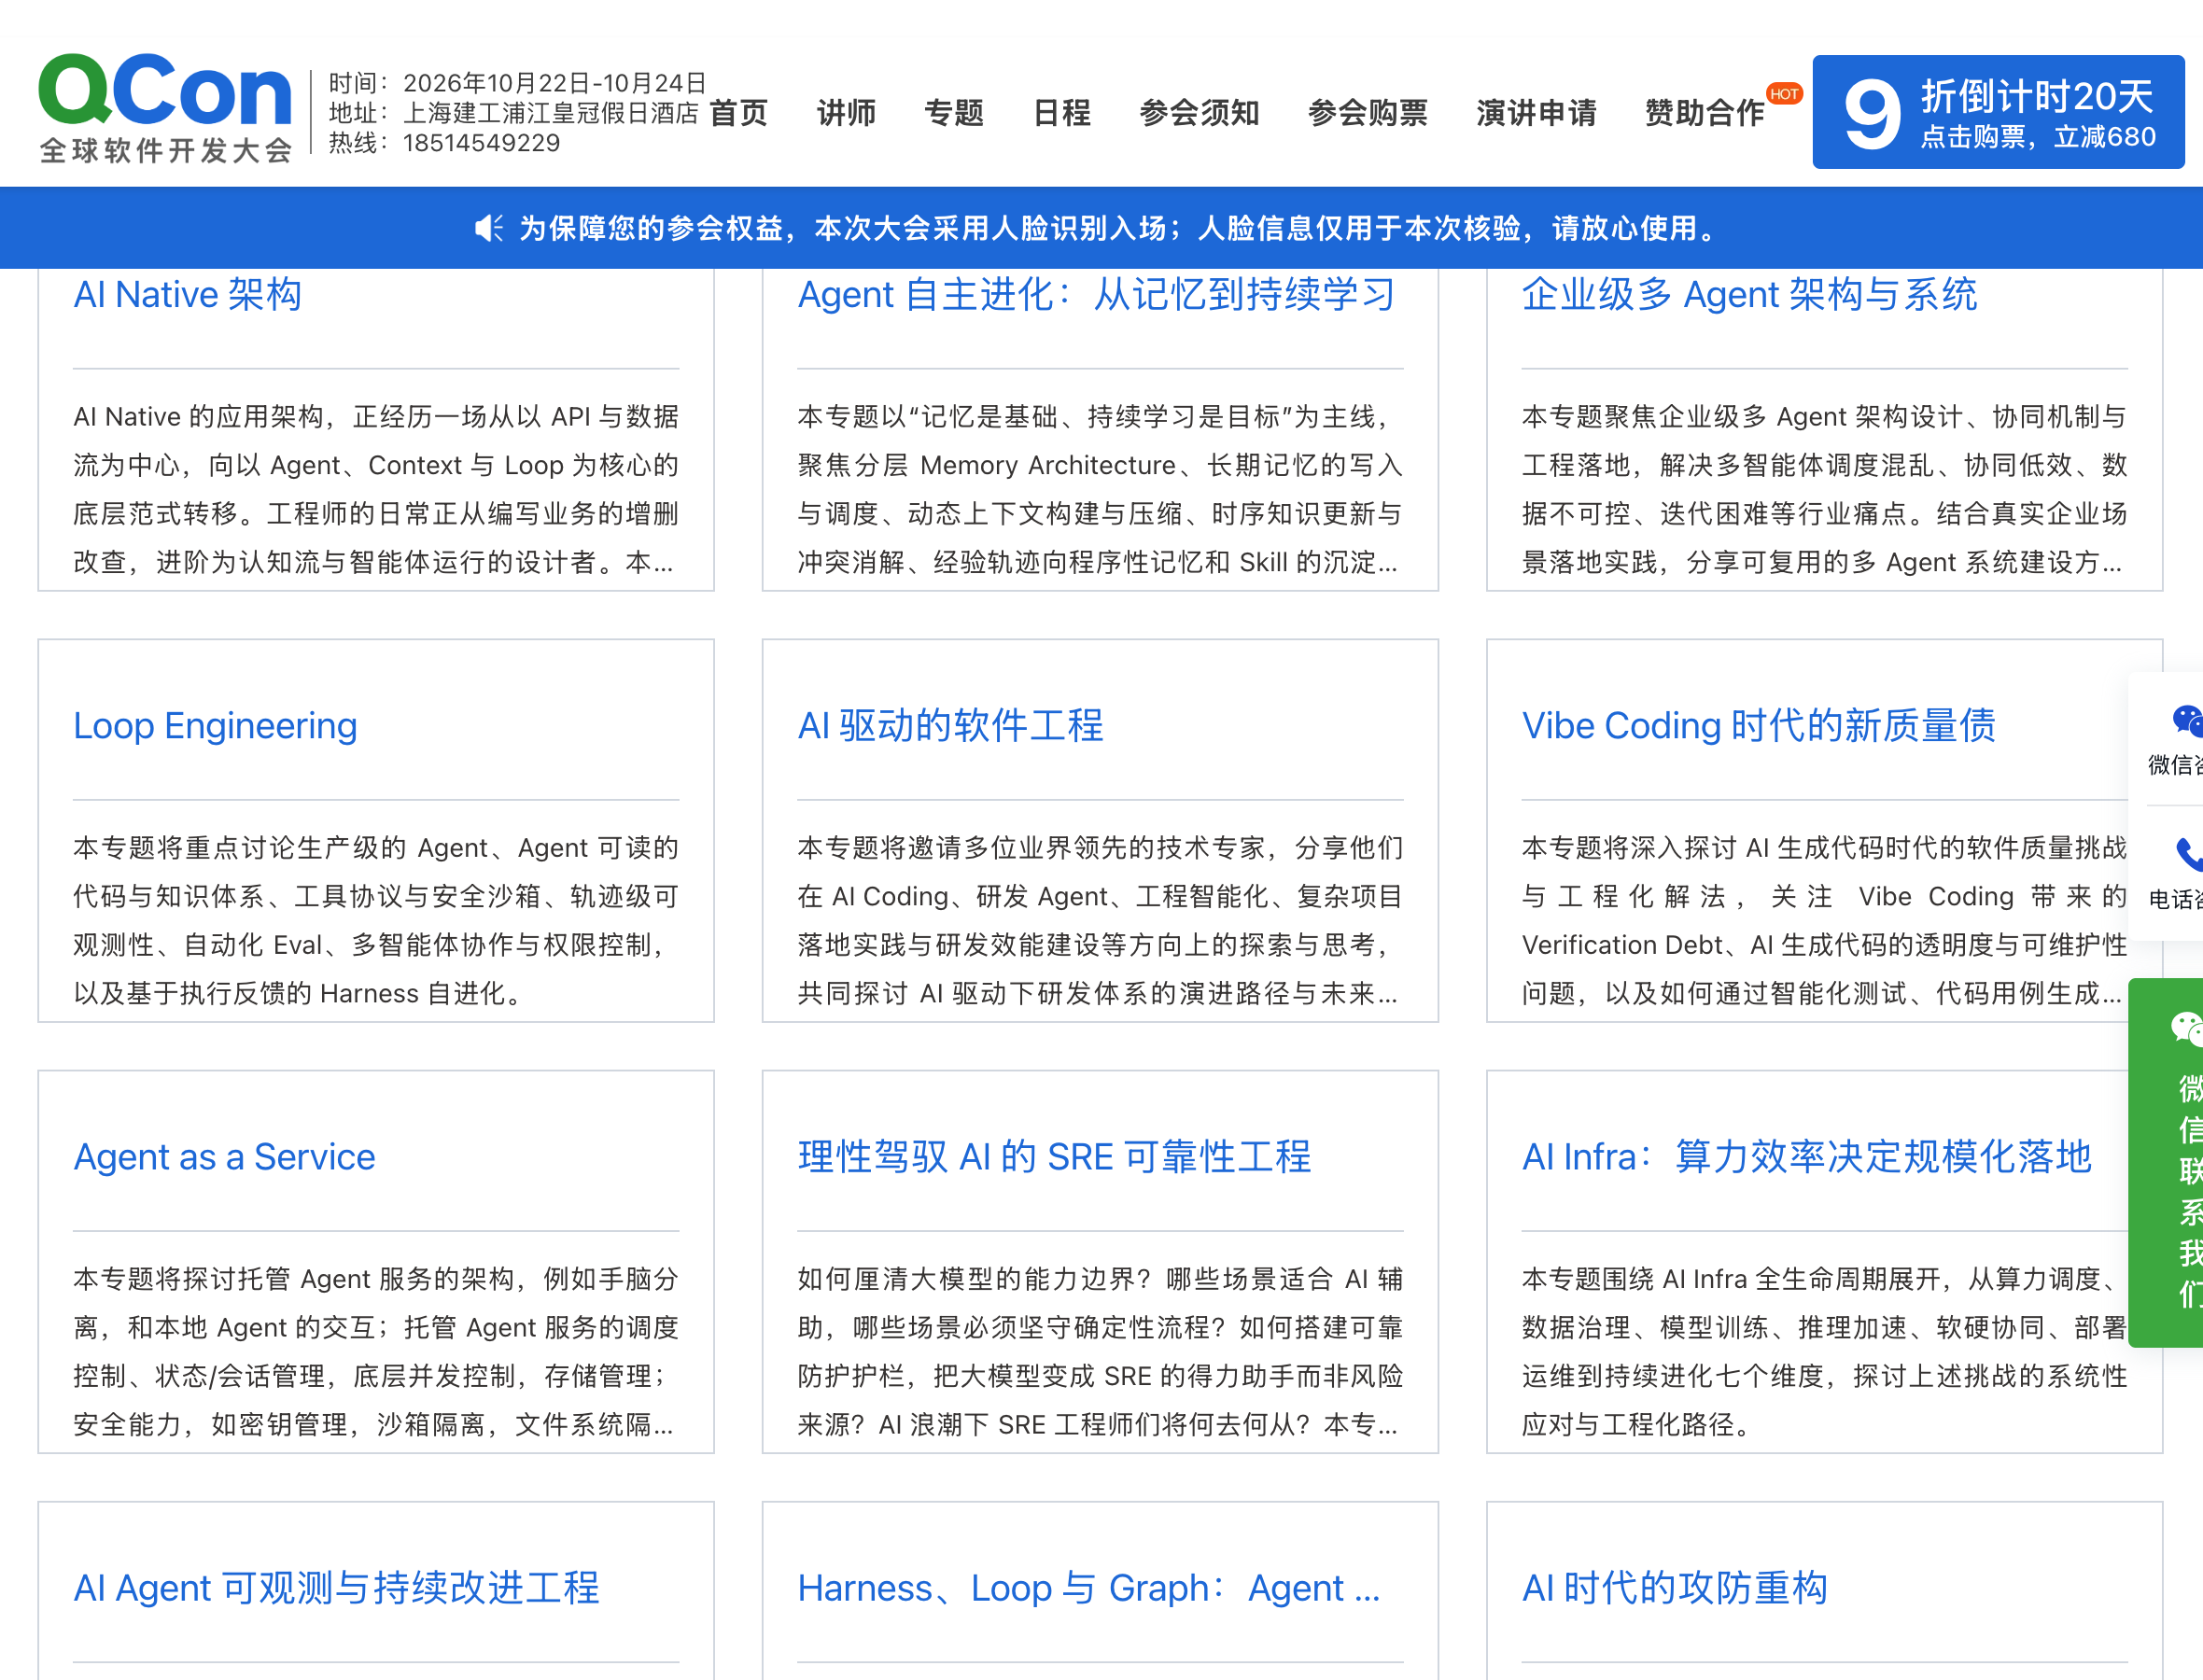
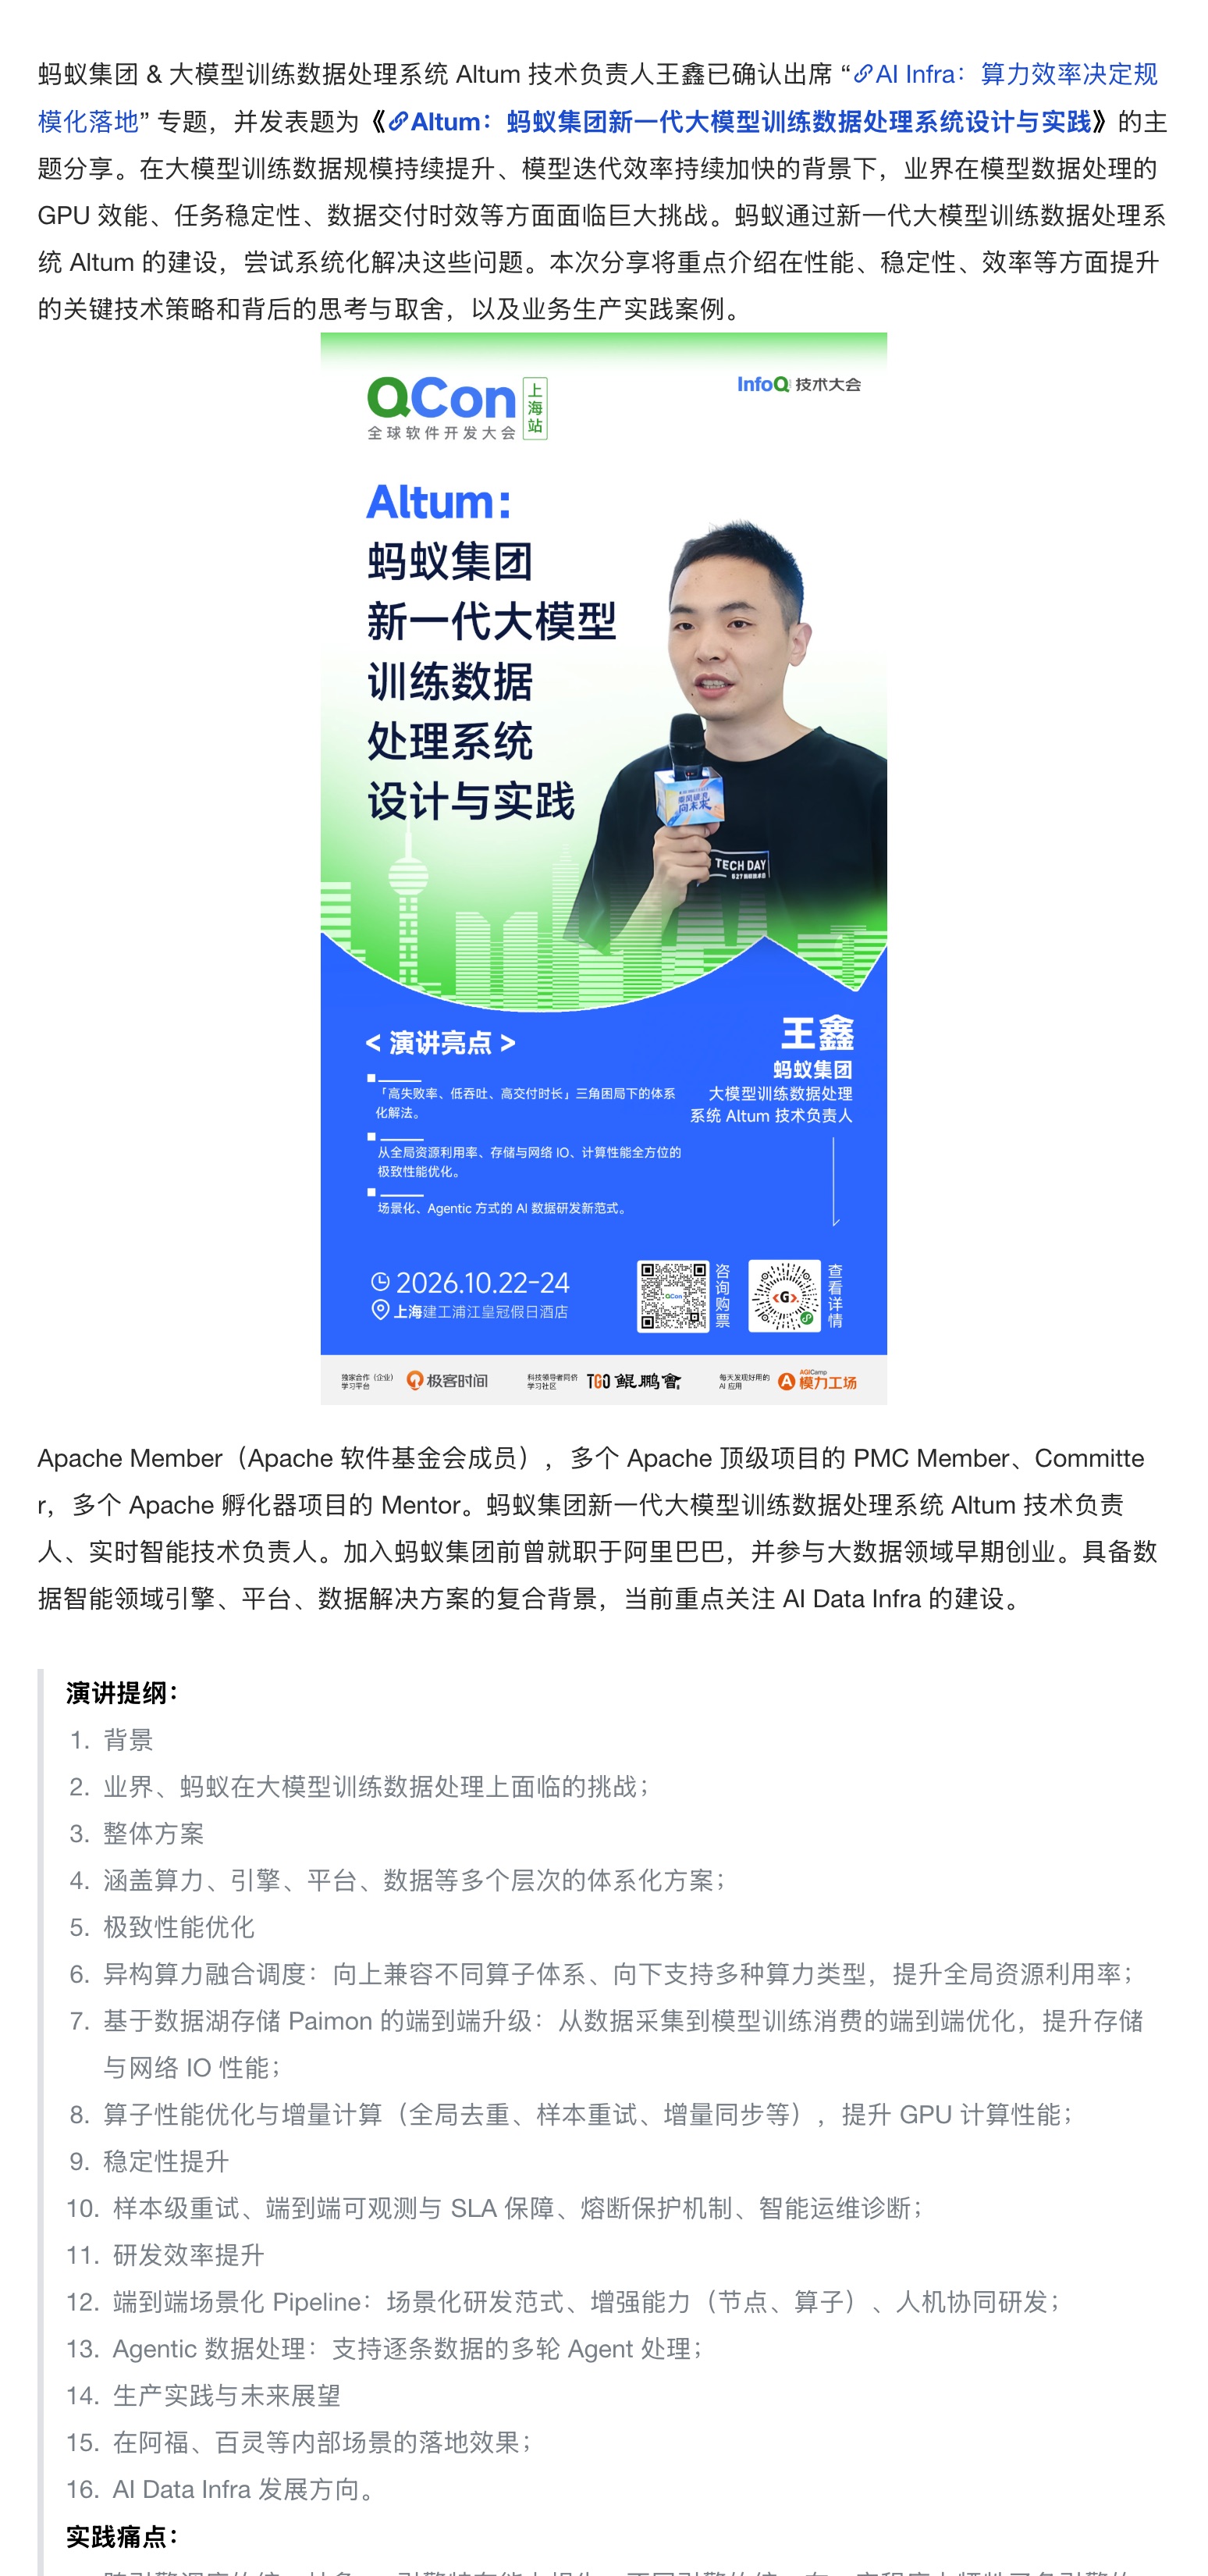
完整细节要等 2026 年 10 月 22 日至 24 日的 QCon 上海站 AI Infra 专题(官网),王鑫会分享《Altum:蚂蚁集团新一代大模型训练数据处理系统设计与实践》,最终内容以主办方与蚂蚁官方公告为准。
总结
10 月分享里建议重点听三件事:开源与开放计划、样本级重试的幂等怎么实现、对 Paimon 的改造有多少会进上游版本。
本文由 AI345 整理,最后更新于 2026 年 9 月。本文未使用 Altum 系统本身,全部信息来自上述公开来源。
常见问题
蚂蚁 Altum 是什么?
答:蚂蚁集团新一代大模型训练数据处理系统,负责训练前的数据加工,不是模型,也不对外售卖。
蚂蚁 Altum 是开源的吗?
答:目前没有公开的开源信息,议题页只把它描述为蚂蚁内部系统的建设实践。
Altum 和百灵大模型是什么关系?
答:Altum 处理训练数据,百灵(Ling、Ring、Ming)是用这些数据训练出来的模型。
Altum 为什么选择 Paimon?
答:Paimon 的实时更新与 Changelog 能力对应全局去重与增量同步。
 京ICP备2024094994号-29