
LLaDA-Image 是什么?蚂蚁开源 6B 图像生成编辑模型,跑分登顶开源第一
最后更新于 2026 年 9 月 4 日 · 作者:AI345 AI 指南编辑部
LLaDA-Image 是蚂蚁集团 inclusionAI 团队于 2026 年 9 月 4 日开源的 6B 参数统一图像生成与编辑模型:一个模型同时搞定文生图和指令修图,在 Qwen-Image-Bench 上拿到 53.53(英文榜)/ 53.38(中文榜)的综合得分,是目前开源图像模型的双榜第一。本文用 6 分钟讲清它的核心能力、跑分、安装方法和常见问题。
本文目录
- LLaDA-Image 是什么?
- 版本与下载:Base、Turbo、FP8 怎么选
- 三大亮点:为什么值得关注
- 跑分对比:Qwen-Image-Bench 开源第一
- LLaDA-Image 安装教程:从下载到出图
- 生成与编辑效果参考
- 与 GPT Image 2 等模型对比
- 常见问题 FAQ
LLaDA-Image 是什么?
LLaDA-Image 是蚂蚁集团开源的 6B 参数统一图像生成与编辑模型家族,官方在 2026 年 9 月 4 日同时放出了 Base(50 步)和 Turbo(4 步)两组模型权重,以及基于 Diffusers 的推理代码;训练代码也在开源计划中(官方 GitHub 仓库、arXiv 技术报告、HuggingFace 模型页)。
它由两个核心部分组成:
- 6B Diffusion Transformer(DiT):从零开始训练的扩散图像模型,负责生成与编辑
- 冻结的视觉语言理解模块:基于蚂蚁自研的 LLaDA2.0-Mini 扩散语言模型骨干,负责"看懂"你的文字指令
一个模型、一套权重,覆盖四种任务:文生图、VQ 条件生成、参考图编辑、中英文文字渲染。以往"生成用 A 模型、修图用 B 模型"分开部署的方案,现在一个 checkpoint 全部搞定。
值得一提的是训练思路:官方没有一上来就堆图文配对数据,而是先通过纯图像预训练和中期训练建立视觉先验,再引入图文配对监督和生成-编辑联合训练。训练管线共 2.2 亿样本,其中约 9800 万为真实图像;全程使用无参数 RMSNorm 和 Muon 优化器来保证高效稳定。
版本与下载:Base、Turbo、FP8 怎么选
官方在 HuggingFace 上发布了 4 个版本:
| 模型 | 采样步数 | 定位 | 下载地址 |
|---|---|---|---|
| LLaDA-Image(Base) | 50 | 高保真文生图 + 指令编辑 | BF16 / FP8 |
| LLaDA-Image-Turbo | 4 | Twin-DMD 蒸馏,2-4 步快速出图 | BF16 / FP8 |
选择建议:
- 追求画质、用于正式生产 → 选 Base
- 追求速度、批量出图或做交互式产品 → 选 Turbo
- 显存紧张 → 选对应的 FP8 量化版
三大亮点:为什么值得关注
1. 生成与编辑统一在一个模型里。 一个 checkpoint 同时支持文生图和保留原图内容的指令编辑,不需要再分别部署"生成"和"编辑"两套模型,部署和推理成本直接减半。
2. 全 Diffusion 架构 + 完全开源的训练配方。 主干和 DiT 都是扩散模型,论文标题就叫《Building Strong Image Generators with Fully Open Training Recipes》——权重、训练代码、详细配方都将开源,在图像生成模型里相当少见,对研究和二次开发很友好。
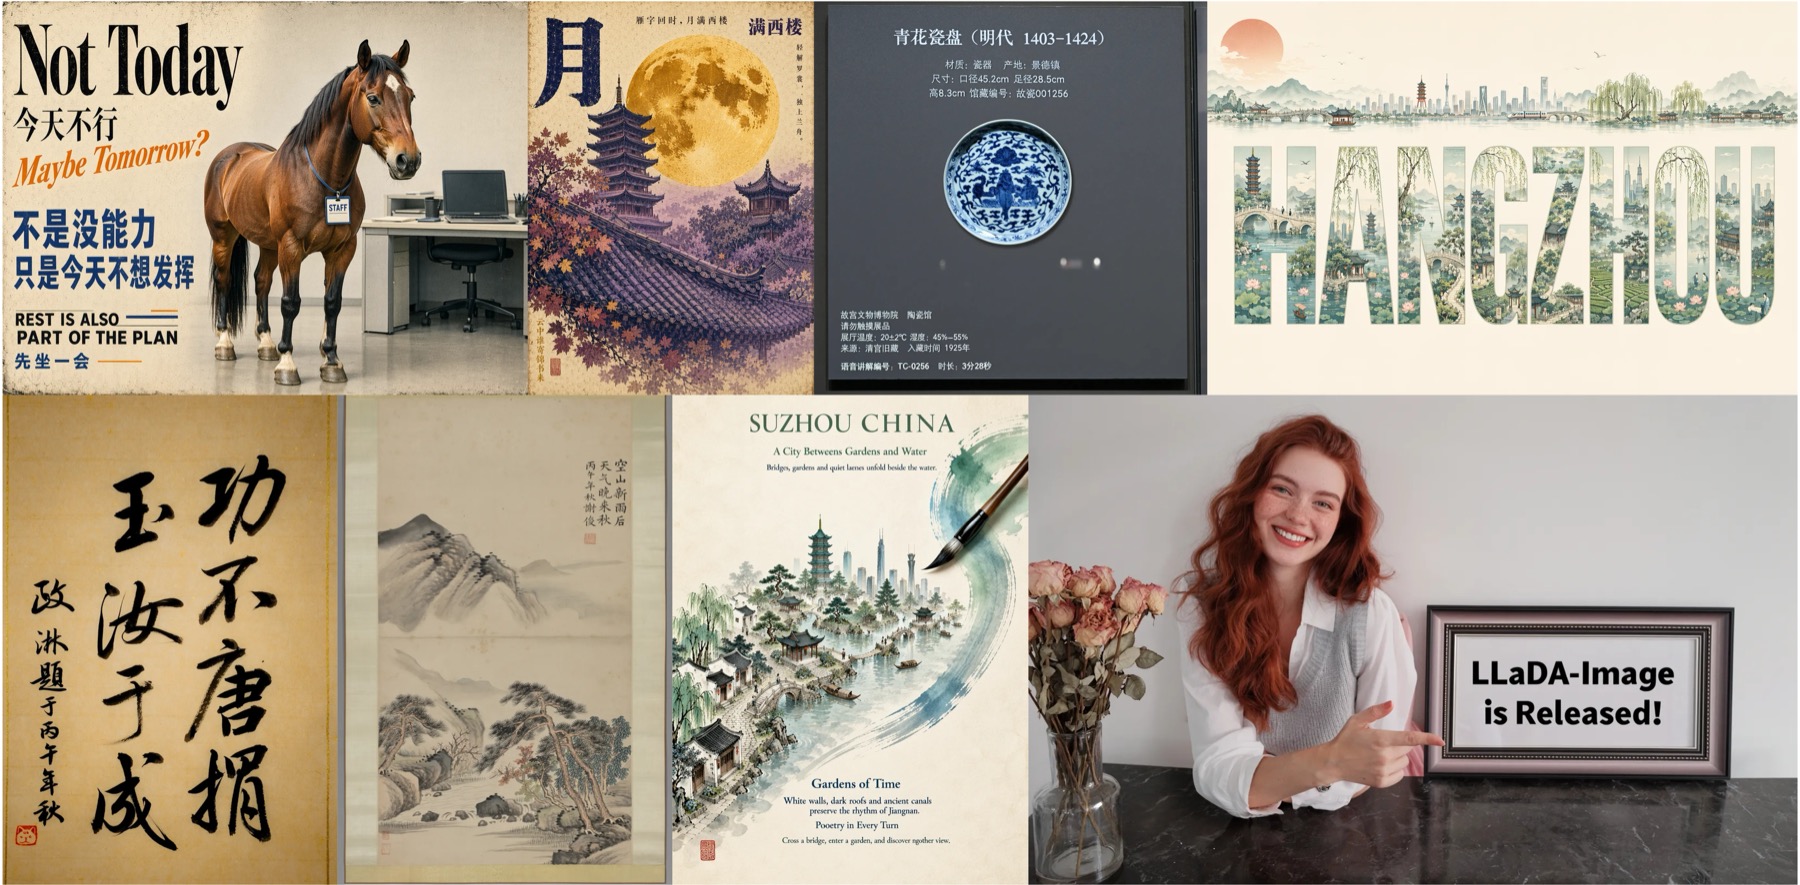
3. 中英文文字渲染。 从官方示例看,海报里的中文书法、英文大标题都能渲染得比较准确,对中文用户做海报、封面、营销配图是实打实的能力。
跑分怎么样?Qwen-Image-Bench 开源双榜第一
根据官方发布的评测数据,在 Qwen-Image-Bench 综合得分上,LLaDA-Image 英文榜 53.53 分、中文榜 53.38 分,超过 Z-Image Turbo、Boogu-Image 0.1 Turbo、HunyuanImage 3.0、SenseNova U1.5 Preview、GLM-Image 等开源模型,位列开源模型双榜第一。
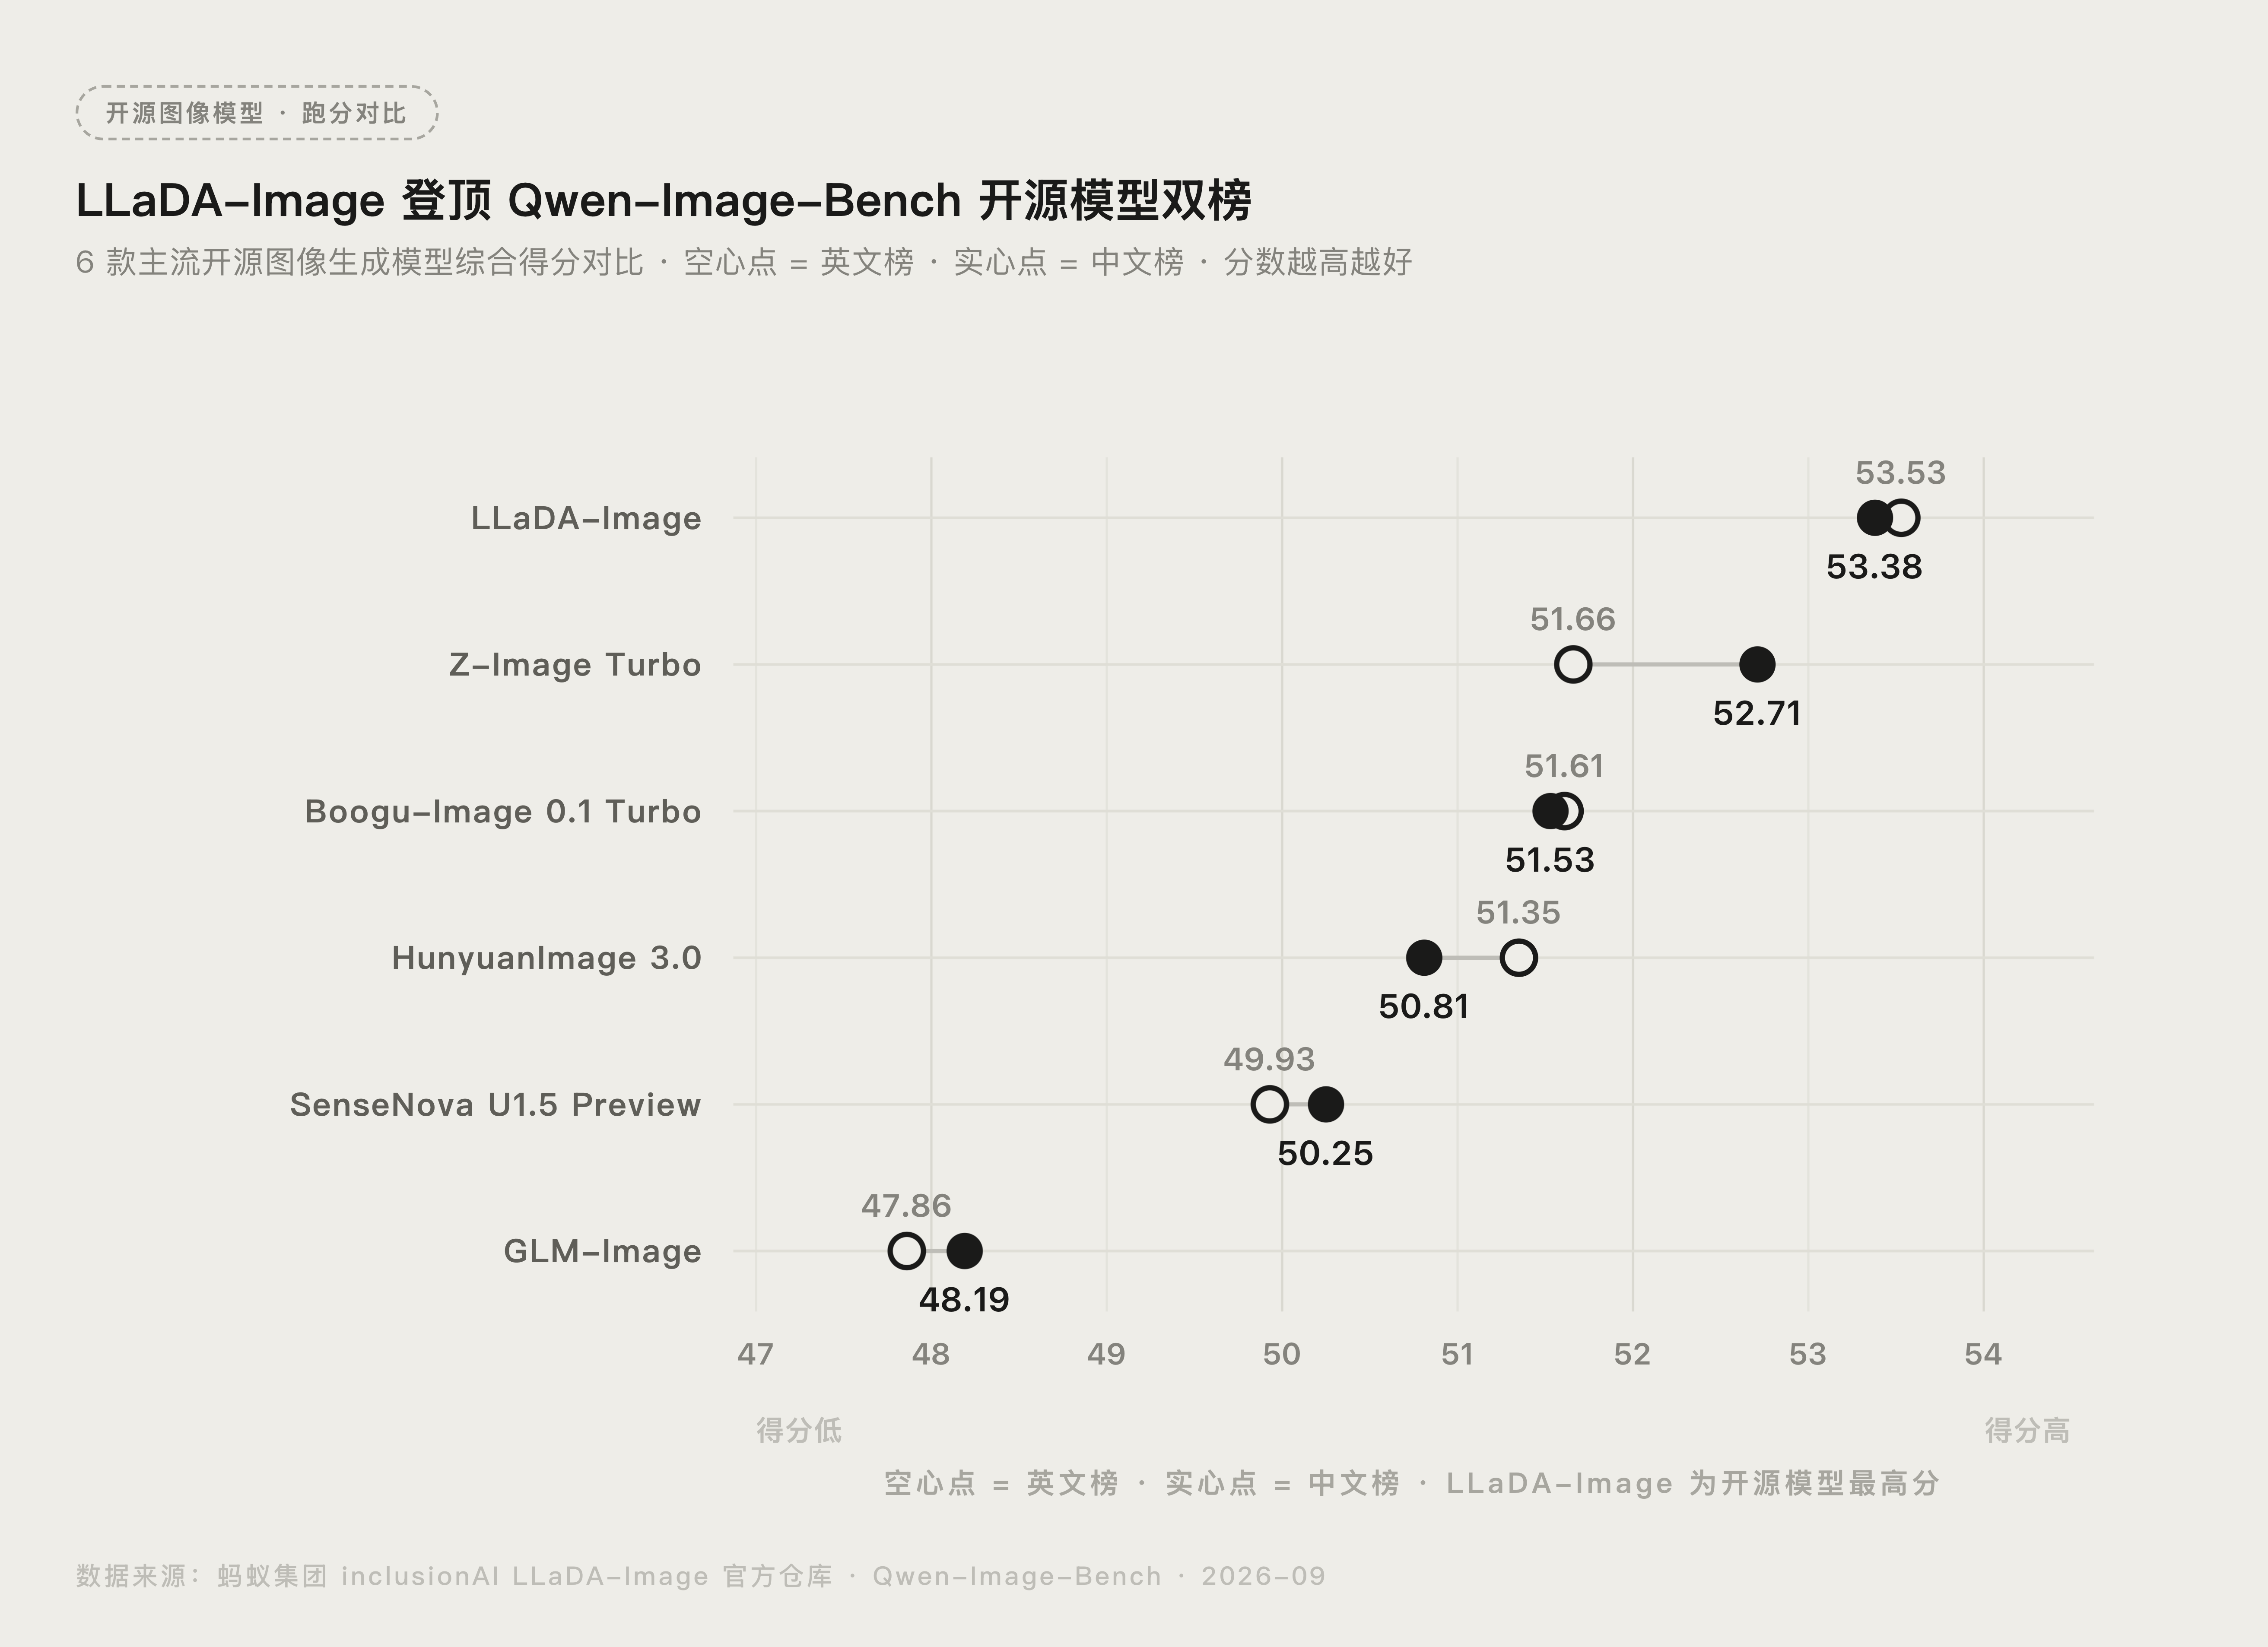
也要客观说明:与闭源旗舰相比仍有差距——GPT-Image 2 达到 65.23 / 64.69,Nano-Banana 2.0 为 59.59 / 59.82,Qwen-Image 2.0 Pro 为 57.90 / 57.84。一句话概括:LLaDA-Image 是"开源阵营里最能打的",但闭源头部模型依然领先 4-11 分。
LLaDA-Image 安装教程:从下载到出图
官方推荐环境:Python 3.11、PyTorch 2.8、Transformers 4.57.6、Diffusers 0.39.0,需要 NVIDIA CUDA 显卡。
第一步:创建环境并安装依赖
git clone https://github.com/inclusionAI/LLaDA-Image.git
cd LLaDA-Image
conda create -n llada-image python=3.11 -y
conda activate llada-image
pip install -r requirements.txt
第二步:文生图(Base 版,50 步采样)
首次运行会自动从 HuggingFace 下载权重:
import torch
from src import LLaDAImagePipeline

pipe = LLaDAImagePipeline.from_pretrained(
    "inclusionAI/LLaDA-Image",
    torch_dtype=torch.bfloat16,
    device="cuda",
)
image = pipe(
    prompt="A cinematic photograph of a red fox standing in fresh snow",
    generation_mode="text",
    height=1024, width=1024,
    num_inference_steps=50,
    guidance_scale=5.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("llada-image-base.png")
第三步:指令修图(传入参考图)
from diffusers.utils import load_image

reference_image = load_image("/path/to/input.png")
image = pipe(
    prompt="Turn it into a watercolor painting",
    image=reference_image,
    generation_mode="editing",
    height=1024, width=1024,
    num_inference_steps=50,
    guidance_scale=5.0,
).images[0]
上手注意两个容易踩的坑(官方 README 写了,但很容易忽略):
- 尺寸必须整除:文生图和 VQ 生成的宽高要能被 16 整除;图像编辑要能被 32 整除,否则会报错
- 步数与引导系数要配套:Turbo 版要用
num_inference_steps=4且guidance_scale=1.0,照搬 Base 的 50 步 / 5.0 配置效果会异常
生成与编辑效果参考
以下效果图为官方发布示例(非本站实测),先看写实生成能力:
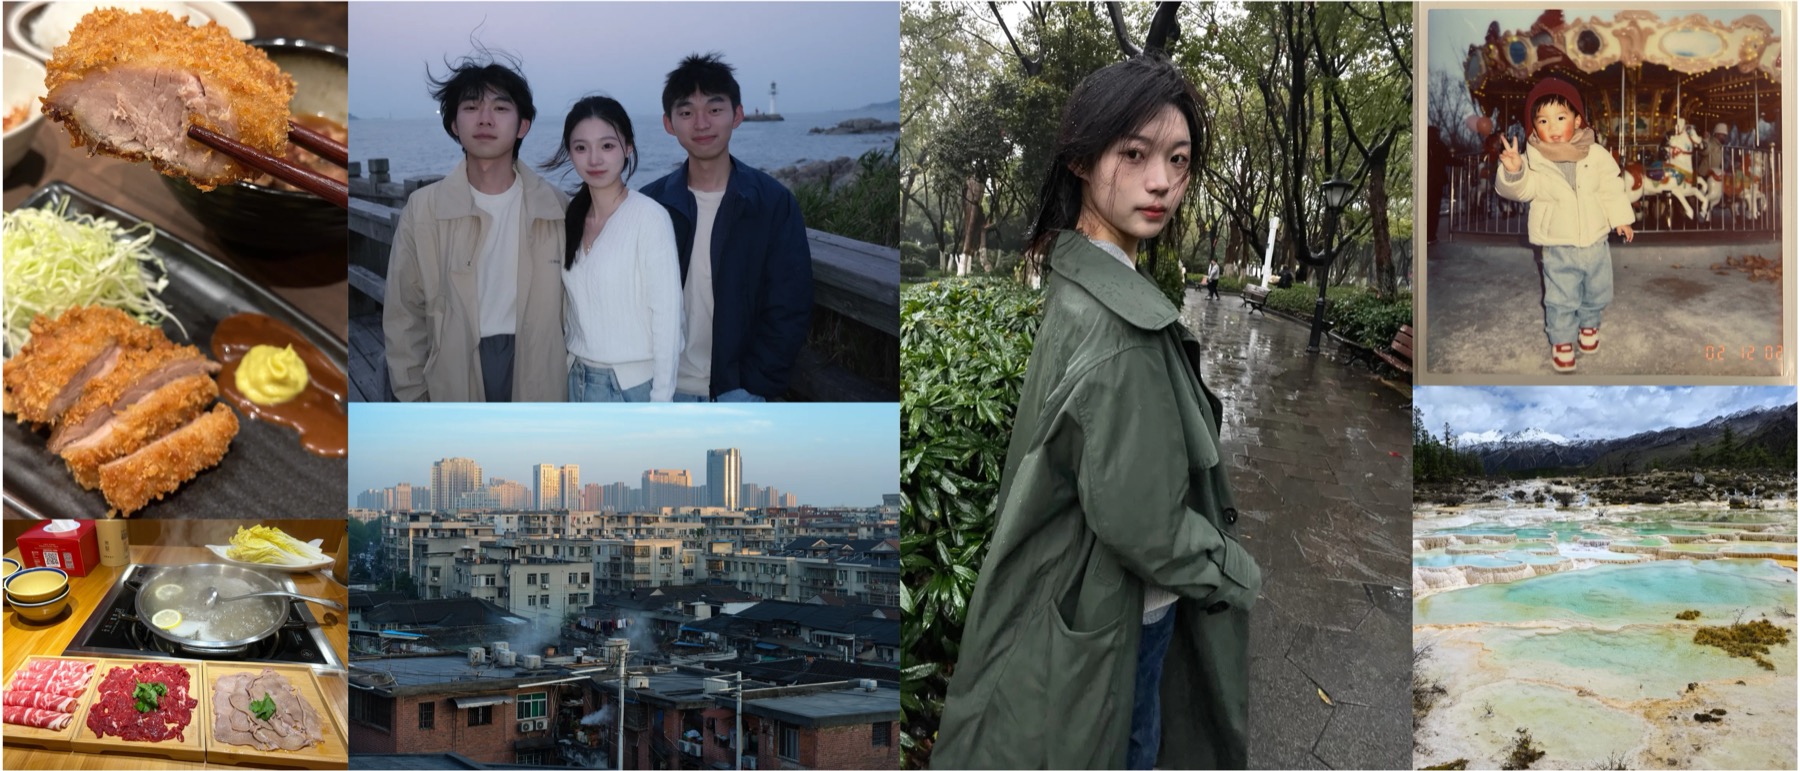
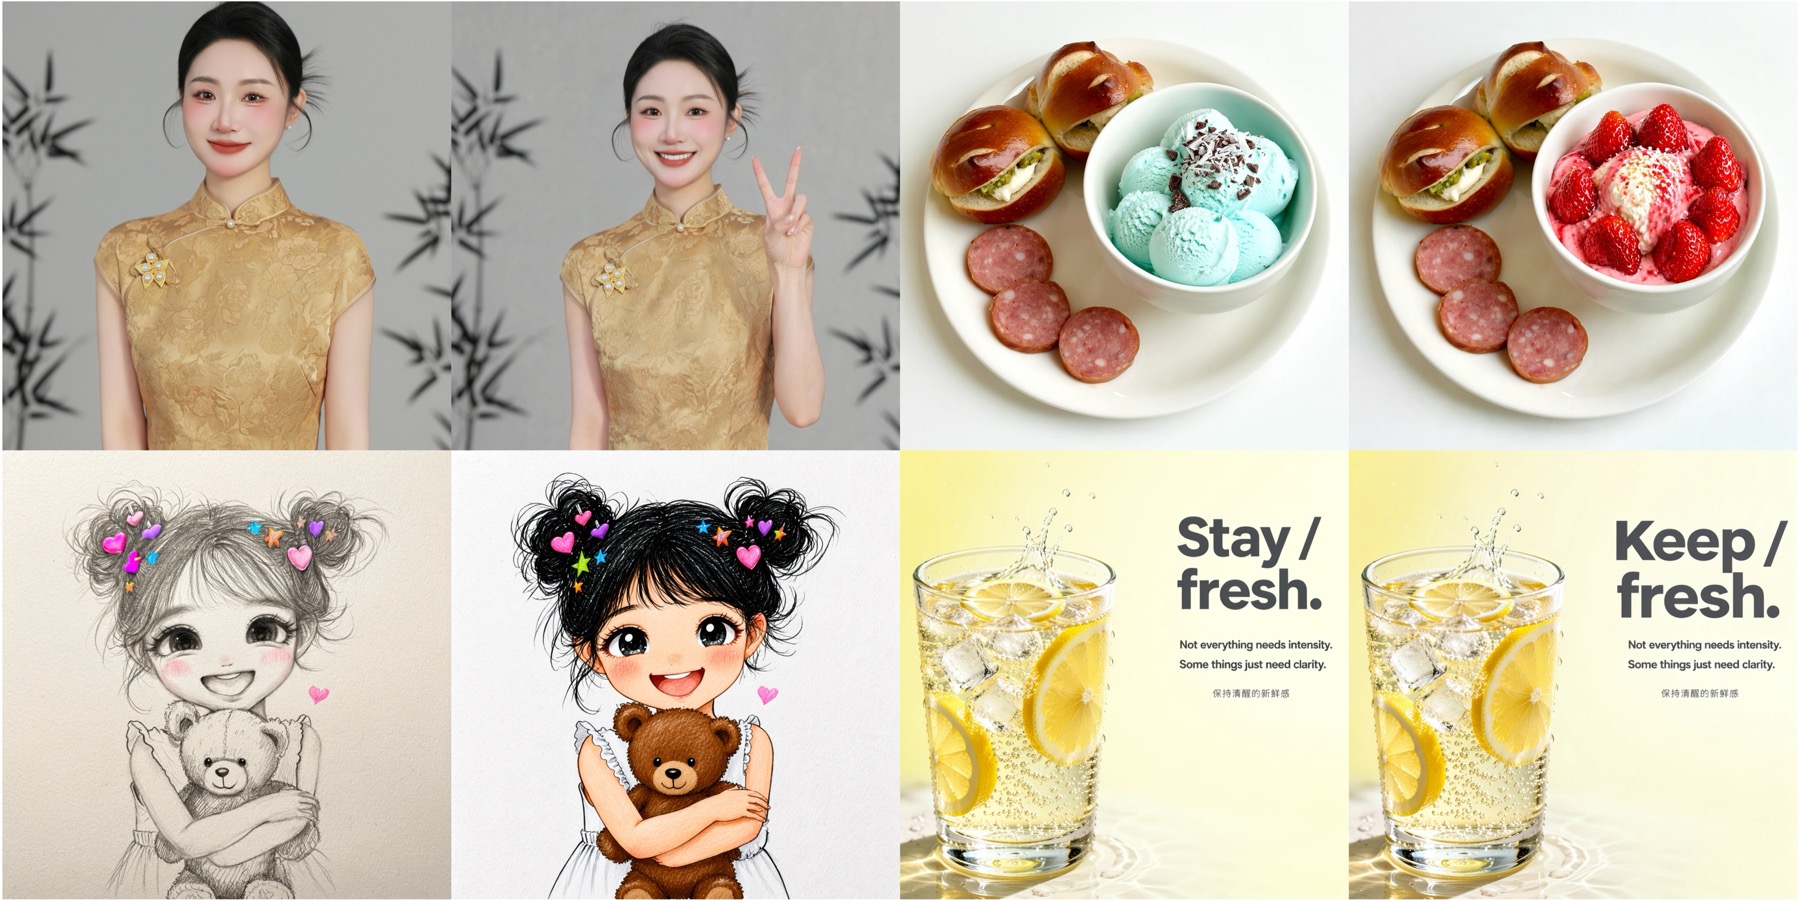
人像、食物、城市风光的质感和光影都比较自然。再看指令编辑能力,覆盖素描上色、局部替换、海报改字等场景:
与 GPT Image 2 等模型对比
把官方评测图中的主要模型整理成表:
| 模型 | 是否开源 | 英文榜得分 | 中文榜得分 |
|---|---|---|---|
| GPT-Image 2 | 否 | 65.23 | 64.69 |
| Nano-Banana 2.0 | 否 | 59.59 | 59.82 |
| Qwen-Image 2.0 Pro | 否 | 57.90 | 57.84 |
| Seedream 5.0 | 否 | 57.80 | 57.22 |
| FLUX.2 Max | 否 | 56.14 | 55.33 |
| LLaDA-Image | ✅ 是 | 53.53 | 53.38 |
| Z-Image Turbo | ✅ 是 | 51.66 | 52.71 |
| HunyuanImage 3.0 | ✅ 是 | 51.35 | 50.81 |
结论:要最强效果且预算充足,闭源旗舰仍是首选;如果要私有化部署、二次训练或控制成本,LLaDA-Image 是当前开源阵营的第一梯队。关于闭源模型的详细解读,可以看我们之前的 GPT Image 2 是什么?OpenAI 新图像模型详解。
想自己部署开源模型,也可以参考 Qwen3.8-27B 本地部署指南:16G 内存 Mac 也能跑,环境配置的思路是相通的;对国产开源多模态模型感兴趣,还可以看 WeMM-Embedding:微信开源多模态嵌入模型全解。
总结
LLaDA-Image 的意义不止于"又多了一个文生图模型":中国团队把「统一生成与编辑 + 完全开源训练配方」这条路线跑通了——6B 的体量对部署友好,Turbo 版 4 步出图对产品化友好,开源双榜第一的成绩对开发者社区有足够吸引力。如果你正想为团队找一个可私有化、可二次开发的图像生成底座,值得现在就上手试试。
有问题或部署中踩了坑,欢迎在评论区留言交流。
常见问题
LLaDA-Image 是免费的吗?可以商用吗?
答:模型权重已在 HuggingFace 完全公开、可自由下载。不过截至本文更新(2026 年 9 月 4 日),官方 GitHub 仓库暂未附带 LICENSE 许可证文件,个人学习和研究没问题,商用前建议持续关注仓库的许可说明更新。
LLaDA-Image 需要多少显存?我的电脑能跑吗?
答:官方暂未公布最低显存要求。按 6B 参数量估算,BF16 权重约占 12GB 显存,FP8 版本约为其一半,一般建议 16GB 及以上显存的 NVIDIA 显卡。普通轻薄本跑不动,可以关注社区的量化版本或后续的在线体验入口。
Base 和 Turbo 版本应该选哪个?
答:看场景。Base 版 50 步采样,画质上限更高,适合对质量要求高的生产场景;Turbo 版经 Twin-DMD 蒸馏只需 2-4 步出图,速度快一个量级,适合批量出图和交互式产品。注意 Turbo 要搭配 `guidance_scale=1.0` 使用。
LLaDA-Image 和 LLaDA、LLaDA 2.0 是什么关系?
答:LLaDA 是中国人民大学高瓴人工智能学院与蚂蚁集团在 2025 年 2 月发布的扩散大语言模型,LLaDA 2.0 是其后续系列。LLaDA-Image 是蚂蚁 inclusionAI 在同一技术脉络下推出的图像生成模型,它的文本理解模块就建立在 LLaDA2.0-Mini 骨干之上。
LLaDA-Image 和 GPT Image 2 哪个好?
答:论绝对效果,GPT-Image 2 在 Qwen-Image-Bench 上领先约 11 分,闭源旗舰仍更强。但 LLaDA-Image 开源、可自部署、可二次开发,且综合得分是开源第一。要最强效果选闭源 API,要可控和低成本选 LLaDA-Image。
LLaDA-Image 支持中文提示词吗?
答:支持。模型官方标注支持中英双语,且具备中英文文字渲染能力,中文海报和中文提示词是主打场景之一;中文榜得分(53.38)与英文榜(53.53)基本持平,说明两种语言的能力没有明显偏科。
 京ICP备2024094994号-29