
Ling 3.0 Flash VL 是什么?蚂蚁百灵多模态新模型解读
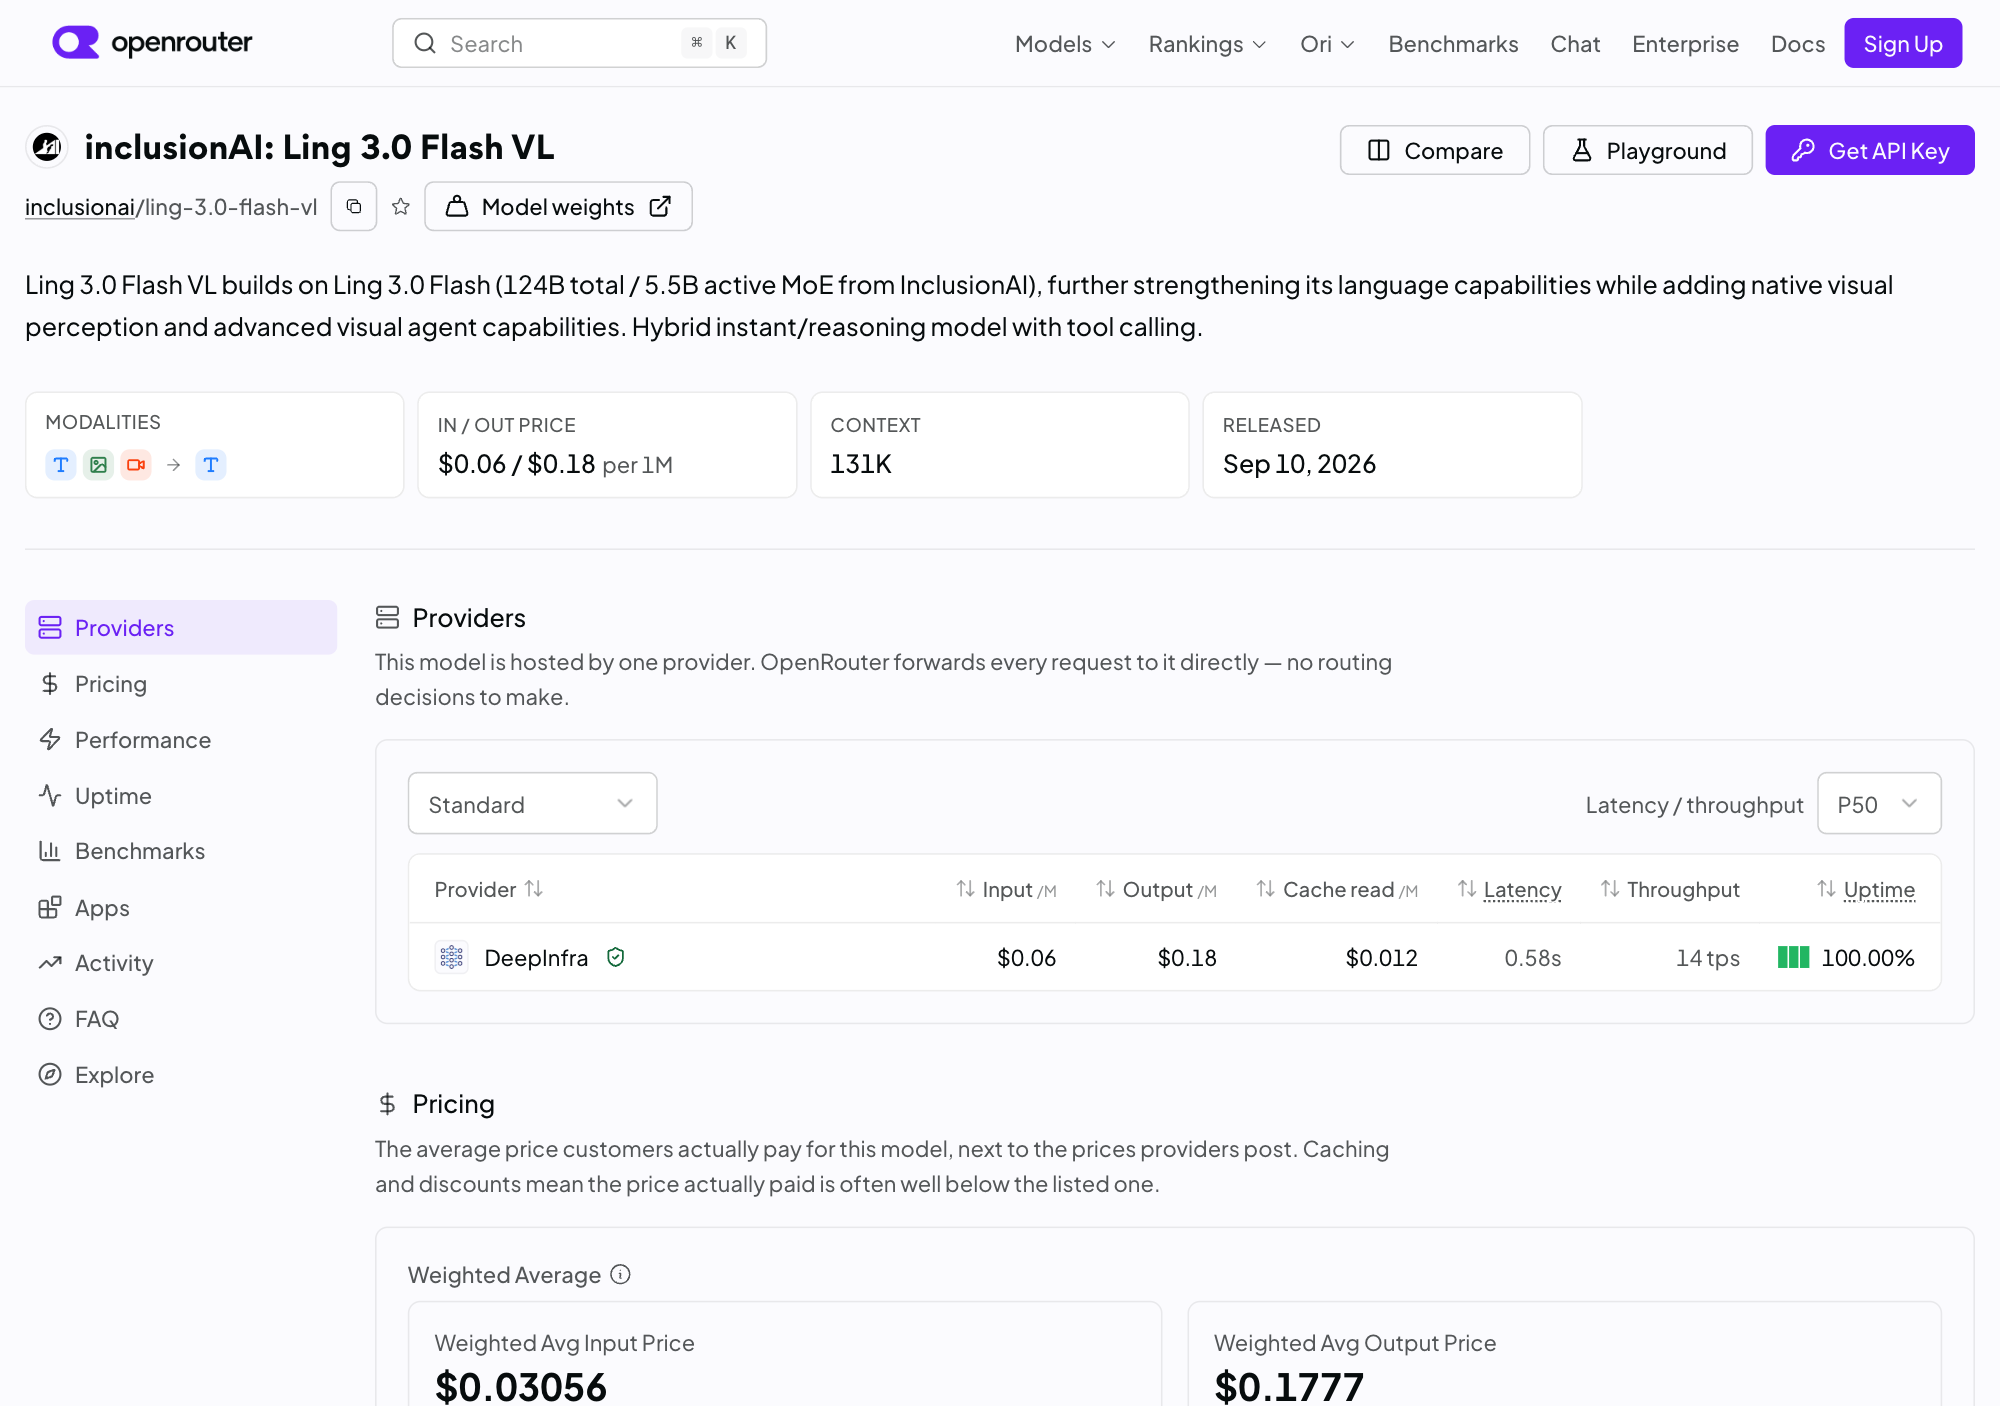
Ling 3.0 Flash VL 是蚂蚁集团 InclusionAI 团队 2026 年 9 月 10 日发布的原生多模态开源模型,在百灵 Ling 3.0 Flash 的基础上加了原生视觉感知能力,输入价格 0.06 美元每百万 token,权重已开放下载。想在 Agent 或业务里加图像理解的开发者,这篇讲清它的参数、跑分和上手路径。
Ling 3.0 Flash VL 是什么
它出自蚂蚁集团的开源团队 InclusionAI,底座是 Ling 3.0 Flash:总参数 124B、每 token 激活 5.5B 的 MoE 架构。VL 版本新增了原生视觉感知和视觉 Agent 能力,官方描述里它是混合即时/推理模型,支持工具调用。
「原生」的含义:图像在训练阶段就和文本一起进模型,不靠外挂视觉编码器中转,看图、读截图时不需要再单独调一个视觉模型。
关键参数一览(2026 年 9 月 16 日核实)
以下数据来自 OpenRouter 模型页:
| 项目 | 数值 |
|---|---|
| 发布时间 | 2026 年 9 月 10 日 |
| 架构 | 124B 总参 / 5.5B 激活 MoE |
| 上下文 | 131K token |
| 输入 / 输出价格 | $0.06 / $0.18 每百万 token |
| 缓存读取 | $0.012 / 百万 token |
目前由 DeepInfra 托管,实测吞吐 P50 约 30 tok/s,上线不到一周可用性维持在 99.8% 以上;上线初期性能波动属于常态,生产接入前先看模型页的 Performance 曲线。
跑分与工程稳定性
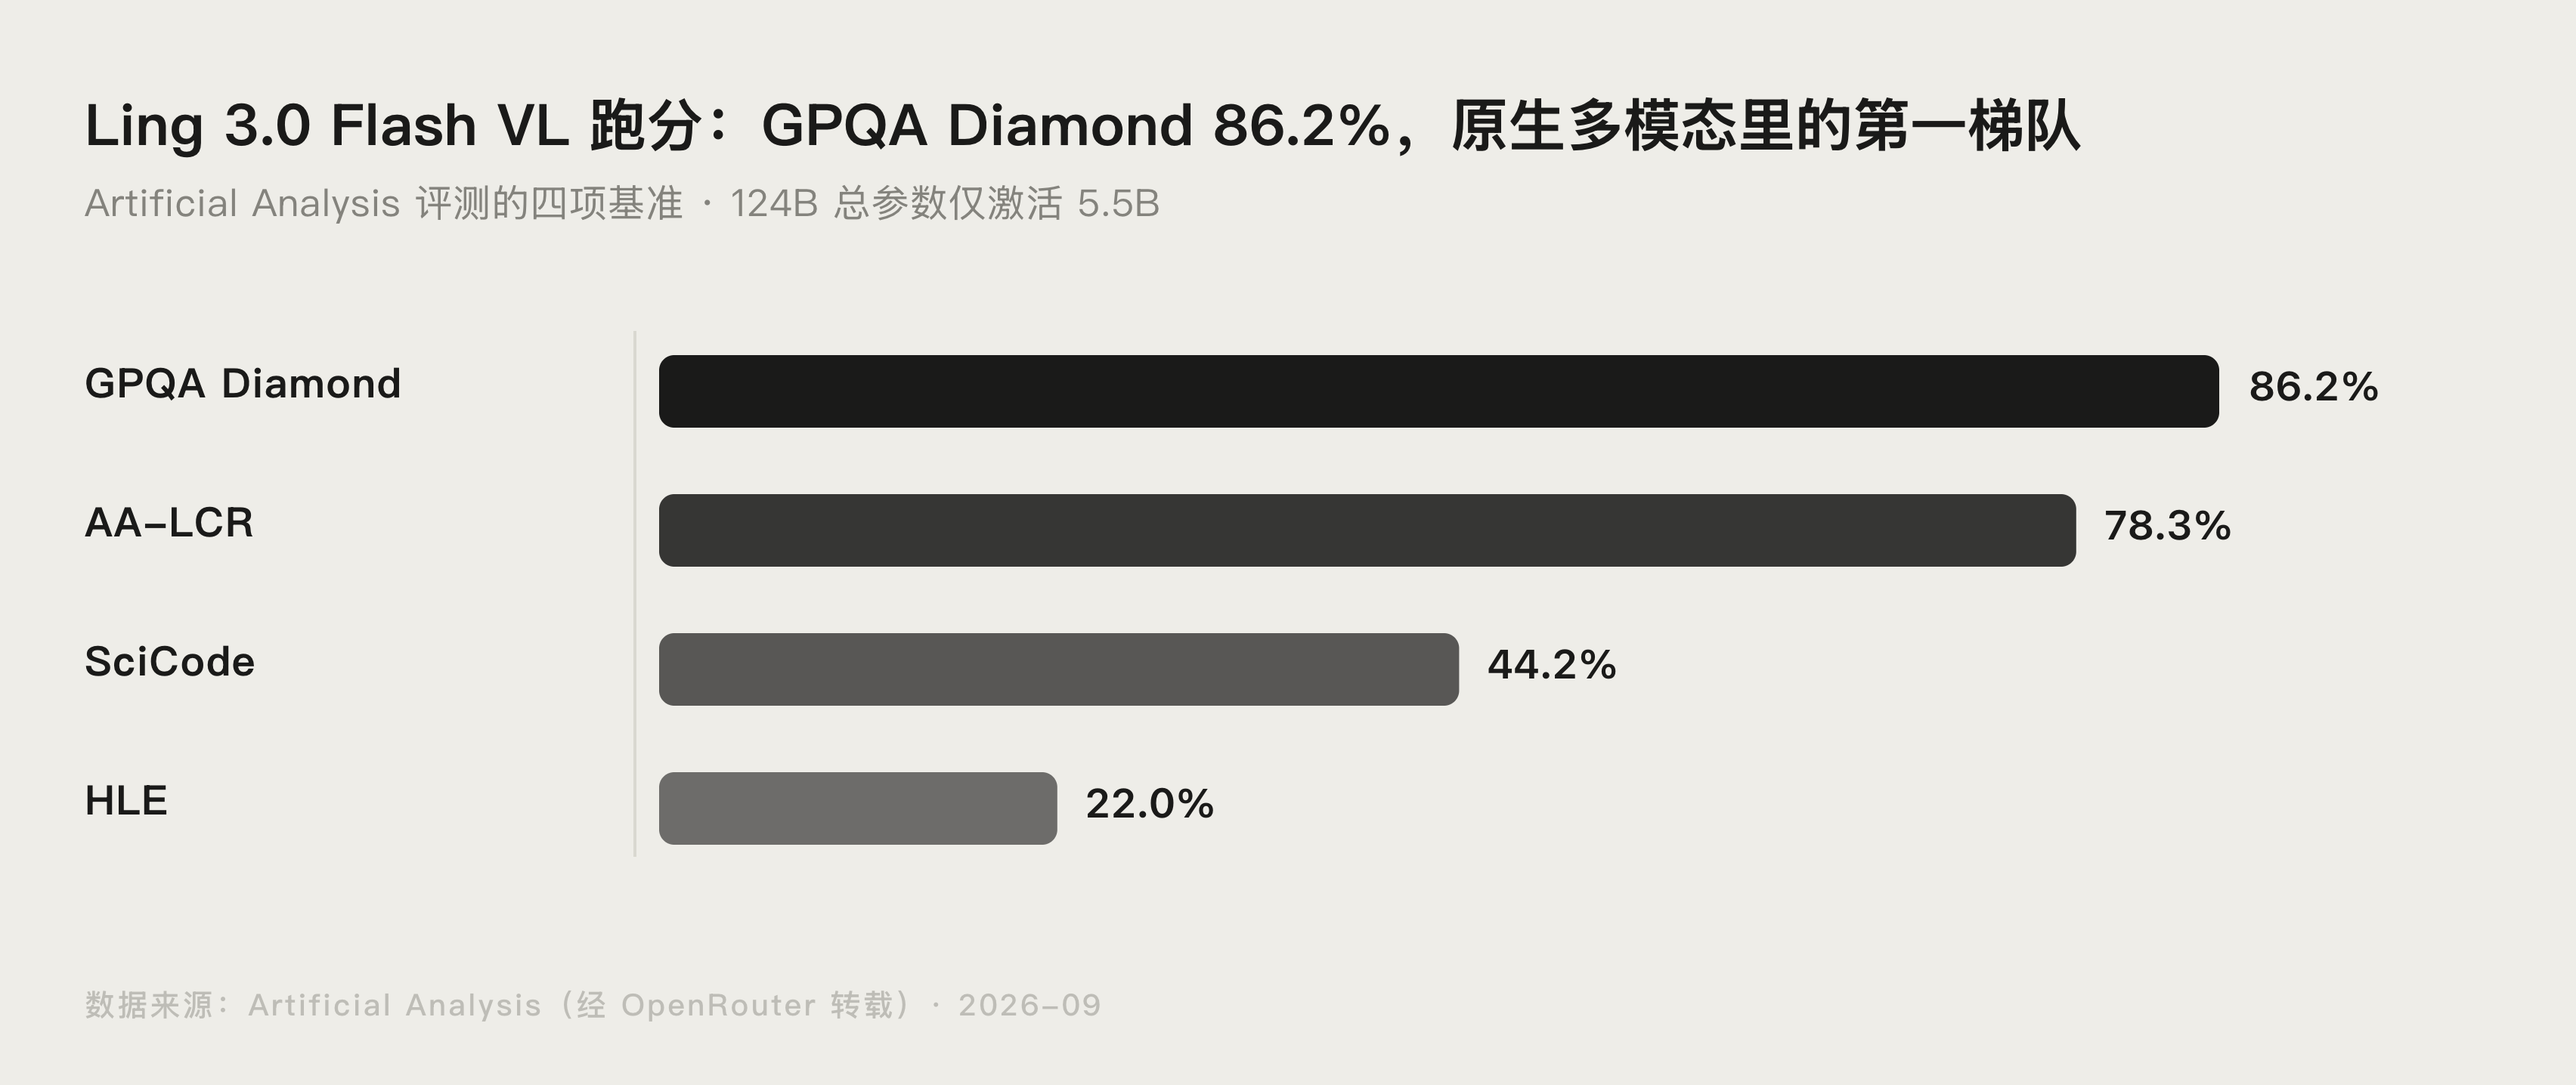
Artificial Analysis 口径:Intelligence Index 25.0,Coding Index 57.0,GPQA Diamond 86.2%,AA-LCR 78.3%,SciCode 44.2%。读法是:科学问答(GPQA)表现突出,编码是相对强项,综合智能处在 OpenRouter 全模型中位附近。
工程侧两个数字更值得 Agent 开发者注意:工具调用错误率约 5.08%,结构化输出错误率约 8.36%,接进工作流前建议配 schema 校验和重试,工具调用的原理可以参考这篇 Function Calling 是什么?一次讲透工具调用。
和 Fin、Sante 是什么关系
百灵 3.0 Flash 家族现在有三个衍生型号,定位互不相同,别混着选:
| 型号 | 定位 | 上下文 | OpenRouter 价格 |
|---|---|---|---|
| Ling 3.0 Flash VL | 原生多模态(看图) | 131K | $0.06 / $0.18 |
| Ling-3.0-flash-Fin | 金融行业版 | 以官方页为准 | 有免费额度,见站内教程 |
| Ling 3.0 Flash Sante | 医疗行业版 | 262K | 有免费档 |
后缀命名的规律我们在 模型版本号怎么读?Preview、Flash 等后缀一次讲透 里拆过,Flash、VL 这类后缀都是同一个逻辑。
适合谁,怎么第一时间用上
- 适合:想在 Agent 里加图像理解、预算敏感的团队;需要中文友好的开源多模态模型做私有化部署的开发者。不适合追求旗舰级视觉推理的任务,以及对调用错误率零容忍的线上关键链路。
- 最快路径:注册 OpenRouter,把 model 换成 inclusionai/ling-3.0-flash-vl,接口 OpenAI 兼容,现有代码几乎零改动。
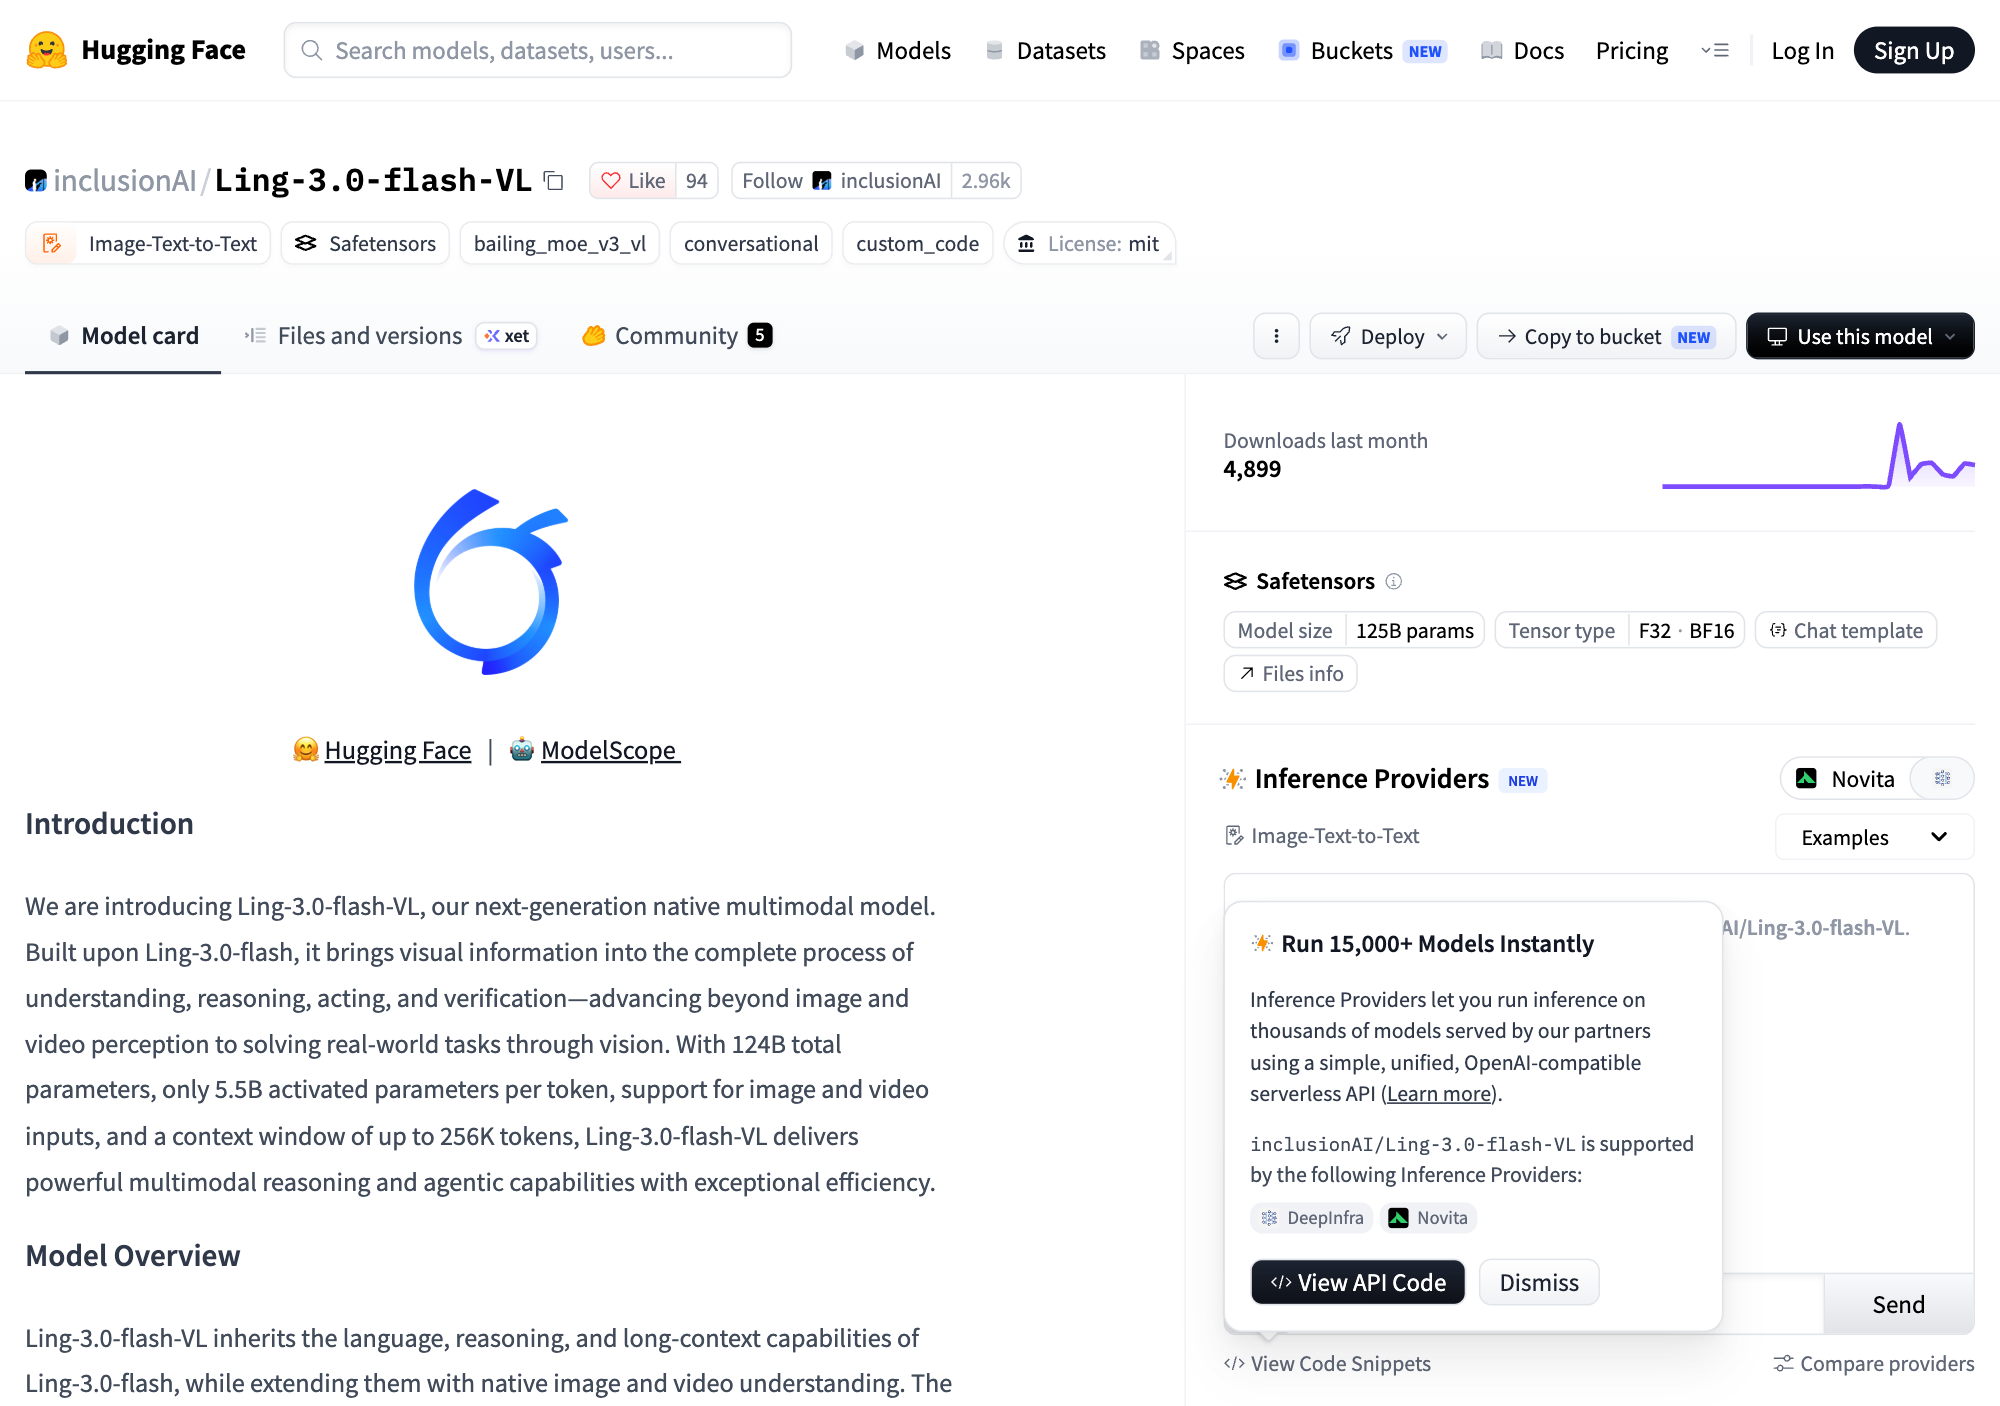
- 私有化路径:去 Hugging Face 下载 inclusionAI/Ling-3.0-flash-VL 权重本地部署,无订阅费;也可以先在模型页 Playground 传图试玩,验证场景再接。
同家族金融版的免费 API 领取步骤,见这篇 蚂蚁百灵 Ling-3.0-flash-Fin 免费 API 领取:接入教程与实测(2026);选型时想横向对比国产模型,可以看 DeepSeek V4.1 Flash 和 V4 Pro 怎么选?价格、速度、能力对比(2026)。
常见问题
Ling 3.0 Flash VL 是免费的吗?
答:权重免费开放下载,自部署零订阅费;API 按量计费,当前输入 $0.06、输出 $0.18 每百万 token。
原生多模态和普通视觉模型有什么区别?
答:原生多模态在训练阶段就把图像和文本一起学,不靠外挂编码器中转,链路短一层,误差也少一层。
它能识别中文图片和文档吗?
答:官方没有中文专项评测,建议在 Playground 用你自己的中文截图实测后再决定。
VL、Fin、Sante 三个型号怎么选?
答:看图选 VL,金融业务选 Fin,医疗方向选 Sante,不要用行业版去干多模态的活。
上下文 131K 够用吗?
答:约等于一次读几万字图文混合输入,覆盖大多数截图和中等长度文档场景,超长文档先分段。
 京ICP备2024094994号-29