
小米 CocktailASR-1 免费吗:开源协议与商用边界
免费。小米 CocktailASR-1 以 Apache License 2.0 协议开源,模型权重放在 HuggingFace 公开下载,个人和商用都可以免费用,不需要 API Key、不按次计费。你要付出的只有本地跑推理的显卡算力。本文说清入口在哪、免费到什么程度、模型值不值得下。
正确入口:GitHub 和 HuggingFace
两个入口都是官方的:
- GitHub 仓库:xiaomi-research/xiaomi-cocktailasr-1,项目说明、批量推理脚本、正负样本示例音频都在这,仓库采用 Apache-2.0 许可证。
- HuggingFace 权重:Ease3/Xiaomi-CocktailASR-1,模型定义代码和全部权重发布在这里,无需申请、无审核、无配额。
搜索时注意别认错:这是小米研究团队(xiaomi-research 组织)发布的「目标说话人语音识别」模型,不是小米手机内置的语音助手功能。
免费到什么程度:三层拆开看
- 代码免费:GitHub 仓库 LICENSE 明确为 Apache License 2.0,属于对商用最友好的开源协议之一。
- 权重免费:HuggingFace 直接下载,官方 README 写明模型定义代码与权重都发布在 HuggingFace。
- 商用允许:Apache 2.0 允许商业使用,条件是保留版权声明和许可证副本,修改过的文件需要标注变更。
但要分清「免费」不等于零成本:官方目前没有提供免费的在线 API 或网页试玩,你需要自己准备算力跑推理。官方示例代码用 CUDA 和 bfloat16 加载,意味着需要一张 NVIDIA 显卡。想了解本地跑大模型的硬件门槛,先看站内这篇端侧 AI 是什么。
它是个什么模型,值不值得下
CocktailASR-1 是目标说话人语音识别大模型:给它一段参考音频,它只转录参考说话人说的内容,自动忽略其他人。三个能力让它和普通 ASR 拉开差距:
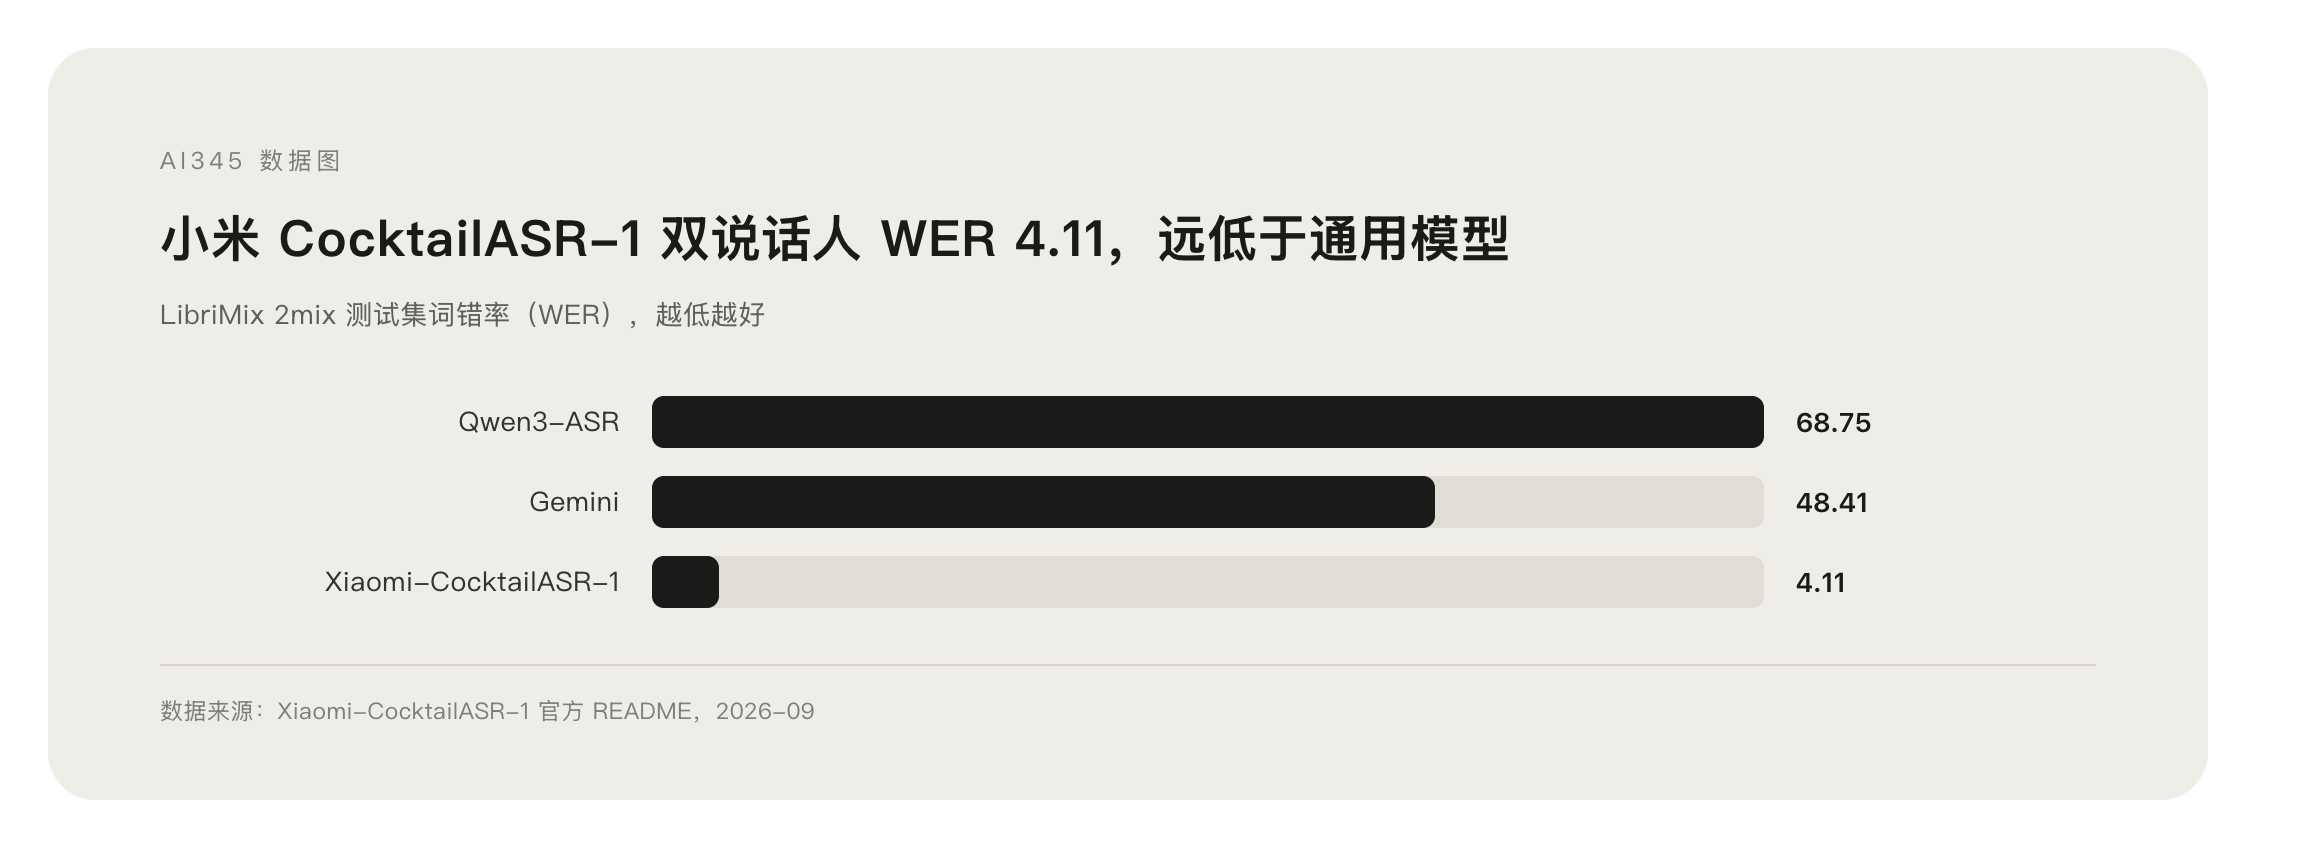
- 多说话人场景达到 SOTA:官方 README 数据,LibriMix 2mix 测试集词错率(WER)4.11%,同表 Qwen3-ASR 为 68.75%、Gemini 为 48.41%。
- 负样本拒识:参考说话人不在音频里时输出空结果,README 实测拒识率在 LibriSpeech 负样本集上为 79.59%,能显著降低误触发。
- 思维链推理:CoT 模式会在标签里给出可解释的推理过程,最终结果单独输出。
单说话人场景也不弱:LibriSpeech 上 WER 1.73%,和主流单人 ASR 模型同档。一句话,会议转写、多人对话字幕这类「只关注一个人」的需求,它是当前开源里的第一梯队。
怎么跑起来:最小三步
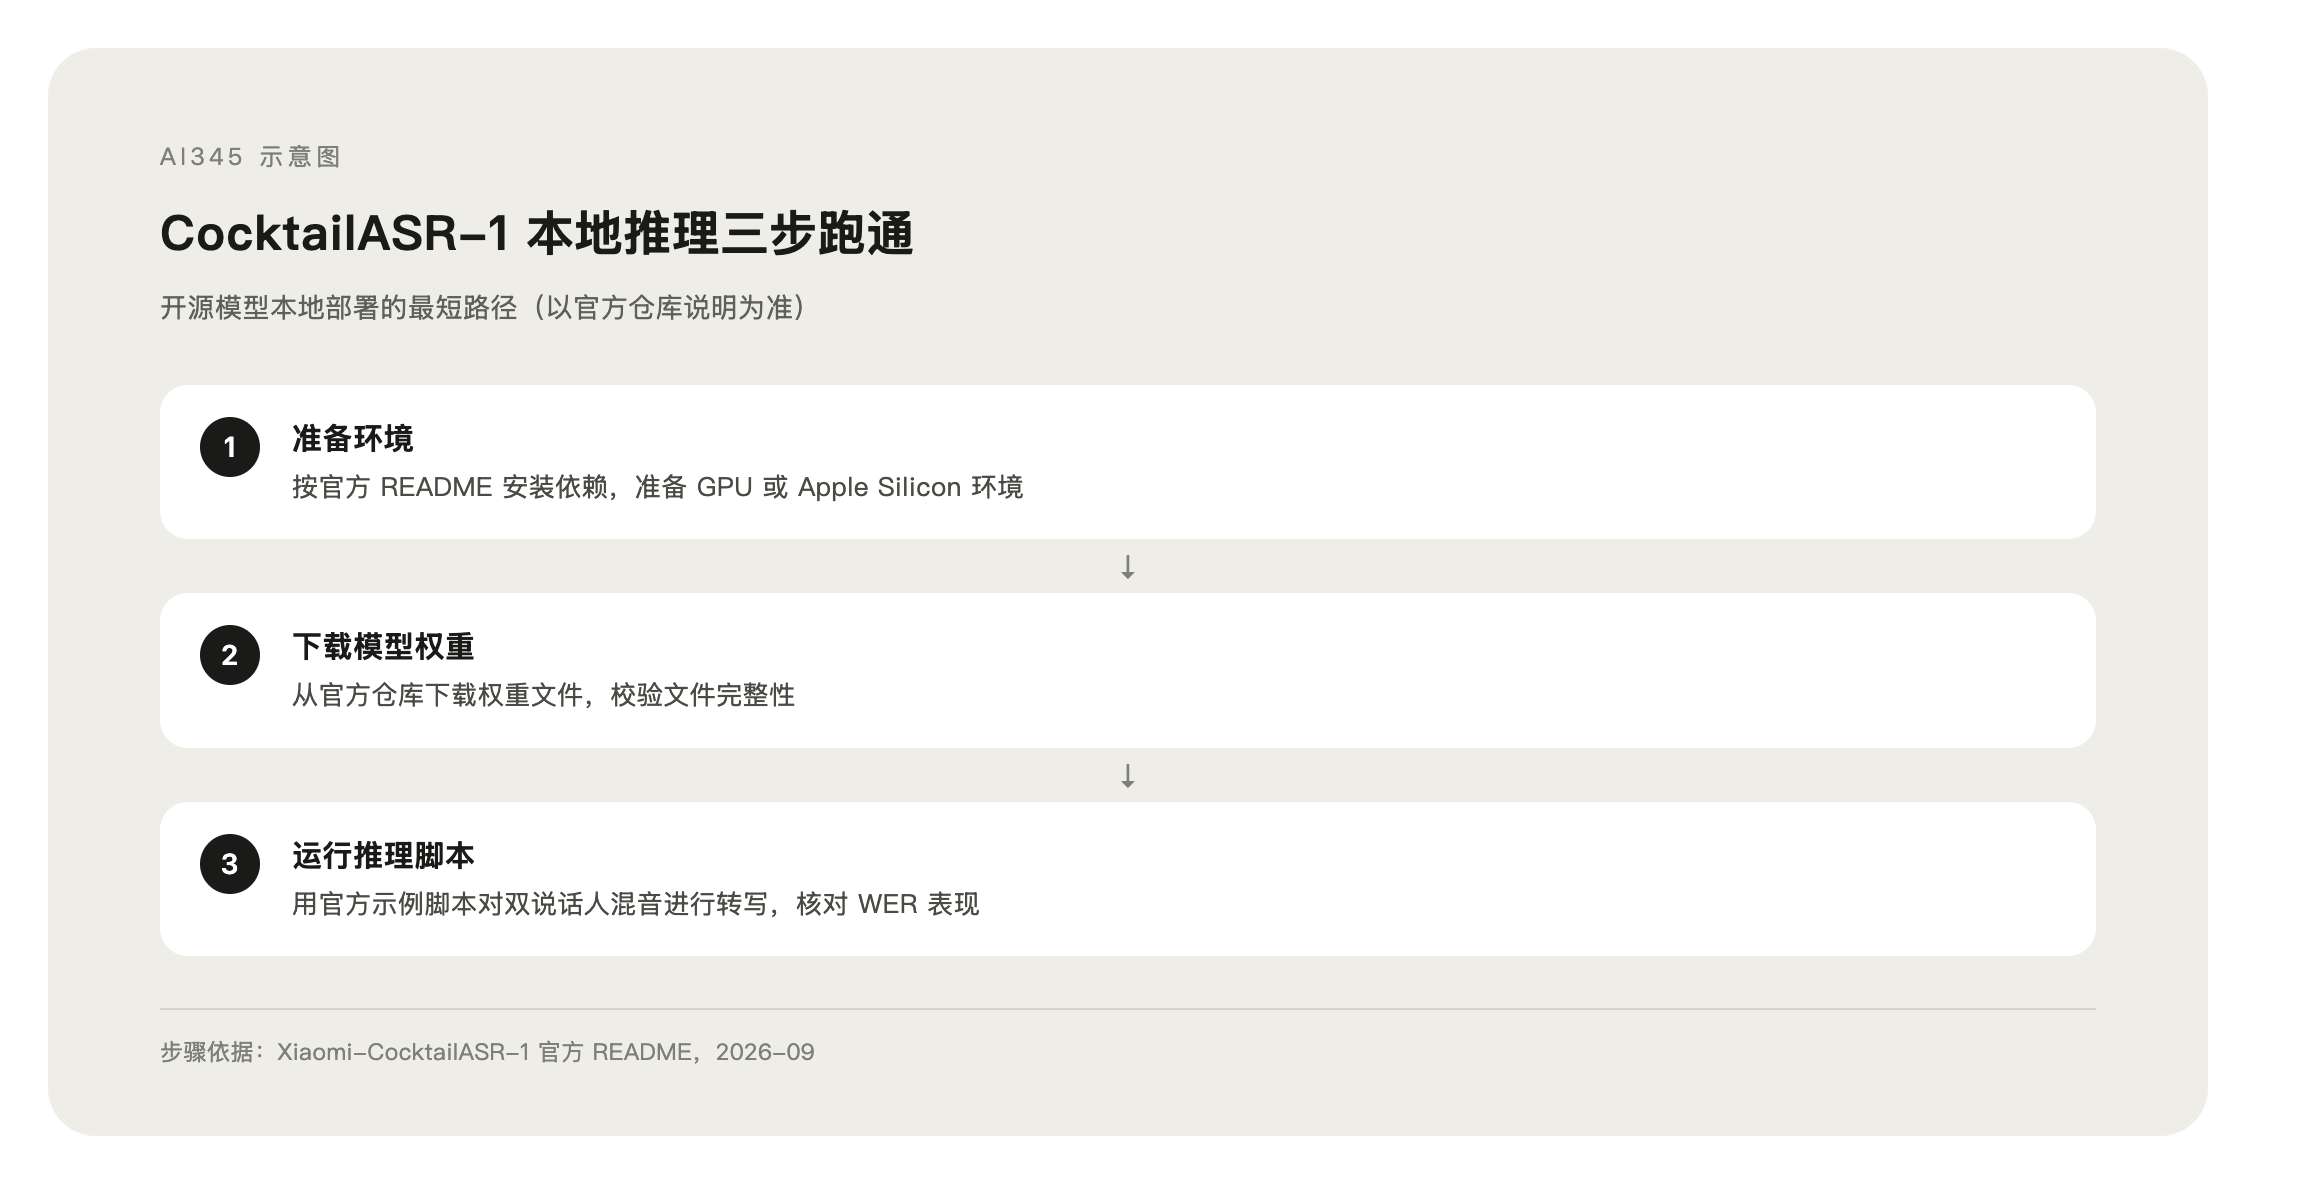
- 装依赖:pip install torch torchaudio transformers soundfile。
- 加载模型(首次运行自动从 HuggingFace 下载权重):
from transformers import AutoModel
model = AutoModel.from_pretrained(
    'Ease3/Xiaomi-CocktailASR-1',
    trust_remote_code=True,
    torch_dtype='bfloat16',
).cuda().eval()
- 传入目标音频和参考音频:text = model('target.wav', 'ref.wav'),返回的文本就是目标说话人的转录内容。
新手最容易踩的四个坑
- trust_remote_code=True 不能漏:模型用自定义代码加载,漏了这个参数直接报错。
- 音频规格:输入要求 16k 单声道,非 16k 会自动重采样,但源音频质量直接影响识别效果。
- 留意空结果:模型有拒识能力,正样本也有小概率被误判为空(README 用误拒率 FRR 表说明了这一点),批量处理时要做空结果检查。
- 批量转写别手写循环:官方 tools/test_batch_scp.py 直接读 TSV 文件批量跑,参考音频拼接在模型内部自动完成。
需要了解这个模型在国内网络环境下怎么顺利下载,看站内这篇CocktailASR-1 国内获取指南;想系统理解语音识别的基本概念,先读什么是 ASR。
常见问题
CocktailASR-1 商用要给小米交授权费吗?
答:不用。项目基于 Apache License 2.0 开源,商用免费,只需保留版权与许可声明,并按要求标注修改过的文件。
有在线试玩的网页吗?
答:目前官方仓库提供的是正负样本示例音频,没有公开的在线试玩页。想快速验证效果,按本文三步在本地跑一遍最快。
它和 Whisper 有什么区别?
答:Whisper 是通用 ASR,不区分说话人,多人同时说话会混在一起;CocktailASR-1 是目标说话人识别,配合参考音频只输出指定人的内容,多人会议场景优势明显。
显卡要求多高?
答:官方示例用 CUDA 和 bfloat16 加载,README 未公布最低显存门槛,建议按大模型推理的常规配置准备并在实际音频长度下测试。
 京ICP备2024094994号-29