
世界模型是什么?图解 AI 脑内预演物理世界的原理与边界
世界模型是给 AI 装的「脑内沙盘」:它不只生成好看的画面,而是在内部维护一套对世界运行规律的认知,能推演「我这么做,接下来会发生什么」。李飞飞创办的 World Labs,以及很多自动驾驶和机器人团队,押注的都是这个东西。
世界模型是什么:从「背答案」到「懂物理」
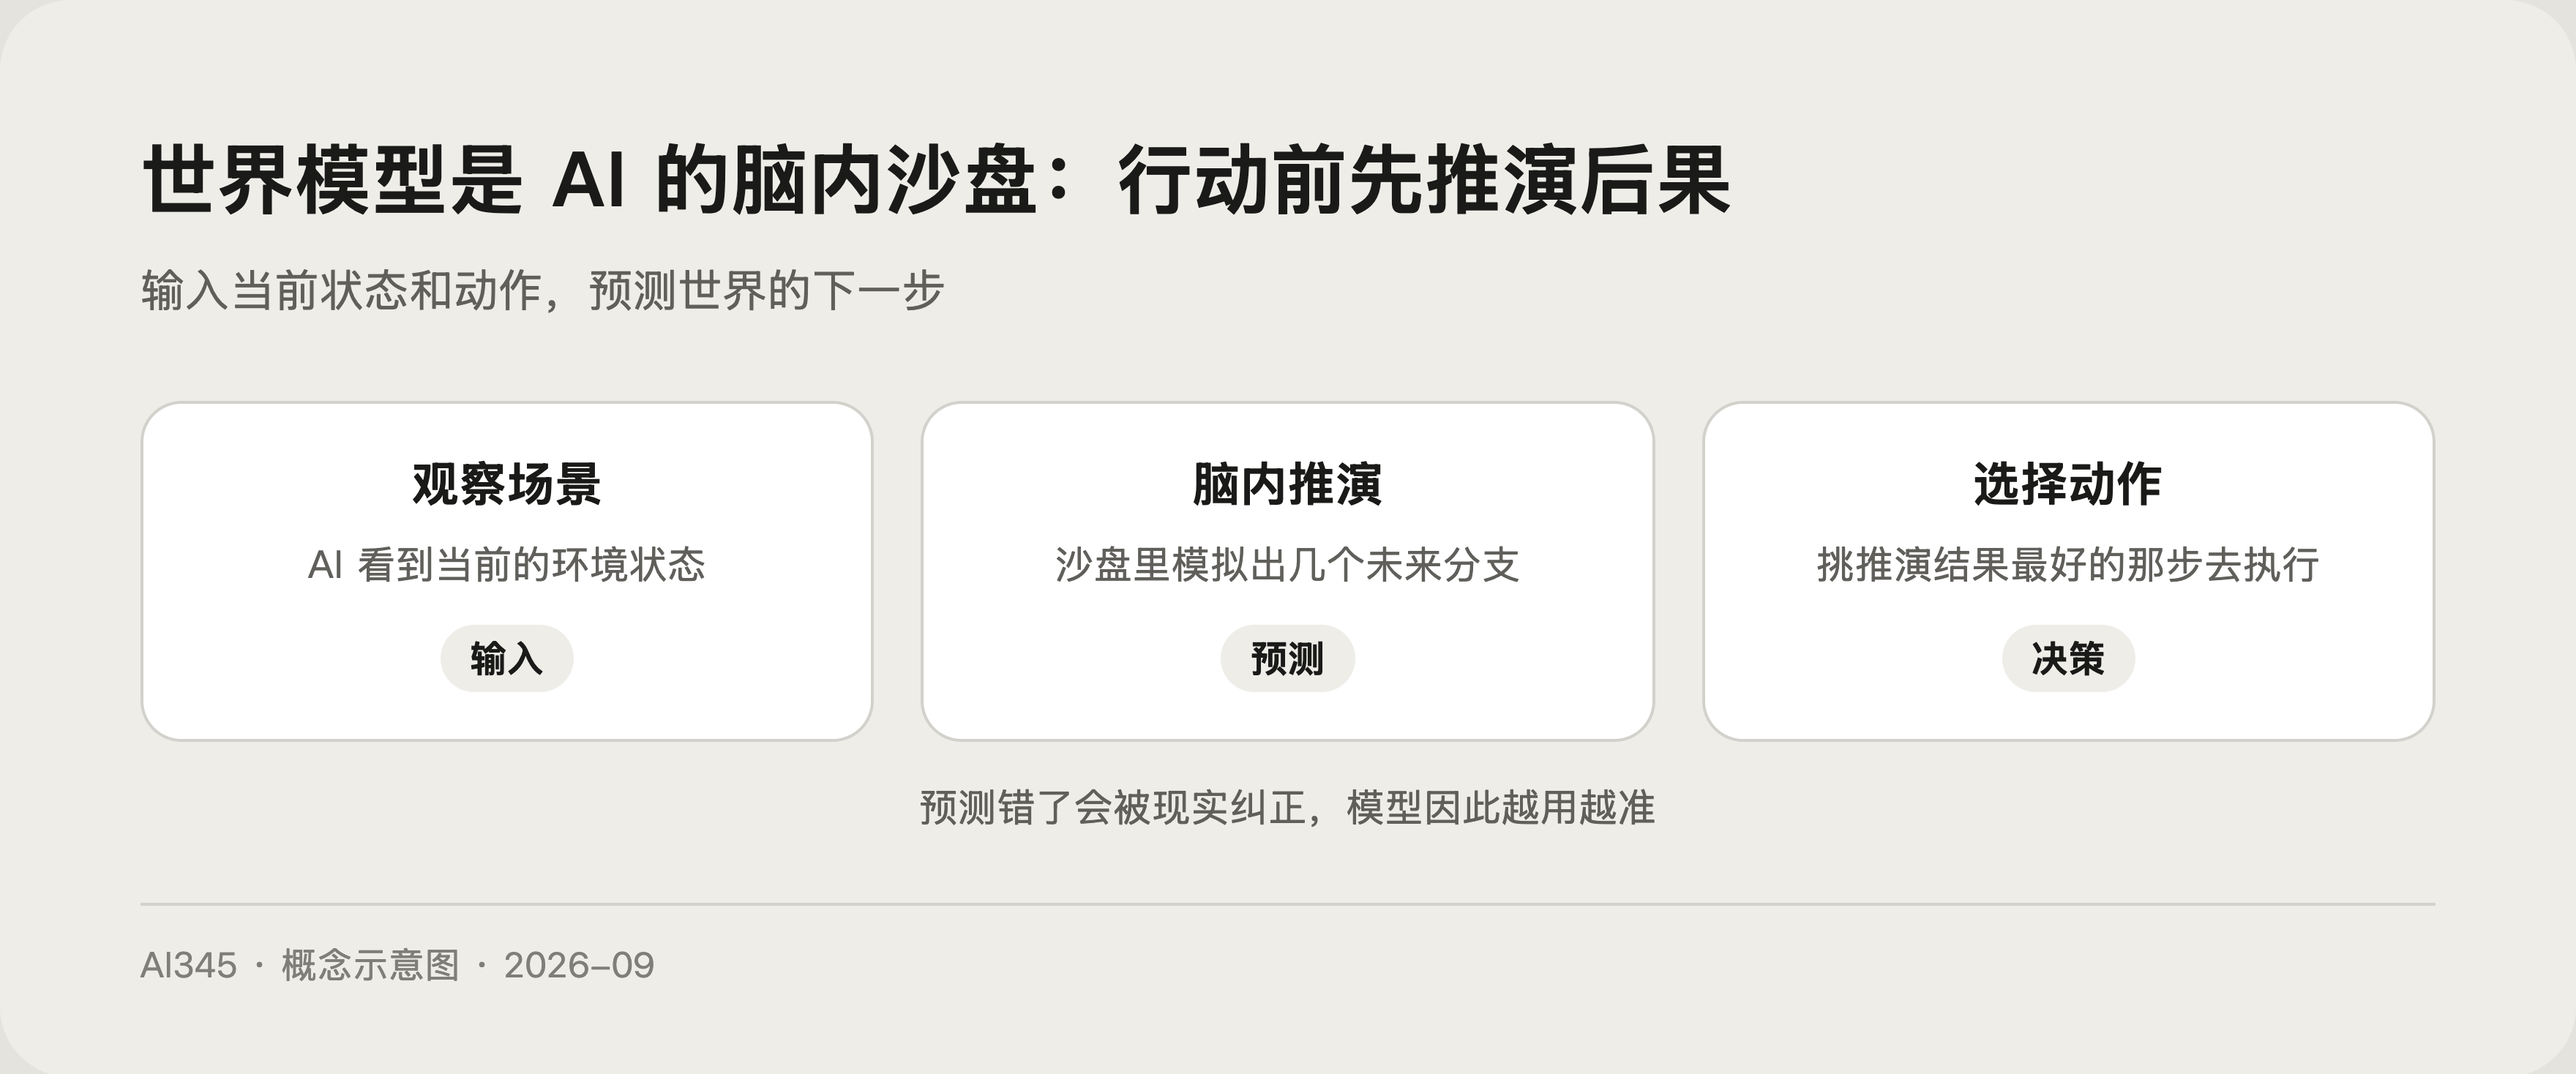
下棋高手有个共同点:走一步之前,会在脑子里推演后面好几步。世界模型想让 AI 具备的就是这种能力,在不真正行动的情况下,用内部模型预演世界的下一步。
这个概念不是新词。2018 年,Ha 和 Schmidhuber 把生成式神经网络当成游戏环境的内部模型,训练出一个可以完全在自己「梦境」里练策略、再把策略迁移回真实环境的智能体,这正是 World Models 论文的核心实验,也是这个词在 AI 圈流行的起点。
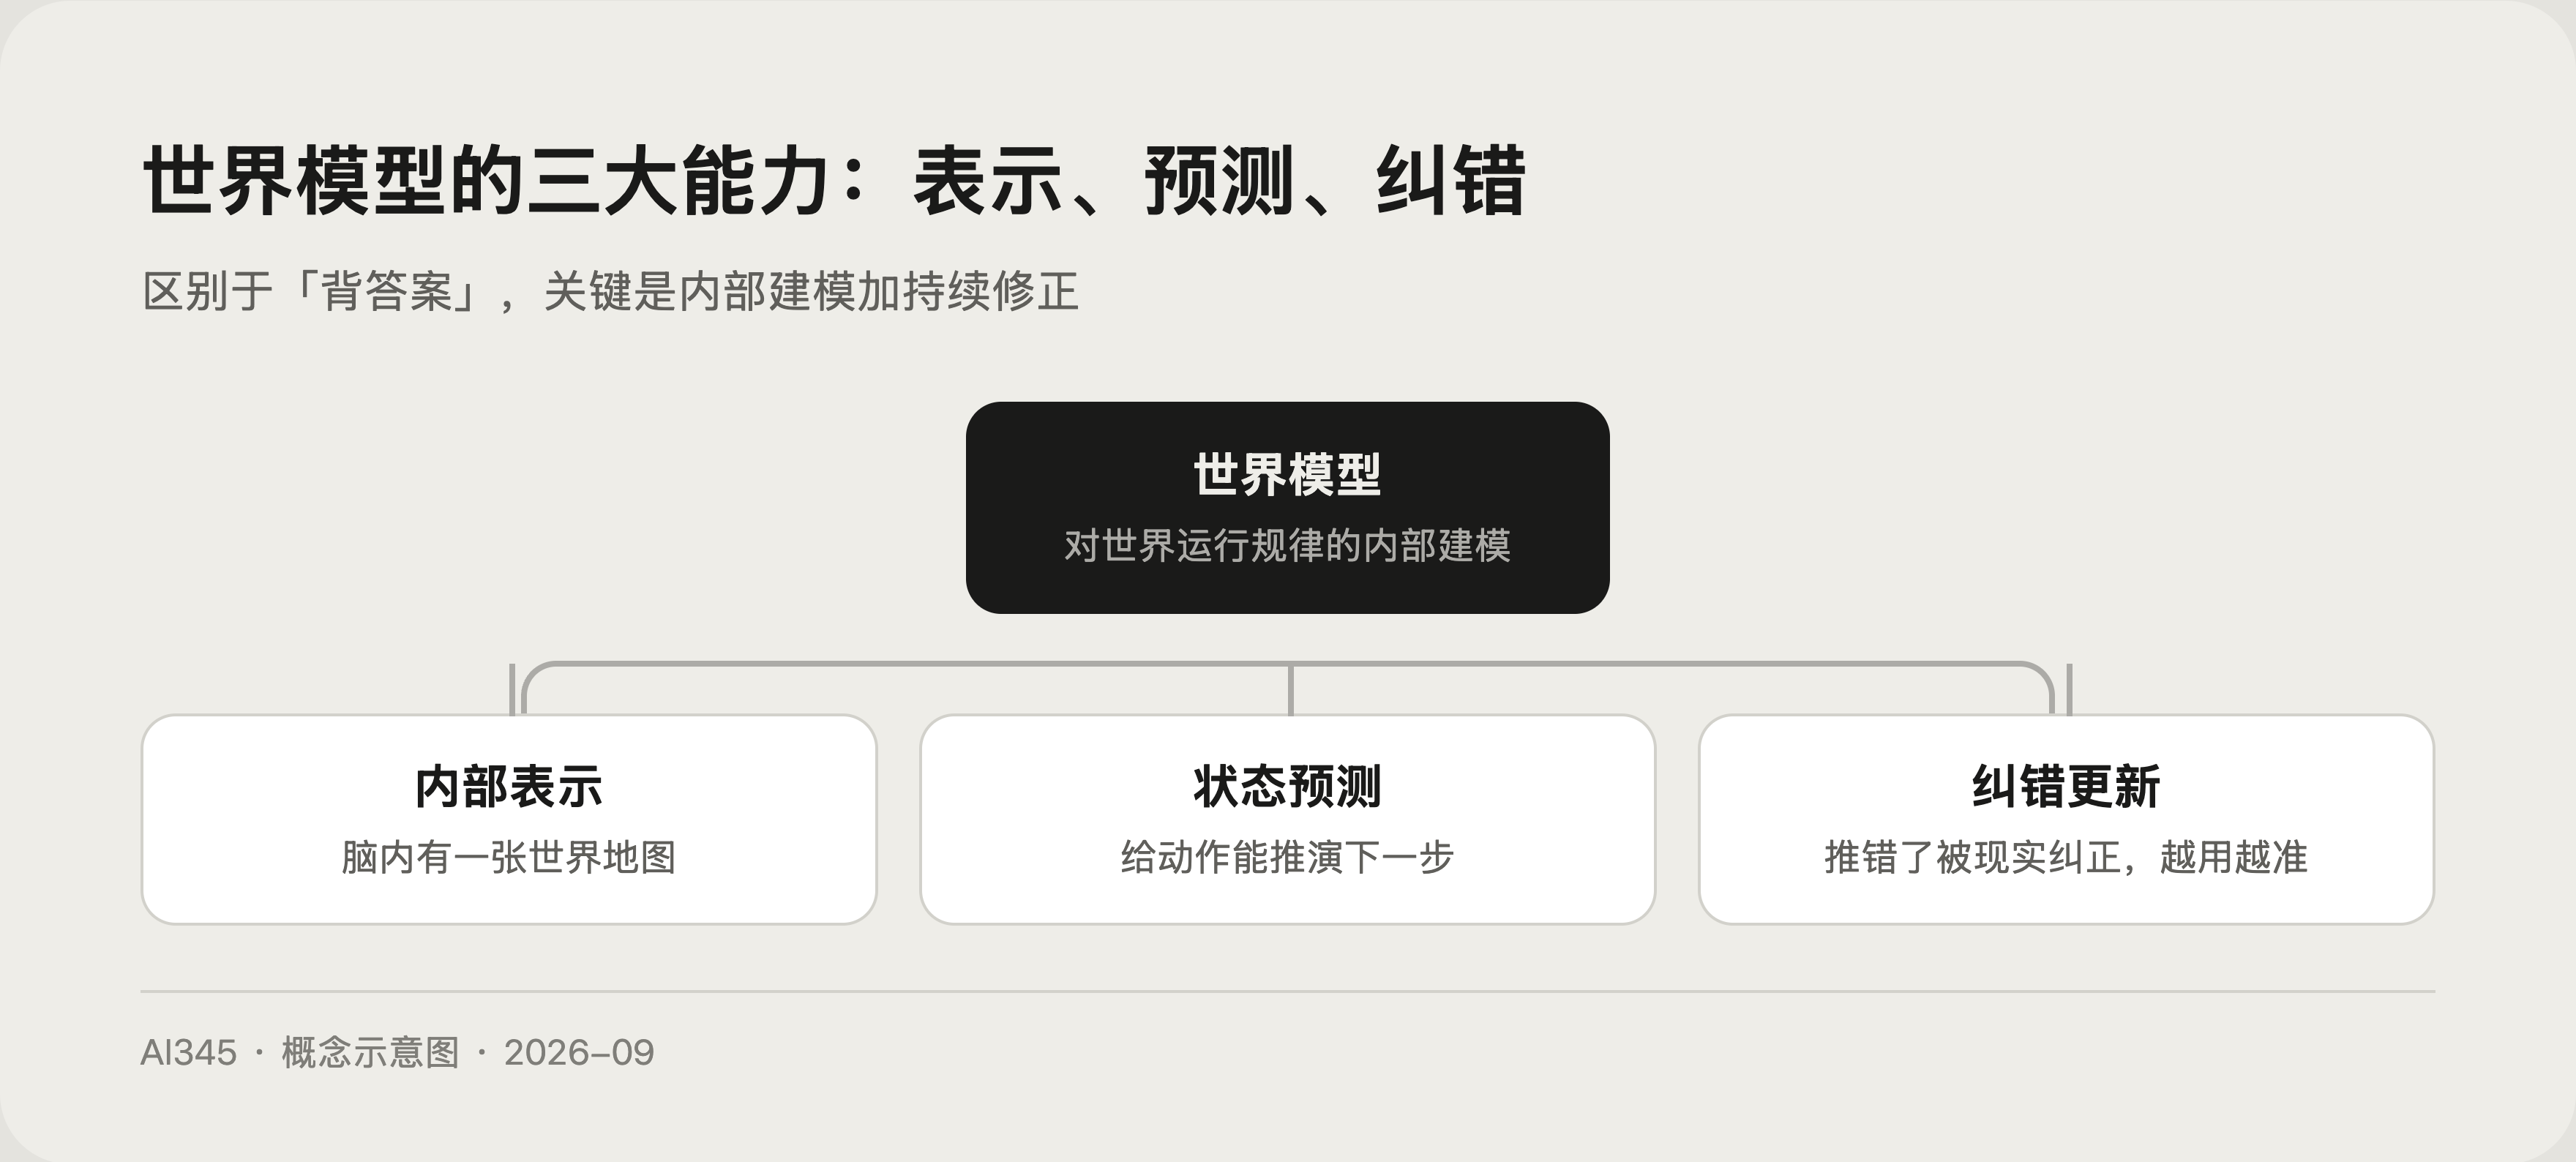
区别于「背答案」,世界模型的关键是三件事:
- 它对世界有一套内部表示,相当于脑内地图;
- 给一个动作或扰动,它能预测世界的下一个状态;
- 预测错了会被现实纠正,模型因此越用越准。
李飞飞和 World Labs 押的是什么
李飞飞是 ImageNet 的提出者,后来她联合多位计算机视觉与图形学学者创办了 World Labs,公司定位是空间智能公司。按官方说法,他们在构建能感知、生成、推理并与虚拟及物理世界交互的前沿模型,目标是让 AI 理解物体、空间和时间上的交互(见 World Labs 官网)。
为什么强调「空间」?因为人类对世界的理解天然是三维的:知道杯子挪到桌边会掉、门往后推开才不会撞到人。世界模型想补的,正是大语言模型最弱的那一块:LLM 读过全世界的文字,却没有身体,也没法在脑内转动一个三维场景。
世界模型和视频生成有什么区别
这两个词经常被混着用,边界其实很清楚。
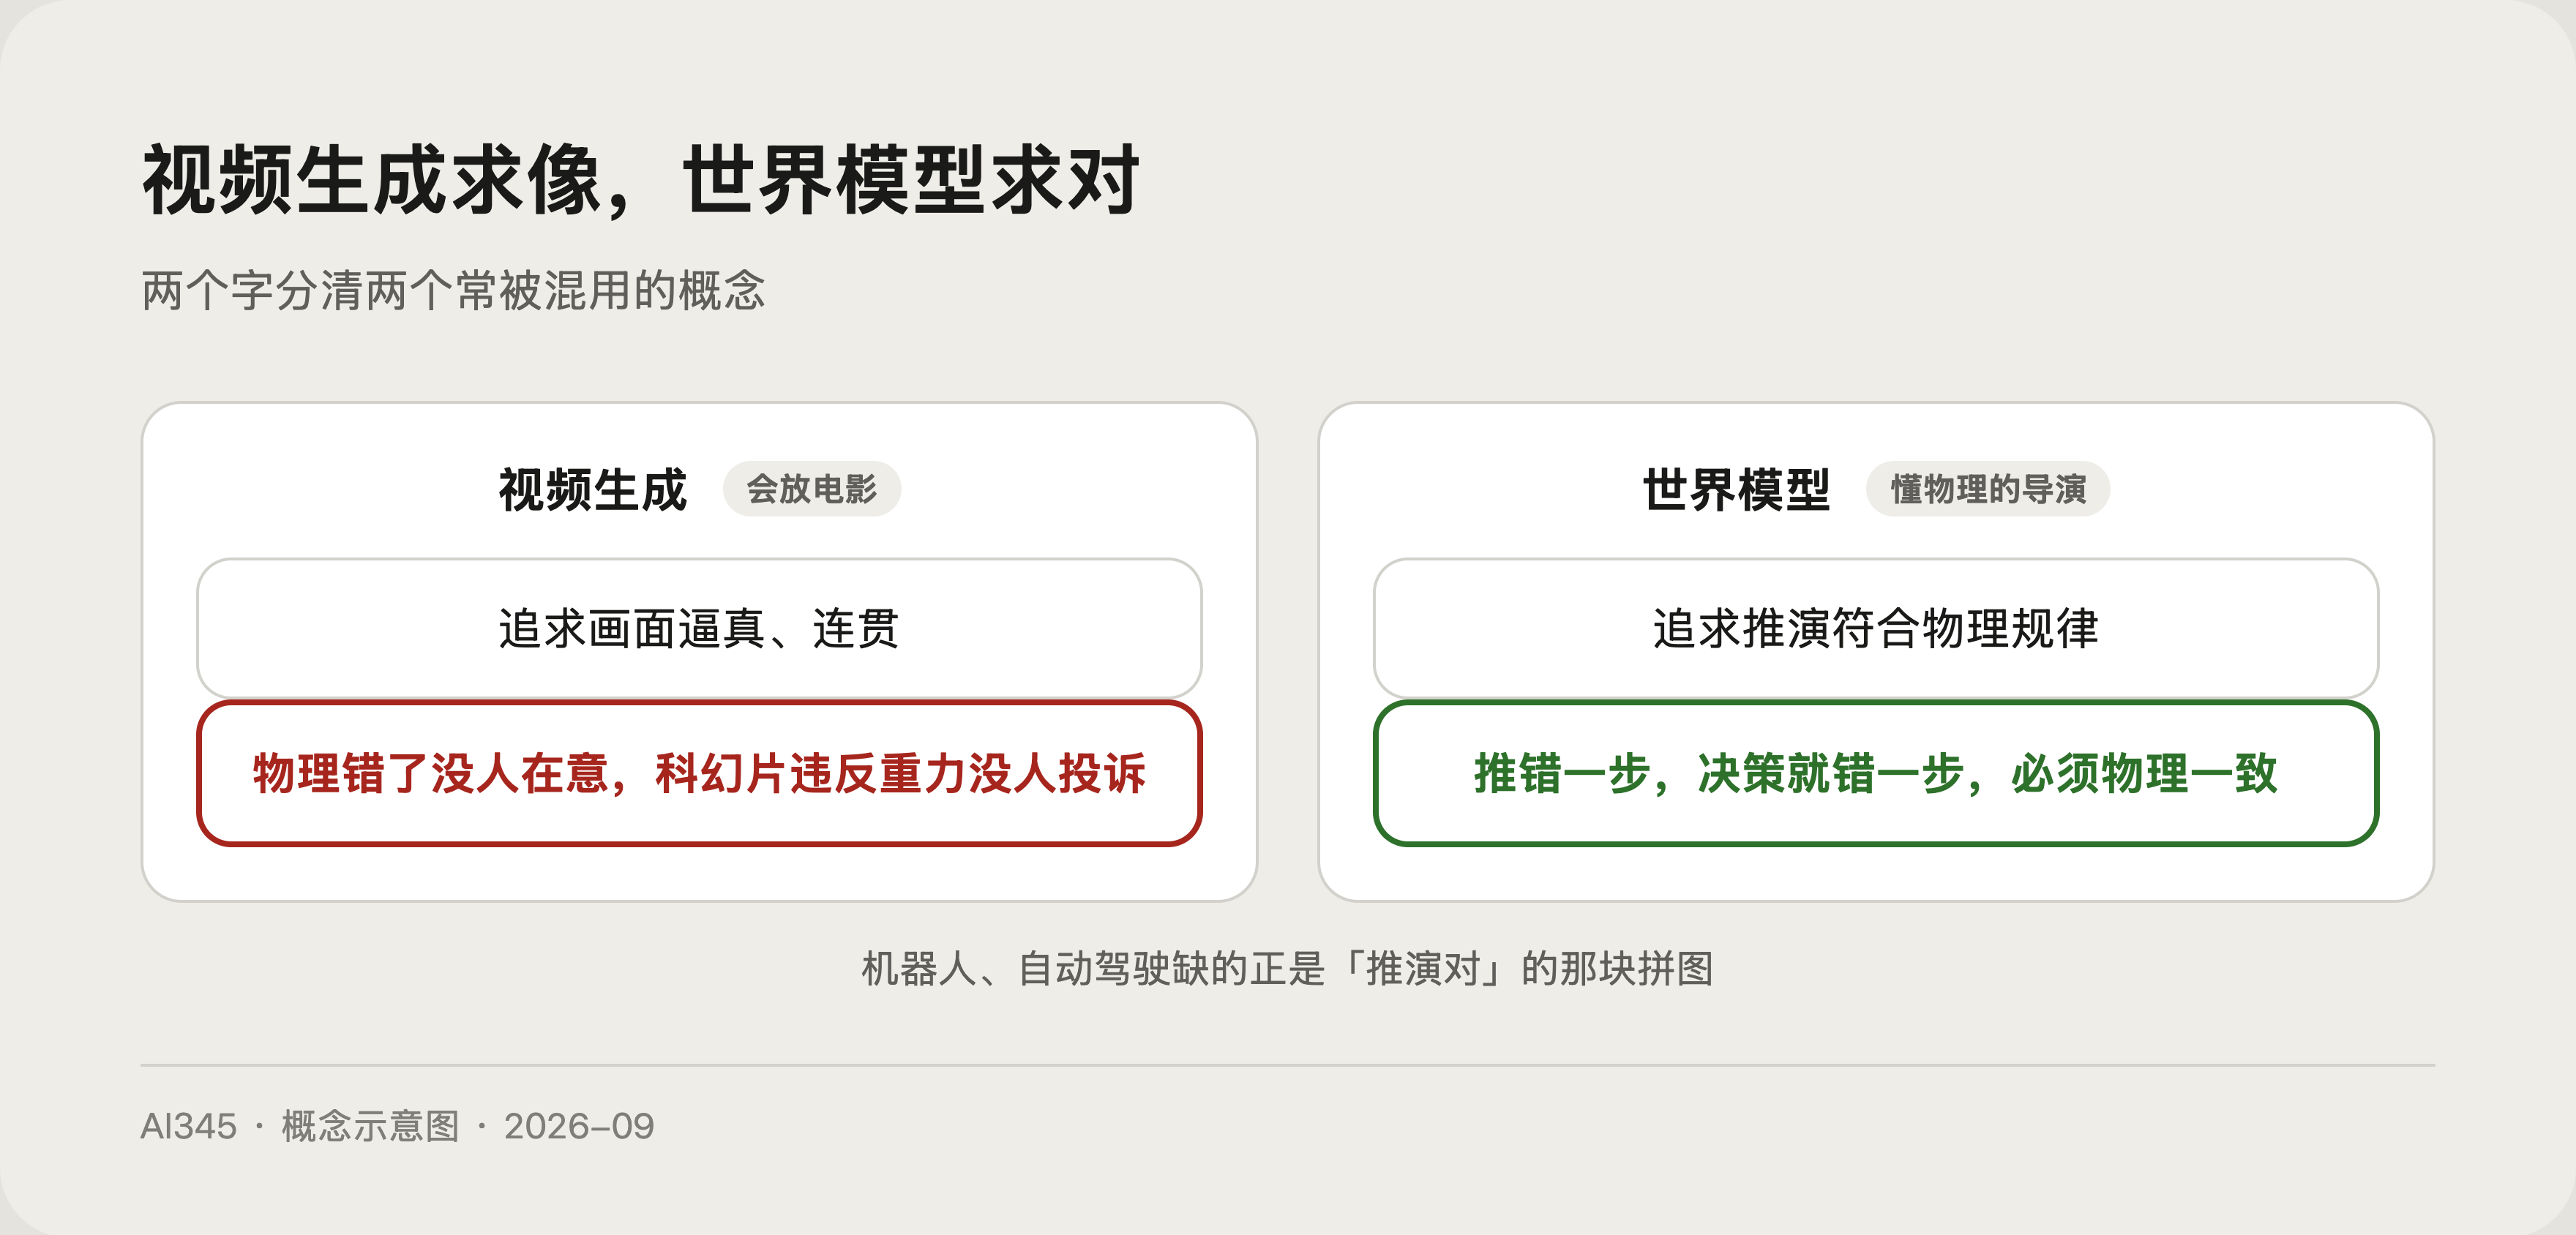
- 视频生成要的是「像」:画面逼真、连贯,物理错了也没人在意,科幻片违反重力没人投诉;
- 世界模型要的是「对」:它推演出的下一段未来必须符合物理规律,推错了决策就会错;
- 打个比方,视频生成是会放电影,世界模型是懂物理的导演。目前多数视频生成模型离严格的「懂物理」还有距离,这正是行业在攻关的地方。
一段话讲清世界模型
「世界模型是 AI 对世界运行规律的内部建模:输入当前状态和动作,预测下一个状态,相当于脑内沙盘,可以在行动前先推演后果。它和视频生成的区别在于不追求画面像,而追求推演对。它被认为是大模型通向物理世界的关键拼图,机器人和自动驾驶都靠它在决策前做预演。」
可能的追问有两个:为什么说大语言模型缺世界模型,因为它从纯文字学习,缺空间和物理的可推演表示;除了 World Labs 还有谁在做,自动驾驶端到端方案和头部机器人公司普遍在布局。
想深入这个方向怎么补课
世界模型是视觉、生成、决策几条线的交汇点。先把多模态和大模型的地基打好,推荐阅读顺序:多模态大模型是什么、预训练是什么、大语言模型是怎么工作的。读完这三篇,再回头看 World Models 论文摘要,会顺畅很多。
常见问题
世界模型和数字孪生是一回事吗?
答:不完全是。数字孪生强调对真实实体的实时映射,世界模型强调对世界规律的通用建模与推演。前者是「镜像」,后者是「脑补」。
大语言模型里有没有世界模型?
答:学界仍在争论。LLM 从文字中学到了部分物理常识,但缺少空间和感知基础,多数研究者认为它缺的是「可推演的内部模拟」,而不是知识本身。
世界模型一定要能生成画面吗?
答:不一定。核心是内部状态预测,画面只是表示形式之一,有些世界模型用抽象状态而不是像素来做推演。
自动驾驶为什么需要世界模型?
答:车要在极短时间内判断「我变道,旁边的车会怎么反应」,这种行动前的预演正是世界模型的核心能力,也是端到端自动驾驶研究它的重要原因。
普通人什么时候能用到世界模型产品?
答:消费级的空间生成类产品已经在公测,但离「可信赖的物理推演」还有距离,具体时间点没人能保证,建议关注 World Labs 等团队的产品动态。
 京ICP备2024094994号-29