
向量数据库是什么?存意思不存字,图解检索原理
向量数据库是专门存「意思」的检索库:它把文字、图片等内容转成一串数字(向量),内容意思越近,对应的点在空间里就挨得越近;查询时不再比对字面,而是直接找「意思最近」的那几条。Pinecone 官方教程把它定义为「为向量嵌入做索引和存储、支持快速检索和相似度搜索的数据库」(官方教程)。
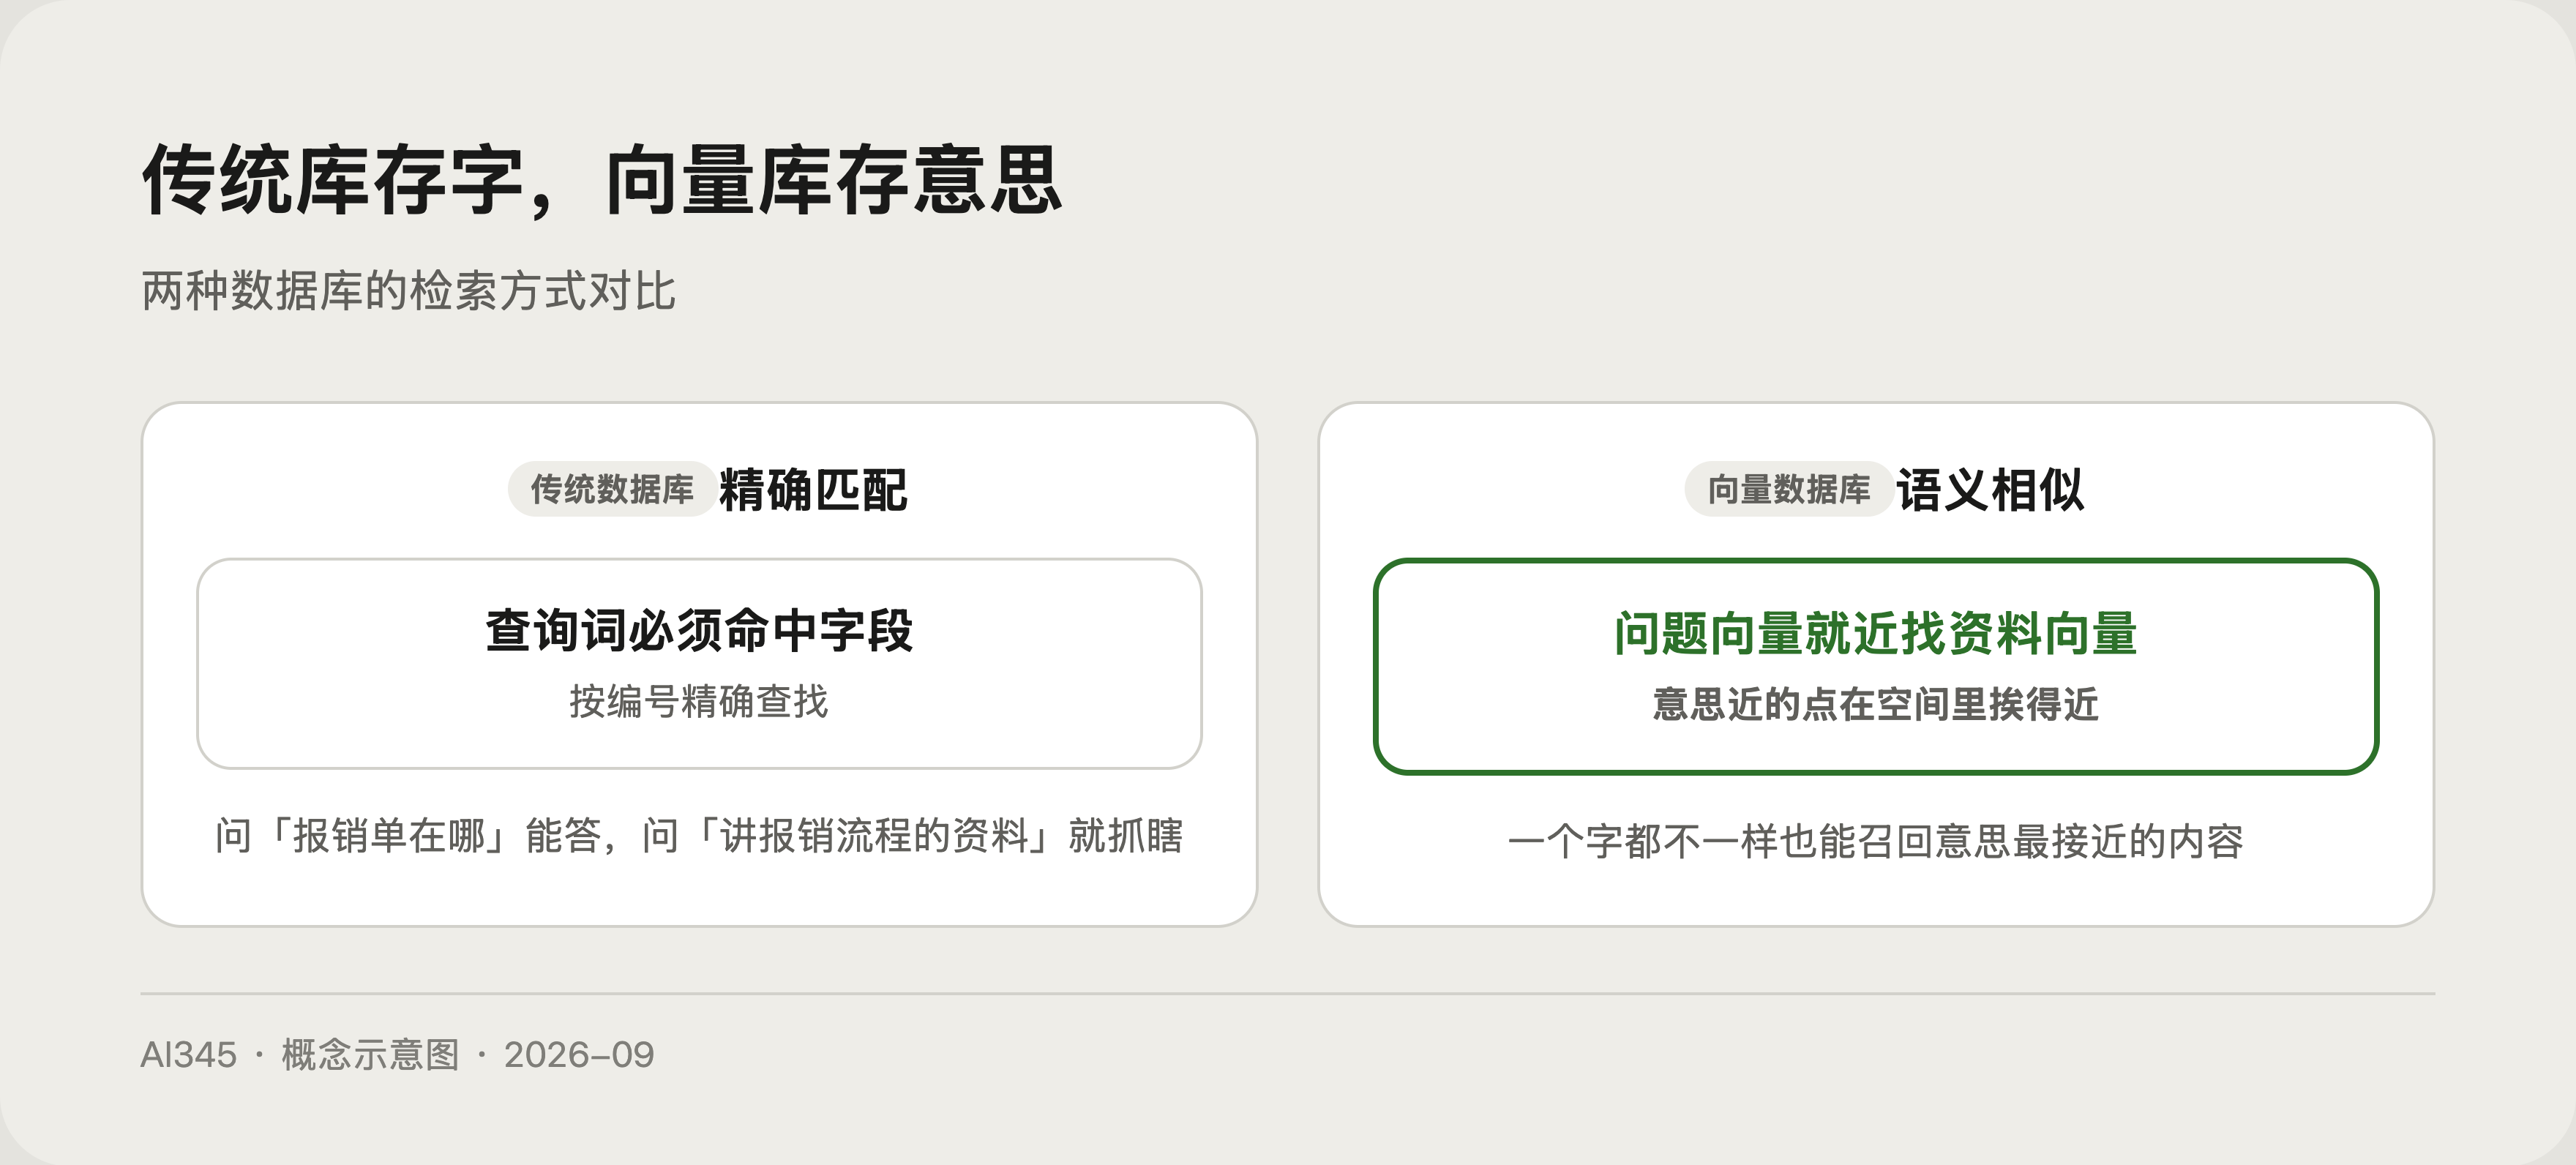
一句话记住它:传统数据库是存字的,向量数据库是存意思的。这一个差别决定了 RAG、语义搜索、AI 记忆全都绕不开它。
为什么普通数据库接不住「意思」
打个比方:传统数据库像个严格的档案管理员,你问「2024 年 3 月的报销单在哪」,它能精确翻出来;但你问「有没有讲过报销流程的资料」,它就抓瞎,因为档案按编号排,不按意思排。
向量数据库更像一位懂行的图书管理员:每份资料入库前先「读一遍」,压缩成一个描述意思的坐标,比如一千多个数字组成的高维向量;你提问时,问题也被转成坐标,系统只需要找「离你最近的几个点」,就能召回意思最接近的内容,哪怕一个字都不一样。
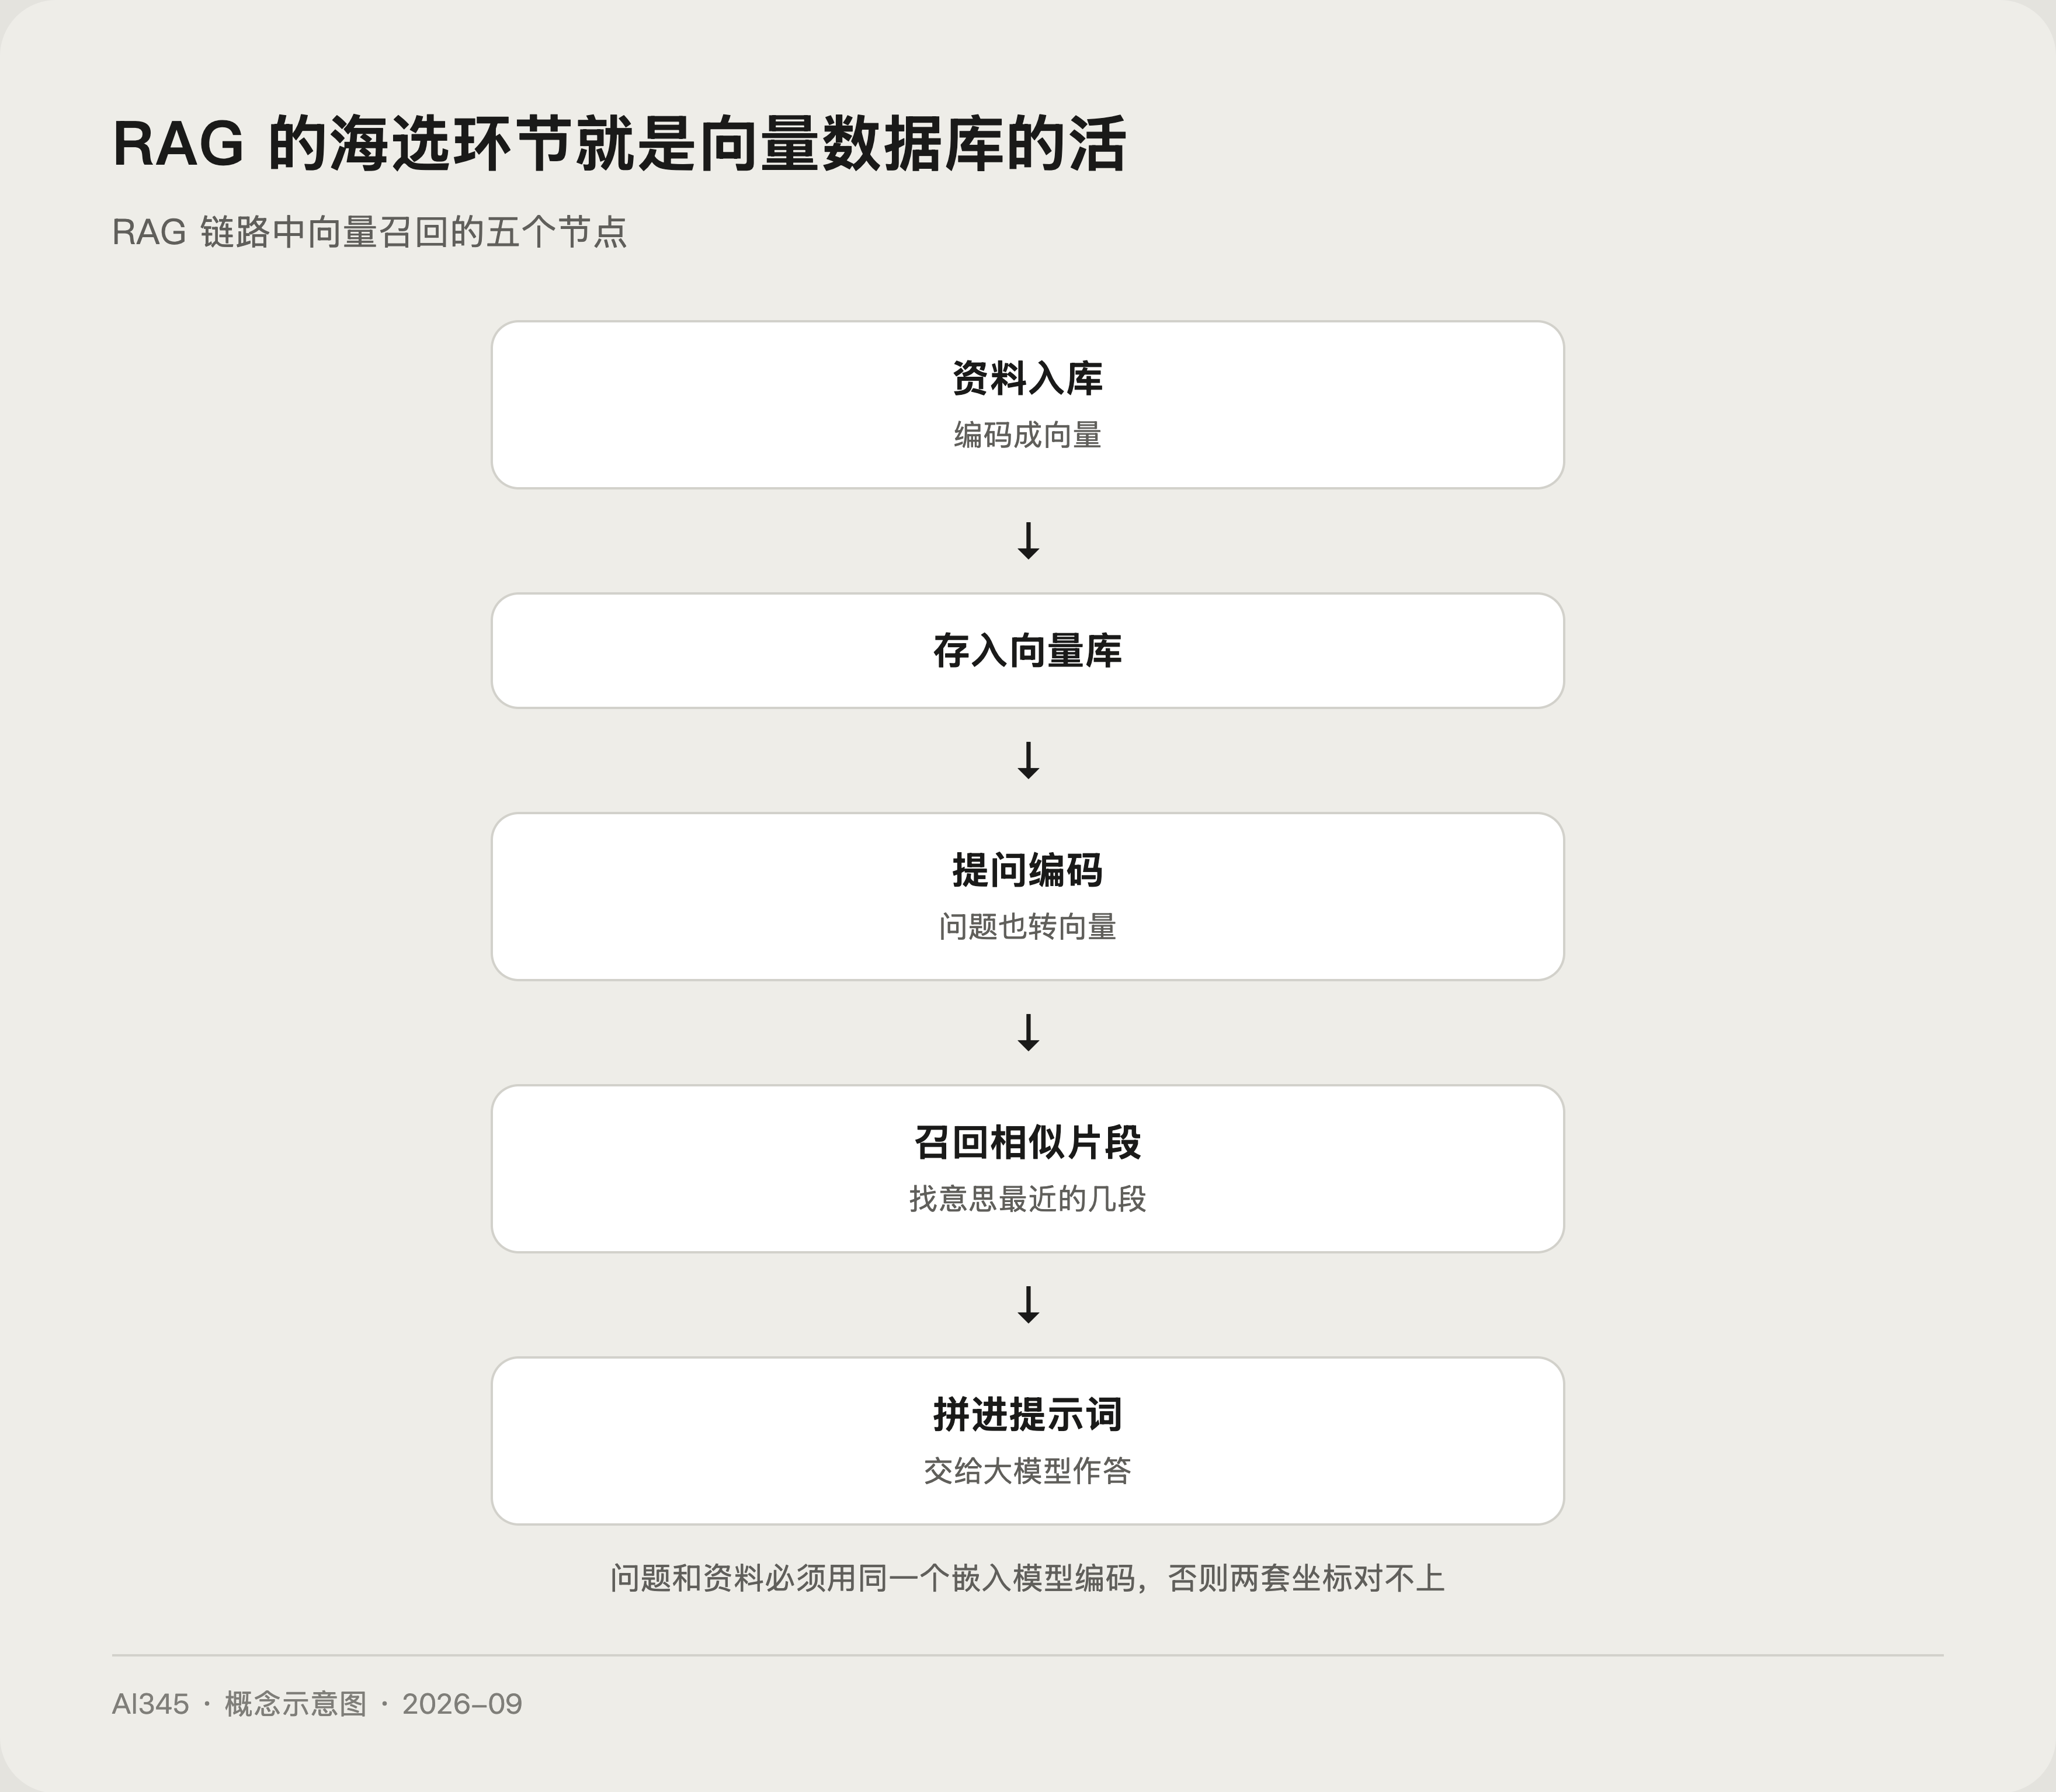
把内容变成向量的模型叫嵌入模型(Embedding Model)。注意一个细节:同一个库里,问题和资料必须用同一个嵌入模型编码,否则两套坐标体系对不上,检索就全乱了。
它和普通数据库的技术区别在哪
- 查询方式:传统数据库按字段精确匹配或范围过滤;向量数据库按相似度排序,返回「最近邻」结果。
- 索引结构:为了在亿万向量里快速找近邻,向量库普遍用近似最近邻算法(ANN),比如 HNSW 分层小世界图(HNSW 论文),用一点点精度损失换几十上百倍的查询速度。
- 附加能力:向量数据库在索引之上补齐了数据库该有的增删改查、元数据过滤、权限和备份,这正是它与裸向量索引库(如 FAISS)的分界线,Pinecone 官方教程专门对比过这一点。
一句话总结:索引只解决「找得快」,数据库还要解决「管得住」。
为什么 RAG 离不开它
RAG 的思路是「先查资料,再让大模型照着答」。问题在于企业资料动辄几十万篇,不可能每次都塞进上下文窗口,所以必须先做一轮「意思级」的海选,把最相关的几段捞出来,海选这一步就是向量数据库的活。完整链路可以读站内的RAG 是什么?给大模型外挂一个资料库。
顺带一提,很多人担心大模型胡说八道,工程上常见的缓解办法就是用 RAG 让模型引用真实资料,原理见AI 幻觉是什么?大模型一本正经胡说八道的 3 个真相。
一段话讲清向量数据库
「向量数据库是专门为向量嵌入设计、支持相似度检索的数据库。它把文本、图片等内容用嵌入模型编码成高维向量,查询时把问题也编码成向量,用近似最近邻算法找出语义最相近的内容。它和普通数据库的区别是按意思检索而不是按字段精确匹配。它是 RAG 的核心组件:大模型上下文有限,必须先用它从海量资料里召回最相关的几段,再交给模型生成回答。」
选型和上手建议
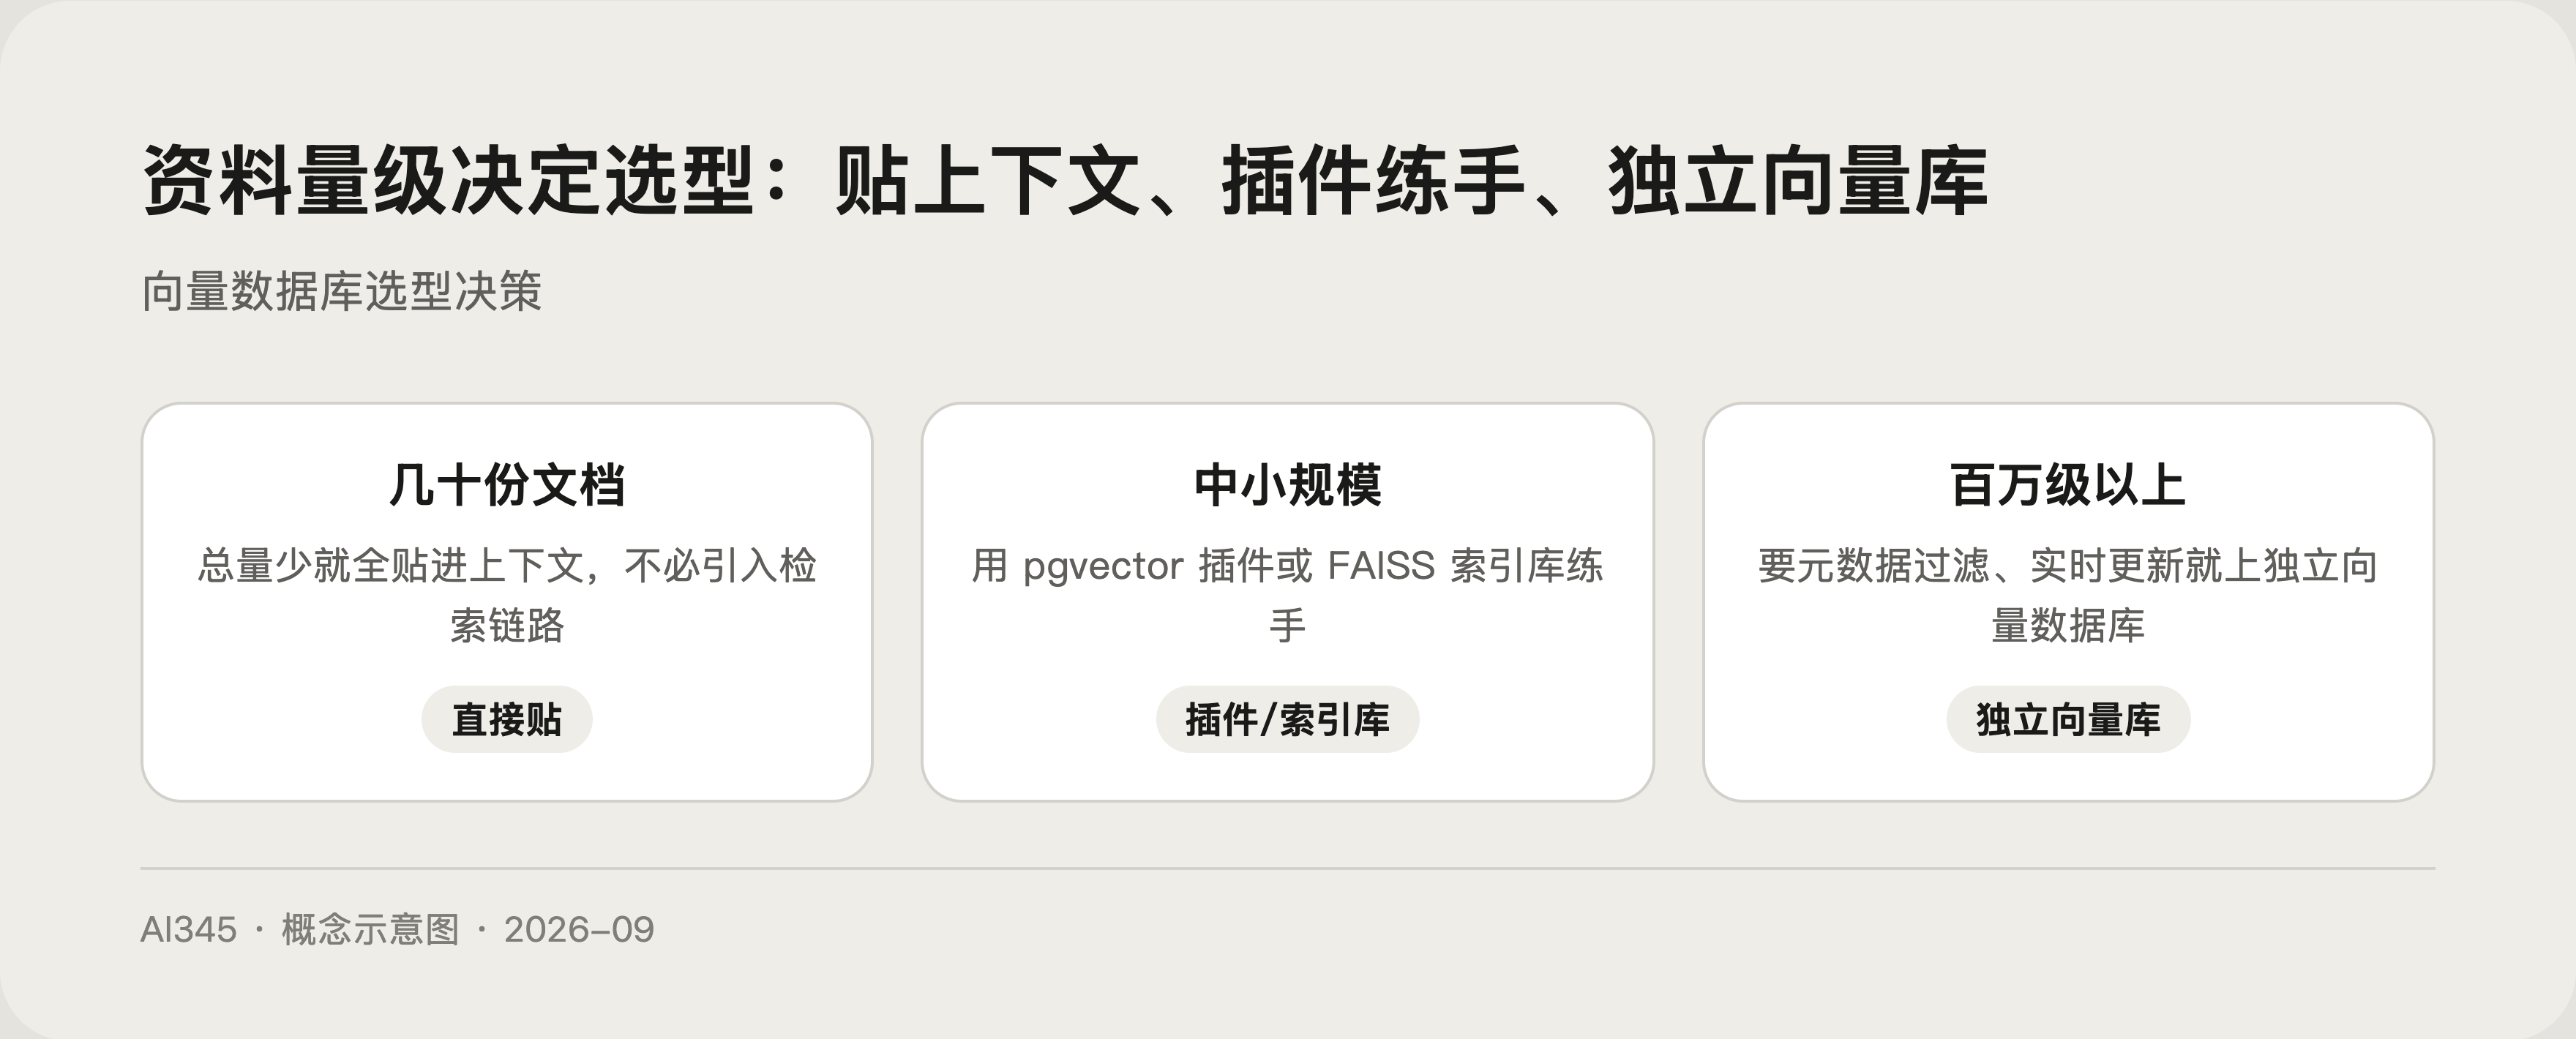
小项目可以从 pgvector 这类数据库插件或 FAISS 这类索引库练手;当数据到百万级、需要元数据过滤、实时更新和权限管理时,再上独立的向量数据库产品。想理解「模型外挂记忆」的整体图景,可以看站内的选型对比claude-mem 和 OpenViking 哪个好?AI 记忆方案选型对比。
常见问题
向量数据库和 MySQL 互斥吗?
答:不互斥。生产系统里常见做法是 MySQL 存业务数据和原文,向量库存向量和引用关系,两边通过 ID 关联配合使用。
向量一定要一千多个维度吗?
答:维度由嵌入模型决定,常见的是几百到几千维。维度越高表达越细腻,但存储和计算开销也越大,选模型时是重要权衡项。
为什么叫「近似」最近邻?
答:数据量大时精确找最近邻太慢,主流索引(如 HNSW)允许极小的召回误差来换速度,这个取舍在工程上通常是值得的。
图片和音频也能存吗?
答:能。多模态嵌入模型可以把图片、音频同样编码成向量,以图搜图、哼歌搜歌这些功能底层就是同一套相似度检索机制。
什么时候不需要向量数据库?
答:资料总量很少、能全量放进上下文窗口时,直接把资料贴给模型更简单,不必为十份文档引入一整套向量检索链路。
 京ICP备2024094994号-29