
claude-mem 和 OpenViking 哪个好?AI 记忆方案选型对比(2026)
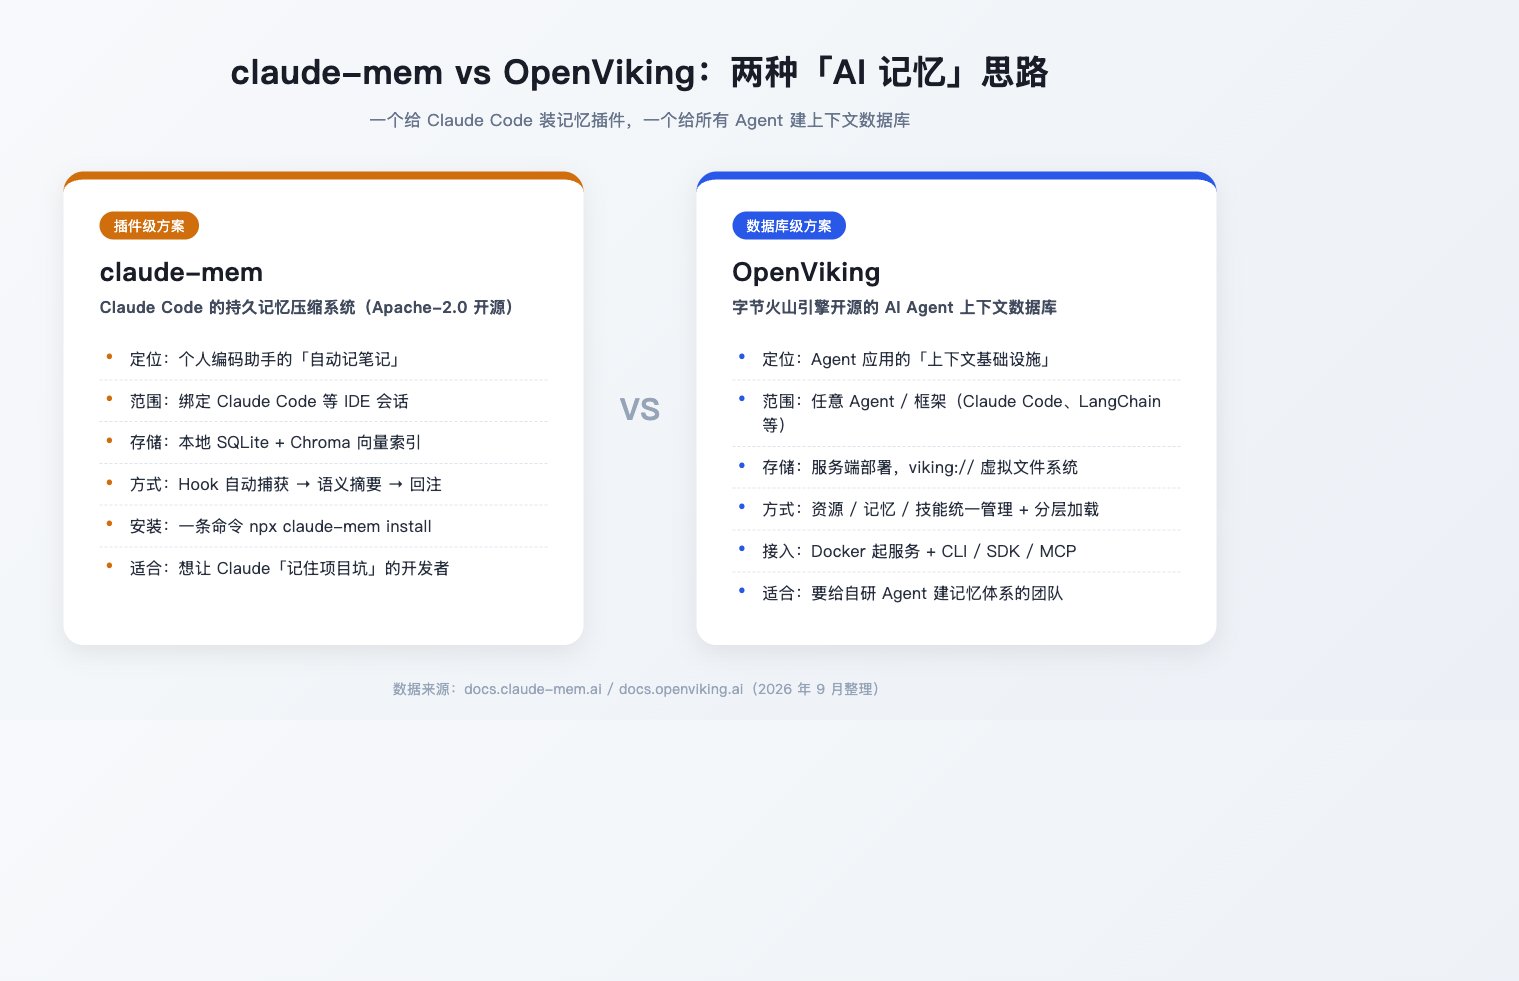
直接给结论:个人开发者用 Claude Code / Cursor 写代码,想要「自动记住项目踩过的坑」,选 claude-mem——一条命令装好、全程本地运行;在自研 AI Agent 产品里建统一的记忆、资源、技能管理体系,选 OpenViking——字节火山引擎开源的上下文数据库,按服务端方式部署。 两者不是同一个层面的东西:claude-mem 是「插件」,OpenViking 是「基础设施」。本文用一张对比表、两套安装教程和社区实测反馈,帮你在 10 分钟内选对方案。
搜索「claude-mem vs openviking/mapalace」进来的读者请注意:我们核查了全网公开资料,"mapalace" 并不是一个真实存在的 AI 产品(各大搜索引擎均无独立产品条目),这个组合词大概率是搜索时的拼写混淆。本文对比的双方就是 claude-mem 与 OpenViking——目前社区讨论最多的两款「AI 记忆」方案。
先搞清楚:两款工具分别是什么
| 项目 | claude-mem | OpenViking |
|---|---|---|
| 一句话定位 | Claude Code 的持久记忆压缩系统 | AI Agent 的上下文数据库 |
| 开发方 | 独立开发者(thedotmack),社区驱动 | 字节跳动·火山引擎 Viking 团队 |
| 开源协议 | Apache-2.0 | 开源(GitHub: volcengine/OpenViking) |
| 官方文档 | docs.claude-mem.ai | docs.openviking.ai |
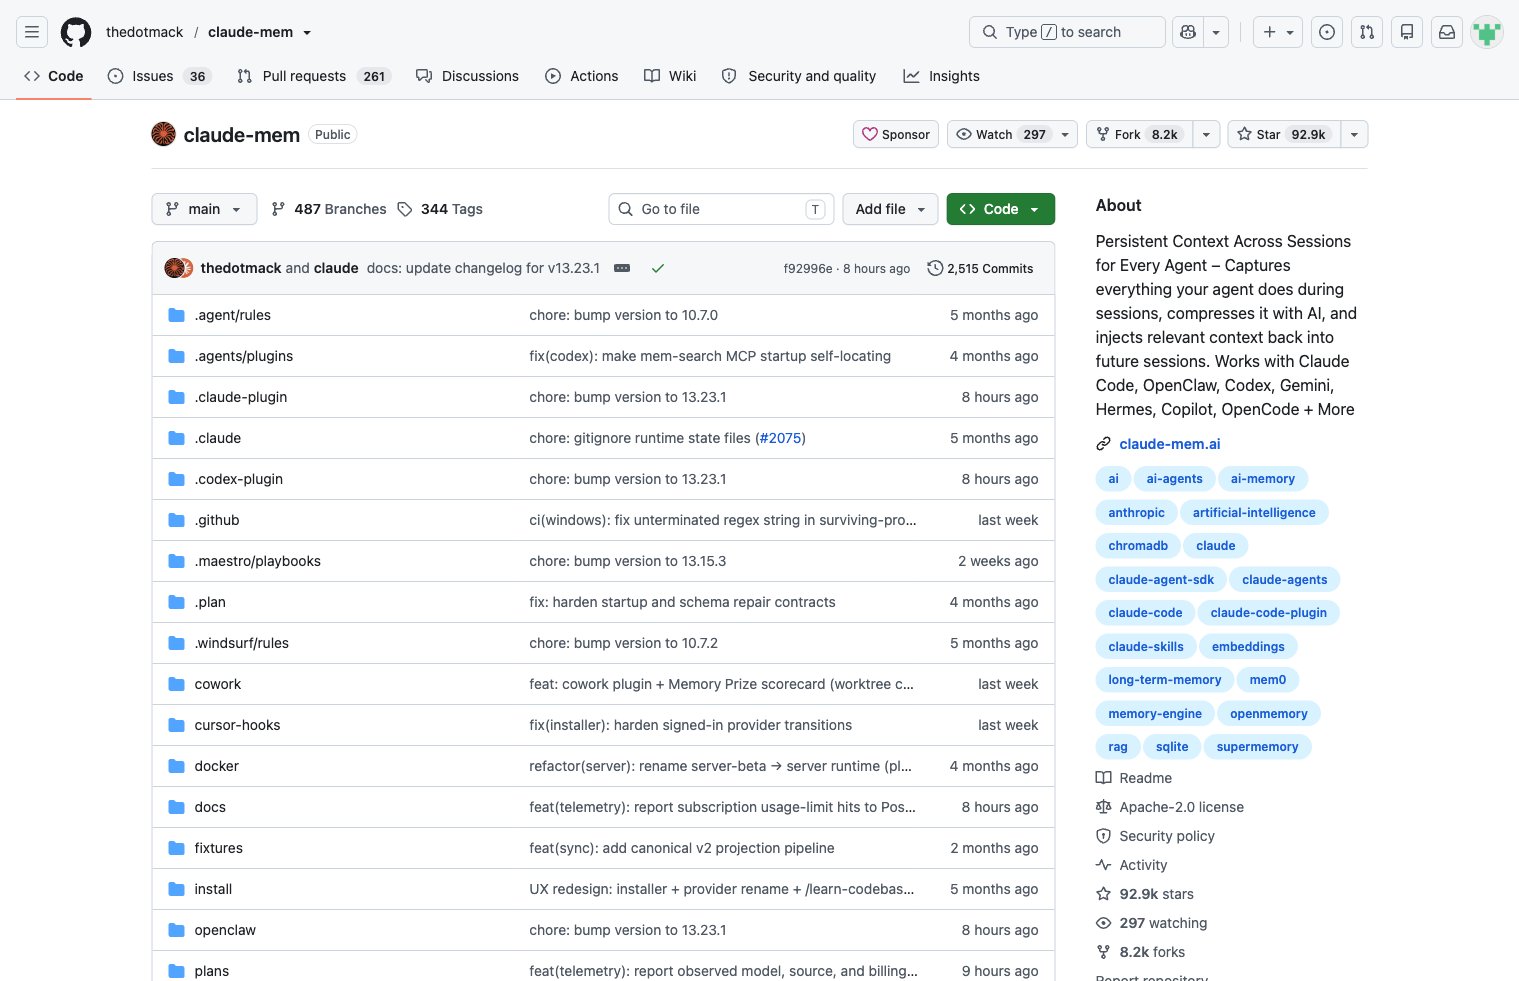
| 代码仓库 | github.com/thedotmack/claude-mem | github.com/volcengine/OpenViking |
| 运行形态 | 本地插件(随 IDE 启动) | 服务端部署(Docker 起 API 服务) |
| 服务对象 | 你个人的编码会话 | 你开发的 Agent 应用 / 团队 |
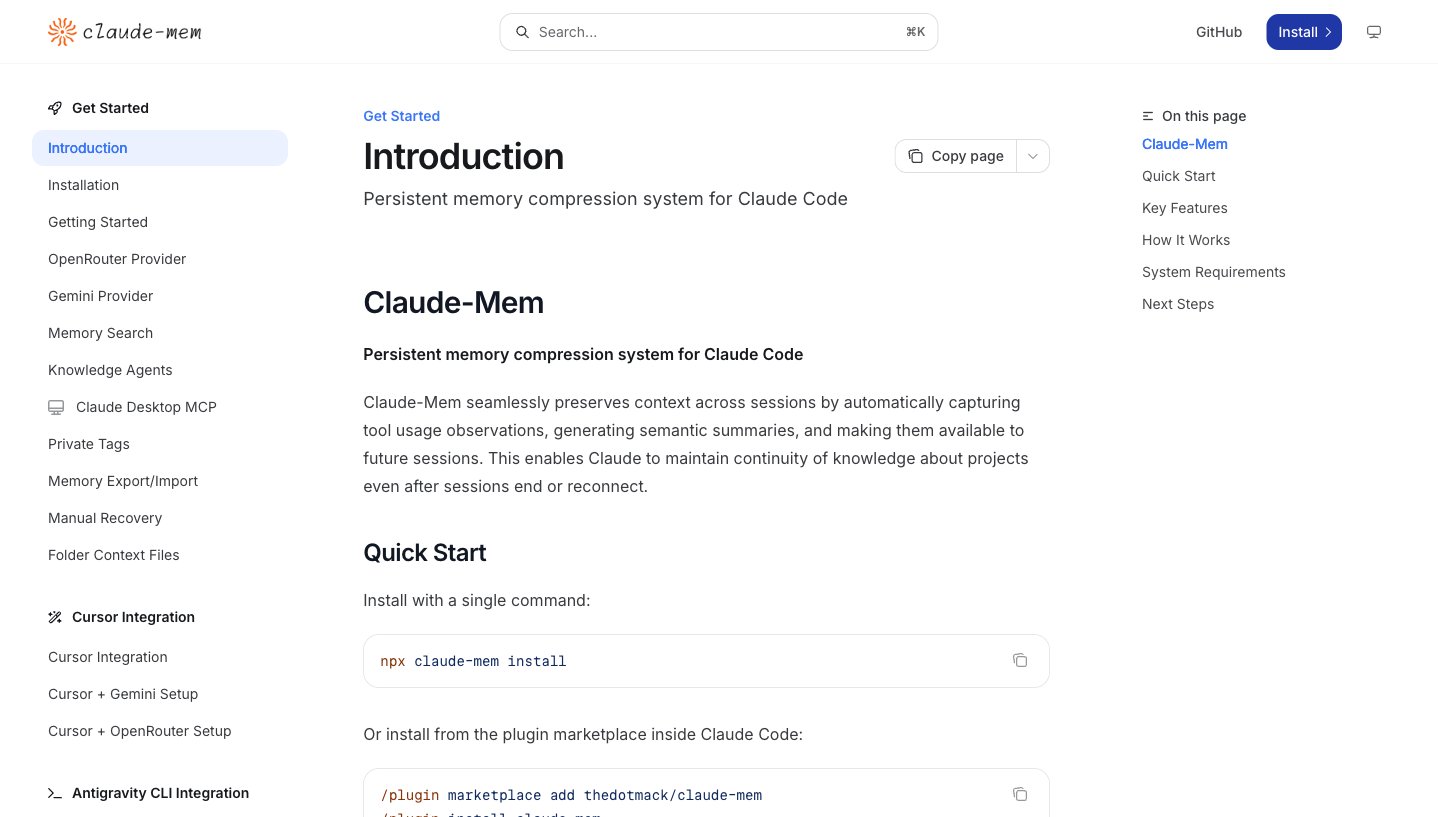
claude-mem 解决的问题:跨会话记忆丢失。今天关掉 Claude Code,明天再打开,它不记得你上周调通的配置、踩过的坑。claude-mem 通过 Hook 机制自动捕获每次工具调用的「观察记录」,用 AI 生成语义摘要存进本地 SQLite(全文检索)和 Chroma(向量检索),新会话开始时自动注入最近 10 个会话的相关上下文。官方文档的原话是"让 Claude 在会话结束后仍保持对项目知识的连续性"。
OpenViking 解决的问题:Agent 的上下文碎片化。构建 Agent 时,记忆在代码里、资源在向量库、技能散落各处;长程任务每跑一次都产出新上下文,简单截断会丢信息,传统 RAG 平铺存储又缺乏全局视野。OpenViking 把记忆(Memory)、资源(Resource)、技能(Skill)统一进一套 viking:// 虚拟文件系统,用类 Unix 的 API(ls / read / find)来管理和检索上下文。
一句话区分:claude-mem 是给「你自己用的编码助手」装记性,OpenViking 是给「你开发的 Agent」建记忆系统。
claude-mem 是什么:给 Claude Code 装上「自动记笔记」
它的核心能力来自官方文档和社区实测:
- 自动捕获与压缩:通过 5 个生命周期 Hook(SessionStart、UserPromptSubmit、PostToolUse、Stop、SessionEnd)在后台记录工具使用观察,AI 生成语义摘要,而不是堆日志;
- 持久记忆:新会话自动注入相关历史,支持 FTS5 全文检索和自然语言 MCP 搜索工具;
- Folder Context Files:自动在项目文件夹生成带活动时间线的 CLAUDE.md,记忆沉淀成可分享的文档;
- 28 种语言模式:中文用户可直接使用中文模式;
- Knowledge Agents:把观察历史构建成可查询的「大脑」;
- 隐私控制:
<private>标签可以排除敏感内容;Web 查看器实时可视化记忆流。
安装只有一条命令(要求 Node.js 20+,Bun 会自动装):
npx claude-mem install
或者在 Claude Code 里走插件市场:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
重启 Claude Code 后看到 Memory loaded: X observations 即安装成功,健康检查用 npx claude-mem doctor。
社区实测的三个真实短板(来自头条、掘金等平台的中文测评和用户反馈,值得写文档前先知道):
- 它不解决单会话窗口满的问题——只让你在新会话里更快复用旧会话的精华,间接减少被迫开新会话的频率;
- 大项目会话启动变慢:注入的观察默认 50 条,可改
~/.claude-mem/config.json里的CLAUDE_MEM_CONTEXT_OBSERVATIONS到 20 起步; - 跨项目误召回:有用户反馈项目路径相邻时会召回隔壁项目的记忆,需要按路径手动清理记录(操作前先备份数据库)。
另外要分清隐私边界:claude-mem 的数据存在本地,但它不改变「对话内容本来就要发给模型 API」这个事实——<private> 标签防的是本地文件泄露,不是云端。
OpenViking 是什么:给 Agent 建一套「上下文操作系统」
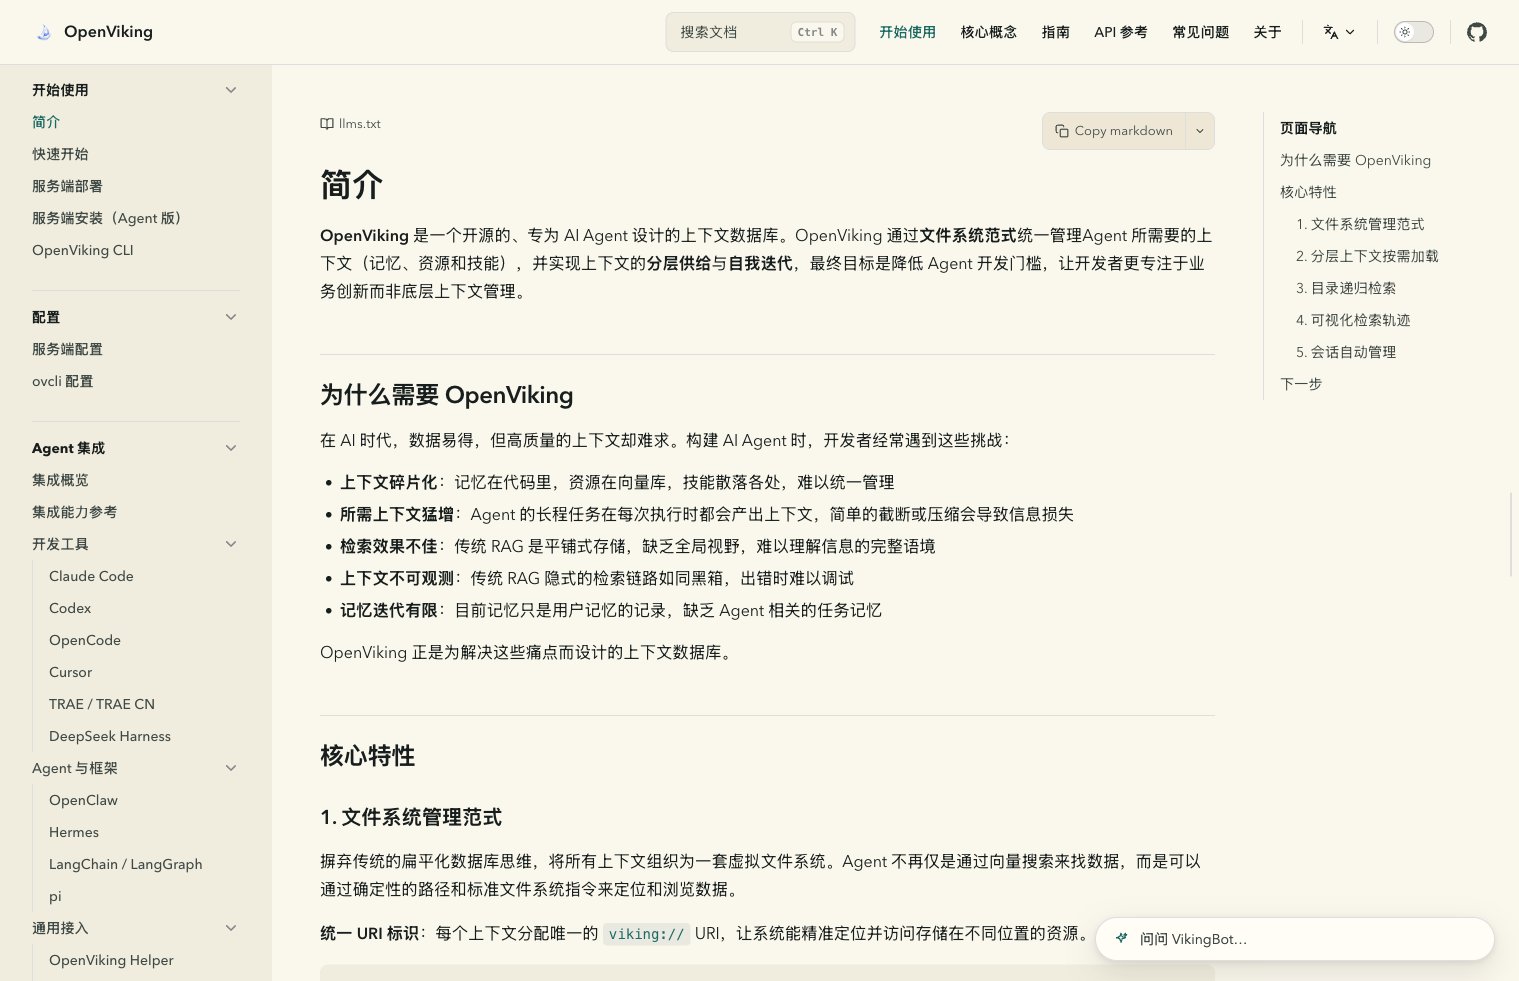
OpenViking 由字节跳动火山引擎 Viking 团队开发并开源,定位是"专为 AI Agent 设计的上下文数据库",目前在快速迭代中(火山引擎官方文档使用的版本为 0.4.15,GitHub 最新 Release 已到 v0.4.16)。
三个核心设计:
1. 文件系统范式。所有上下文组织成一棵 viking:// 虚拟文件树:resources/ 放项目文档和代码库,user/{id}/memories/ 放用户记忆,agent/skills/ 放全局技能。Agent 用确定性路径 + 语义搜索两种方式定位数据。
2. 分层上下文按需加载。写入时自动处理成三层:L0 摘要(256 字符,用于向量搜索)、L1 概览(4000 字符,用于精排和导航)、L2 完整内容(按需加载)。不用把海量上下文一次性塞进提示词,省钱也不引噪声。
3. 可观测的检索链路。提供目录递归检索策略和可视化检索轨迹(Web Studio UI),出错能调试——这是对传统 RAG「黑箱检索」的直接回应。
快速启动用 Docker,默认在 1933 端口起 API 服务(同一端口附带 Web Studio UI):
docker run -d -p 1933:1933 volcengine/openviking
(以官方 Quick Start 文档 为准)
集成面比 claude-mem 宽得多(下图为 OpenViking 的 GitHub 仓库):
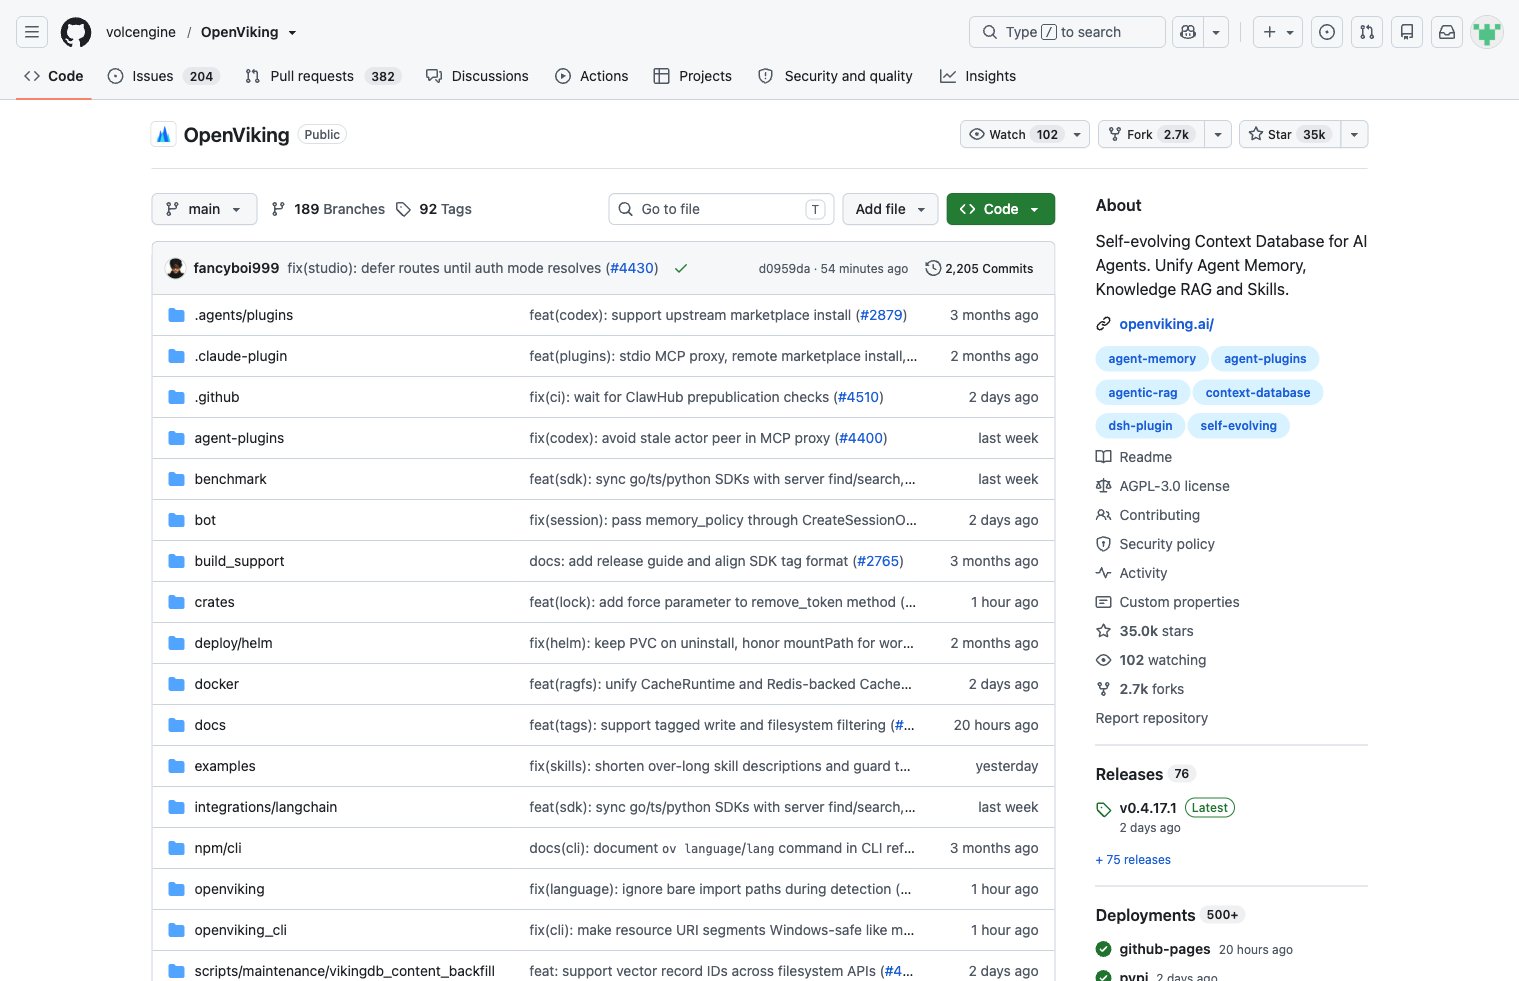
OpenViking 官方文档列出了 Claude Code、Codex、OpenCode、Cursor、TRAE、DeepSeek Harness、OpenClaw、Hermes、LangChain/LangGraph 以及通用 MCP 客户端接入。也就是说,OpenViking 也能给 Claude Code 供上下文——但它是把自己当成所有 Agent 共用的记忆后端,而不是一个「装完即忘」的插件。
核心对比:5 个维度看差异
| 维度 | claude-mem | OpenViking |
|---|---|---|
| 部署门槛 | 一条命令,本地跑 | 需部署服务端(Docker),多一步运维 |
| 数据位置 | 本地 SQLite + Chroma,隐私可控 | 服务端集中存储,适合团队共享 |
| 能力范围 | 记忆捕获 / 摘要 / 回注,围绕编码会话 | 记忆 + 资源 + 技能三类上下文统一管理 |
| 适用对象 | 个人开发者(Claude Code / Cursor / Codex CLI 等 IDE 用户) | Agent 开发团队、自研 Agent 产品 |
| 生态方向 | Claude Code 插件生态(含 OpenClaw 网关、云同步 Pro 服务) | 火山引擎生态(火山方舟文档、企业级集成) |
怎么选,其实就是三个问题:
- 你是「用 Agent」还是「做 Agent」? 用现成 IDE 写代码 → claude-mem;开发 Agent 应用 → OpenViking。
- 数据能不能出本机? 涉及公司代码、敏感项目,本地优先 → claude-mem;要团队共享记忆 → OpenViking。
- 要不要管「技能」和「资源」? 只需要记性 → claude-mem 够用;要把工具调用能力(Skill)、知识库(Resource)、记忆(Memory)统一治理 → OpenViking。
两个典型场景的实际选法
场景 A:自由开发者,Claude Code 重度用户。 选 claude-mem。理由:安装零摩擦、数据在本地、自动生成 CLAUDE.md 还能沉淀成项目文档。配合「重要决策写进 CLAUDE.md、过程踩坑交给 claude-mem」的分工,记忆质量最稳——这也是社区测评验证过的最佳实践:CLAUDE.md 当权威结论,claude-mem 记录辅助过程。
场景 B:团队在做一个需要长期记忆的 Agent 产品。 选 OpenViking。理由:用户偏好、任务经验这类「任务记忆」需要跨用户、跨会话的集中管理和迭代;分层加载直接控制 token 成本;可视化检索轨迹让线上问题可排查。这些都不是一个 IDE 插件能承担的。
如果你正在评估 Agent 相关的技术选型,也建议同时看看这两篇:ChatGPT Work 和 Claude Cowork 怎么选(办公 Agent 选型思路类似),以及 Anthropic MHS 是什么(Agent 操控物理世界的另一块拼图)。
总结
- claude-mem:插件级记忆方案,一条命令安装,本地运行,适合用 Claude Code / Cursor 写代码的个人开发者,社区口碑的共识是「跨会话记忆确实省心,但要接受启动变慢和偶发误召回」。
- OpenViking:基础设施级上下文数据库,字节开源、快速迭代中,适合给自研 Agent 建统一的记忆 / 资源 / 技能体系,团队场景才是它的主场。
- 判断标准只有一条:你是给自己装记性,还是给你的 Agent 产品建记忆。
最后更新于 2026 年 9 月 2 日。两款工具都在快速迭代(OpenViking 处于 v0.4.x 阶段),价格、版本与功能以官方文档为准。
作者:AI345 AI 指南编辑部。我们持续实测和追踪 AI 工具与模型动态,往期内容可从 AI 指南首页 进入。
参考资料(均为官方或一手来源):
常见问题
claude-mem 和 Claude Code 自带的 CLAUDE.md 有什么区别?
答:CLAUDE.md 是纯手动维护的静态文档,Claude Code 启动时读取,透明可靠但不会自动更新。claude-mem 把记忆变成「自动挡」:自动记录、自动摘要、自动注入,还会自动写回带时间线的项目 CLAUDE.md。最佳实践是两者配合:结论性决策写 CLAUDE.md,过程性踩坑交给 claude-mem。
OpenViking 是免费的吗?
答:OpenViking 是字节火山引擎开源的项目,代码在 GitHub 公开,自己部署使用不需要付软件授权费用。如果使用火山引擎方舟相关的托管或配套云服务,则按火山引擎的定价计费,以官方页面为准。
claude-mem 支持中文吗?会不会影响中文项目?
答:支持。claude-mem 官方提供 28 种语言模式,中文是其中之一,中文用户可以直接用中文模式交互。社区中文教程(知乎、掘金、CSDN)均验证过中文项目的记录与召回可用。
claude-mem 和 OpenViking 可以一起用吗?
答:技术上不冲突(一个在本地、一个在服务端),但功能高度重叠——OpenViking 官方本身就提供 Claude Code 集成。对个人开发者而言二选一即可,同时跑两套记忆反而会出现「两份记忆互相打架」的问题。建议先跑 claude-mem(成本更低),确有团队级需求再迁 OpenViking。
claude-mem 会把我的代码上传到云端吗?
答:观察记录和摘要都存在本地 SQLite 与 Chroma 中,官方还有云同步(cmem.ai Pro)但属于可选 Beta 服务。要注意的是:你的对话内容本身仍会发送给所使用的模型 API(如 Anthropic),这是使用任何 AI 编码工具都绕不开的,与是否安装 claude-mem 无关。
搜到的 "mapalace" 是什么工具?
答:经全网核查,"mapalace" 并不是真实存在的 AI 产品,各大搜索引擎均没有它的产品条目,大概率是搜索时的拼写混淆或以讹传讹。目前与 OpenViking 同场景的公开方案对比,主流讨论就是 claude-mem(插件级)与 OpenViking(数据库级),本文的对比结论直接适用。
 京ICP备2024094994号-29