
数字人是什么?一次讲透口播数字人的技术链路与带货玩法
数字人是用技术做出来的「看起来像人、能开口说话」的虚拟形象。它可以是凭空捏造的一张脸,也可以是克隆某个真人。你刷到的口播带货、新闻播报里的虚拟主播,大多数都是数字人在工作。
数字人是什么:给形象装上嘴和大脑
把数字人理解成「皮影戏的现代版」最直观:过去是人躲在幕后操纵皮影,现在是模型躲在幕后操纵一张脸。按驱动方式,市面上的数字人基本分两类。
- 真人驱动:真人在镜头前说话做表情,算法实时把动作迁移到虚拟形象上,也就是常说的动作捕捉和表情迁移,虚拟主播多用这种;
- AI 驱动:给一段文字或录音,模型直接生成对应口型和动作的视频,口播数字人、数字人直播走的多是这条路。
判断一个数字人的技术含量,主要看第二条路走得好不好:嘴型和声音对不对得上、表情僵不僵、像不像真人。
口播数字人是怎么一步步做出来的
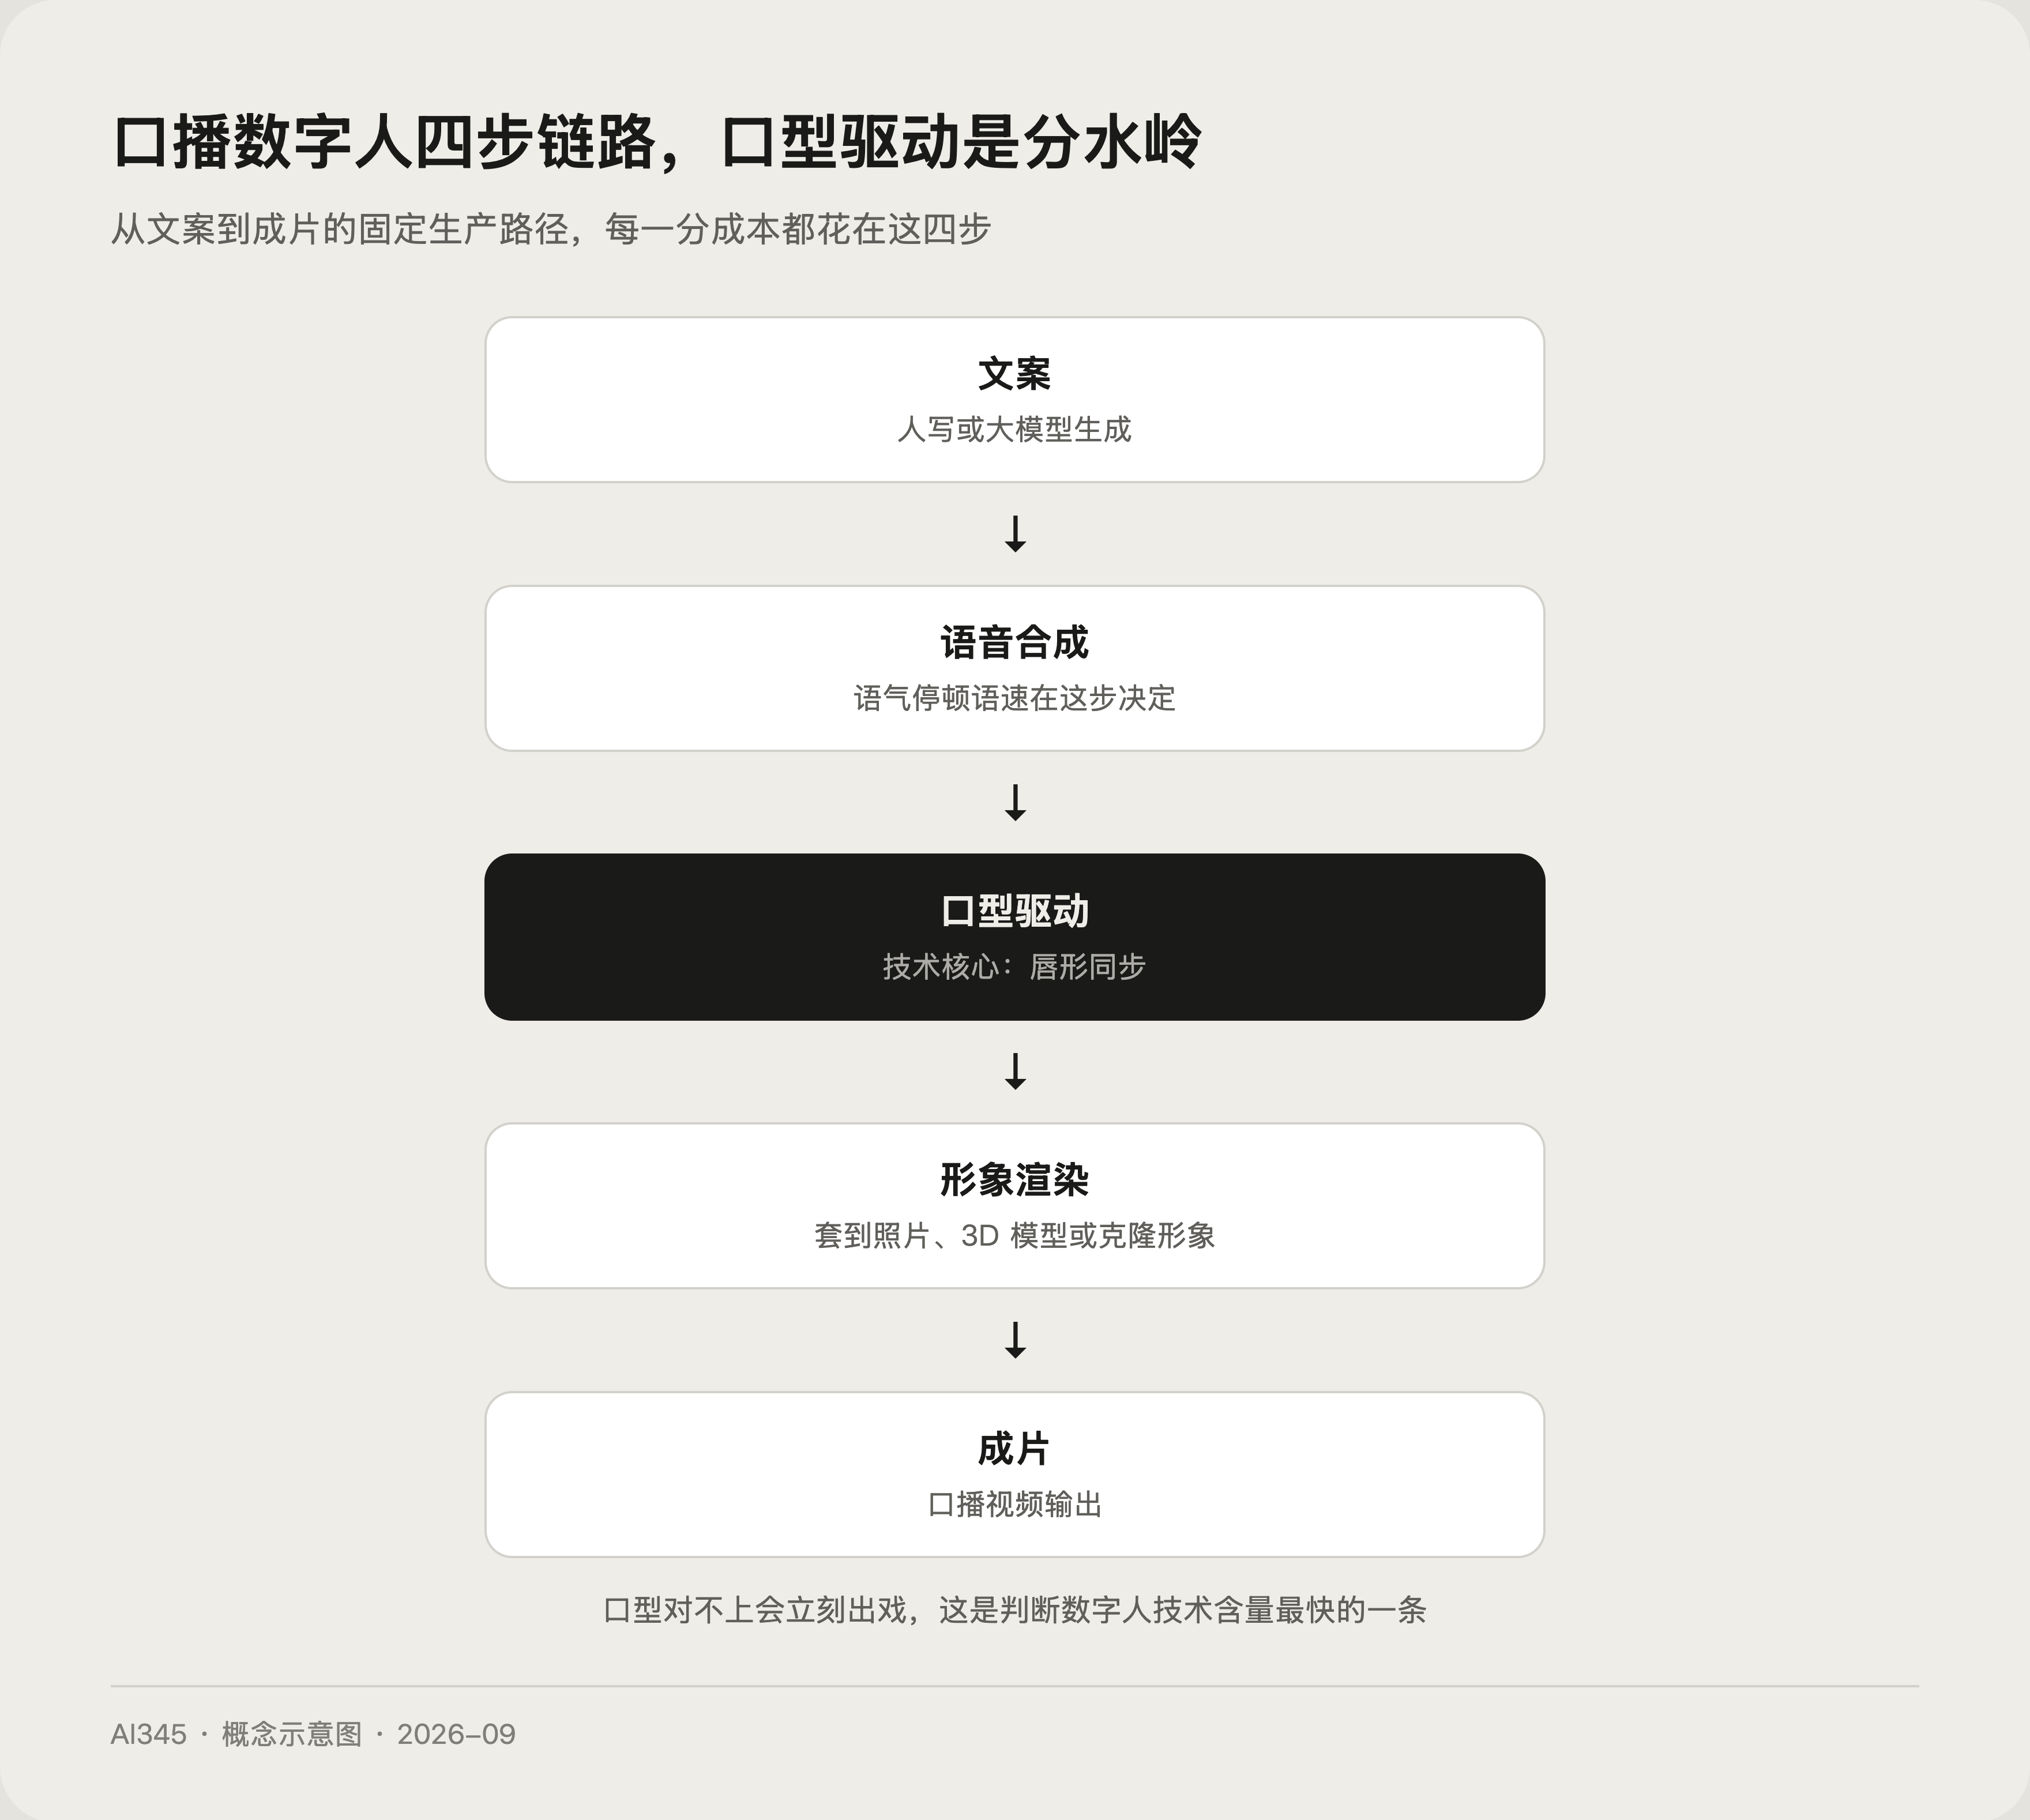
一条口播数字人视频,生产链路固定为四步,理解它就知道每一分成本花在哪、翻车点在哪。
- 文本生成:先有要说的话,人写或大模型生成都行;
- 语音合成:把文字变成带感情的人声,语气停顿语速都在这步决定;
- 口型驱动:技术核心,让嘴唇和语音逐帧对齐,学界叫唇形同步。2020 年的 Wav2Lip 用唇形同步判别器纠偏,让任意人像的口型贴合给定语音,同步准确度接近真实视频,代码开源至今仍被广泛使用(见 Wav2Lip 论文与 官方开源项目);
- 形象渲染:把口型和表情套到 2D 照片、3D 模型或克隆形象上,输出成片。
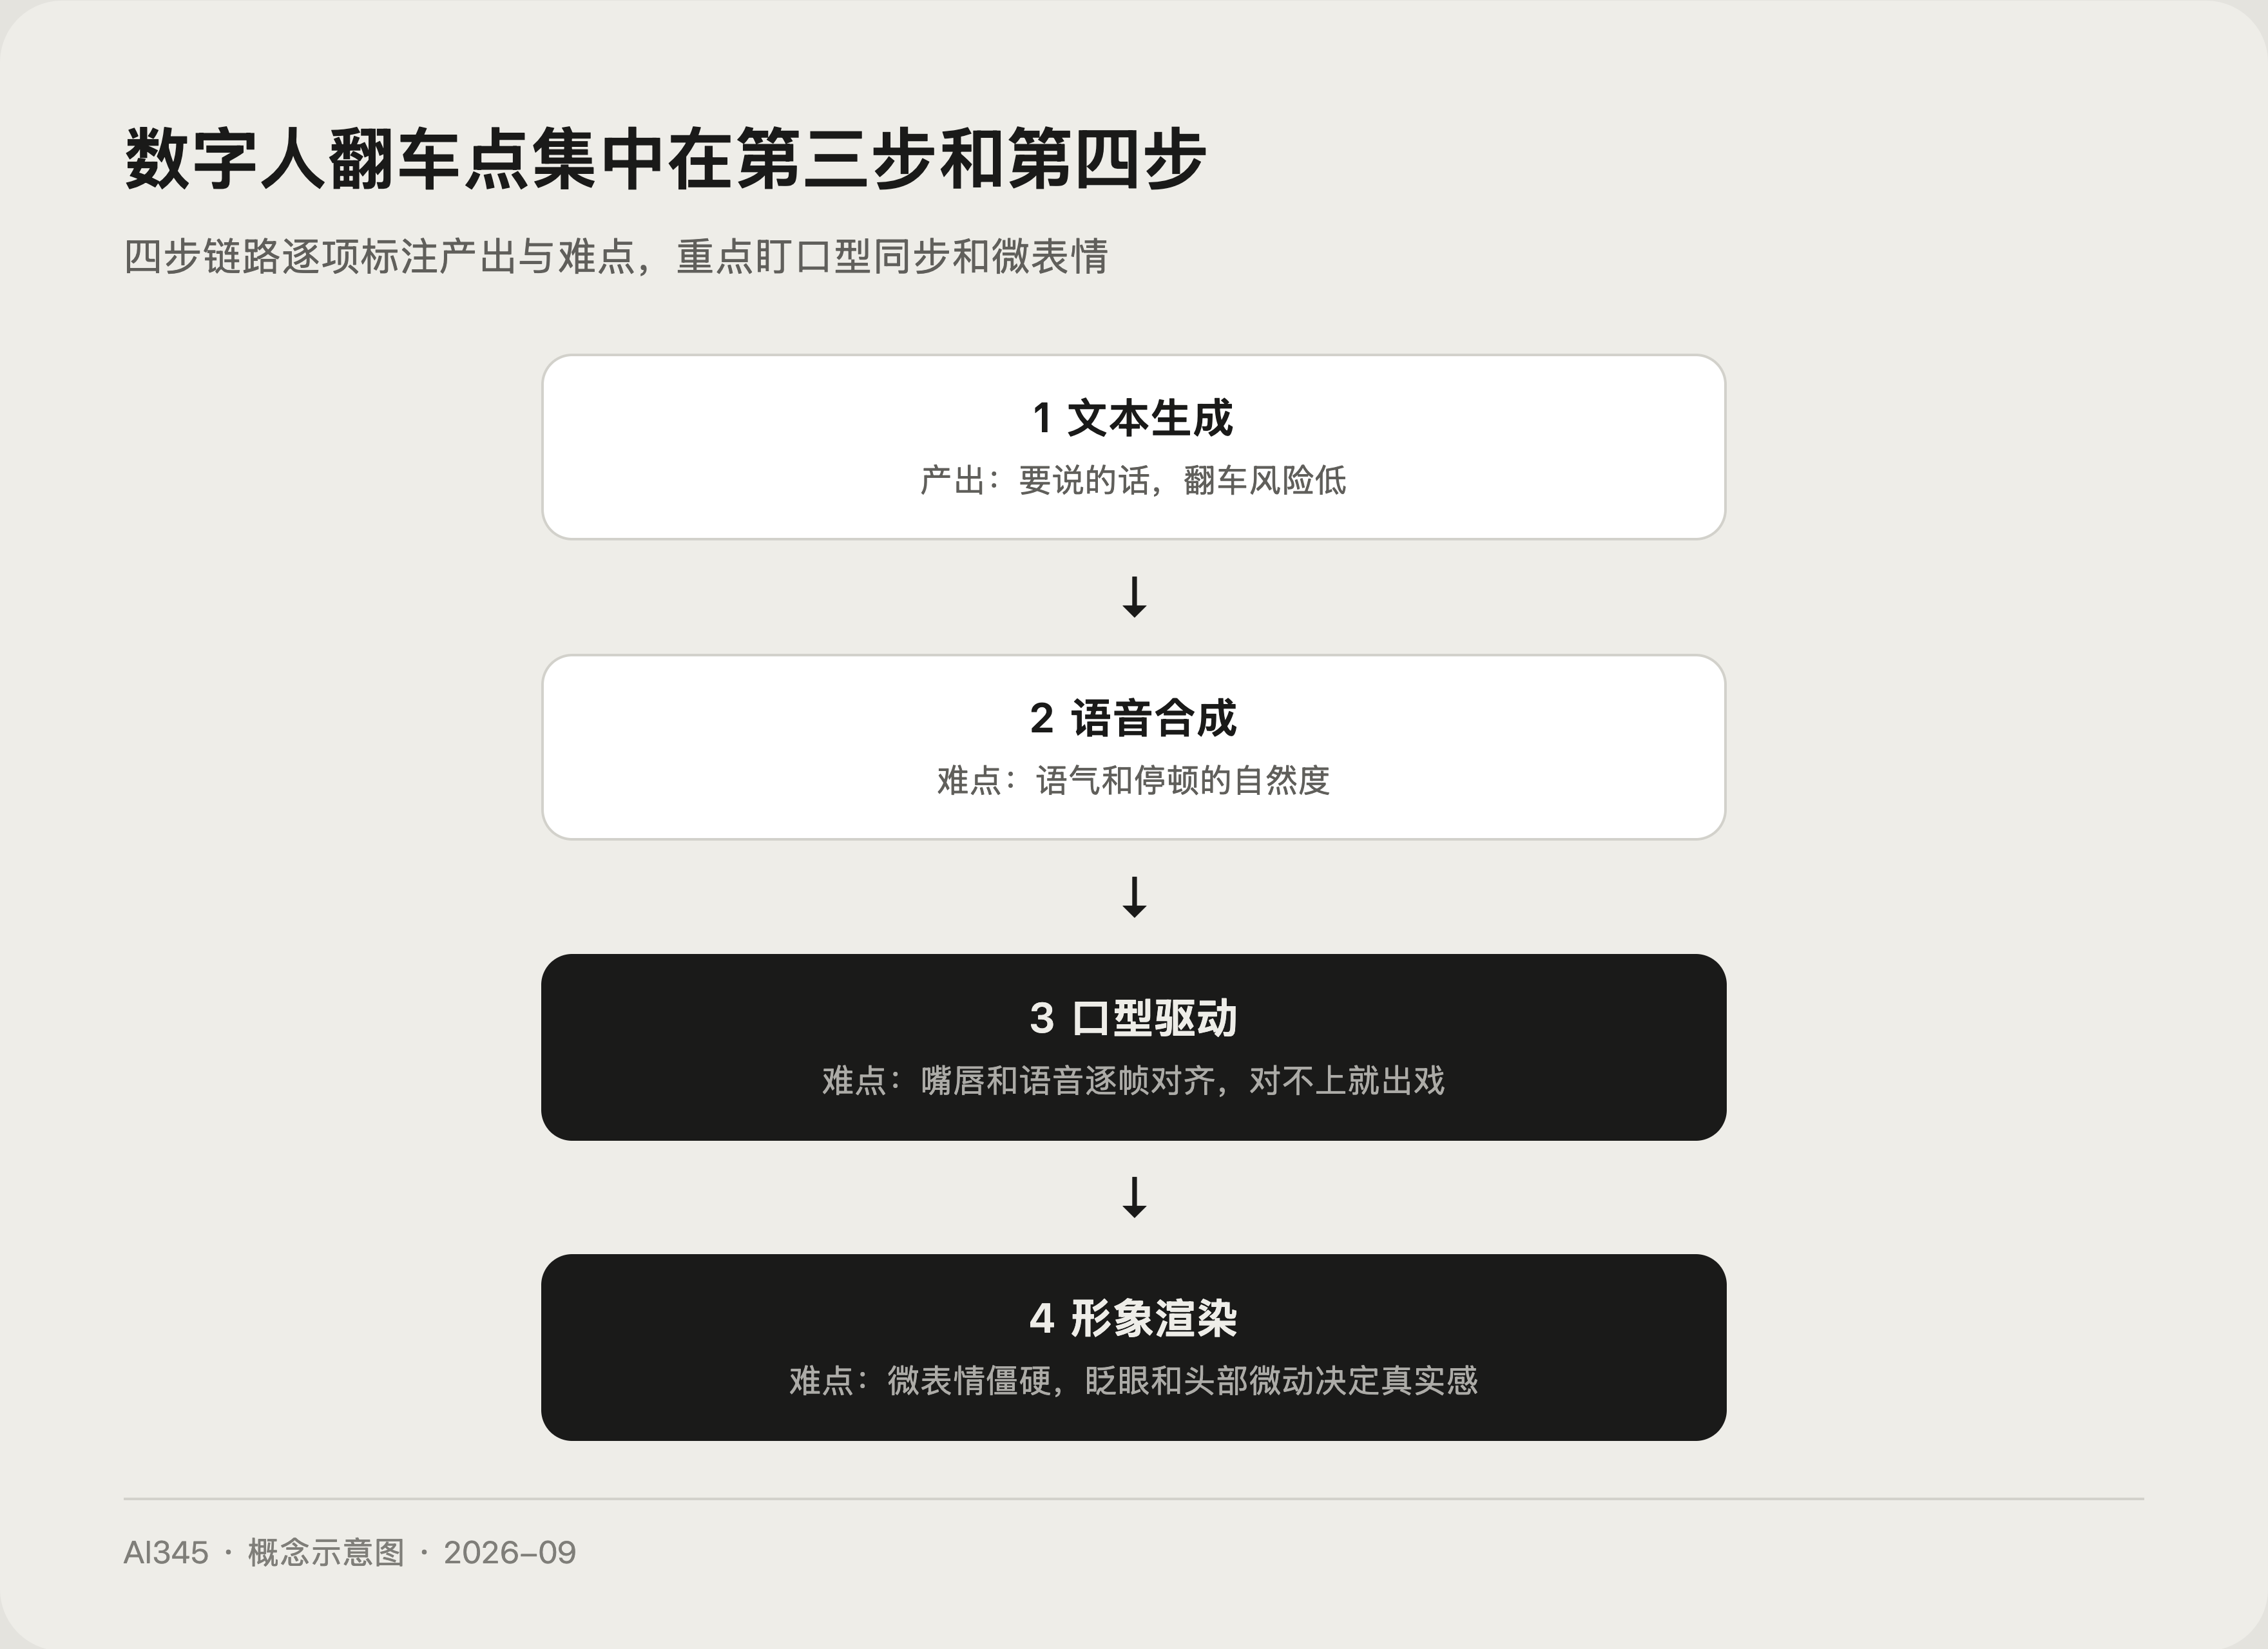
翻车高发区在第三步和第四步:口型对不上会立刻出戏,表情僵硬多半是驱动模型没学好微表情。
直播带货里的数字人:能干什么,边界在哪
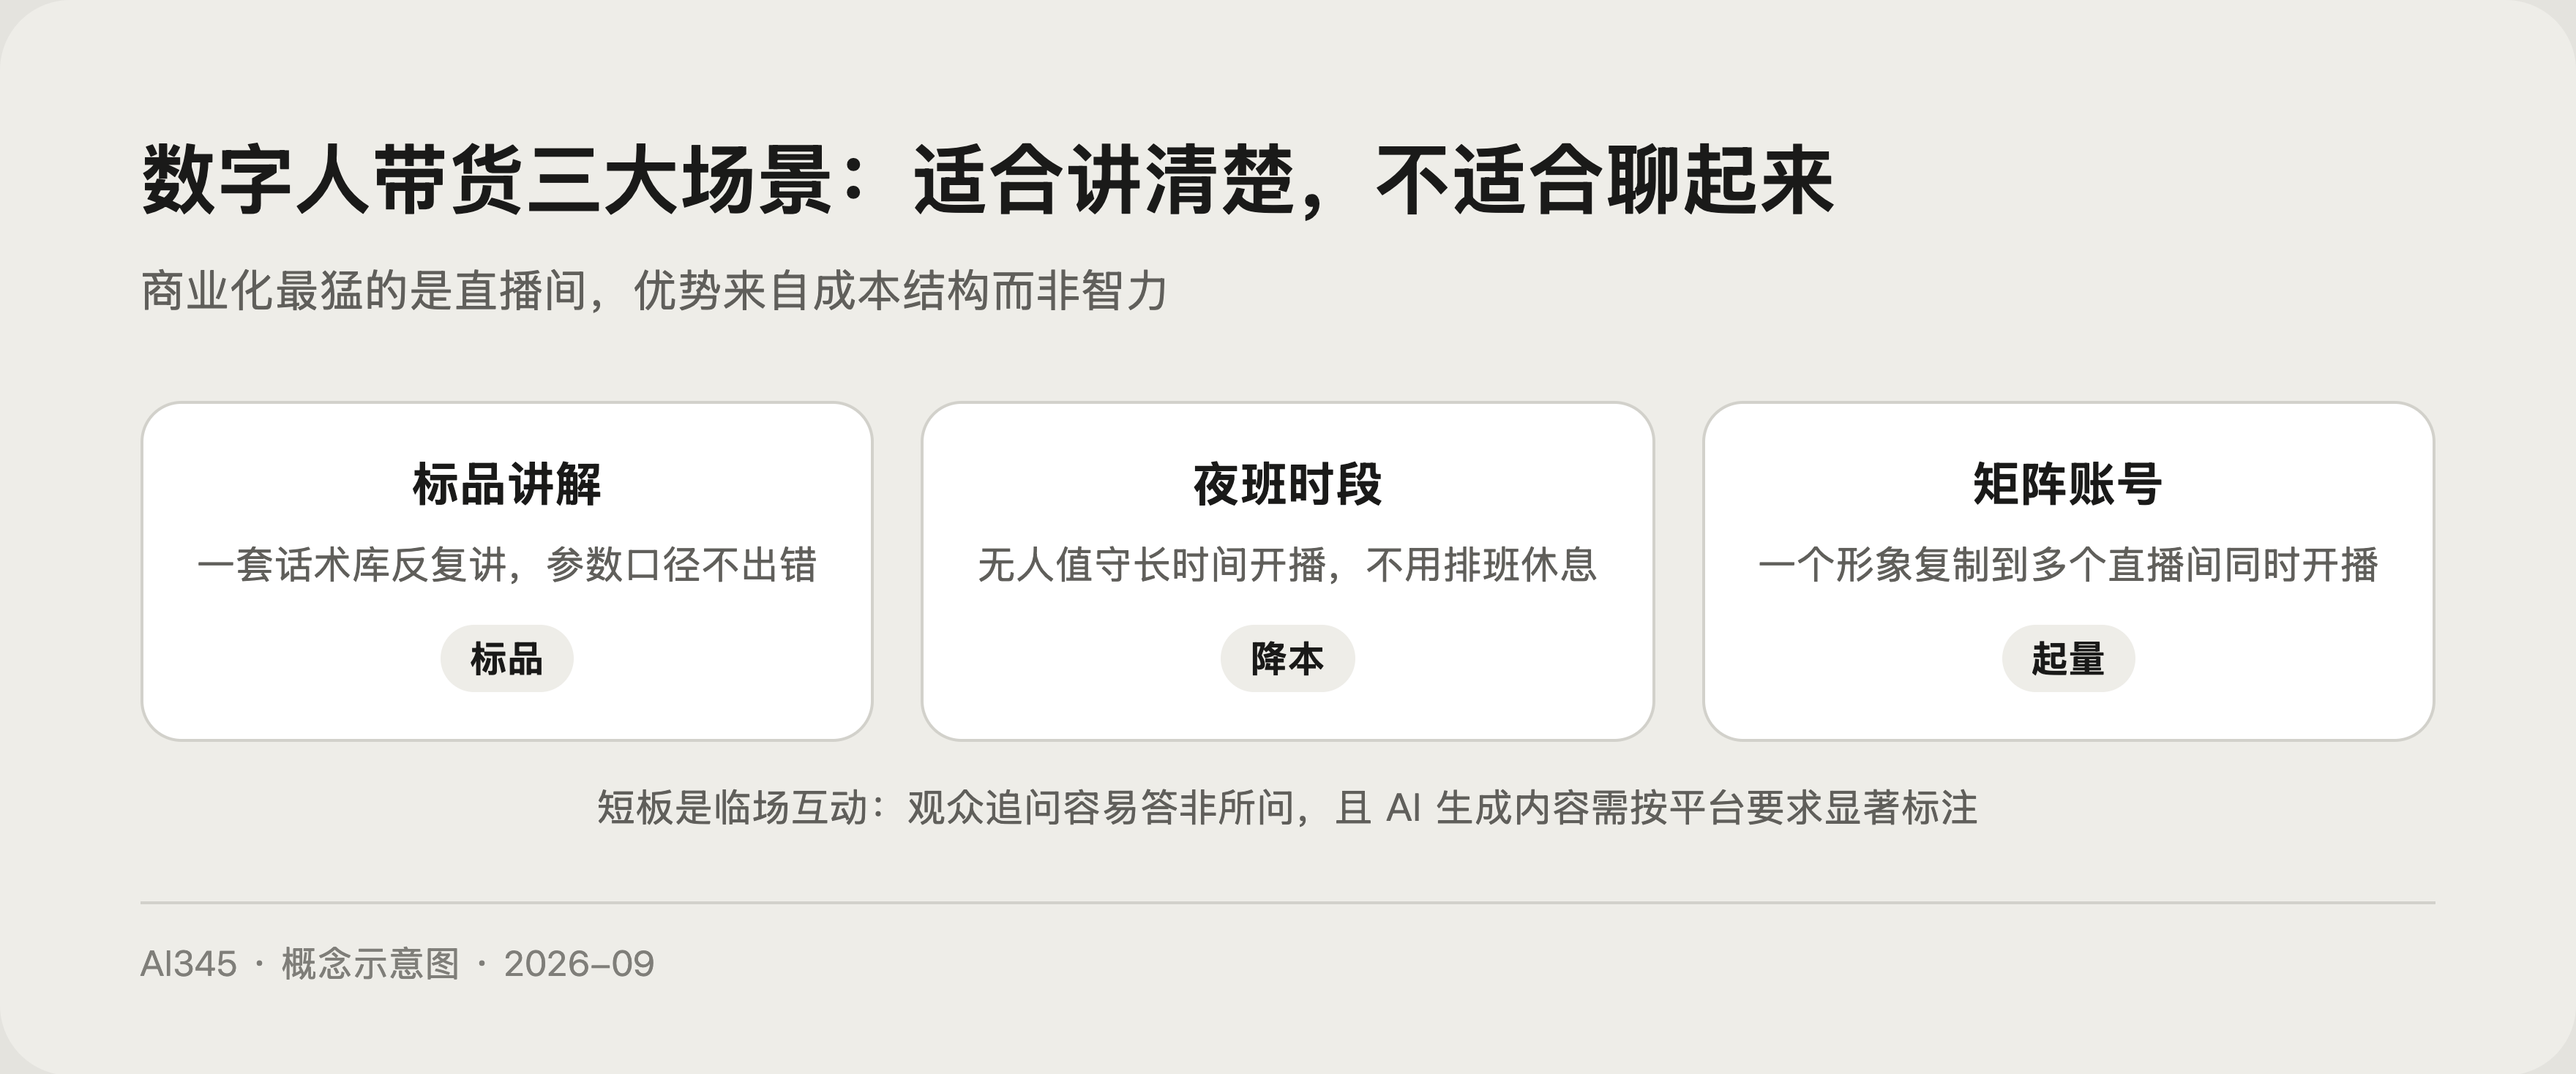
直播间是数字人商业化最猛的场景。它的吸引力来自成本结构:真人主播要排班、要休息,数字人可以拿着一套话术库长时间开播,特别适合标品讲解、夜班时段和矩阵账号。
但边界同样清楚:
- 口播数字人擅长照稿讲解,不擅长临场互动,观众追问时容易答非所问;
- 带货涉及信任和合规,克隆真人形象必须拿到本人授权,虚拟形象也要遵守平台对 AI 生成内容的标识要求;
- 主流平台普遍要求对 AI 生成的直播内容做显著标注,未标注有被限流或下架的风险。
一句话总结:数字人适合「讲清楚」,不适合「聊起来」。
一段话讲清数字人
「数字人是用 AI 生成的、能说话有表情的虚拟人形象,分真人驱动和 AI 驱动两条路线。口播数字人的链路是文本到语音合成、语音到口型驱动、再套上形象渲染输出成片,核心技术卡点是唇形同步和微表情自然度。商业化上它适合标准化口播场景,比如电商讲解和新闻播报,短板是临场互动。」
追问大概率落在两个方向:怎么评估数字人像不像真人,通常看口型同步程度和观众留存;数字人直播的合规红线,重点是本人授权和 AI 内容标识。
数字人和语音、多模态是什么关系
数字人是多模态的集大成场景,语音视觉文本缺一不可。语音合成和识别的进展,决定数字人的「嗓子」和「耳朵」好不好使。延伸阅读三篇:多模态大模型是什么、微软开源语音识别 VibeVoice ASR 解读、语音转文字模型 MAI-Transcribe-2 全解。
常见问题
数字人和 VTuber 虚拟主播有什么区别?
答:VTuber 通常由真人实时驱动,背后有一个真人在表演;口播数字人多数由 AI 从文本直接生成,不需要真人出场。看「幕后有没有人」是最快的判断方法。
做一条口播数字人视频需要准备什么?
答:最少要准备两样:一段文案和一个授权形象(照片或录音)。剩下由工具链完成,成片质量的关键在口型同步和语气自然度。
克隆别人的声音和脸做数字人违法吗?
答:未经授权克隆涉及肖像权和个人信息保护等问题,商用必须拿到本人明确授权,并遵守平台对 AI 生成内容的标识要求,否则有法律和下架风险。
数字人会取代真人主播吗?
答:会替代一部分标准化口播工作,但临场互动、信任型销售仍然依赖真人。更可能的走向是分工:数字人管长时段讲解,真人管直播间的关键互动。
为什么有的数字人一眼就假?
答:多半卡在口型不同步和微表情僵硬,也就是链路第三步、第四步没做好。眨眼频率、头部微动这些细节,比画质更能决定真实感。
 京ICP备2024094994号-29