
腾讯 AuK 是什么?1.5B 开源语音模型,一句话指令改写音频
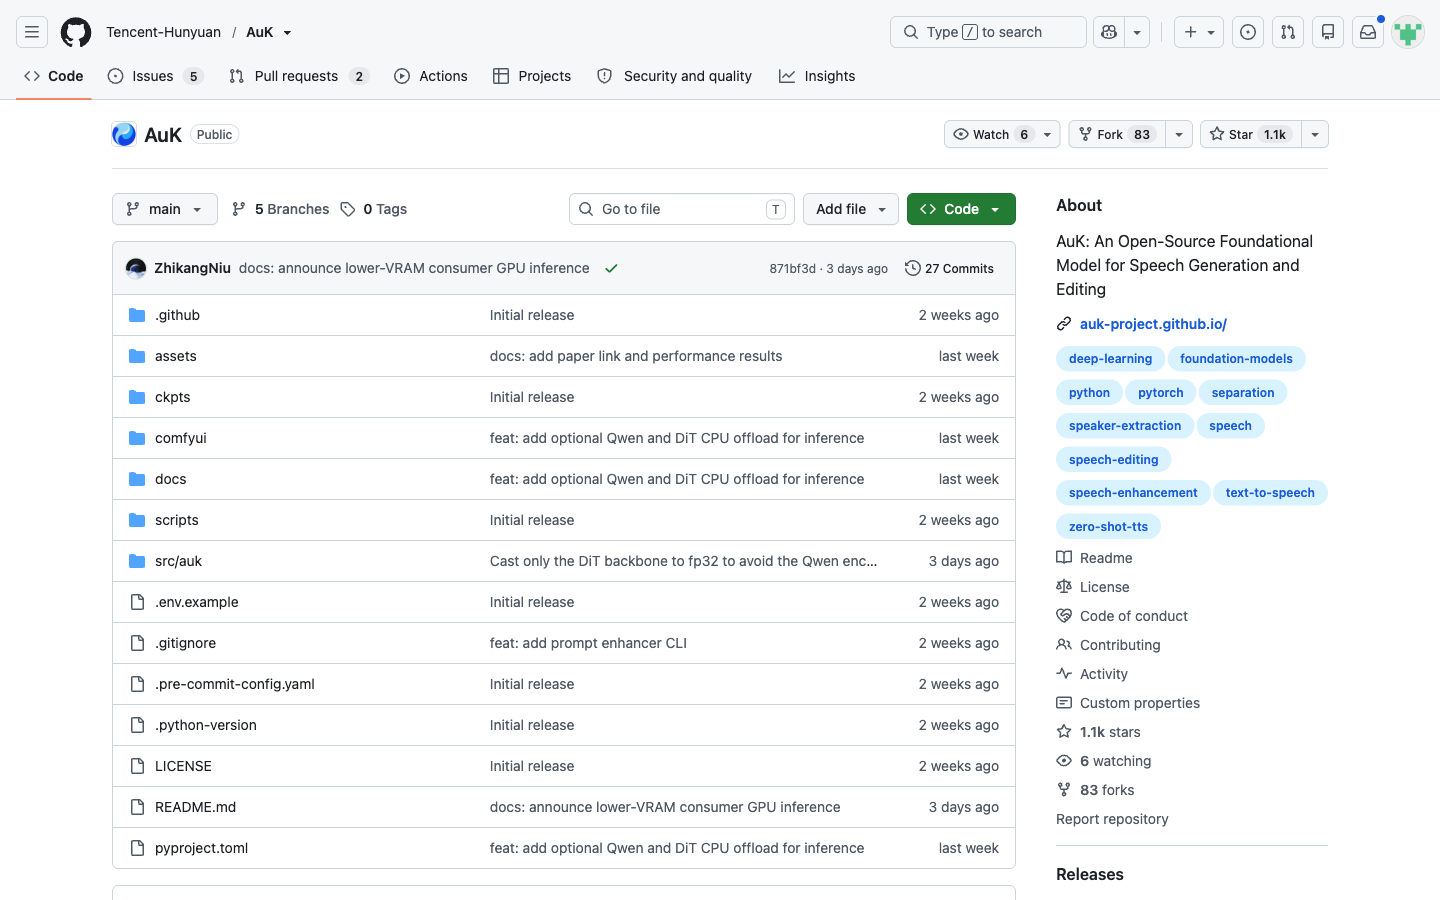
想知道腾讯 AuK 是什么,答案就一句话:它是腾讯混元联合上海交通大学等机构在 2026 年 9 月 9 日开源的 1.5B 语音基础模型,MIT 协议,一句自然语言指令就能做语音生成、内容编辑、语气编辑、人声增强和音轨分离。代码在 GitHub 的 Tencent-Hunyuan/AuK,权重同时发布于 Hugging Face 与 ModelScope。
AuK 是什么:一个模型吃掉五类语音任务
AuK 是 1.5B 参数的基础模型,训练数据来自数百万小时多语种音频。它最大的特点是接口统一:文字转语音、改一句话的内容、把哭腔换成平静语气、从混音里拆伴奏,全都不用换模型,换一句指令就行。
官方提供两个版本:AuK 质量优先,NFE 和 CFG 可调;AuK-Flash 是蒸馏版,固定 4 步推理、CFG=0,速度优先。论文摘要给出的训练规模是约 30.3 亿条指令与音频配对实例、195 万小时有效监督。
它能做的 18 类任务
官方 Cookbook 把所有任务挂在同一套指令接口下,按大类归拢是这样:
| 大类 | 代表任务 | 一句话说明 |
|---|---|---|
| 语音生成 | 零样本 TTS、指令 TTS | 用参考音频的音色说话,或只凭一段音色描述生成语音 |
| 内容编辑 | 语音内容编辑、歌词编辑 | 替换、插入、删除说的内容,翻唱改词还能保住旋律和音色 |
| 声学编辑 | 音高、语速、音量 | 按半音调音高,按倍率改语速,按分贝调音量 |
| 副语言编辑 | 情绪、音色、去口音、非语言音、气声转换 | 换情绪不改内容,去地方口音,删掉或补上呼吸声与笑声 |
| 增强与分离 | 语音增强、语音分离、音乐分离、目标说话人提取 | 去噪去混响,按说话顺序留一个人,从混音里抽人声或伴奏 |
对内容团队来说,最实用的是副语言编辑和分离:以前改录音语气要重录、拆伴奏要另找工具,现在都能写成指令批量处理。
关键数据:速度与显存
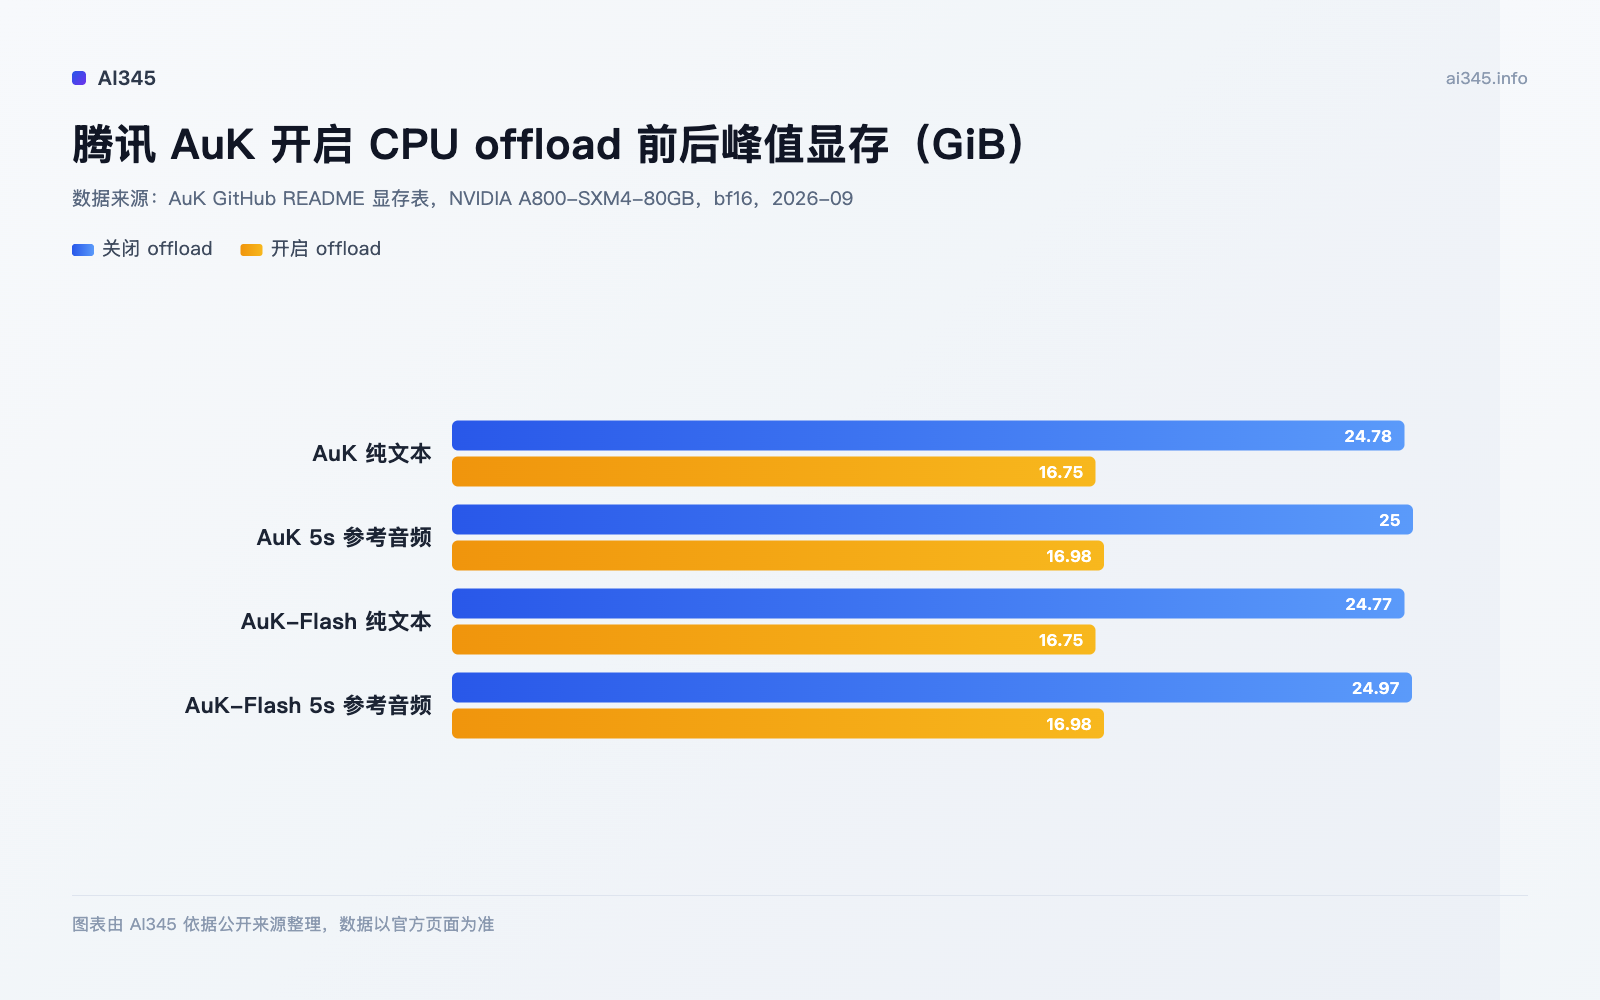
官方称 AuK-Flash 在匹配条件下能拿到 4.5 倍墙钟加速,代价是质量略低于基础模型。显存方面,官方在单张 NVIDIA A800-SXM4-80GB 上以 bf16 推理测得峰值如下,单位 GiB:
| 模型 | 输入 | CPU offload 关 | CPU offload 开 | 节省 |
|---|---|---|---|---|
| AuK | 纯文本,1.5 秒输出 | 24.78 | 16.75 | 8.03(32.4%) |
| AuK | 5 秒参考音频 | 25.00 | 16.98 | 8.02(32.1%) |
| AuK-Flash | 纯文本,1.5 秒输出 | 24.77 | 16.75 | 8.02(32.4%) |
| AuK-Flash | 5 秒参考音频 | 24.97 | 16.98 | 7.99(32.0%) |
官方口径是 torch.cuda.max_memory_allocated,实际占用随输入长度、精度和硬件变化。
最近三次更新,对国内用户意味着什么
- 2026 年 9 月 13 日加入 Apple Silicon 的 MLX 推理支持,代码在 feat/mlx-apple-silicon 分支,同时给 CUDA 推理加了 CPU offload,Mac 用户有了云 GPU 之外的选项。
- 2026 年 9 月 16 日,PR #19 把编码器显存再降约 7.5 GiB,官方说法是让消费级 GPU 的本地推理更可行。
- 同期 AuK 被选为 ICASSP 2027 Audio Editing Challenge 单模型赛道的端到端基线,SGLang-Omni 在开源当天完成了支持。
行动指引:想先听效果,直接去 Hugging Face 的 tencent/AuK Space 或 ModelScope 演示空间,不用装环境;想本地跑,优先从 ModelScope 下权重,国内更稳。
本地部署要准备什么
- 克隆 Tencent-Hunyuan/AuK 仓库,用 uv 或 conda 建 Python 3.10 的独立环境,按需安装核心推理、gradio、comfyui 或 train 这几组依赖。
- 下载三个目录:AuK 基础权重、可选的 AuK-Flash、以及作为 MLLM 编码器的 Qwen2.5-Omni-3B。
- 用 auk-infer 跑命令行推理,或用 auk-gradio 起一个网页界面,加上 --cpu_offload 可以进一步压低显存。
有一个坑必须提前知道:权重里的 checkpoint 只包含 diffusion transformer 和 layer-fusion 部分,MLLM 编码器和 VAE 是在运行时从其他文件加载的。所以加载时看到 text_encoder.* 这类 key 缺失属于预期现象,不是下载不完整。环境准备那套流程和站内 腾讯混元 Hy-MT2 的 Ollama 本地部署教程 很接近,可以直接复用。
放在腾讯 AI 产品线里看
2026 年腾讯在 AI 侧的节奏明显加快:编程侧有 CodeBuddy 的三种形态,输入法方向有被曝光的 ChatterFly,通用助手方向有 WorkBuddy。AuK 补的是语音这条线,路线与前几个不同:它是开源权重加开源代码,不是先做商业 SaaS,开发者可以先本地验证效果再决定要不要上生产。
适合谁用,不适合谁
适合要把语音编辑做成批量流程的内容团队,比如短视频配音、播客降噪、批量拆人声;也适合不想把音频上传第三方 API 的团队,以及需要可微调权重的研究者。
不适合只想快速生成一段配音、完全不碰环境的用户;不适合需要稳定 SLA 和商业支持的业务,官方项目页明确写了这是作者维护的独立页面;也不适合显存吃紧又不想用 CPU offload 换速度的小显卡用户。
另外,官方自评的对比图只能当参考,混响、信噪比、说话人相似度这些指标对测试集依赖很大,建议用你自己的素材跑一轮再下结论。
常见问题
腾讯 AuK 是免费的吗?
答:权重和代码以 MIT 协议开源,本地使用免费。官方没有公布托管 API 的定价信息,需要商用支持可以通过项目仓库联系作者。
AuK 和 AuK-Flash 怎么选?
答:要质量选 AuK,NFE 和 CFG 可调;要速度选 AuK-Flash,固定 4 步推理且不用 CFG,官方称匹配条件下有 4.5 倍墙钟加速。实际项目里可以先用 Flash 验证流程,再换基础模型出终版。
最低需要多大显存?
答:官方在 A800 80GB 上测得开启 CPU offload 后峰值约 16.75 GiB,关闭时约 24.78 GiB。9 月 16 日的更新又把编码器显存降了约 7.5 GiB,具体下限建议自行实测。
国内怎么下载权重?
答:官方同时提供 Hugging Face 和 ModelScope 两个渠道,国内推荐走 ModelScope,命令是 modelscope download --model Tencent-Hunyuan/AuK --local_dir ./ckpts/AuK,编码器建议一起下 Qwen2.5-Omni-3B。
 京ICP备2024094994号-29