
StepAudio 3 是什么?阶跃星辰五款语音大模型一次讲清
StepAudio 3 是什么?简单说,它是阶跃星辰(StepFun)2026 年 9 月 15 日发布的最新一代语音大模型系列,一次推出 Realtime、ASR、TTS、Gen、Music 五款模型,分别负责实时语音交互、语音识别、真人级语音生成、完整音频内容生成和音乐创作,当天全部上线阶跃星辰开放平台。其中多款模型在第三方评测机构 Artificial Analysis 榜单位列全球第一:Realtime 交互综合得分 98.9%、语音推理准确率 99.7%、语音识别词错误率(WER)低至 1.7%。
想快速找到答案:五款模型分工看下一节,「全球第一」含金量看成绩单解读,上手方式看文末。
最后更新:2026 年 9 月 15 日
五款模型一览:一款管一件事
StepAudio 3 不是一款模型,而是按场景分工的模型家族:
| 模型 | 定位 |
|---|---|
| StepAudio 3 Realtime | 实时语音交互:全双工、能打断、边想边说 |
| StepAudio 3 ASR | 语音识别:中英方言混说、专业术语理解 |
| StepAudio 3 TTS | 真人级语音生成:能生成笑声、迟疑、改口 |
| StepAudio 3 Gen | 一次生成人声、音效、环境音、背景音乐 |
| StepAudio 3 Music | 歌曲创作、清唱配乐、翻唱 |
过去各家语音大模型多在单项能力上竞争,StepAudio 3 把听、说、理解、推理、创作补成一条完整产品线,官方称之为语音大模型进入「听说想做」阶段。
五款模型分别能做什么
Realtime:从能聊天到能一起干活。 支持原生全双工对话:用户和模型可以同时说话,被打断会及时停下,随口附和不会被当成新指令;简单问题秒回,复杂任务边想边说;Tool Call 和长任务异步执行,任务运行期间对话不中断。
ASR:从听清到听懂。 把高精度识别和大语言模型的知识推理结合,支持中文、英文、方言、中英混说、长音频和医疗、法律、金融等专业领域,还能处理低声、快语速、含糊连读和背景音乐等复杂输入。找开源方案的话,可以对比我们写过的小米开源语音识别模型 CocktailASR-1 详解。
TTS:会笑、会迟疑、会改口。 在音色、语调、节奏之外,能生成笑声、迟疑、结巴、改口这些真实交流里的副语言,流式架构下生成和播放同步进行。副语言恰恰是机器味和人味的分界线。
Gen:一句话生成完整声音场景。 传统流程里配音、环境音、音效、配乐要分开制作再混音,Gen 用自然语言一次生成带完整声音层次的音频,还能指定每类声音出现的时间和顺序。
Music:支持清唱配乐。 不止一句话生成一首歌,还支持丢一段歌词、清唱或 ABC 记谱让模型接着编曲;哼一段旋律,模型自动补和声、节奏、乐器,输出含主歌副歌桥段的完整作品。
成绩单解读:「全球第一」的含金量有多少
Artificial Analysis 是独立第三方 AI 模型评测机构,语音榜单是业内评估原生语音模型引用最多的基准之一,成绩不背书厂商。三项第一:
- 对话动态 98.9%:Realtime 全球第一,考核对话节奏与打断处理;
- 语音推理 99.7%:Realtime 全球第一,考核直接听音频做复杂推理;
- 非流式语音识别 WER 1.7%:ASR 并列全球第一,WER 越低转写越准。
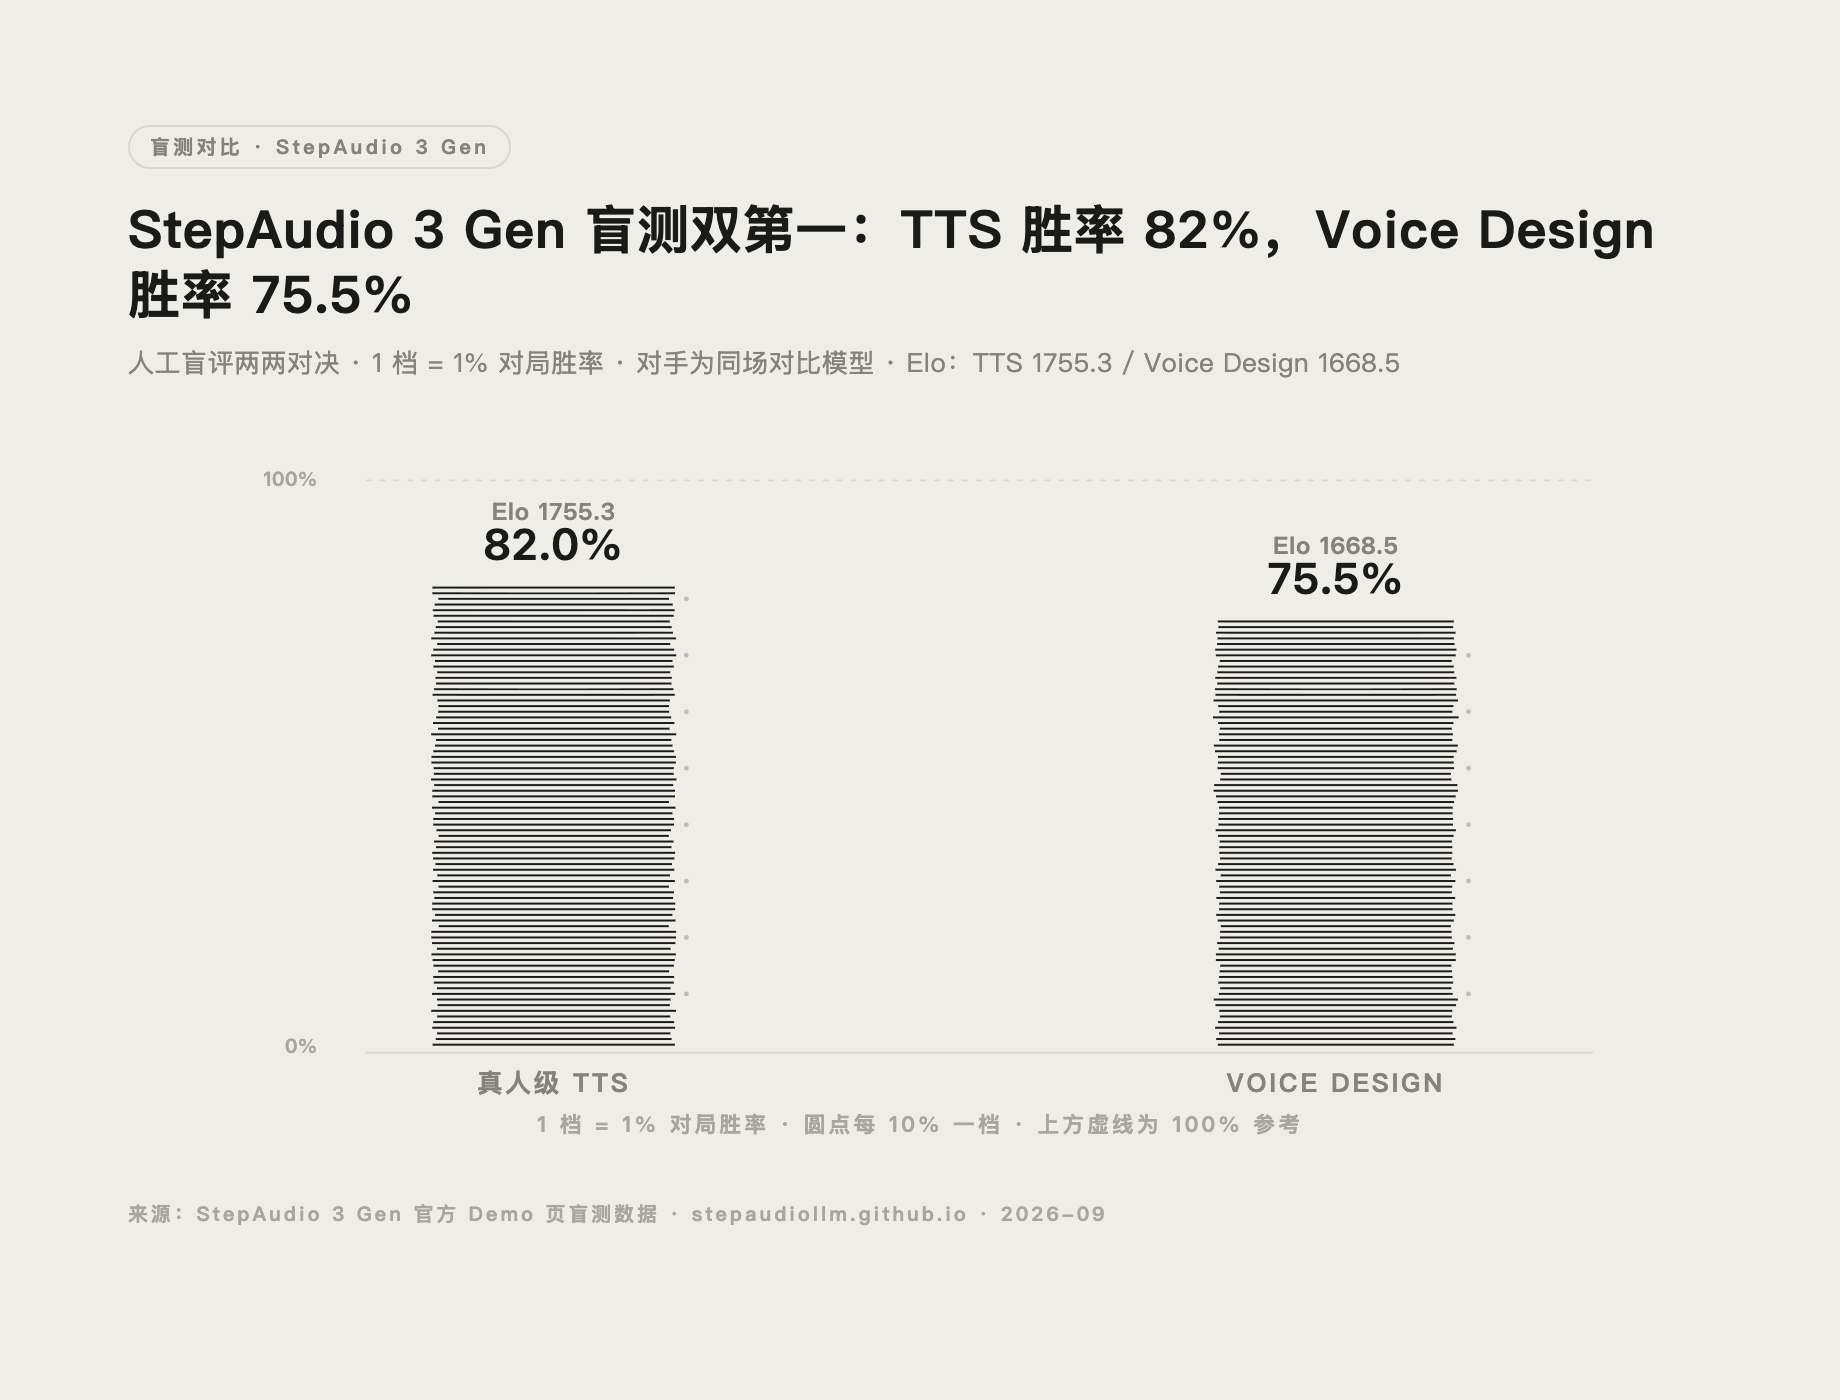
生成侧成绩来自官方盲测:人工两两对决中,StepAudio 3 Gen 在真人级 TTS 和 Voice Design 均排第一,Elo 分别为 1755.3 和 1668.5,胜率 82.0% 和 75.5%。注意这是官方口径(对手为 Demo 页同场对比模型),与第三方榜单性质不同,可作横向参考。
对选型者的实际含义:做实时语音对话,StepAudio 3 Realtime 是当前榜单上最值得优先测试的模型之一;做批量转写,1.7% 的 WER 已属全球第一梯队,与微软 MAI-Transcribe-2 同档。
和上一代什么关系?开源了吗?
阶跃语音线由来已久:2025 年开源了 1300 亿参数的 Step-Audio-Chat、3B 的 Step-Audio-TTS-3B 和 Step-Audio 2 系列,之后又有语音推理模型 Step-Audio-R1 与音频编辑模型 Step-Audio-EditX,早期仓库已停止维护。
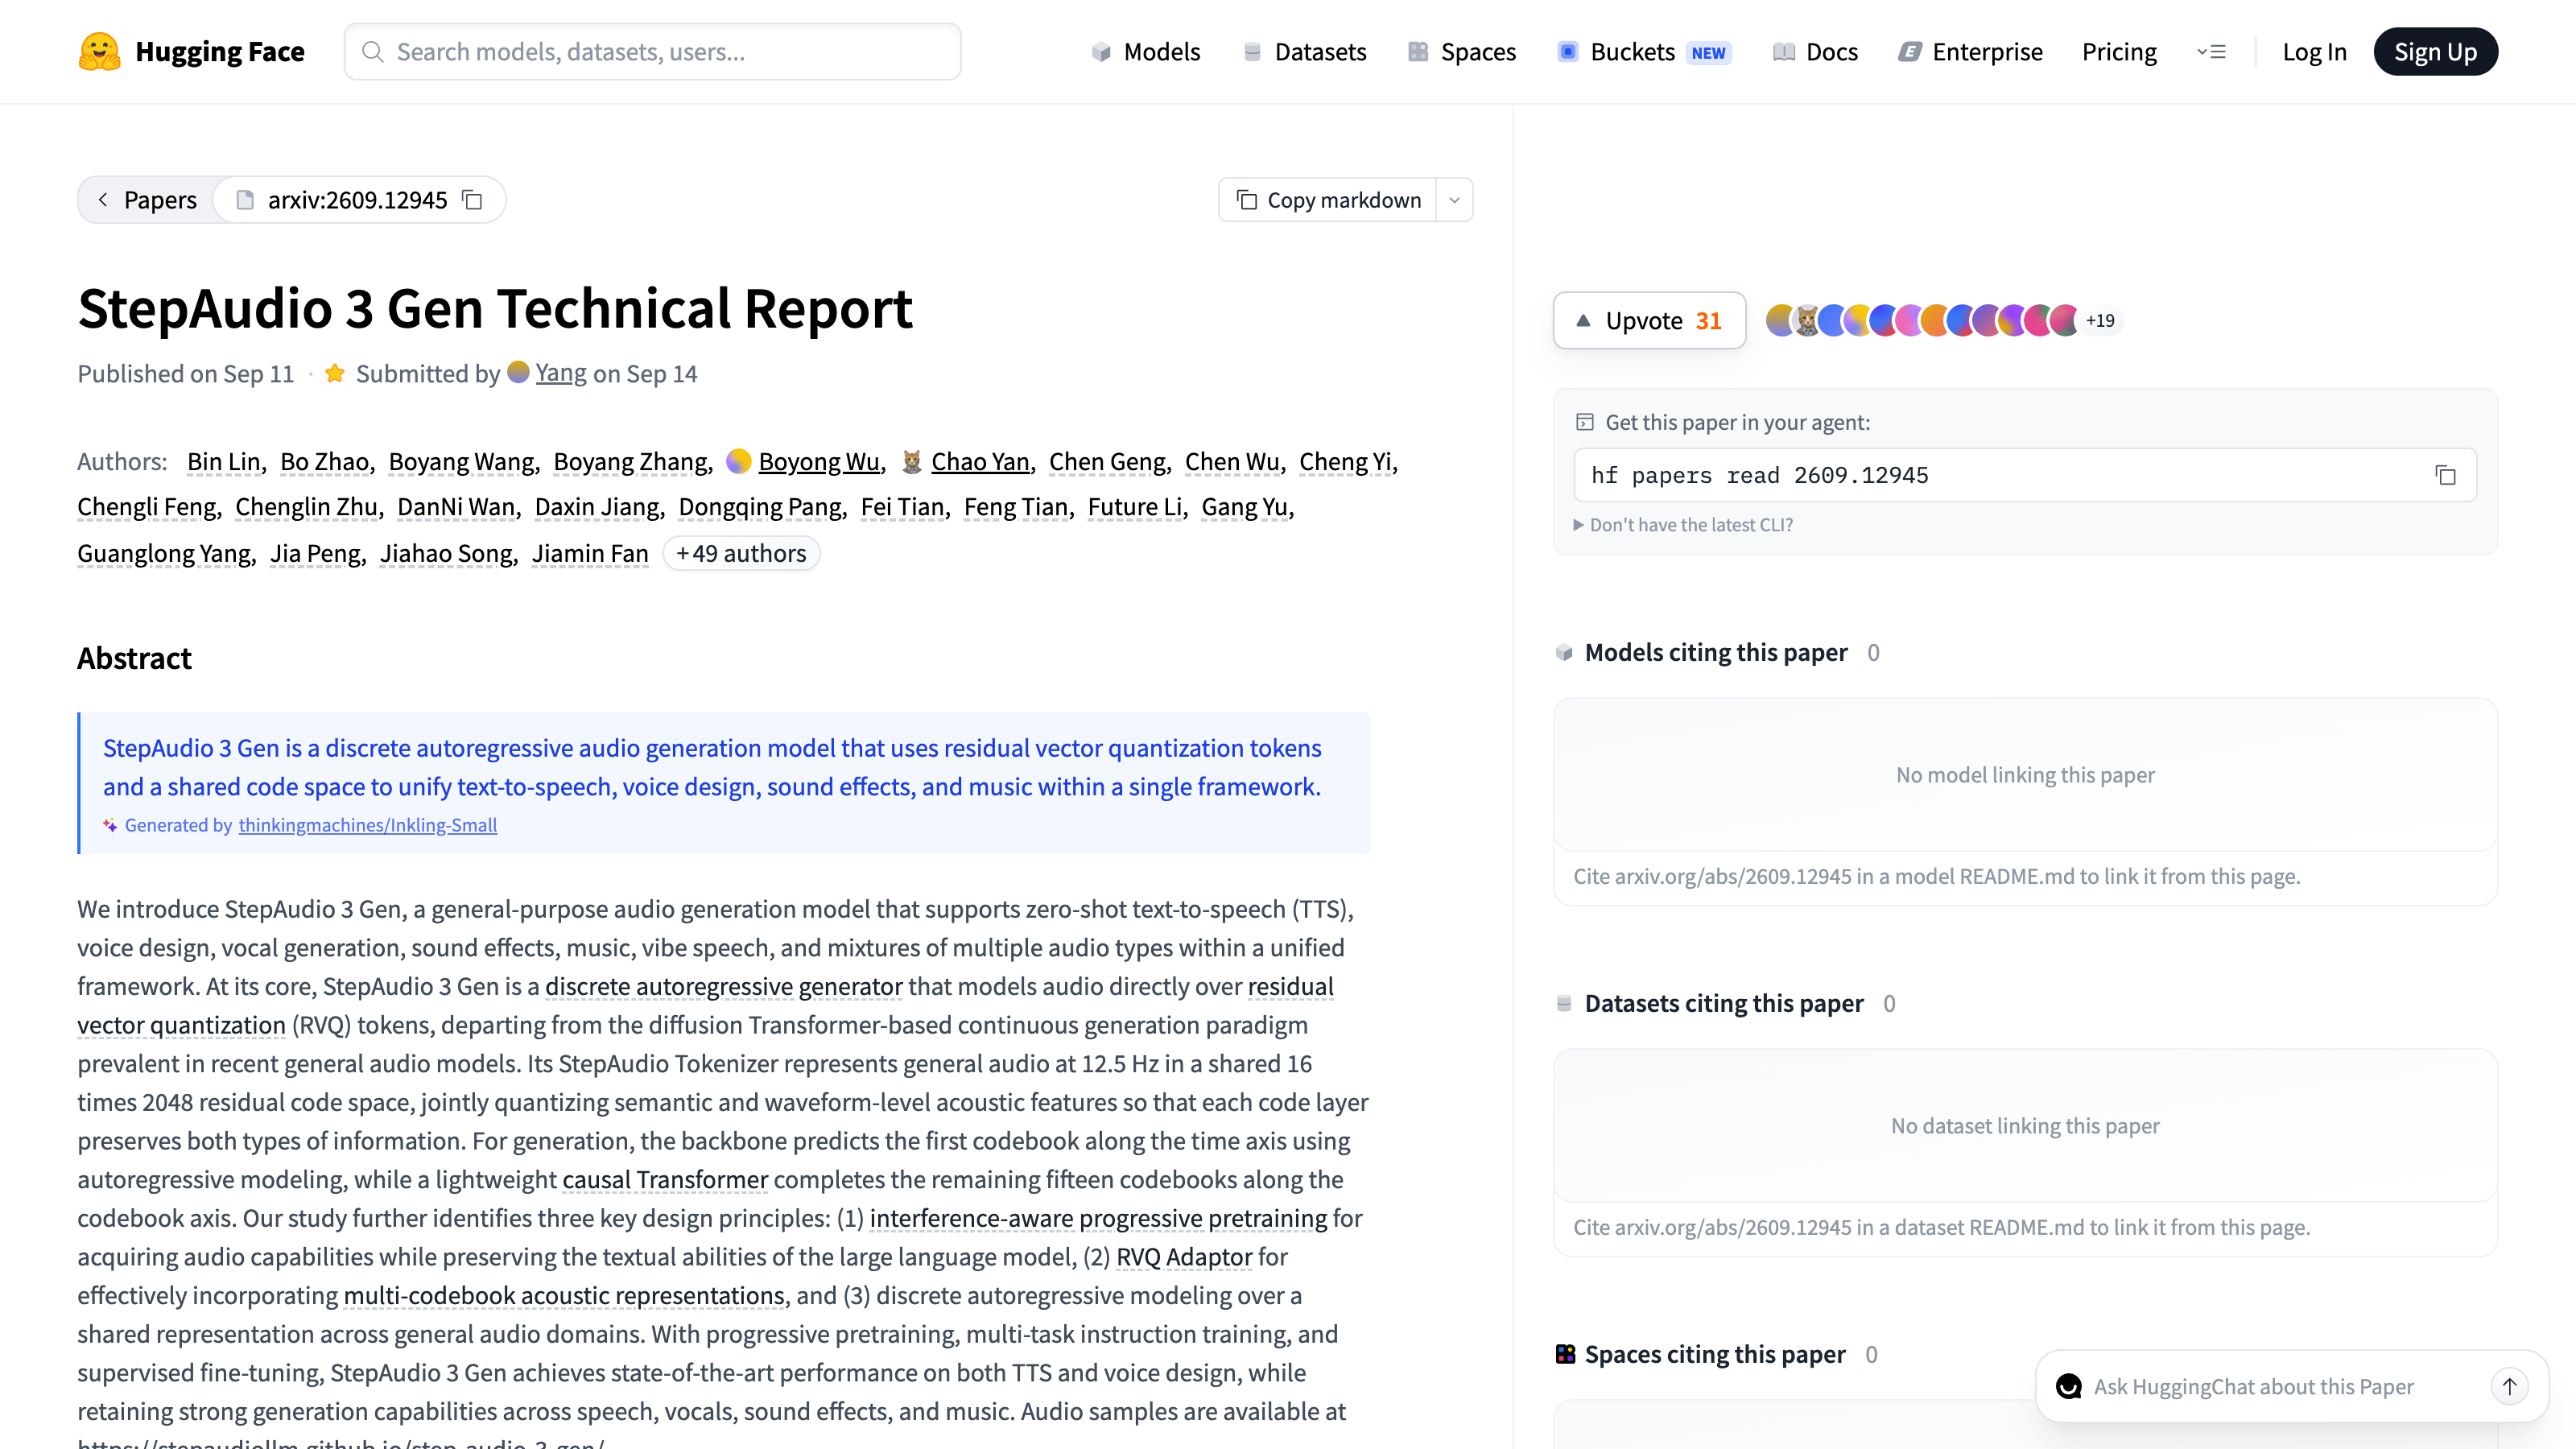
StepAudio 3 是这条线的最新一代。截至发稿,五款模型以开放平台 API 形式提供,权重暂未在 Hugging Face 放出;阶跃此前开源过 Step-Audio 2 mini、Step-Audio-R1.1 等模型,后续是否开放建议关注其 Hugging Face 主页。技术上,StepAudio 3 Gen 技术报告已于 9 月 11 日公开(arXiv 2609.12945):离散自回归架构,基于 RVQ 残差向量量化 token 和共享码空间,把 TTS、声音设计、音效、音乐统一在一个框架内,做语音技术的读者值得一读。
怎么用上 StepAudio 3
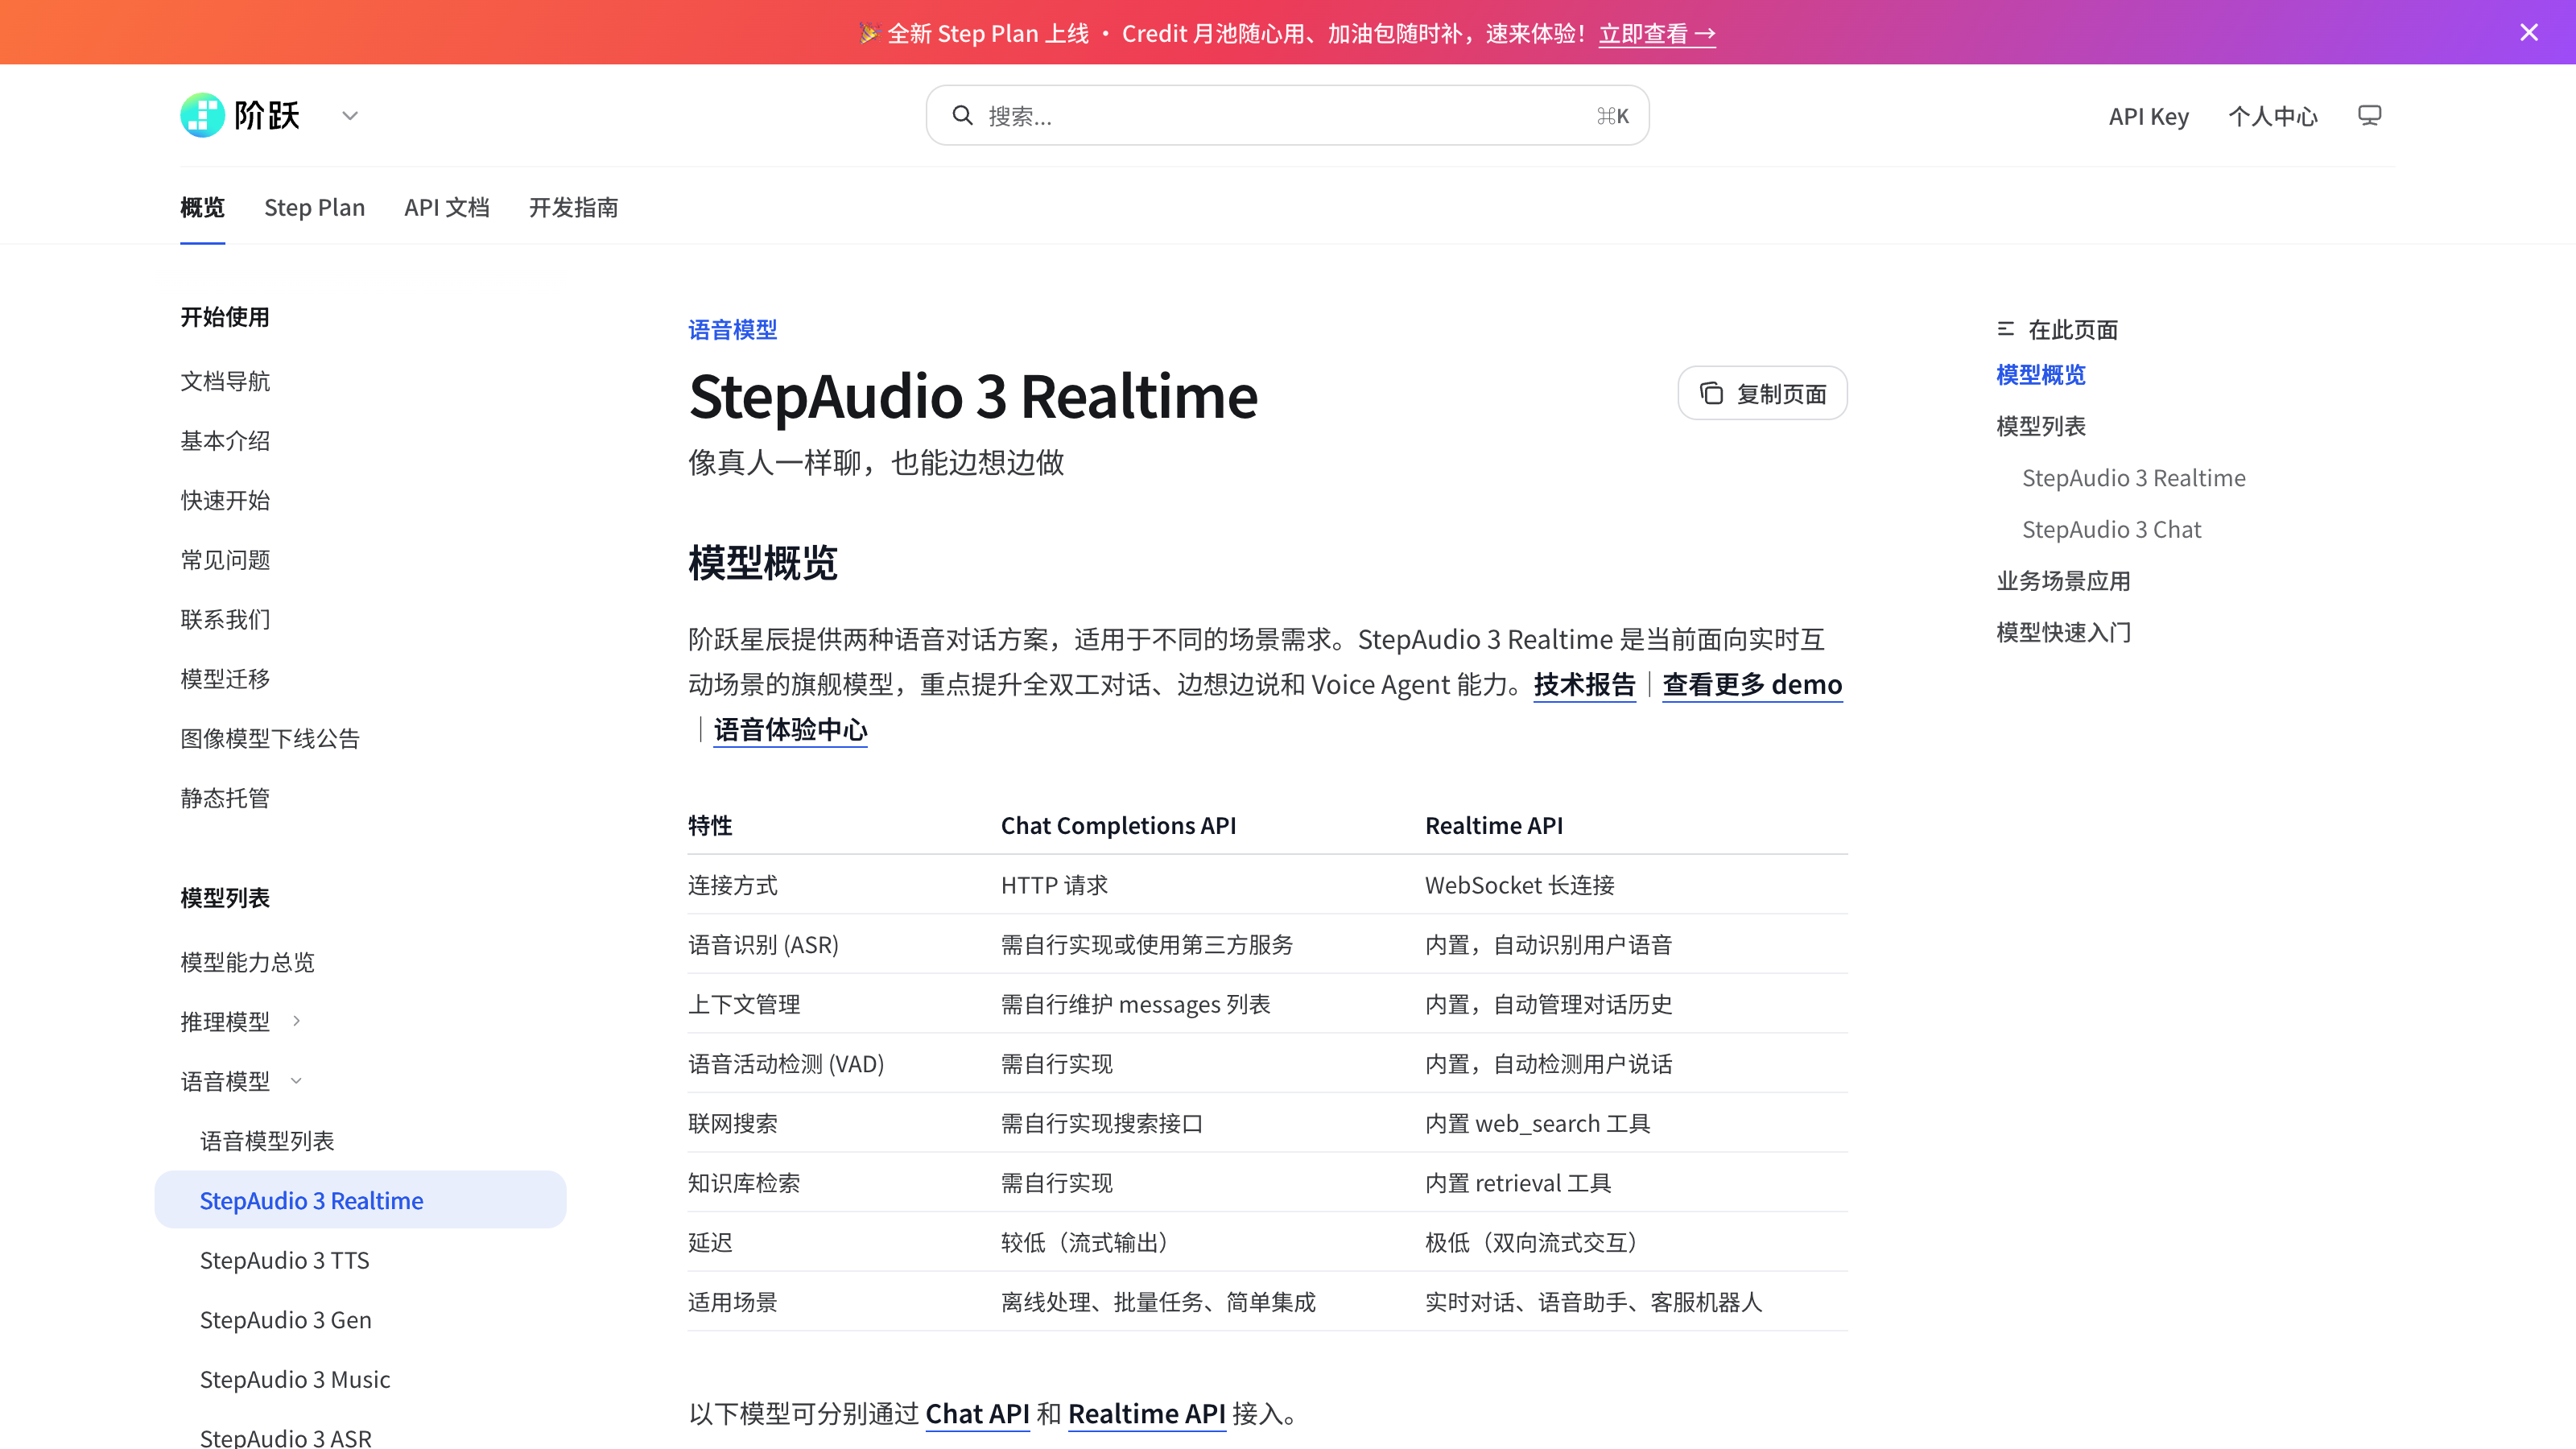
开发者走开放平台 API。 Realtime 走 WebSocket 长连接,内置 ASR、VAD、上下文管理、联网搜索和知识库检索,适合实时对话类应用;Chat 版本走标准 Chat Completions API,适合按轮次提交语音或文本。当前预览阶段模型名带 preview 后缀(如 stepaudio-3-realtime-preview),限免到期后会下线预览版、上线正式付费版。
普通用户先玩官方 Demo。 StepAudio 3 Gen 官方 Demo 页提供 Voice Studio 和在线试听,Hugging Face 已上线 StepAudio 3 Music Studio 空间,不写代码就能体验。
和 OpenAI 的全双工语音方案(见我们的 GPT-Live-1 解读)相比,阶跃的优势在中文方言、中英混说和完整音频生成。上手指引:Demo 页确认效果,再注册开放平台拿 API Key 用 preview 模型名测试,正式版上线后改模型名即可;拿不准选型可以看我们的2026 智能语音产品横评。
总结
StepAudio 3 的价值不在单个榜单第一,而在于把实时交互、识别、生成、音频创作和音乐创作补成完整产品线,且五款模型当天全部可用。提醒两点:preview 限免结束后会切换付费版本,接入前留意定价公告;权重开源情况待官方确认。
资料来源:
- StepAudio 3 Realtime 官方文档
- StepAudio 3 Gen 官方 Demo 页
- StepAudio 3 Gen 技术报告(arXiv 2609.12945)
- IT之家报道
- 新浪科技解读
本文由 AI345 发布,最后更新于 2026 年 9 月 15 日。事实核对于上列来源,评测数据以官方口径标注。
常见问题
StepAudio 3 开源了吗?
答:截至 2026 年 9 月 15 日,五款模型以开放平台 API 形式提供,权重暂未开源。阶跃此前开源过 Step-Audio-Chat、Step-Audio 2 mini、Step-Audio-R1.1 等语音模型,后续以官方公告为准。
StepAudio 3 免费吗?
答:当前阶段免费。stepaudio-3-realtime-preview 等 preview 模型名是限免版本,到期后会下线并上线正式付费版,计费以平台「定价与限速」页面为准。
StepAudio 3 和 GPT 的实时语音哪个好?
答:第三方评测中 Realtime 在对话动态和语音推理两榜全球第一,属第一梯队;但中文方言和中英混说阶跃更有优势,英文生态和多模态联动 OpenAI 更成熟,建议用真实业务语料实测后决定。
StepAudio 3 能部署到本地吗?支持哪些语言?
答:目前不能本地部署,权重未放出,只能通过开放平台 API 或官方 Demo 体验,想本地部署可关注阶跃已开源的 Step-Audio 2 mini 等模型。识别支持中文、英文、方言、中英混说、长音频和专业领域,生成支持中英文多音色情绪控制。
 京ICP备2024094994号-29