
GPT-Live-1 是什么?OpenAI 全双工语音 API 上线
OpenAI 在 2026 年 9 月 10 日把全双工语音模型 GPT-Live-1 开放到了 API:它能边听边说,还能把查订单、调工具这类"动手活"委派给后端 Agent,前端语音层定价 0.05 美元一分钟、按秒计费。对做语音助手、电话机器人的开发者来说,这是 Realtime API 之后最有分量的一次升级。此前我们对 OpenAI 新模型的跟踪见GPT-6 发布全解读。
关于适用范围:GPT-Live-1 最早随 ChatGPT 首发,9 月 10 日才正式进入 API。官方公告页与开发者文档均已上线(来源:OpenAI 公告、GPT-Live 上手文档),本文所有参数、价格与跑分均从这两处官方页面核实。
GPT-Live-1 发布了什么
按官方模型页(gpt-live-1)与公告页的说明,这次开放的核心内容有 6 条:
- 全双工语音模型 gpt-live-1 正式可用:支持音频和文本输入输出,可以一边听你说话一边开口回应,打断和抢话由模型自己处理,不再依赖手动事件控制。
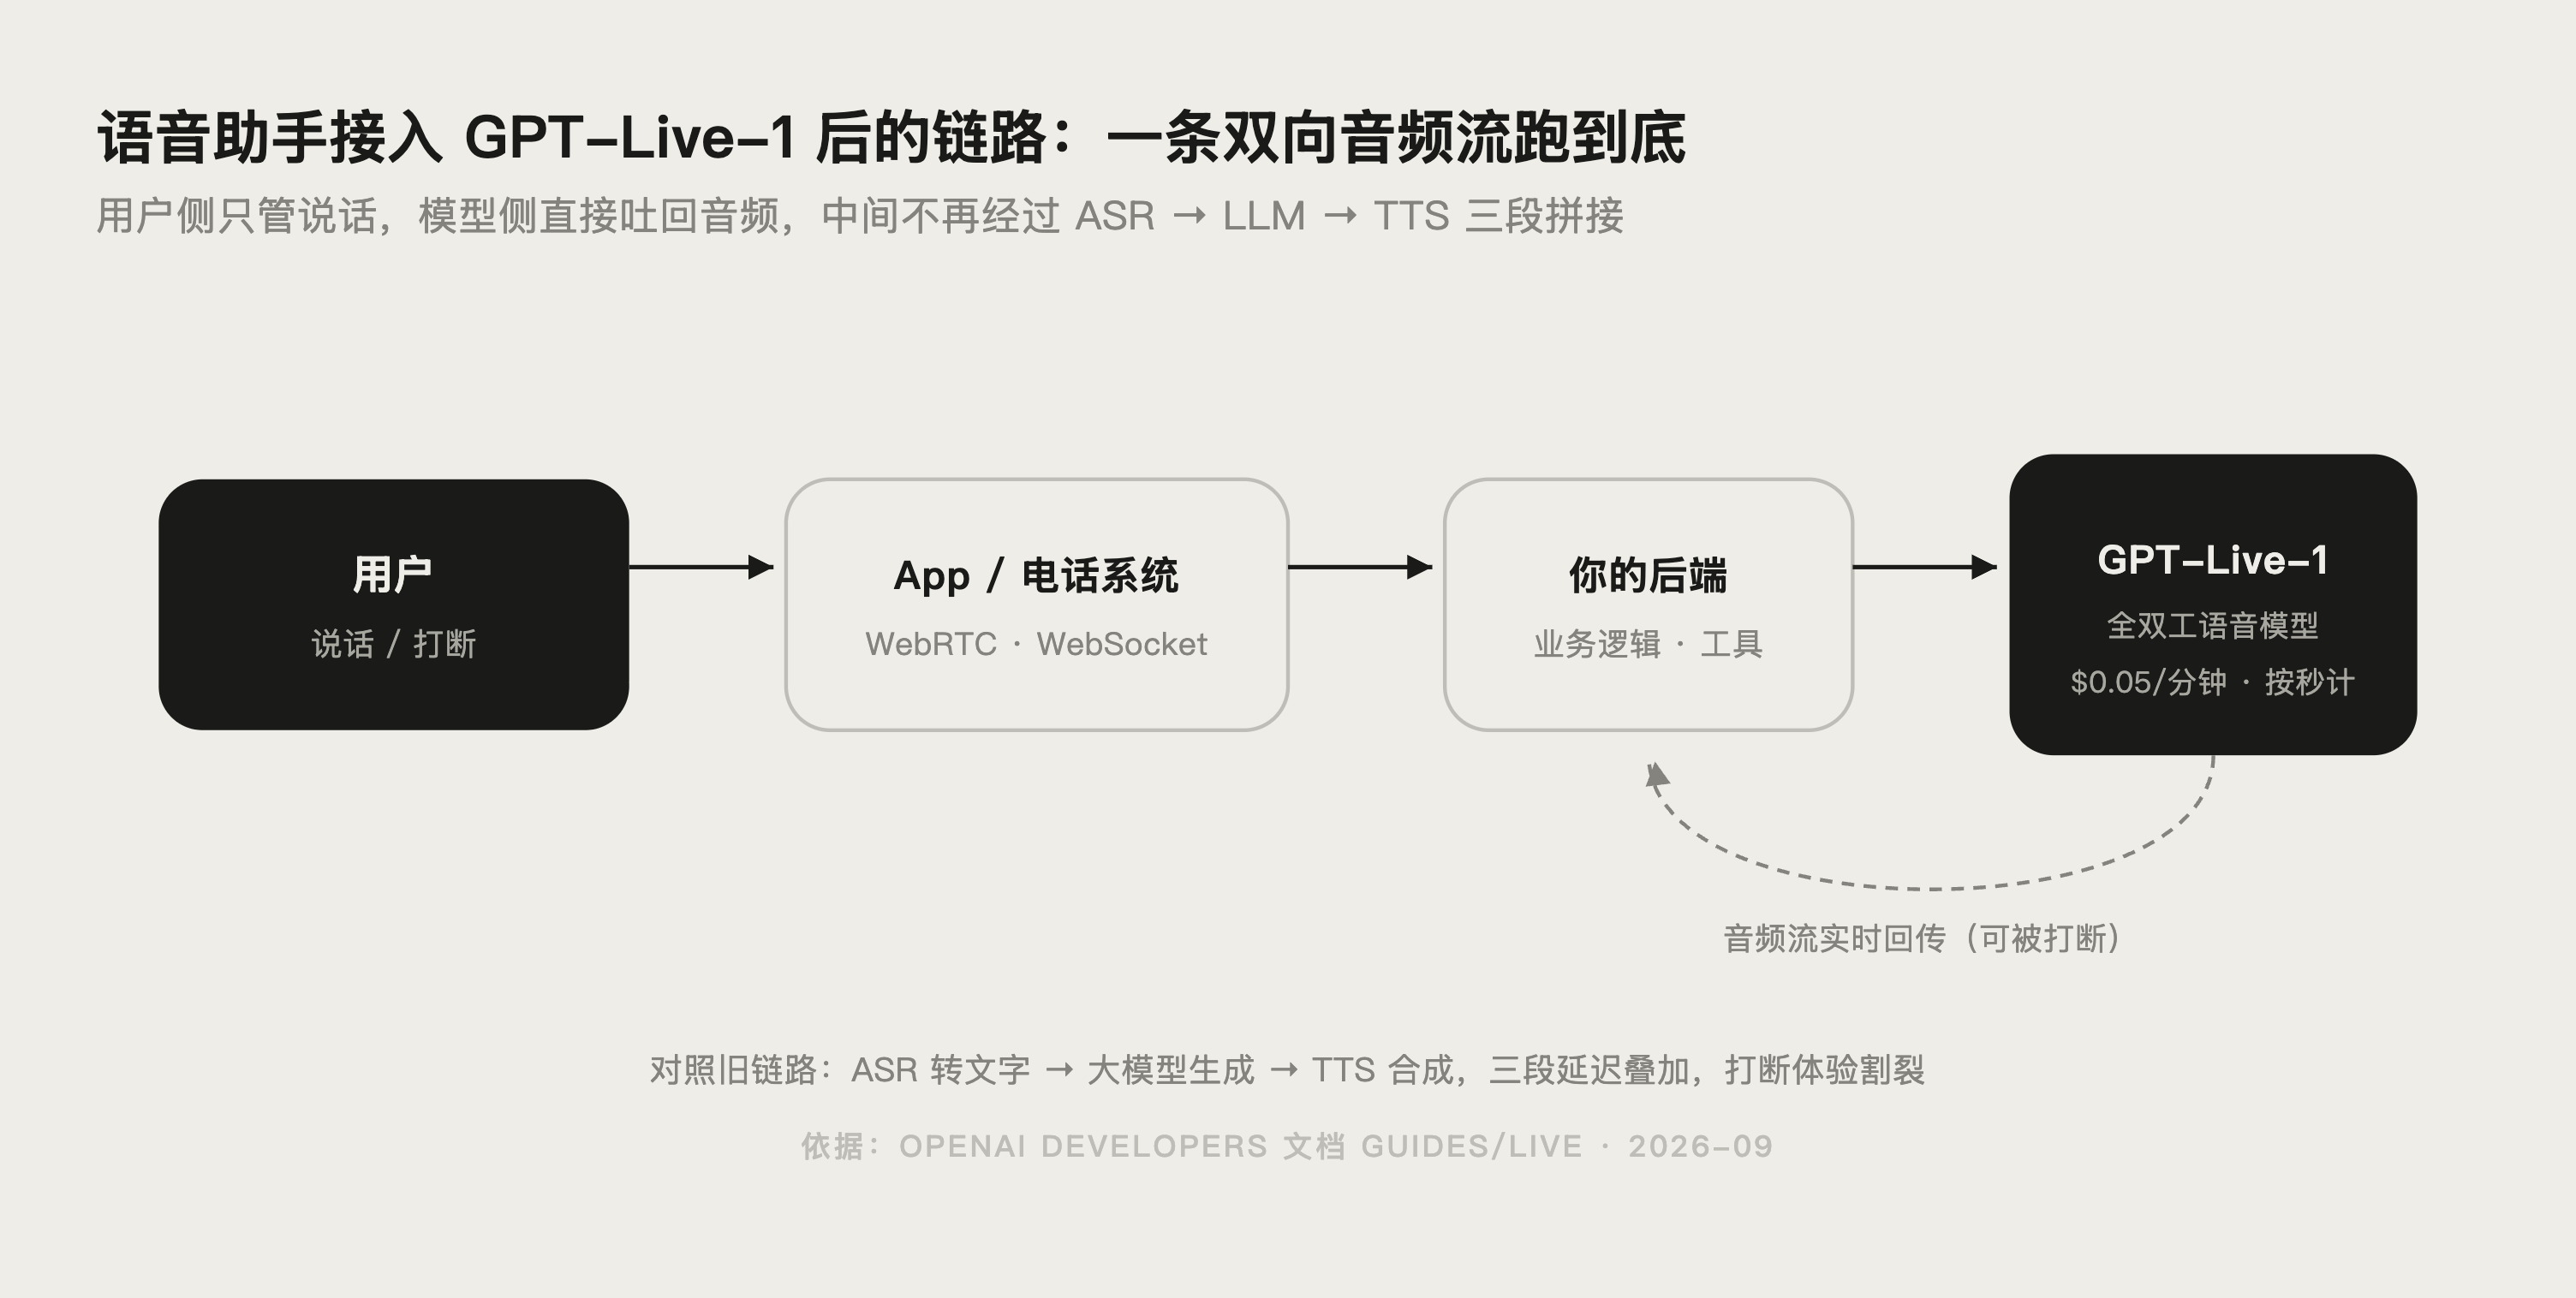
- 语音与后端任务分离(delegation 机制):语音模型只负责"说话和听",遇到需要查数据、调工具的请求,它会委派给后端模型(官方示例用 GPT-6 Astra,也可以换成 Luna、Terra 或你自己的 Agent)去处理,处理期间对话不中断。
- 多种接入方式:浏览器场景走 WebRTC,服务端集成走 WebSocket,电话场景有 SIP 方案;LiveKit、Twilio、Telnyx、Daily/Pipecat 这些语音基础设施厂商都提供了官方对接路径。
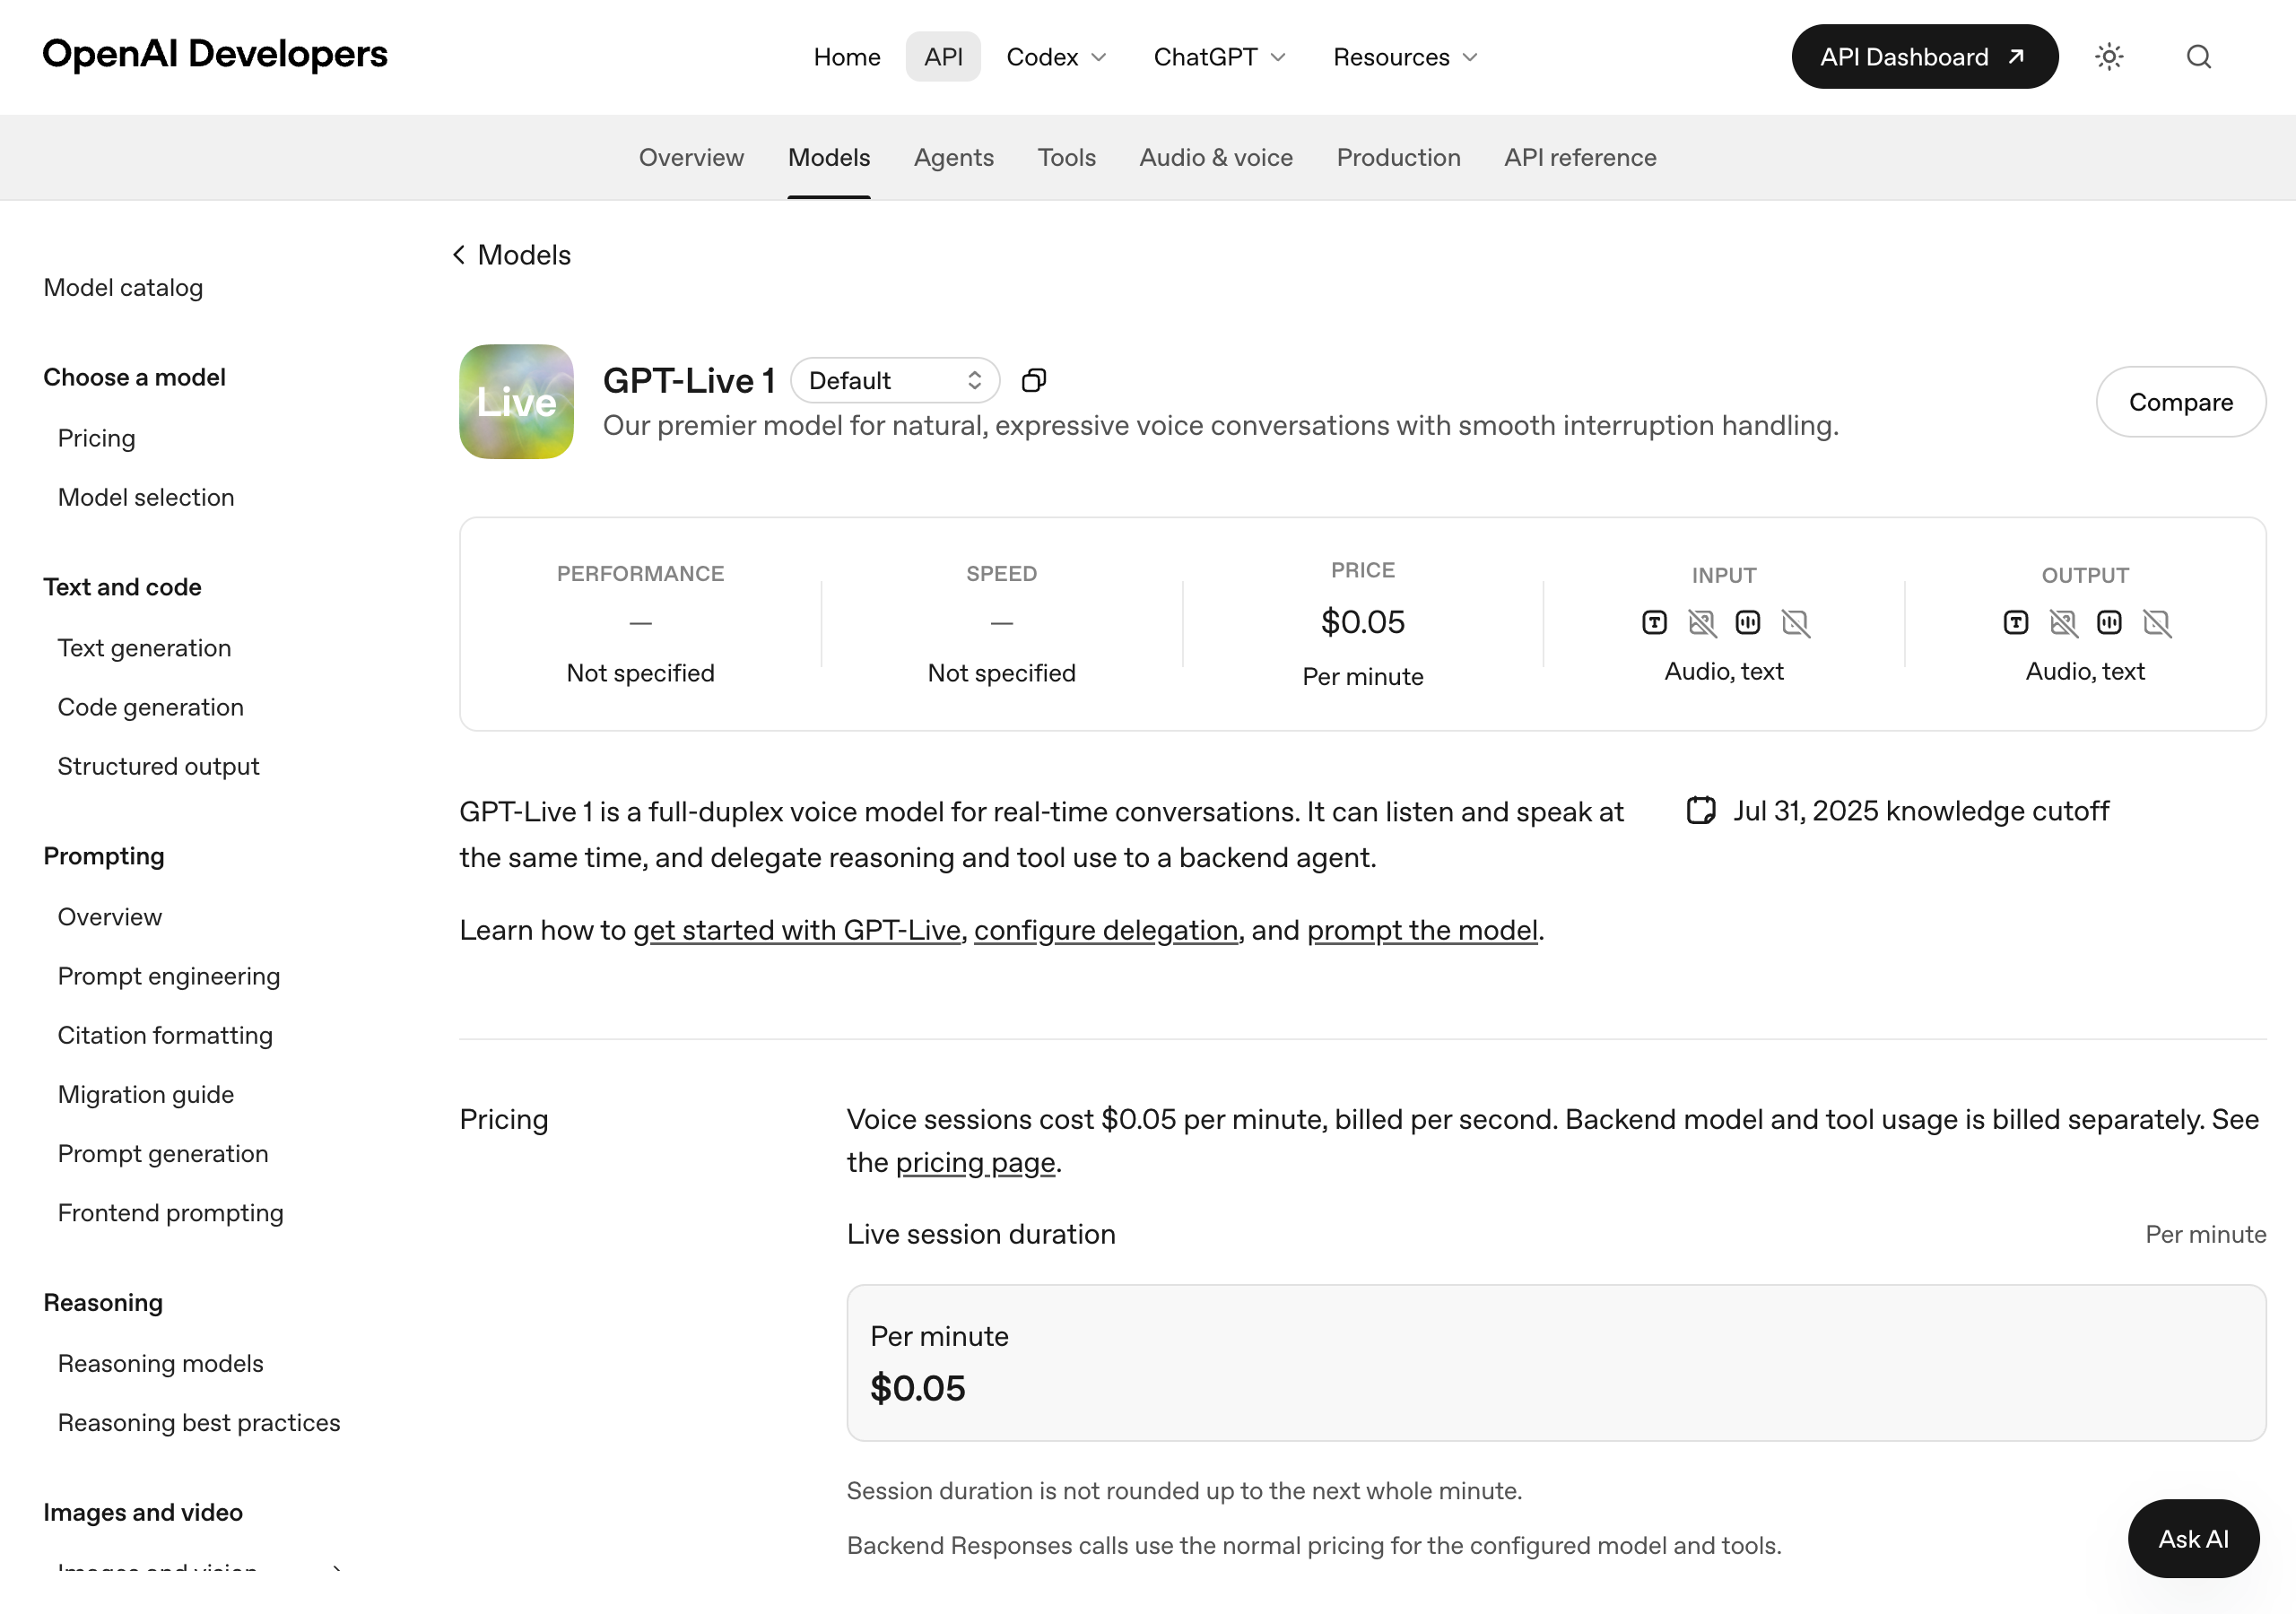
- 按时长计费:语音会话 0.05 美元每分钟,按秒计费、不向上取整,后端模型的用量单独结算。
- 原生转写与轮次能力:模型原生输出 ASR 转写和回答文本,对字母数字(订单号、验证码这类)识别做了加强,支持关键词偏置;虽然它不是轮次模型,但原生支持轮次检测,按旧架构写的代码仍可继续用轮次边界。
- 音色扩容:从原来一小撮实时音色,扩到覆盖不同口音、方言和语言的更大音色集合,官方当前公布的音色包括 Quartz、Ripple、Vesper、Willow、Stone、Gleam、Meridian、Bossa、Tempo、Beacon、Delta、Cinder。
关键信息一览
| 项目 | 内容 | 来源 |
|---|---|---|
| 模型 ID | gpt-live-1 |
官方模型页 |
| 发布日 | 2026 年 9 月 10 日进入 API | 官方公告页 |
| 核心能力 | 全双工对话 + 任务委派 | 官方文档 |
| 端点 | v1/live/sessions(不支持 chat completions) |
官方模型页 |
| 定价 | $0.05/分钟,按秒计费不凑整 | 官方定价页 |
| 后端用量 | 单独按所用模型与工具计费 | 官方定价页 |
| 免费层 | Free 等级不可用 | 官方模型页 |
| 并发会话 | Tier 1 为 25 路,Tier 5 为 500 路 | 官方模型页 |
| 输入输出模态 | 音频与文本(图片、视频不支持) | 官方模型页 |
官方跑分:全双工到底强多少
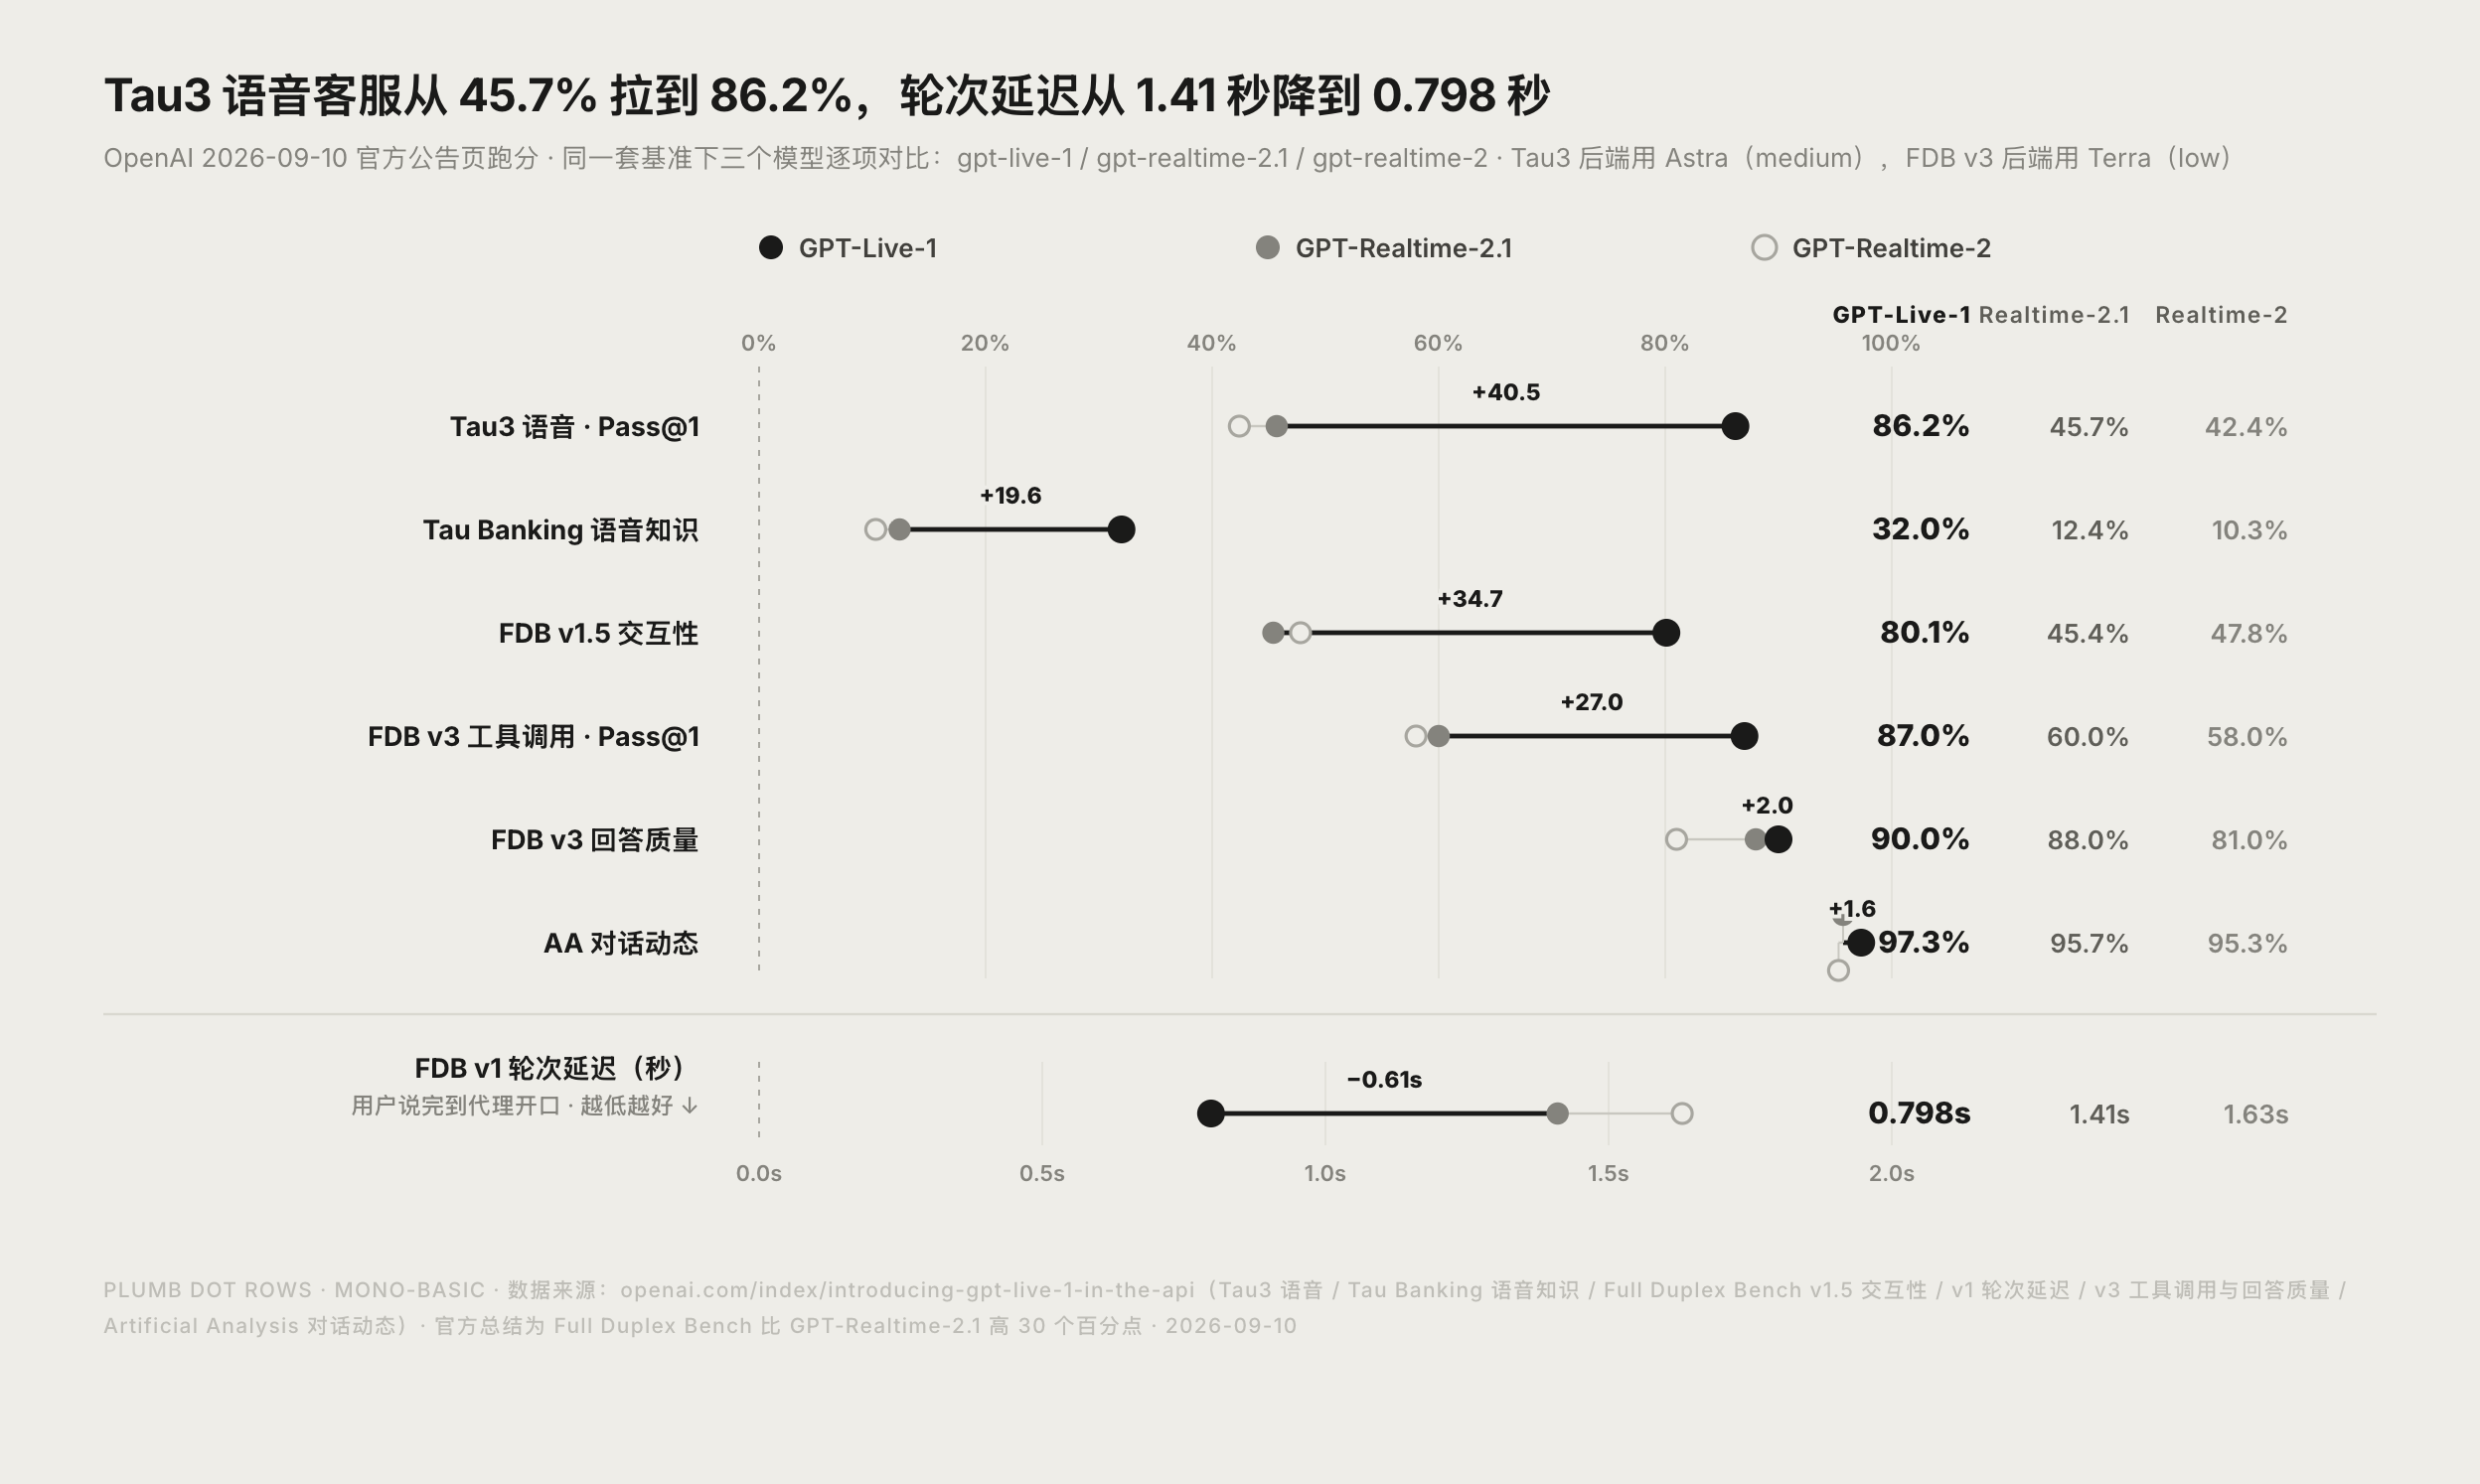
这是公告页最有信息量的部分,也是中文转述里最常丢的部分。官方把 GPT-Live-1 和上一代 gpt-realtime-2.1、gpt-realtime-2 放在同一套基准里对比:
| 评测项 | GPT-Live-1 | GPT-Realtime-2.1 | GPT-Realtime-2 | 测的是什么 |
|---|---|---|---|---|
| Tau3(语音,Pass@1) | 86.2% | 45.7% | 42.4% | 航司、零售、电信的口播客服任务;后端用 Astra(medium) |
| Tau Banking(语音知识,Pass@1) | 32.0% | 12.4% | 10.3% | 口播银行客服,含知识检索与账户工具 |
| Full Duplex Bench v1.5 交互性 | 80.10% | 45.4% | 47.8% | 背景人声、对旁人说话、语气词回应、被打断 |
| Full Duplex Bench v1 轮次延迟 | 0.798 秒 | 1.41 秒 | 1.63 秒 | 用户说完到代理开口(越低越好) |
| Full Duplex Bench v3 工具调用(Pass@1) | 87.0% | 60.0% | 58.0% | 带停顿、犹豫、自我纠正的口播请求;后端用 Terra(low) |
| Full Duplex Bench v3 回答质量 | 90.0% | 88.0% | 81.0% | 同上场景下回答与参考意图的吻合度;后端用 Terra(low) |
| Artificial Analysis 对话动态 | 97.3% | 95.7% | 95.3% | 停顿处理、轮次、打断、语气词 |
官方给的总结是:在 Full Duplex Bench 上比 GPT-Realtime-2.1 高 30 个百分点,提升集中在轮次延迟和交互行为。
企业侧反馈也印证了这两个点:Yelp 把 GPT-Live-1 接进 Yelp Host 和 Hatch 之后,轮次处理与准确率都优于传统语音架构,官方转述的观察是来电者开始说更完整、更自然的句子;Speak 的语言陪练在早期评估中把「学习者思考停顿期被打断」减少了接近 80%;Cognition 的说法是,相比级联方案,代码库简化了 80%、删掉 2.3 万行代码。
和上一代 Realtime API 差在哪
这是很多已经用 Realtime API 的团队最关心的问题。官方在迁移指南里给了很明确的对照,我们提炼成三句话:
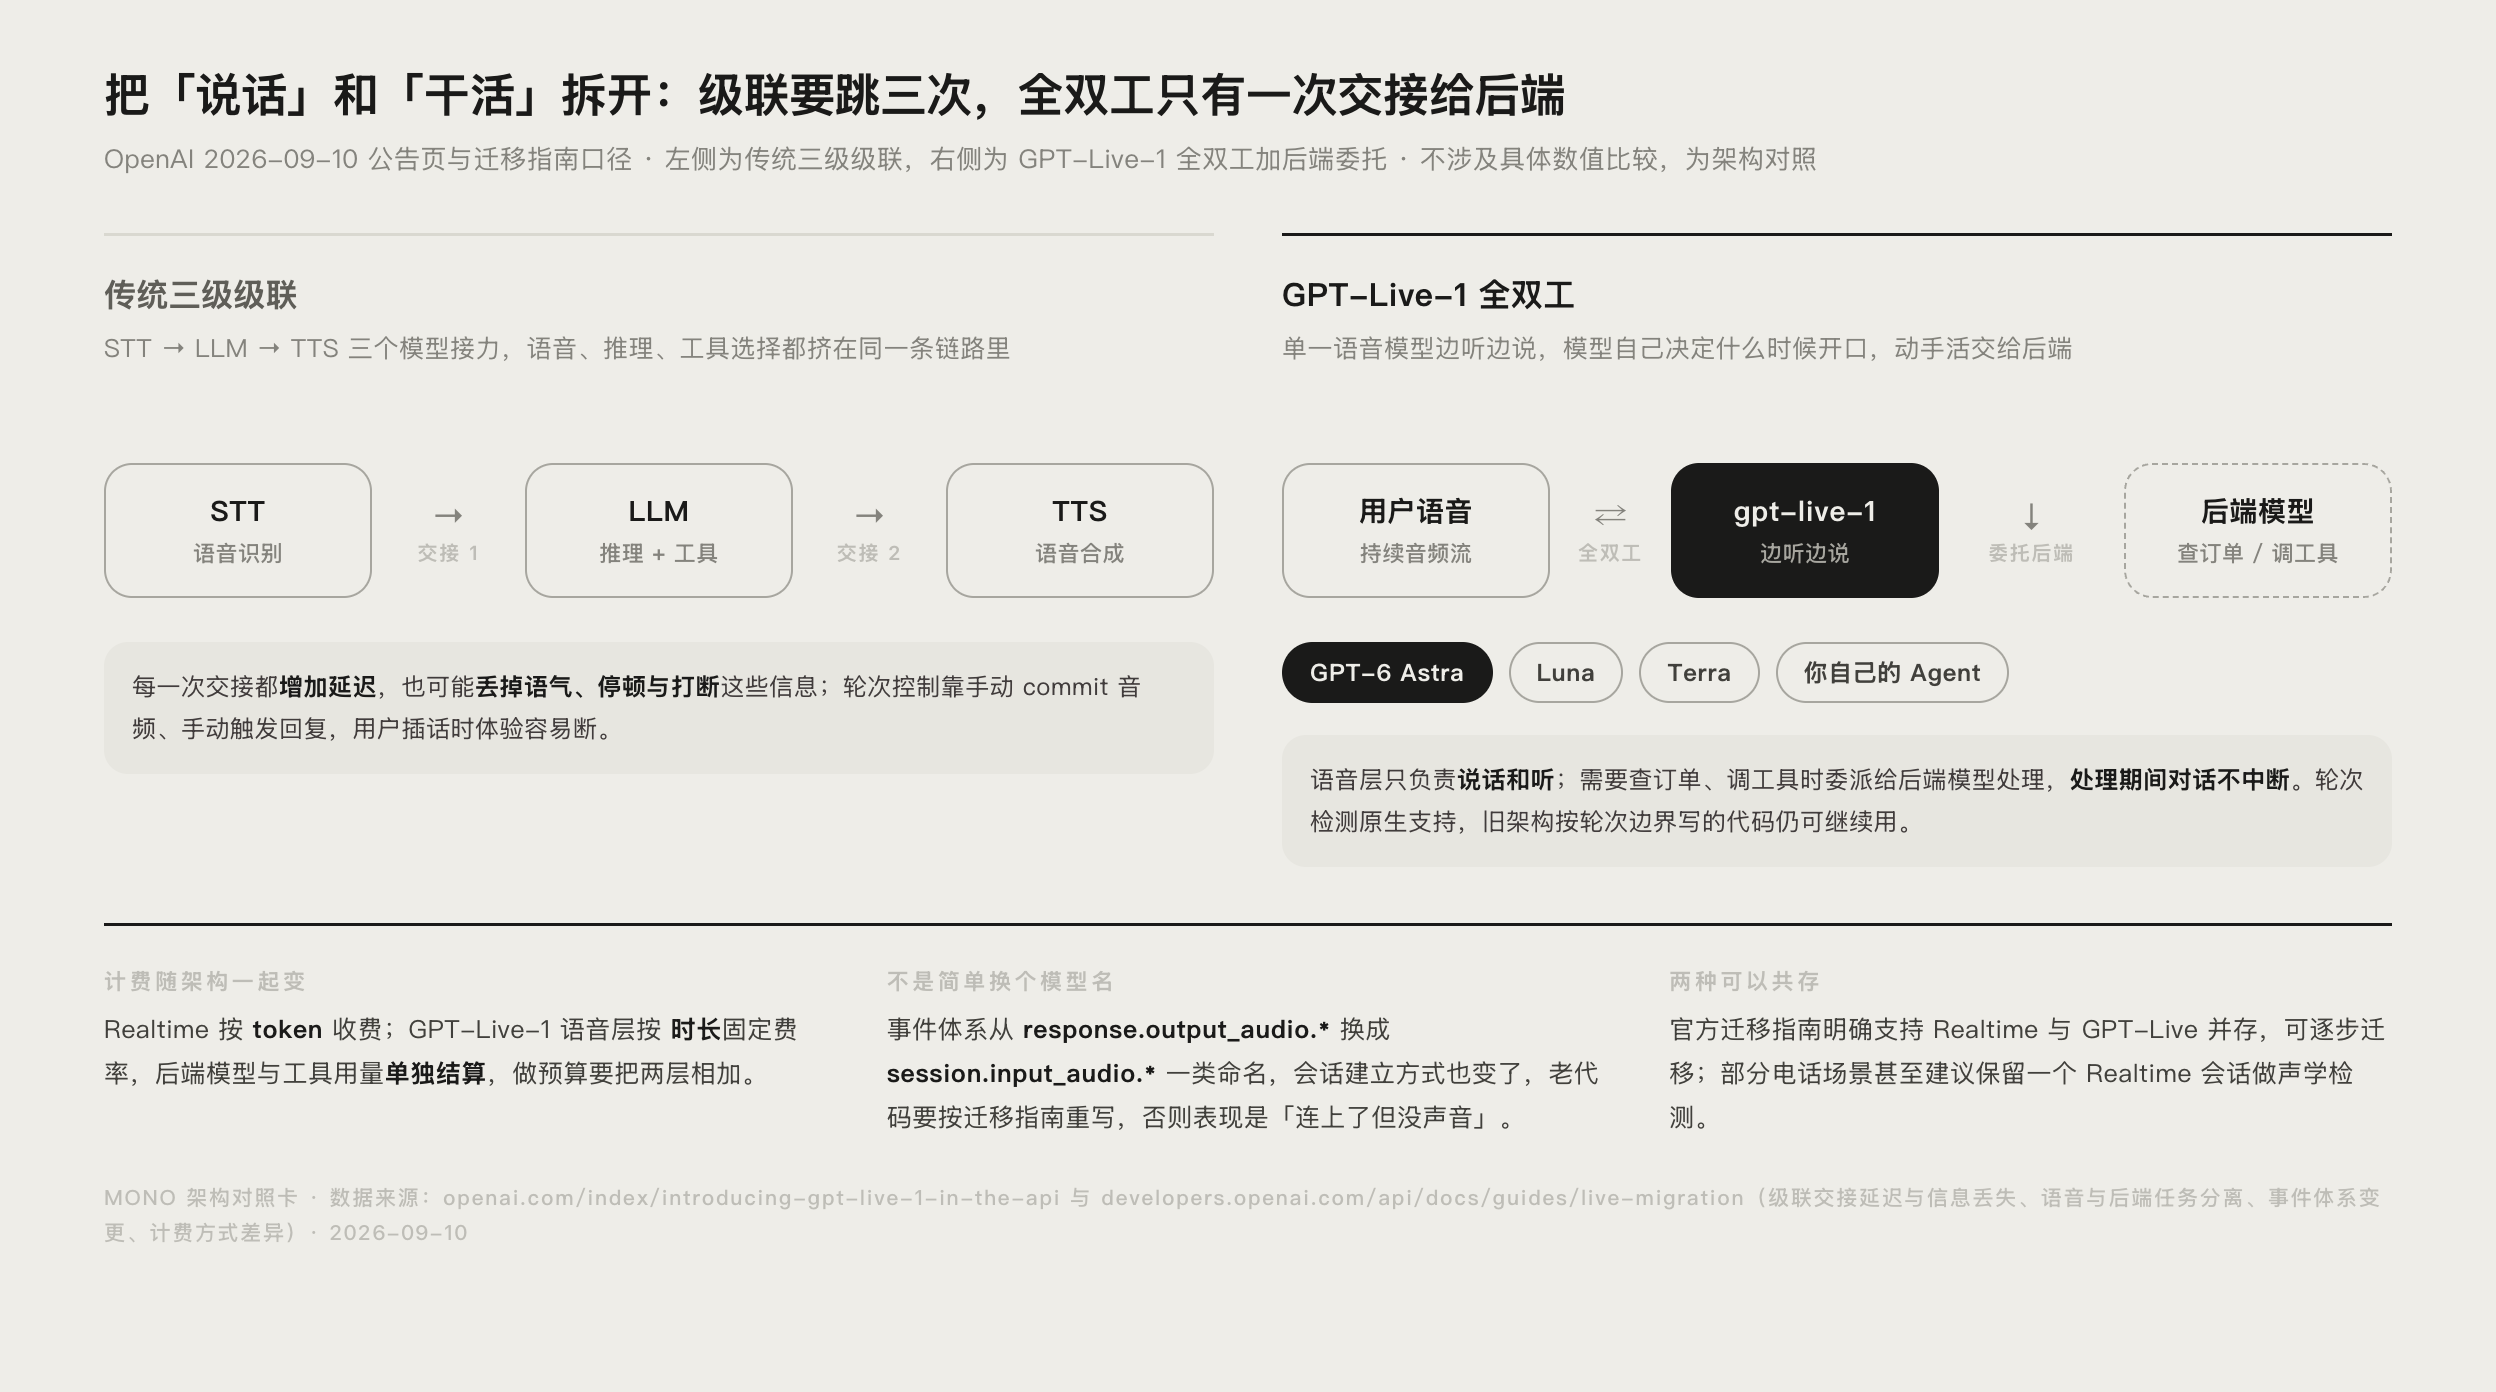
- 架构不同:Realtime 里一个模型同时管语音、推理和工具选择;GPT-Live 把"说话"和"干活"拆开,语音模型只管对话,推理和工具交给后端,后端你可以换成任何模型或自己的 Agent。
- 交互方式不同:Realtime 需要手动 commit 音频、触发回复;GPT-Live 持续接收音频流,模型自己决定什么时候开口,官方迁移指南明确写了"移除手动音频提交和语音轮次触发"。
- 计费方式不同:Realtime 按 token 收费(音频输入输出各有百万 token 单价);GPT-Live 按通话时长收固定费率,成本更容易预估。
| 对比项 | Realtime API | GPT-Live-1 |
|---|---|---|
| 语音+推理 | 同一模型承担 | 语音模型 + 独立后端 |
| 轮次控制 | 手动 commit/触发 | 持续音频流,模型自主 |
| 计费 | 按 token | 按时长($0.05/分钟) |
| 事件体系 | response.output_audio.* |
session.input_audio.* 等,需改代码适配 |
| 唤醒与停顿 | 依赖显式事件 | 模型自行判断,原生支持轮次检测 |
需要注意:GPT-Live 不是 Realtime 的简单换名,事件名、会话建立方式都变了,老项目要按迁移指南改代码,官方也提供了从 Realtime 迁移的完整路径。
真正会踩的坑:接入前先看清这 6 条
公告和文档里散落着几条容易被忽略的限制,单独拎出来(均来自官方页面):
- 不能只改模型名。事件体系从
response.output_audio.*换成session.input_audio.*一类命名,会话建立方式也变了,老代码必须按迁移指南重写,否则表现是「连上了但没声音」。 - 成本要按两层算。语音层 $0.05/分钟只覆盖前端语音,后端模型的 token 和工具调用另外计费。按旧 Realtime 的单价推算预算会明显偏低。
- 并发是硬上限。语音会话一旦建立就持续占用并发额度,Tier 1 只有 25 路。用文字接口的 QPS 经验来估语音容量,上线当天就会撞墙。
- 免费层完全不可用。官方模型页标注 Free 用量等级不支持,需要至少 Tier 1 的付费等级。
- 自定义音色要单独申请。想用自己录制的品牌音色,官方给的路径是联系销售确认资格与申请流程,不是后台自选。
- 模态有限。输入输出只有音频和文本,图片、视频都不支持;官方在线体验 Demo 本身也是限时的。
国内开发者现在能做什么
想第一时间用上,按下面三步走:
- 确认账号条件:需要 OpenAI Platform 账号且 API 用量等级高于 Free(免费层不可用该模型),网络和支付需自行解决合规渠道。
- 从 WebRTC 快速开始入手:官方提供了浏览器+服务器的示例工程,接上麦克风就能体验全双工对话,见 GPT-Live 快速开始。
- 电话类需求先看合作方:如果你的产品是电话机器人,建议直接从 LiveKit、Twilio 等合作方的对接文档进入,可以少踩音频链路的坑。
国内团队要注意两点:一是 GPT-Live 会话需要直连 OpenAI 服务,跨境网络与数据合规要先评估;二是语音会话按秒计费但持续占用并发额度,上线前用 Tier 并发数(Tier 1 只有 25 路)压测一下容量。
官方同时给了 GPT-Live-1 与 Codex 组合的示例代码,思路是让应用把对话上下文交给 Codex,再把它的回答通过 session.commentary.append 回注到语音会话里,实现「边聊边查仓库」:
import { Codex } from "@openai/codex-sdk";

const thread = new Codex().startThread({
  workingDirectory: "./repo",
  sandboxMode: "read-only",
  approvalPolicy: "never",
});

async function answer(live, delegationId, context) {
  const { finalResponse } = await thread.run(
    `Answer the latest question using this repo.
 Reply in two short spoken sentences.
${context}`
  );
  live.send({
    type: "session.commentary.append",
    delegation_id: delegationId,
    content: finalResponse,
  });
}
这段代码只展示了「传上下文回去」这一步,连接建立与委派处理在官方文档里另有说明。企业侧如果不想自己搭,还可以走 OpenAI Presence 这条线,它是官方为实时语音交互准备的企业方案。
哪些团队值得升级,哪些可以再等等
值得第一时间跟进的:做实时语音客服、电话机器人、语音硬件的团队,全双工和委派机制直接解决"用户插话被打断、后台查询卡住对话"两个老问题。从官方跑分看,轮次延迟从 1.41 秒降到 0.798 秒,这对电话体验是质变级数字。
可以再等等的:只用文字转语音、语音转文字的产品,这类需求看语音转文字工具横评更对口;深度绑定 Realtime 的存量项目,等社区把迁移坑趟一遍再动手更稳。
常见问题
GPT-Live-1 是模型还是服务?
答:gpt-live-1 是模型 ID,对应 OpenAI 的全双工语音模型,通过 `v1/live/sessions` 端点建立语音会话使用。
GPT-Live-1 和 Realtime API 可以共存吗?
答:可以。官方迁移指南明确支持两者并存,存量 Realtime 项目可以按需逐步迁移,部分电话场景甚至建议保留一个 Realtime 会话做声学检测。
免费账号能不能试用 GPT-Live-1?
答:不能。官方模型页标注 Free 用量等级不支持该模型,需要至少 Tier 1 的付费 API 等级。
GPT-Live-1 支持图片输入吗?
答:不支持。官方模型页写明输入输出为音频和文本,图片、视频模态均不支持。
0.05 美元一分钟是全部成本吗?
答:不是。$0.05/分钟只是前端语音层的价格,后端承担的推理、工具调用按所用模型与工具单独结算,做预算时要把两层相加。
能用自己录制的音色吗?
答:官方目前的路径是联系销售确认资格与申请流程,不是自助配置。公开可选的音色是官方公布的那一批(Quartz、Ripple、Vesper、Willow 等),官方表示后续几个月还会继续扩充音色和语言。
 京ICP备2024094994号-29