
Qwen4.5 是什么?还没发布,官方最新规划:参数迈向5-10T
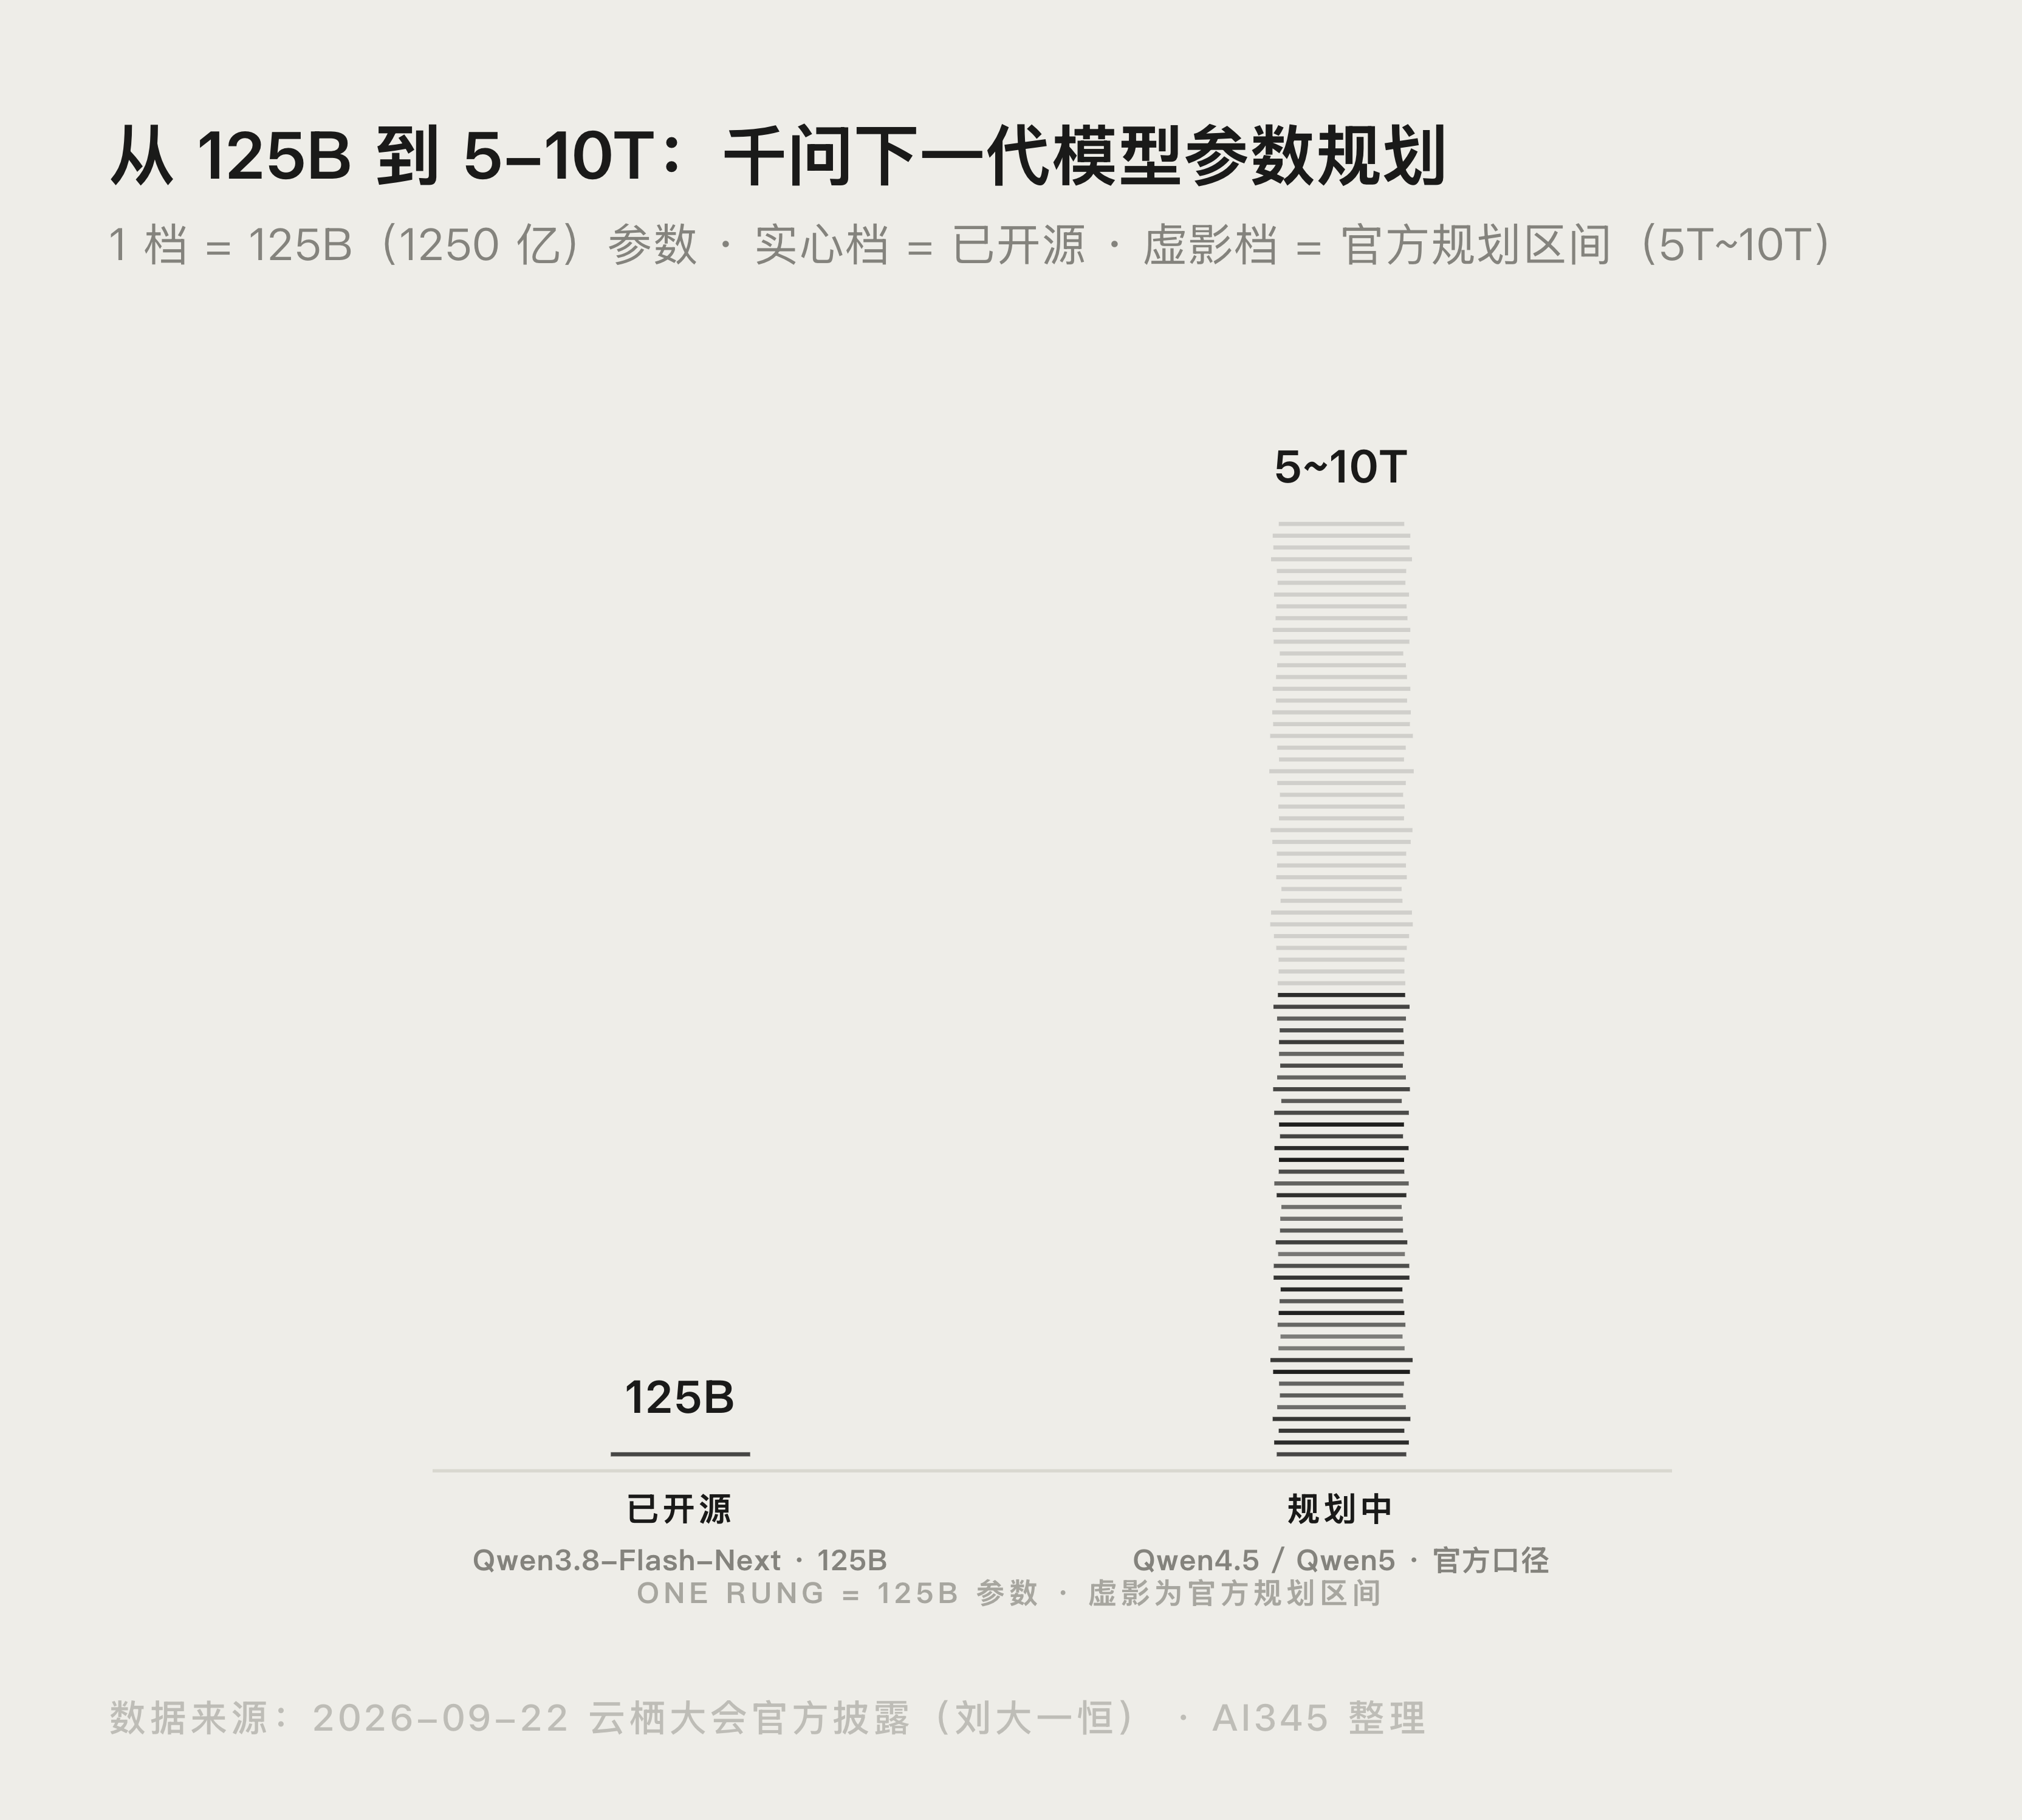
Qwen4.5 目前还没有发布。9 月 22 日云栖大会上,阿里 Qwen LLM 项目负责人刘大一恒首次给出官方口径:基于全新架构的 Qwen4 已经在训练中,Qwen4.5、Qwen5 均在稳步推进,总参数规模计划迈向 5 万亿至 10 万亿(5-10T)。
本文会讲清楚四件事:Qwen4.5 的官方信息有哪些、它和 Qwen4、Qwen3.8-Flash-Next 是什么关系、5-10T 参数意味着什么、现在能用上什么。
Qwen4.5 的官方信息:目前只确认了三件事
9 月 22 日云栖大会是 Qwen4.5 首次被官方公开提及。把现场披露的内容拆开,目前能确认的只有三件事:
- 版本路线:Qwen4 正采用全新架构展开训练,Qwen4.5、Qwen5 均在稳步推进中。
- 参数规模:未来 Qwen4.5、Qwen5 等版本总参数量将扩展至 5 万亿甚至 10 万亿的规模。
- 技术底座:Qwen3.8-Flash 提前开源的下一代千问架构(注意力机制与模型内信息传递机制创新)将成为新一代模型的基石,训练成本骤降近 90%。
除此之外,官方没有公布 Qwen4.5 的发布时间、具体参数和评测数据。网上流传的具体规格都属于猜测,建议以量子位对云栖大会的报道和千问官方渠道为准。
Qwen4.5、Qwen4、Qwen3.8-Flash-Next 是什么关系?
很多报道把这三个名字混在一起,一次说清:
| 名称 | 状态 | 说明 |
|---|---|---|
| Qwen3.8-Flash-Next | 已开源(8 月 26 日) | Qwen4 架构的预览版,125B 总参数,每 token 激活约 6B |
| Qwen4 | 训练中 | 采用全新架构的下一代正式系列 |
| Qwen4.5 / Qwen5 | 规划中 | 参数规模计划迈向 5-10T,时间未公布 |
可以理解为:Qwen3.8-Flash-Next 是阿里放出的「架构金丝雀」,先用一个开源模型验证下一代架构;Qwen4 是这套架构的正式版;Qwen4.5 和 Qwen5 则是在此基础上继续放大参数规模。
5-10T 参数意味着什么?
Qwen3.8-Flash-Next 的总参数是 125B(1250 亿),官方规划的 5-10T 相当于在此基础上放大 40 到 80 倍。
但总参数量大不等于推理成本等比上涨。千问新架构走的是稀疏 MoE 路线,Qwen3.8-Flash-Next 每 token 只激活约 6B 参数。稀疏激活让「总参数决定能力上限、激活参数决定推理成本」成为可能,这也是阿里敢把参数规划推到 10T 级别的技术前提。
顺带一提,同场大会还披露了 RSI(递归自我改进)的进展:Qwen3.8-Max 在人类零参与的情况下自主迭代 33 轮,Artificial Analysis 得分从 40 涨到 45,与 Claude、GPT 最强模型同处第一阵营。国产模型的版本节奏可以参考我们此前的GLM-5.3 实测与 GLM-6.0 发布动态。
等不及 Qwen4.5?现在就能用的架构预览模型
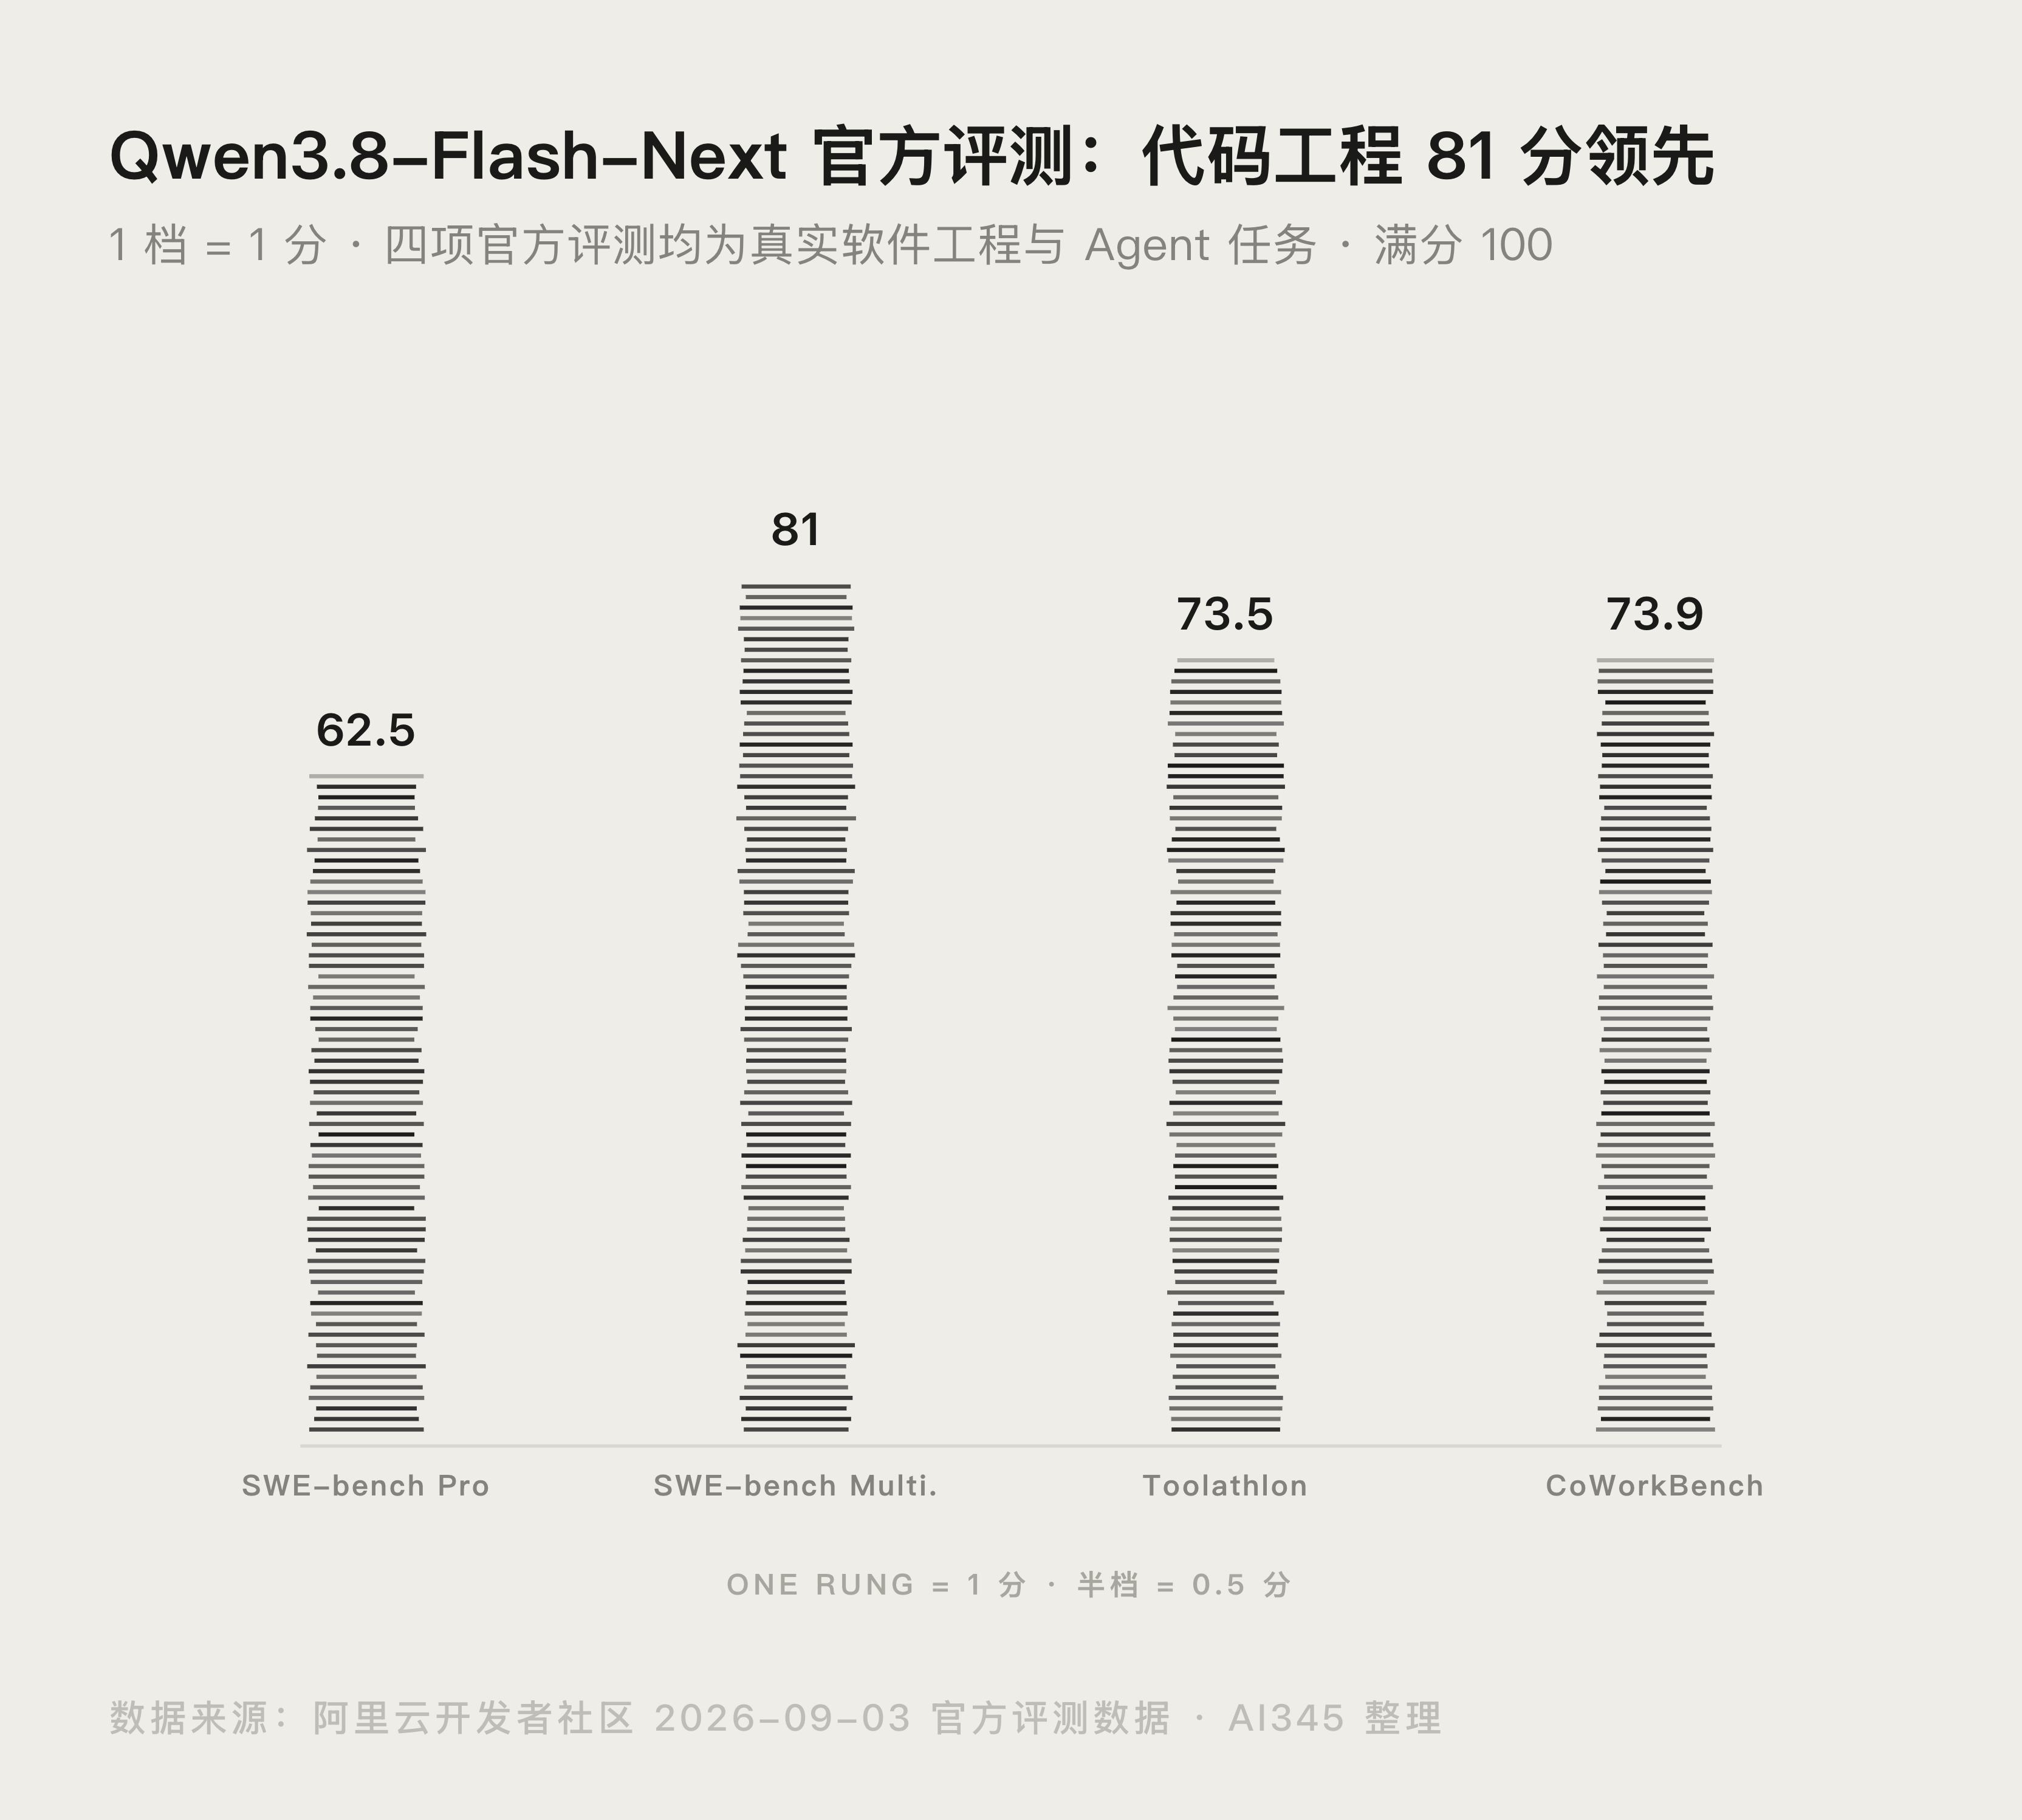
Qwen3.8-Flash-Next 是目前唯一能实际体验的「下一代千问」,它在真实软件工程和 Agent 任务上的官方评测数据如下:
| 评测项 | 得分 | 考核内容 |
|---|---|---|
| SWE-bench Pro | 62.5 | 真实代码仓库问题修复 |
| SWE-bench Multilingual | 81.0 | 多语言代码工程 |
| Toolathlon Verified | 73.5 | 智能体工具调用 |
| CoWorkBench | 73.9 | 长流程办公任务 |
价格与上下文方面:云服务版 Qwen3.8-Flash 定价为输入 0.16 美元/百万 token、输出 0.47 美元/百万 token,原生上下文 262144,通过 YaRN 可扩展到 100 万 token。API 同时兼容 OpenAI 和 Anthropic 协议,现有的 Claude Code、Codex 业务代码几乎不用改就能迁移,具体接入流程和 OpenRouter 多模型调用全解里的思路一致。更多细节见阿里云开发者社区的解析。
架构上,HuggingFace transformers 文档已经收录了这套下一代架构(Qwen4-Exp),包含三个核心组件:
- GatedResidual(GR):混合多条残差流,在注意力和 MoE 块前做细粒度门控。
- Qwen Sparse Attention(QSA):按块选择最相关的压缩 key 块,配合 Gated DeltaNet,成为首个融合线性注意力与稀疏注意力的混合架构。
- Per-Layer Embedding(PLE):为部分解码层注入词法特征,增强词汇级感知。
这三项就是 Qwen4 训练所用新架构的核心,也是 Qwen4.5 能把参数推到 5-10T 的基础。
怎么第一时间用上 Qwen4.5?
官方没有给时间表。参考 Qwen3.8-Flash-Next 的节奏(8 月 26 日开源、云服务同步),Qwen4 大概率延续「开源权重 + 云服务 API 同步」的发布方式。想第一时间用上,建议盯三个渠道:
- Hugging Face 的 Qwen 组织页:开源权重第一时间在这里放出。
- 魔搭社区(ModelScope):此前 Qwen3.8-Flash-Next 就提前挂了发布倒计时。
- 阿里云百炼平台:API 版本通常同步上线,兼容 OpenAI 协议。
另外,同场官宣的下一代视频生成模型计划 11 月发布,主打更长时长、更可控的角色与镜头。阿里系视频模型的现有能力可以先看通义万相 Wan 3.0 上手指南。
总结
Qwen4.5 的故事可以浓缩成一句话:架构已经开源验证(Qwen3.8-Flash-Next),正式系列在训练(Qwen4),参数规模剑指 5-10T(Qwen4.5、Qwen5)。对开发者来说,与其等待 Qwen4.5,不如现在就把 Qwen3.8-Flash-Next 接进工作流,提前适配下一代架构的协议和上下文能力。
本文由 AI345 整理,最后更新于 2026 年 9 月。
常见问题
Qwen4.5 发布了吗?
答:还没有。9 月 22 日云栖大会的官方口径是:Qwen4 已在训练中,Qwen4.5、Qwen5 稳步推进,但未公布任何时间表。
Qwen4.5 有多大?
答:官方规划总参数规模为 5-10T(5 万亿至 10 万亿),采用稀疏 MoE 架构。每 token 激活多少参数暂未披露,参考架构预览模型的 6B 激活,实际推理成本不会随总参数等比上涨。
Qwen4.5 和 Qwen4 有什么区别?
答:Qwen4 是全新架构的下一代正式系列,Qwen4.5 是它之后的参数扩展版本,两者共用同一套新架构底座。目前 Qwen4 在训练中,Qwen4.5 处于规划推进阶段。
现在能用什么代替 Qwen4.5?
答:可以体验已开源的 Qwen3.8-Flash-Next,或云服务版 Qwen3.8-Flash。它们提前采用了 Qwen4 的核心架构,SWE-bench Multilingual 得分 81.0,支持百万级上下文。
Qwen4.5 会开源吗?
答:官方未确认。但开源是千问的惯例打法:阿里已开源 460 余个 Qwen 模型,下载量突破 30 亿次,Qwen3.8-27B 还是 Hugging Face 史上最受欢迎的开源大模型,Qwen4.5 大概率延续开源策略。
Qwen 和 GLM、DeepSeek 相比处于什么水平?
答:以同场披露的数据看,Qwen3.8-Max 在 Artificial Analysis 得分 45,与 Claude、GPT 最强模型同处第一阵营,领先 GLM5.3、Kimi-K3 等国产模型。Qwen4.5 尚无评测数据,无法直接对比。
 京ICP备2024094994号-29