
Qwen3.8-Omni-Flash 怎么用?4 步跑通音视频输入
Qwen3.8-Omni-Flash 怎么用,答案分两条路:想在网页上试,直接打开 Qwen Studio 上传音频或视频提问,零代码;想接进产品,就在阿里云百炼开通后拿到 API Key,用 OpenAI 兼容接口调用 qwen3.8-omni-flash。输入支持文本、图片、音频、视频,输出只有文本。国内调用价是输入 0.8 元、缓存命中输入 0.1 元、输出 2.7 元(每百万 Token)。下面按 4 步把两条路都跑一遍。
本文包含:
- 它是什么、能做什么、有哪些坑(含官方参数表)
- 4 步跑通 API:开通百炼、配 base_url、传音频、传视频(附完整 Python 代码)
- 国内真实价格、免费额度规则,以及两个最容易误读的成本细节
- 和上一代 Qwen3.5-Omni-Plus 的官方对比数据
- 不写代码的玩法:把 Qwen-MM-Plugins 装进 Claude Code、Codex 等 Agent
Qwen3.8-Omni-Flash 是什么?
Qwen3.8-Omni-Flash 是阿里千问团队 2026 年 9 月 18 日发布的下一代原生全模态模型,官方中文标题是「耳聪目明,办事得力」。
一句话概括这次的变化:上一代全模态模型解决的是「听懂、看懂」,这一代开始解决「把活干完」,也就是在音视频场景里自己规划任务、调用工具、交付结果,官方把它叫做 Agentic 能力。所以它的宣传重点不是刷榜,而是视频剪辑、影视解说、会议纪要、声音与画面协同分析这类真实工作流。
「原生全模态」指的是四类输入在同一模型内理解,不是外挂一个转写模型再接一个大模型。官方给的完整参数和上下文限制如下(来自阿里云百炼模型页,页面更新时间 2026-09-18):
| 项目 | 说明 |
|---|---|
| 输入模态 | 文本、图片、音频、视频 |
| 输出模态 | 仅文本,不含语音输出 |
| 上下文长度 | 1M Token |
| 最大输入长度 | 991,808 Token(非思考模式)/ 983,616 Token(思考模式) |
| 最大输出长度 | 131,072 Token |
| 调用方式 | Chat Completions、Responses |
| 工具能力 | Function Calling、联网搜索(Responses 内置工具仅 web_search) |
| 缓存 | 隐式缓存、Responses Session 缓存 |
| 音频输入语种 | 113 种语言和方言,支持多通道空间音频 |
| 支持地域 | 华北2(北京)、新加坡、中国香港、日本(东京)、德国(法兰克福)、美国(弗吉尼亚) |
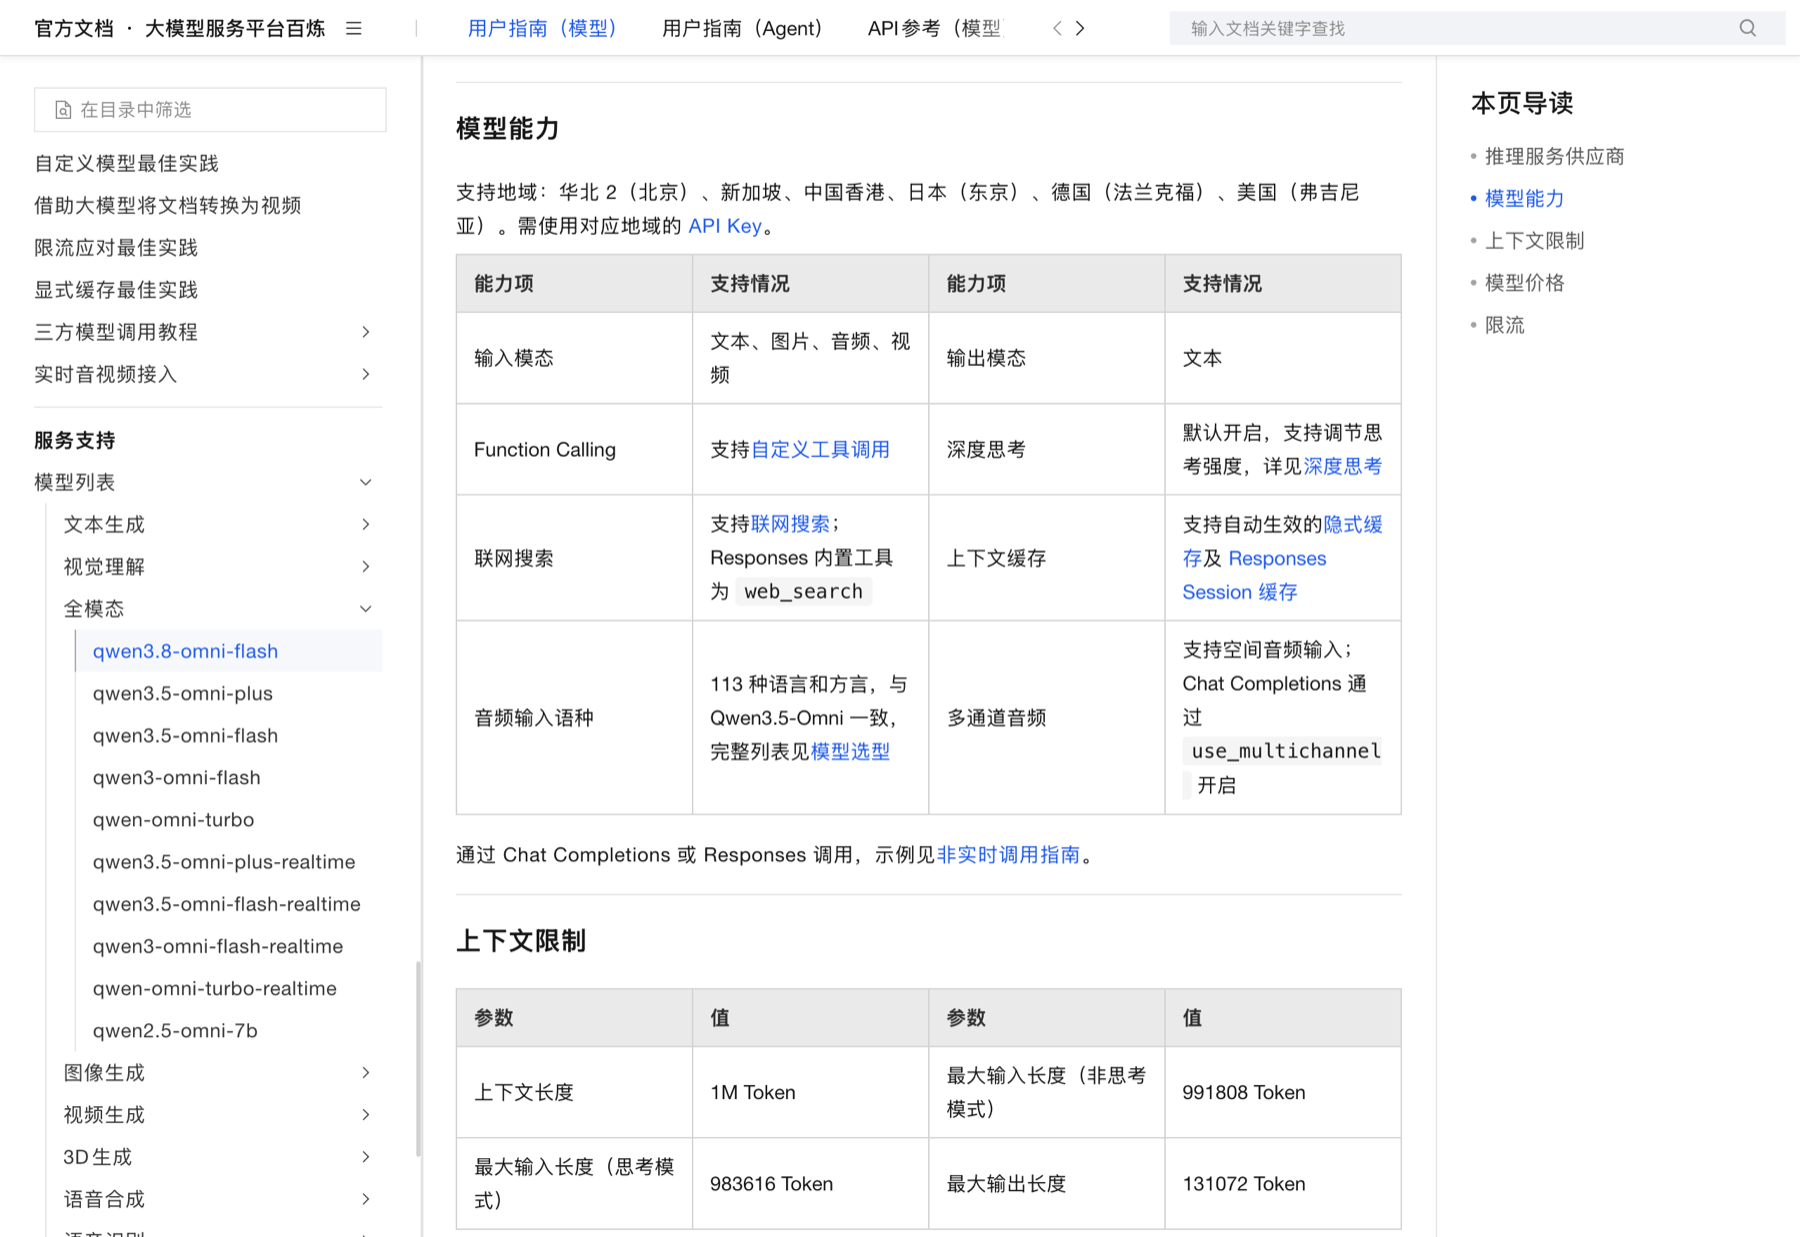
表格里有两行最容易被忽略。一是「输出模态:仅文本」,官方文档写得很直白,需要语音输出请改用 qwen3.5-omni-plus,这意味着它做不了配音、语音助手这类要「开口」的活。二是 6 个地域各自独立,API Key 必须和地域匹配,用北京地域的 Key 去请求新加坡端点会直接报错。
思考模式默认开启,可以调节思考强度。这点在算成本时要留意:思考过程本身也计入输出 Token。
Qwen3.8-Omni-Flash 怎么用?4 步跑通
如果你只是想先试试效果,可以直接跳过前三步,打开 Qwen Studio(chat.qwen.ai)上传一段录音或视频提问,这是官方提供的体验入口,不需要写代码。
下面这 4 步是给要把它接进自己系统的人:接完就能在代码里处理音频和视频。
第一步:开通阿里云百炼,拿对应地域的 API Key
- 用阿里云账号登录阿里云百炼控制台,首次开通会自动发放新人免费额度。
- 在控制台创建 API Key,并确认它属于哪个地域(业务空间)。
- 记下这个地域对应的服务地址(base_url),后面第二步要用。
地域和 Key 不匹配是新手最容易卡住的一步。百炼开通、取 Key、查免费额度可以参考 官方模型调用价格页 与 免费额度说明。
第二步:安装 OpenAI SDK,配好 base_url
Qwen3.8-Omni-Flash 兼容 OpenAI 协议,所以官方示例直接用 OpenAI 的 Python SDK。把 base_url 换成你的地域地址,模型名固定填 qwen3.8-omni-flash。
python3 -m pip install openai
export DASHSCOPE_API_KEY="你的 API Key"
export DASHSCOPE_BASE_URL="你的业务空间 Chat Completions 地址"
export AUDIO_URL="https://你的可访问域名/meeting.wav"
第三步:传入音频,让它总结会议录音
音频走 input_audio 字段,data 填可公网访问的音频 URL,format 填 wav。官方说明音频输入支持 113 种语言和方言,中文会议、方言访谈都可以直接丢进去。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url=os.environ["DASHSCOPE_BASE_URL"],
)

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "总结这段录音的主要内容,列出待办事项。"},
            {"type": "input_audio", "input_audio": {
                "data": os.environ["AUDIO_URL"],
                "format": "wav",
            }},
        ],
    }],
    stream=True,
    stream_options={"include_usage": True},
)

section = None
for chunk in completion:
    if not chunk.choices:
        if chunk.usage:
            print("
用量:", chunk.usage)
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        if section != "thinking":
            print("
思考过程:")
            section = "thinking"
        print(delta.reasoning_content, end="", flush=True)
    if delta.content:
        if section != "answer":
            print("
模型回复:")
            section = "answer"
        print(delta.content, end="", flush=True)
如果你要处理双声道或四声道的空间音频,在音频对象里加一个 "use_multichannel": True(与 data、format 同级),默认是 False,按单通道解析。这是它区别于普通转写模型的地方:声音的方向和距离信息会保留下来。
第四步:传入视频,控制画面 Token 再喂给模型
视频是最费钱的一环,因为画面会按帧折算成 Token。官方给出的建议是先用 max_pixels 控制画面精度,再决定要不要整段丢进去:
| 使用场景 | 推荐视频长度 | max_pixels 推荐值 |
|---|---|---|
| 快速审核,成本优先 | ≤60 分钟 | 230,400 |
| 标准分析(短视频打标) | ≤4 分钟 | 921,600 ~ 2,073,600 |
| 精细分析(多说话人、复杂场景) | ≤2 分钟 | 2,073,600 |
response = client.responses.create(
    model="qwen3.8-omni-flash",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "描述视频中的画面和声音,并给出关键时间点。"},
            {"type": "input_video", "video_url": os.environ["VIDEO_URL"]},
        ],
    }],
    stream=False,
)

print(response.output_text)
注意音频和视频在 Chat Completions 与 Responses 两种协议里的字段写法不同:Chat Completions 用 input_audio.data,Responses 用 input_audio.audio_url,视频对应 input_video.video_url。另外音视频输入只允许出现在 user 消息里。完整字段说明见官方 Qwen-Omni 调用指南。
Qwen3.8-Omni-Flash 多少钱?国内价格与两个省钱细节
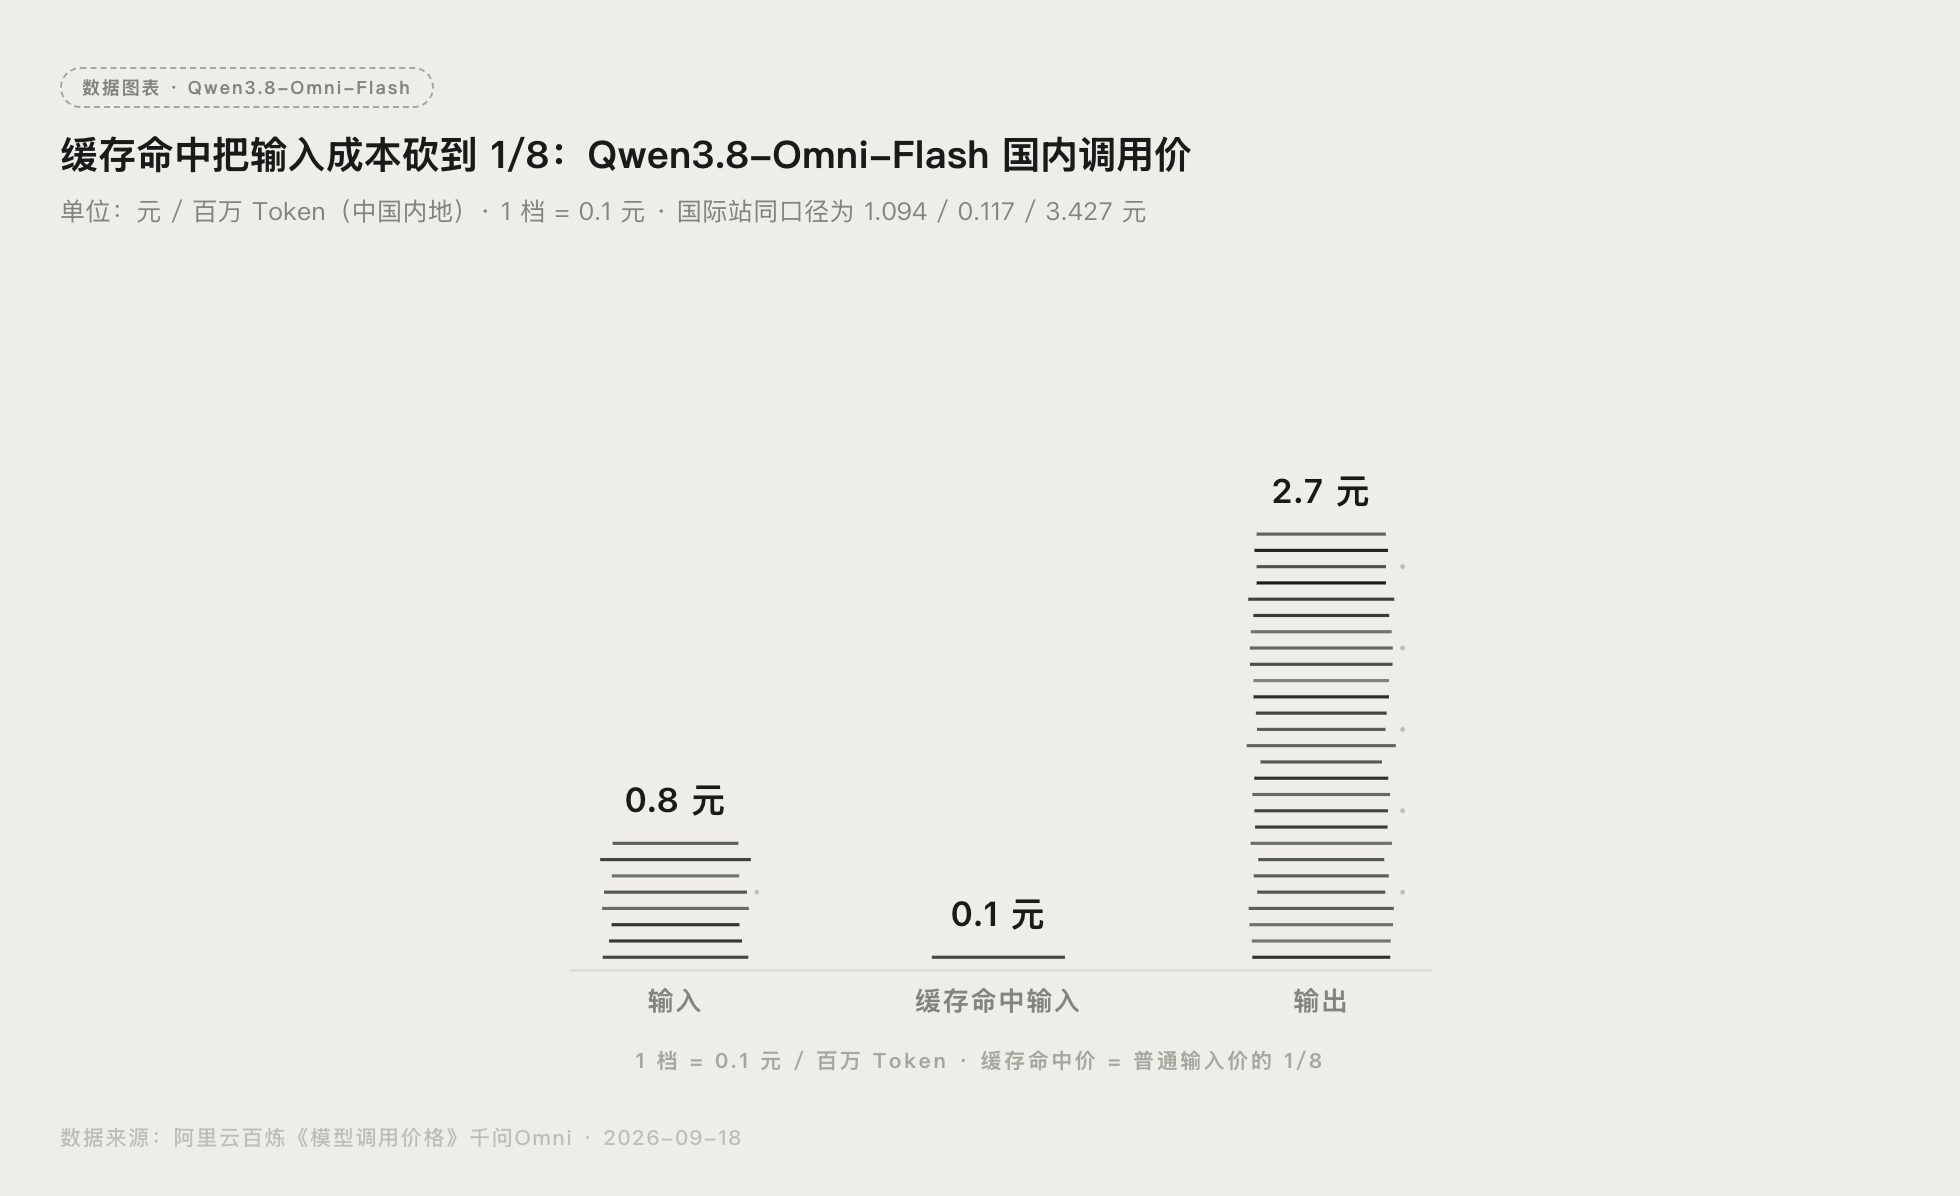
中国内地调用价(元 / 百万 Token):输入 0.8、缓存命中输入 0.1、输出 2.7。国际站同口径是 1.094 / 0.117 / 3.427。
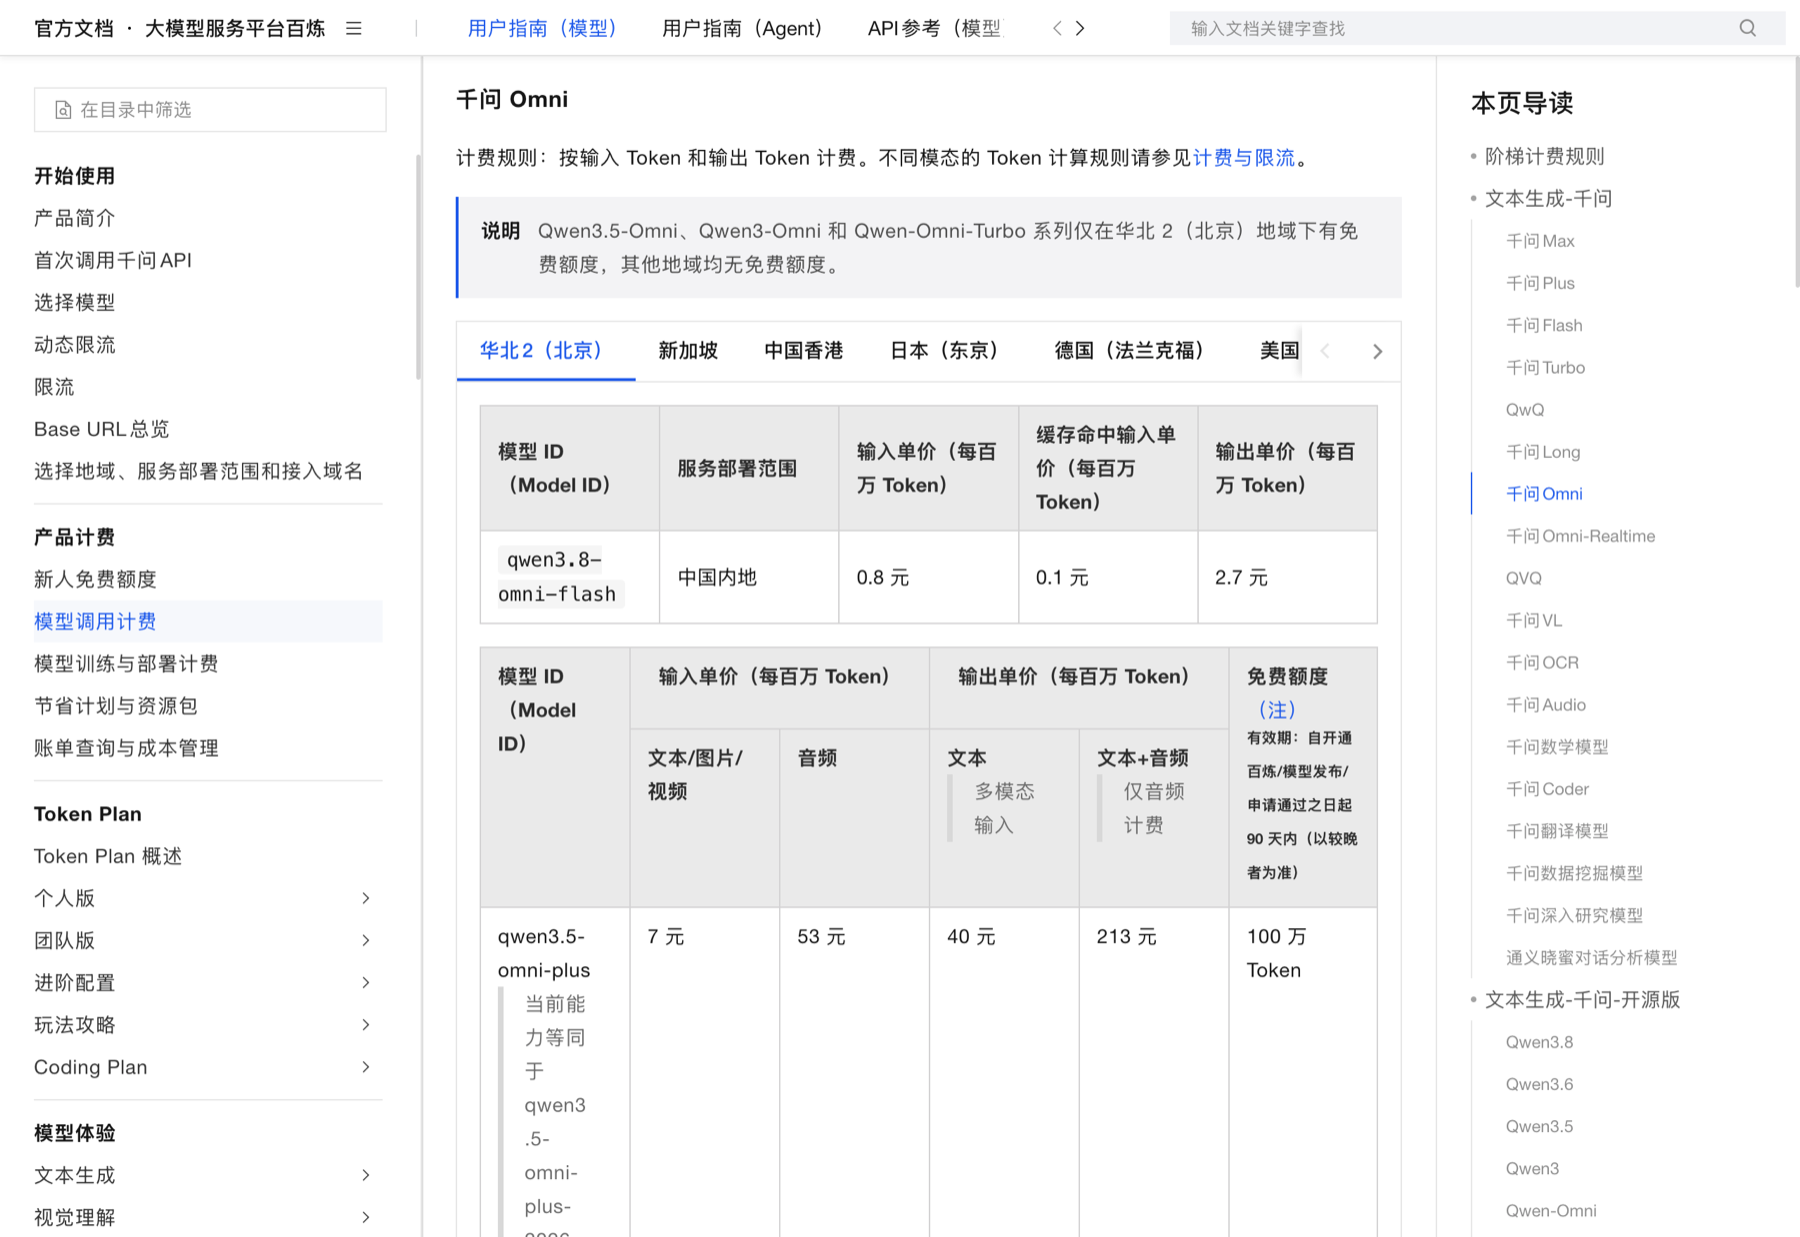
两个容易被误读的地方,我们按官方单价换算了一遍:
- 「音频输入成本降 98%」是相对降幅,不是每小时多少钱。 官方对比的是上一代 Qwen3.5-Omni-Plus,真实花费仍然按 Token 单价算。如果你把它理解成「每小时音频只要几毛钱」,很容易在长素材上算错预算。
- 缓存命中是真的省钱,把输入成本降到 1/8。 普通的缓存命中输入是 0.1 元,比标准输入 0.8 元低 87.5%,同一段素材反复追问时差距会放大。反过来说,每次都换新素材、缓存命中不了,就是实打实的 0.8 元档。
再给一个直观的量级:一段约 1500 到 2000 Token 的回复,输出成本大约是 0.004 到 0.005 元;把 1M 上下文一次性塞满,输入成本是 0.8 元,命中缓存则只需 0.1 元。这两个数按官方单价线性换算得出,是估算值,实际账单以控制台为准。
Qwen3.8-Omni-Flash 免费吗?免费额度怎么算
按阿里云百炼的新人免费额度规则,它不一定是「完全免费」,但新账号通常能先白用一段:
- 谁有:首次开通阿里云百炼的账号,系统自动发放,无需手动领取,也无需先实名认证。
- 多少:按模型独立发放,通常每个模型 100 万 Token,输入和输出共用这一个总额度。
- 多久:有效期 90 天,从开通百炼、模型发布或申请通过之日起算,以较晚者为准,过期不补发。
- 哪个地域:只有华北2(北京)地域的模型享有免费额度,其他地域没有。
- 用完会怎样:未实名认证的账号额度用完后无法继续调用;已认证账号会自动转按量付费,建议在控制台开启「免费额度用完即停」避免意外扣费。
需要提醒的是:免费额度是按模型逐个发放的,某个模型有额度不代表所有模型都有。qwen3.8-omni-flash 具体的额度余量,以控制台「免费额度」页实时显示为准。
Qwen3.8-Omni-Flash 和 Qwen3.5-Omni-Plus 有什么区别?
官方给的对比口径是:累计 29 项评测平均提升超 25%,音视频能力接近 Gemini 3.8 Flash,音频能力整体超过 Gemini 3.8 Flash。挑几个能看出方向的提升值:
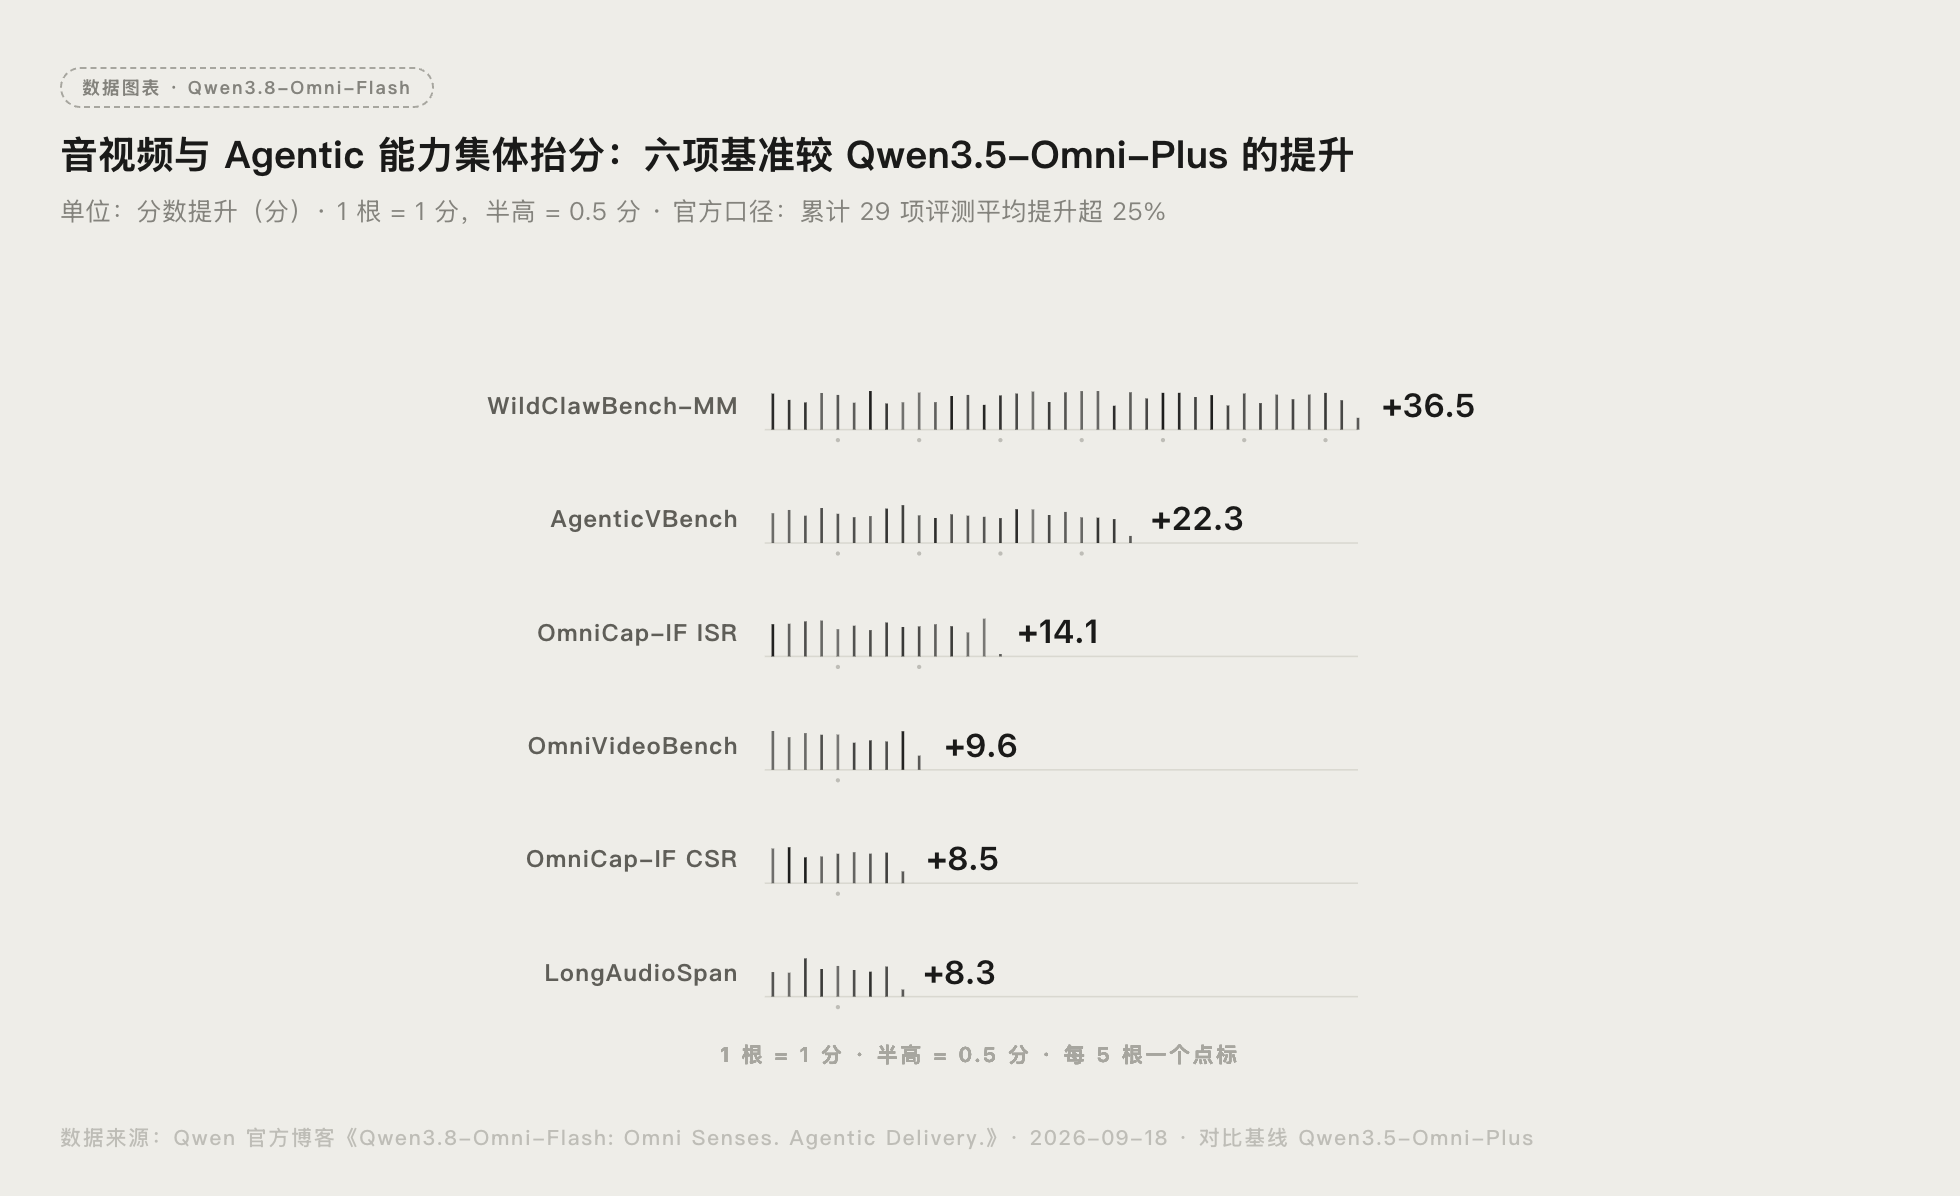
- 音视频 Agent 能力:WildClawBench-MM 提升 36.5 分,AgenticVBench 提升 22.3 分,UniClawBench 拿到 69.6 分。
- 长音频与音视频理解:LongAudioSpan 提升 8.3 分,OmniVideoBench 提升 9.6 分。
- 音视频描述:OmniCap-IF 的 CSR 与 ISR 分别提升 8.5 和 14.1 分。
- 多人会议识别:AliMeeting 的 DER 与 cpWER 从 88.11 / 89.61 降到 3.35 / 17.18,这条对做会议纪要的人意义最大。
另一个值得单看的是它处理长视频的方式变了。以前要模型从头到尾把整段视频看完,现在是「按需取证」:模型从你的问题出发,自己决定该看哪几分钟、听哪几段,多轮由粗到细地找证据。
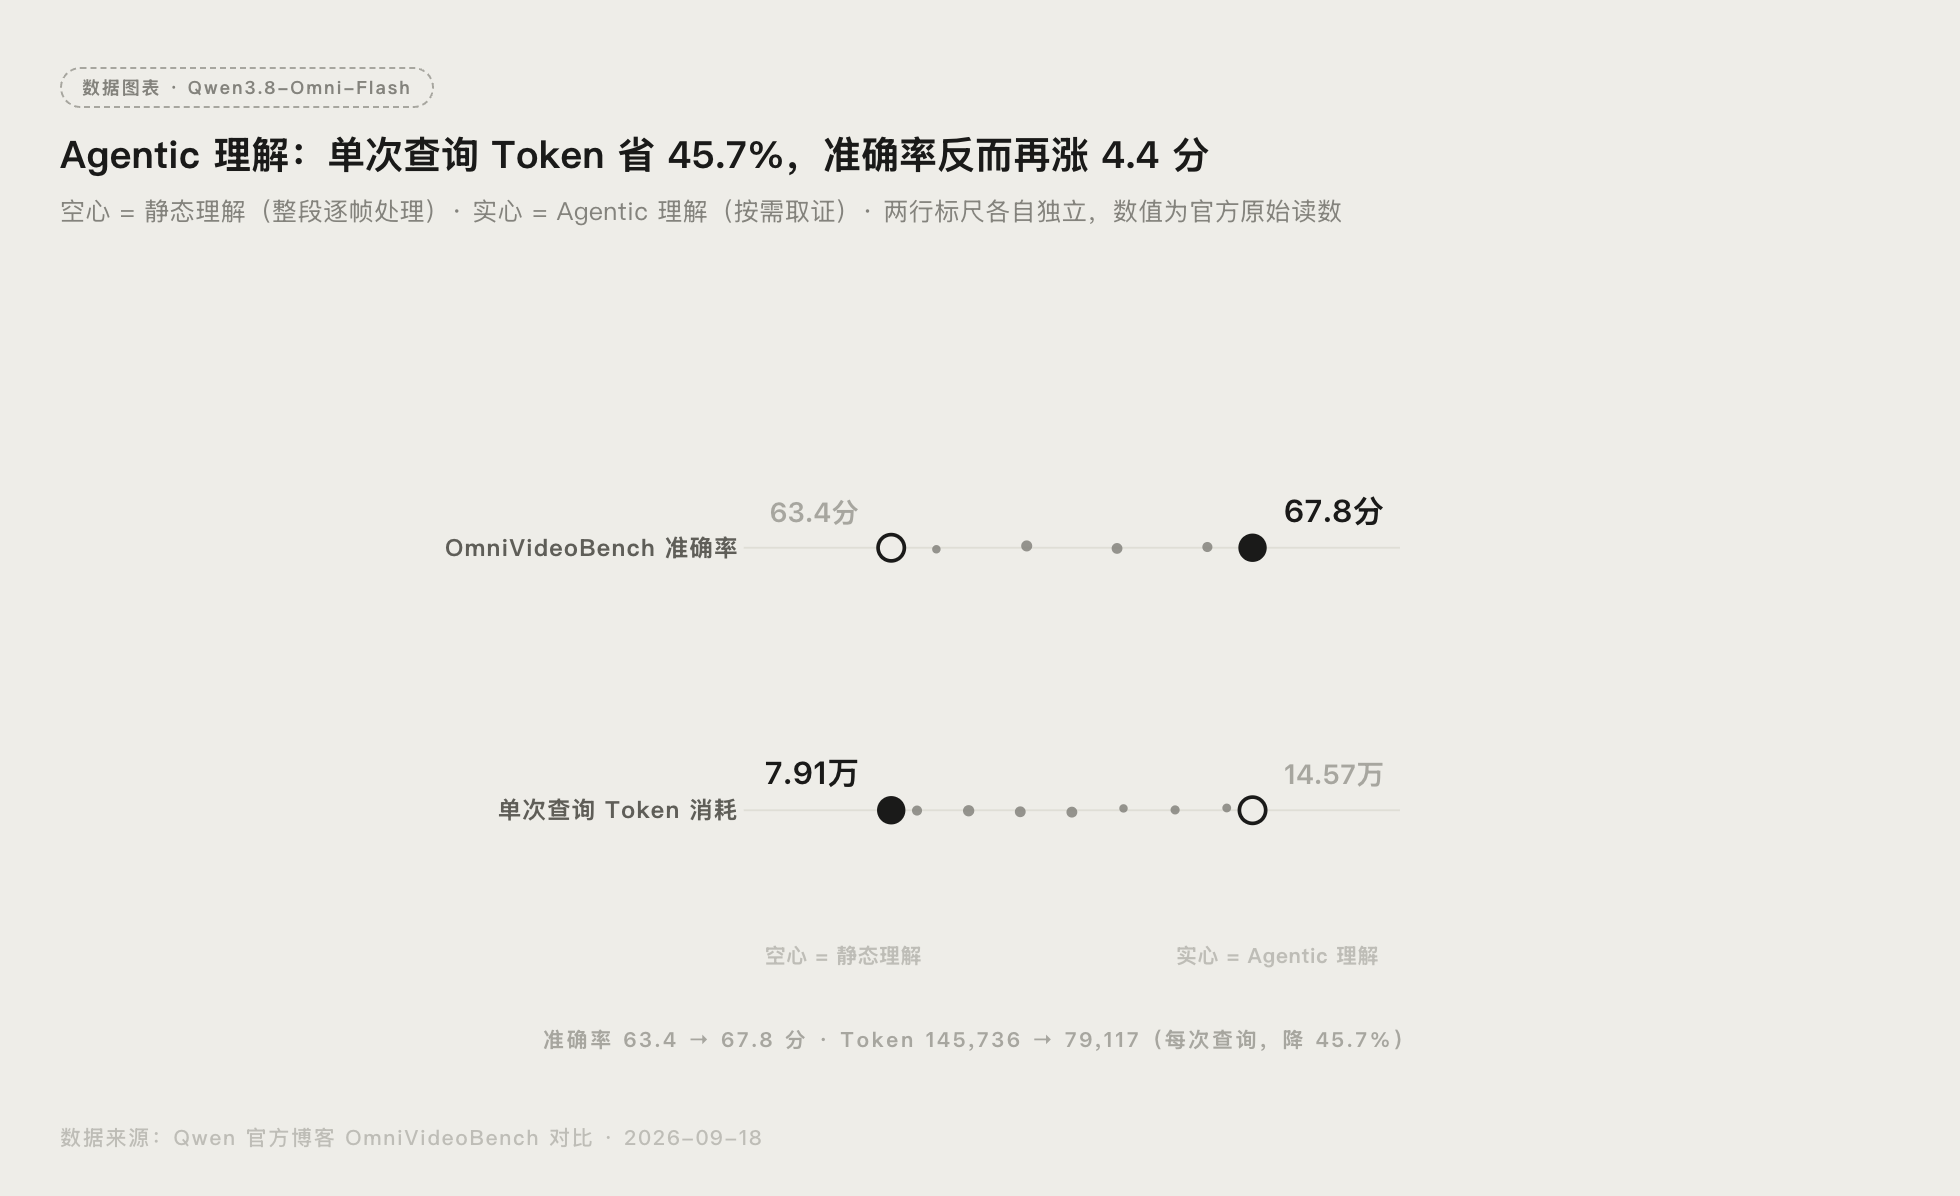
官方在 OmniVideoBench 上的数字是:准确率从 63.4 提到 67.8 分,单次查询的 Token 消耗从 145,736 降到 79,117,降了约 45.7%。也就是说,省 Token 不等于降准确率,反而是更准了。
想横向看同一代 Flash 系列其他档位的取舍,可以参考站内的 Qwen3.8-Flash 与其他主流模型对比。
要把它跑在本地,需要另选开源权重,步骤见 Qwen3.8-Flash-Next 本地部署教程。
如果预算更高、要旗舰档位,可以看 Qwen3.8-Max 使用指南。
三个最容易踩的坑
- 以为它能「说」。 输出模态只有文本。如果你要的是语音回复、声音复刻,用 qwen3.5-omni-plus 或 qwen3.5-omni-flash,别在这个模型上反复试。
- API Key 的地域和端点不一致。 6 个地域各自独立,Key 也只对同一地域有效。报鉴权错误时,先检查 Key 属于哪个地域,再看 base_url。
- 把两三个小时的视频整段丢进去。 官方博客写明原生支持最长 1 小时的音视频输入,更长的素材建议分段处理;同时思考模式默认开启,思考过程计入输出 Token,长视频会把这部分成本放大。
不用写代码的玩法:装进 Claude Code、Codex 里用
除了直接调 API,官方还开源了一套插件 Qwen-MM-Plugins,把图片、音频、视频、文档理解能力装进你已经在用的 Agent 里。我们核对了官方仓库:目前 2.9k star、178 fork、214 次提交,最新一次提交的说明里明确把 Omni 的默认模型指向了 qwen3.8-omni-flash,说明这个插件已经在跟新模型对齐。
六个插件各有分工:core 读图片、视频帧、PDF、Office 等文件,api 做图片理解、OCR、音视频转写、说话人分离、事件分析,omni-chatcut 做 MV 和影视解说,omni-video2note 把视频教程整理成带截图的 PDF 笔记,omni-skill-creator 把操作演示提炼成可复用的 Skill,omni-memory 给长视频建立人物与事件记忆。
安装方式是官方引导脚本,支持 Codex、Claude Code、Qwen Code、Gemini CLI、Qoder、CodeBuddy、OpenClaw:
curl -fsSL https://raw.githubusercontent.com/QwenLM/Qwen-MM-Plugins/main/install.sh | bash
装完重启 Agent 或新建任务即可,仓库地址:QwenLM/Qwen-MM-Plugins。
总结
Qwen3.8-Omni-Flash 的用法可以压缩成三句话:想试效果就用 Qwen Studio 上传音视频;要接系统就在百炼拿对应地域的 Key,用 OpenAI 协议调 qwen3.8-omni-flash,音频走 input_audio、视频走 input_video;成本按 Token 算,输入 0.8 元、缓存命中 0.1 元、输出 2.7 元(每百万 Token),缓存命中能把输入成本压到 1/8。
上手顺序上,建议先用一段自己的会议录音跑第三步,确认返回质量后再上视频,并且一开始就给 max_pixels 设一个较小的值控制成本。
最后更新:2026 年 9 月 18 日。作者:AI345。
本文事实与截图来自 Qwen 官方博客(qwen.ai/blog?id=qwen3.8-omni-flash)、阿里云百炼模型信息页、模型调用价格页。
调用细节参考官方 Qwen-Omni 调用指南,插件信息来自 Qwen-MM-Plugins 仓库,社区反应来自 Reddit r/LocalLLM 上关于该模型的讨论帖。
常见问题
Qwen3.8-Omni-Flash 免费吗?
答:模型本身是付费 API,按 Token 计费,输入 0.8 元 / 百万 Token、输出 2.7 元 / 百万 Token。但首次开通阿里云百炼的新账号通常会拿到该模型的独立免费额度(通常 100 万 Token、90 天有效、仅华北2北京地域),额度内可以白用。具体余量以控制台「免费额度」页为准。
Qwen3.8-Omni-Flash 是开源的吗?能本地部署吗?
答:它不是开源权重模型,官方目前只通过阿里云百炼和千问 AI 平台提供 API 调用。开源的是配套工具链:插件 Qwen-MM-Plugins 和运行环境 Qwen-Live Harness。确实需要本地权重,可以看开源的多模态底座去部署。
Qwen3.8-Omni-Flash 能生成语音吗?
答:不能。它的输出模态只有文本,官方文档明确写着需要语音输出请使用 qwen3.5-omni-plus。它的强项是理解音频和视频并给出文本结果,比如转写、会议纪要、字幕、内容分析。
Qwen3.8-Omni-Flash 最多能处理多长的音频和视频?
答:官方博客写明原生支持最长 1 小时的音视频输入。更长的素材官方建议分段处理。上下文是 1M Token,理论输入上限 991,808 Token(思考模式 983,616),但视频画面会按帧折算 Token,实际能塞多长取决于分辨率设置。
Qwen3.8-Omni-Flash 怎么调用?支持哪些协议?
答:支持 Chat Completions 和 Responses 两种协议,兼容 OpenAI 接口规范,用 OpenAI 官方 SDK 把 base_url 换成百炼对应地域的地址即可。模型名填 qwen3.8-omni-flash,同时支持 Function Calling 和联网搜索(Responses 内置工具目前只有 web_search)。
Qwen3.8-Omni-Flash 和 Gemini 3.8 Flash 哪个好?
答:官方口径是音视频能力接近 Gemini 3.8 Flash、音频能力整体超过。选型时别只看榜单:需要语音输出的场景它做不了,需要国内稳定调度和人民币结算的场景它更省事。两边都试一遍同样的素材,比看参数更快得出结论。
 京ICP备2024094994号-29