
Kimi K3.1 Pro 费 token?高72%的成因与省钱设置
Kimi K3.1 Pro 费 token?高72%的成因与省钱设置
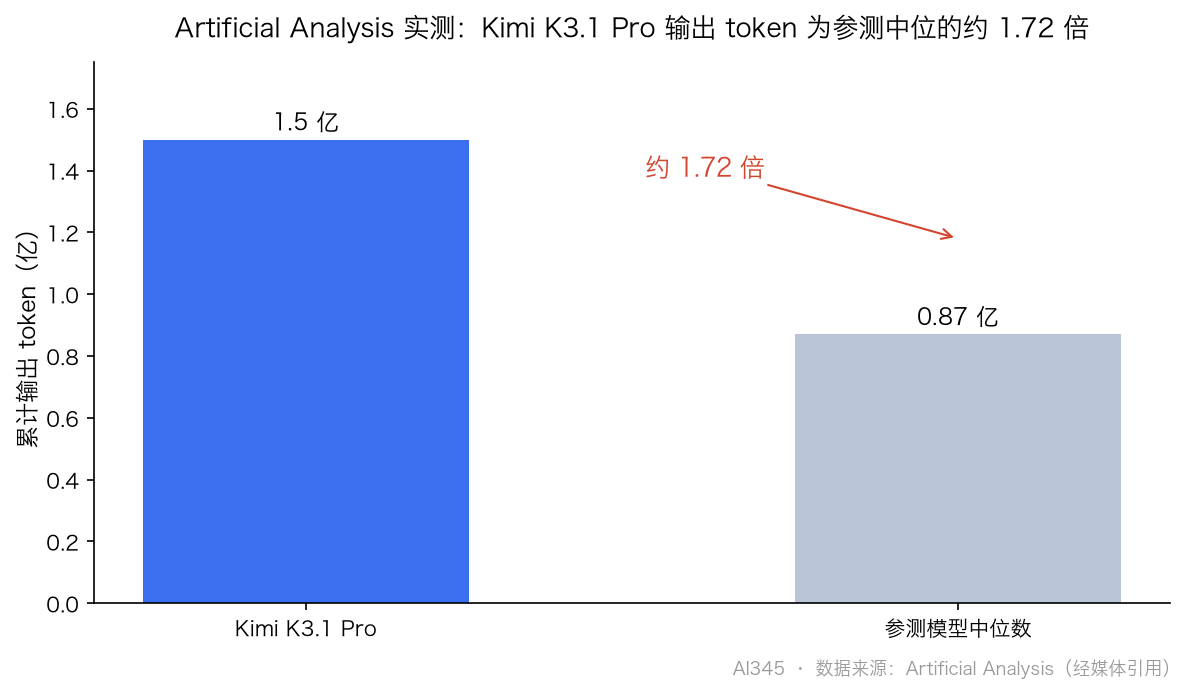
先给结论:贵不是错觉。Artificial Analysis 统计 K3.1 Pro 跑完一套评测累计输出约 1.5 亿个 token,是参测模型中位数 8700 万的 1.72 倍,同样完成任务多吐 72%。
先确认:你是不是撞上了同一件事
中两条以上基本就是同一回事:
- 一句话发出去,十几分钟额度见底,任务还没跑完
- 让 Agent 审查项目架构,它拉起五六个子 Agent
- 同一个任务,上一代 K3 一次能过,K3.1 Pro 反复调试
- 只发了句「你好」,token 计数就有几万
为什么这么费:三层原因
第一层:默认最高强度思考,而且关不掉
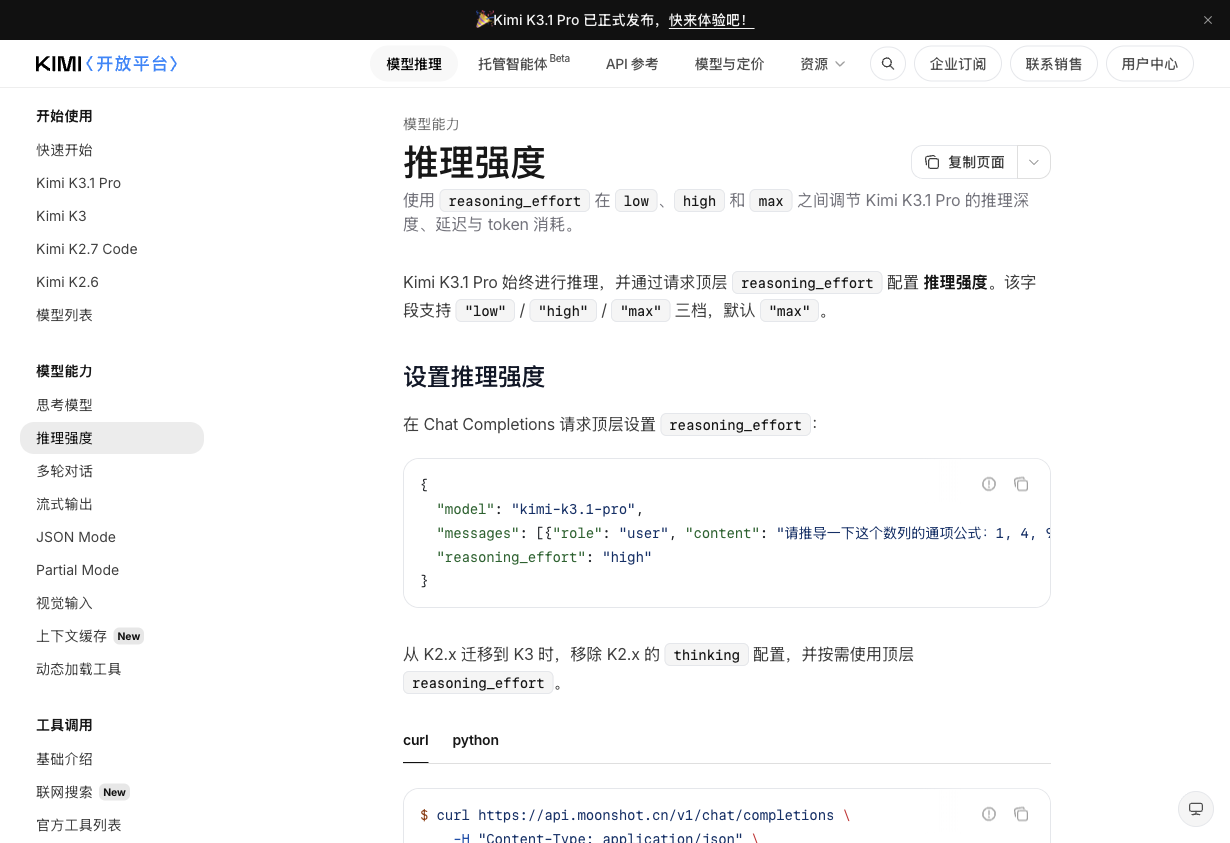
最直接也最被忽略的一条。推理强度字段是 reasoning_effort,取 low / high / max 三档,官方推理强度文档写明默认值就是 max。不写就按最高强度跑,改个变量名和推导数学证明付同一档成本。
关键在思考关不掉。官方常见问题原话是「目前关不了,K3.1 Pro 始终开启思考模式」。想省只能降到 low。
第二层:它倾向于把活儿派给子 Agent
K3.1 Pro 是 K3 的大规模后训练版本,官方说法是大幅增加 RL 算力、在数百个下游领域做联合强化学习。Agent 能力被拉上去了,代价是它学会了「先拆任务、再派给子 Agent」。
经济观察报引用的一位接近 Kimi 的人士说得直接:新模型配置出了问题,倾向于把工作派给子 Agent。10 月 26 日的致歉声明也认了这点,说正在减少不必要的子 Agent 调用和输出长度。对订阅用户伤害最大,199 元档用户的原话是:只发一句审查项目架构,拉起 5 个子 Agent,十几分钟 5 小时额度就满了。
第三层:长上下文在多轮里复利
上下文窗口是 1,048,576 tokens,这是能力也是陷阱。后面每次请求都要把历史重读一遍,多轮工具调用下输入 token 乘着轮数涨。Kimi 10 月 26 日的致歉声明把限流和额度异常消耗两件事一起认了。
三个能立刻见效的设置
订阅用户先去找官方新增的「是否使用子 Agent」开关,它直接治第二层原因。API 用户则靠下面三条。
设置一:显式写 reasoning_effort
唯一不需要等官方修的一条:
{
  "model": "kimi-k3.1-pro",
  "messages": [{"role": "user", "content": "把这个变量名改成 user_count"}],
  "reasoning_effort": "low"
}
分档:格式化、改名、分类抽取、简单问答走 low;日常写代码改 bug 走 high;复杂重构、数学证明、多步 Agent 任务才值得 max。钱有没有被思考吃掉,看 usage.completion_tokens_details.reasoning_tokens,输出费用包含推理和正文。
设置二:把稳定内容放前面,让缓存命中
缓存自动生效,请求前缀一致就命中。命中价 1.3 元,未命中 13 元,差整整十倍,这是全篇最值钱的换算。验证看 usage.prompt_tokens_details 里的 cached_tokens,命中率低说明你每次都把变化的内容塞进了开头。做法三条:
- system prompt、工具定义、参考资料、代码库全部放最前面
- 用户问题、工具返回结果、任务状态放后面
- 前缀里别出现时间戳、随机 ID、会话序号,一处变动后面全部作废
TTL 默认 5m,请求间隔可能超过 5 分钟的长会话传 prompt_cache_options 选 1h,官方算过账:前缀 1M tokens 时 1 小时内再命中 2 次,选 1h 比 5m 净省 16 元。
设置三:别用高速版跑长任务
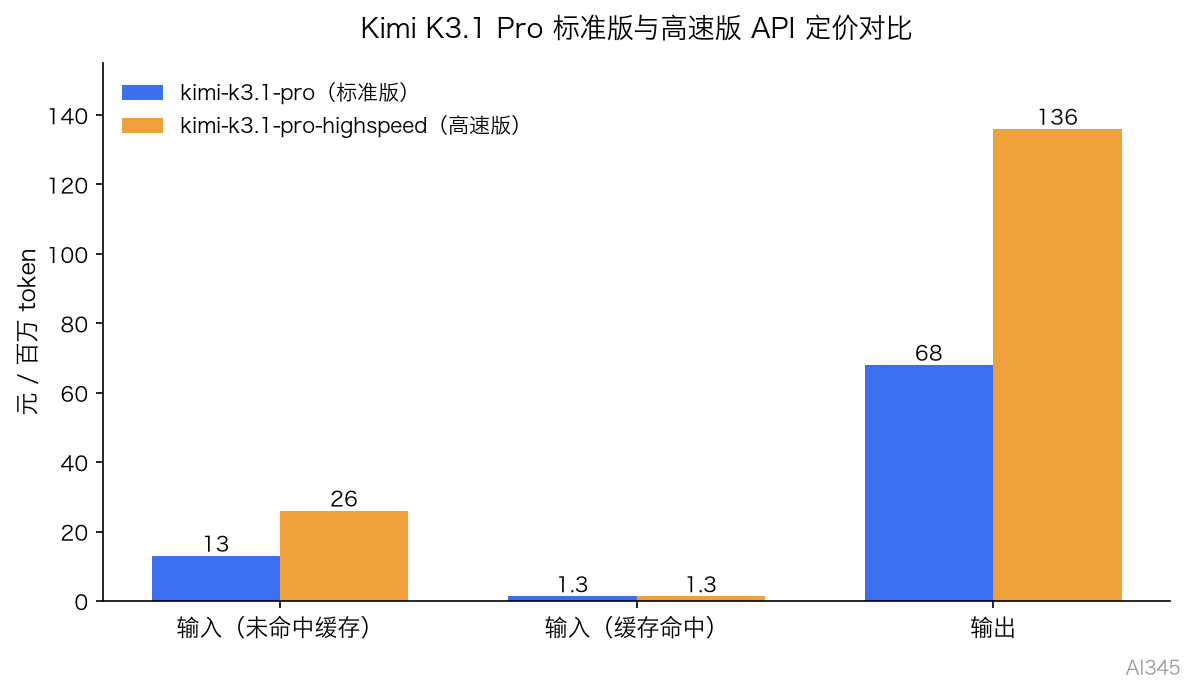
高速版智能和标准版一样,输出快 2 到 3 倍,但输入未命中和输出价格都是 2 倍。容易被忽略的是缓存命中价和标准版一样,1.3 元。
它能用但要挑场景:适合人盯着屏幕等答案,不适合挂着跑几小时的 Agent 长任务,那种场景多付一倍的钱买自己不看的时间。1M 上下文是上限不是目标,拆成几个上下文干净的小任务更省。
单价便宜 80%,为什么你没感觉到
最反直觉的地方。按官方定价,外界普遍说它整体价格约为 GPT-6 Astra 的五分之一,便宜约 80%。但 Artificial Analysis 测算的单任务成本相反:单价是对手五分之一,单任务花的钱只便宜约 35%。
差额全在「完成任务用掉多少 token」上。再往下一层,同样任务换模型价差能到 18 倍:同一道 Rust App 任务 K3.1 Pro 花了 221.21 元,DeepSeek V4.1 Flash 是 12.32 元。
省额度之前,先把版本选对
选错版本比调参更浪费。站内 Kimi K3.1 Pro 高速版和标准版区别 把价格翻倍和速度提升放在一张表里算了账,判断标准只有一条:等待时间是你自己盯着,还是挂着跑别的活。要自己写脚本统计缓存命中率和推理 token 占比,改哪个字段看站内 Kimi K3.1 Pro API Key 配置。
订阅额度撞墙和 API 限流报的是两种 429,站内 Claude Max 429 额度用完怎么解决 里「看提示有没有给重置时间」的判定法换个产品通用。
常见问题
Kimi K3.1 Pro 为什么比别的模型费 token
三层叠加:推理强度默认 max 且关不掉、后训练让它倾向派活给子 Agent、1M 长上下文在多轮里复利。第三方统计输出 token 约为参测模型中位数的 1.72 倍。详细拆解见正文第二节。
Kimi K3.1 Pro 的额度消耗太快怎么办
显式传 `reasoning_effort: "low"` 或 `"high"`,别用默认的 max;把 system prompt 和参考资料固定放最前面让缓存命中,命中价只有未命中的十分之一;把大任务拆成几个上下文干净的小任务。订阅用户去找「是否使用子 Agent」选项。
Kimi K3.1 Pro 的思考模式能关吗
不能。官方常见问题明确写了目前关不了,模型始终开启思考模式。唯一可行的省钱方式是把 `reasoning_effort` 从 `max` 调到 `low`,思考 token 会少一些但不会归零。
Kimi K3.1 Pro 和高速版哪个更费额度
按 API 计费高速版贵一倍:输入未命中 26 元对 13 元,输出 136 元对 68 元。但缓存命中价两边都是 1.3 元,只要命中率高,溢价远没有账面那么大。它适合人盯着等答案,不适合挂几小时的长任务。
Kimi K3.1 Pro 的 API 和会员额度是同一套吗
不是。API 是按量计费的余额,会员走订阅月度额度池,两套账互不相通。同一条 Key 在 Kimi Code、Codex、Claude Code 里共用账户限速,但不会消耗会员额度;反过来会员额度见底也不会影响 API 调用。
Kimi K3.1 Pro 的额度补偿是每月都有吗
不是。10 月 26 日的补偿是一次性重置,所有有效期内的订阅会员获得月度总额 25% 的额度,相当于一周用量,已用不足 25% 的重置为 0。
 京ICP备2024094994号-29