
GPT-Live-1 429 报错怎么办?两类根因一次排查完
GPT-Live-1 的 429 报错不是只有一种原因。它靠响应体里的错误码区分限流(请求太快)和额度耗尽(余额或支出上限用完),用错解法会一直重试浪费时间。本文给你一套 3 步排查法,先定位是哪一类,再对症处理。
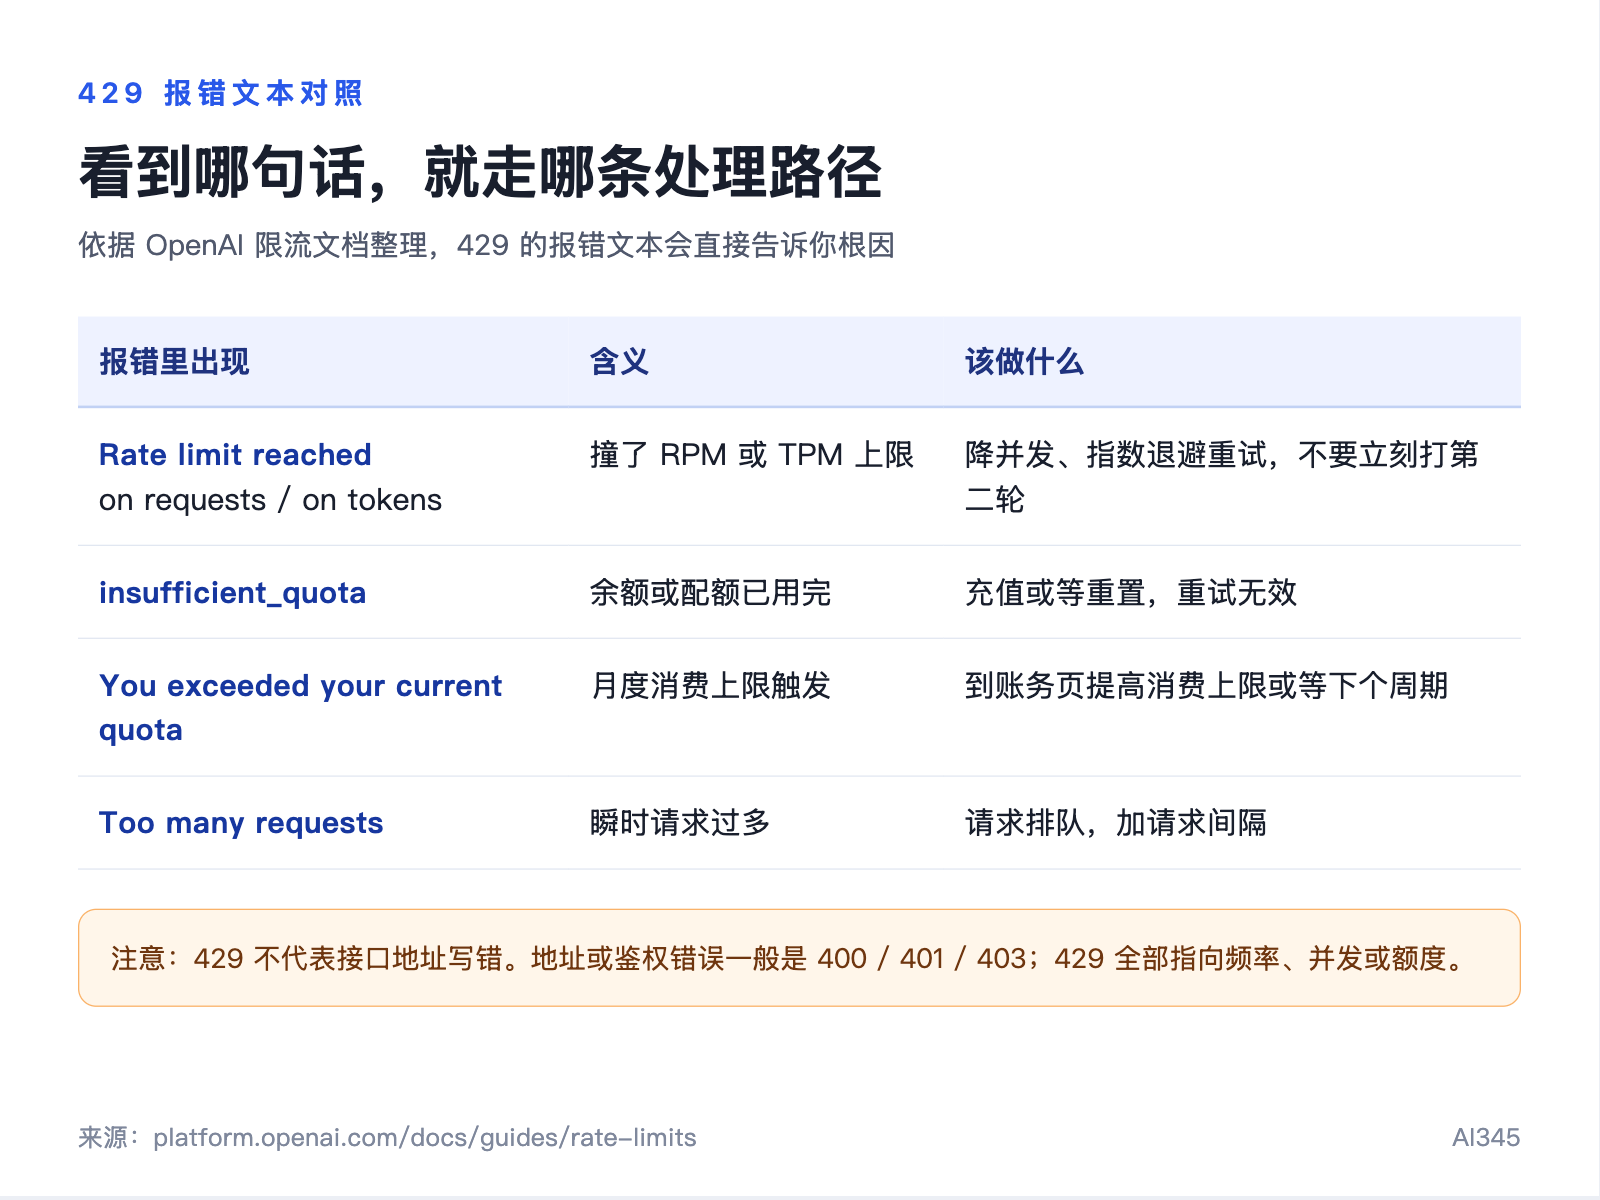
GPT-Live-1 429 报错先看错误文案,对号入座
GPT-Live-1 是 OpenAI 2026 年 7 月 8 日发布的原生全双工语音模型,9 月正式接入 API 供开发者调用并公布定价,国内开发者随之开始用它做实时语音 Agent。正因为刚上线,撞上限流和配额的概率比老模型高得多。
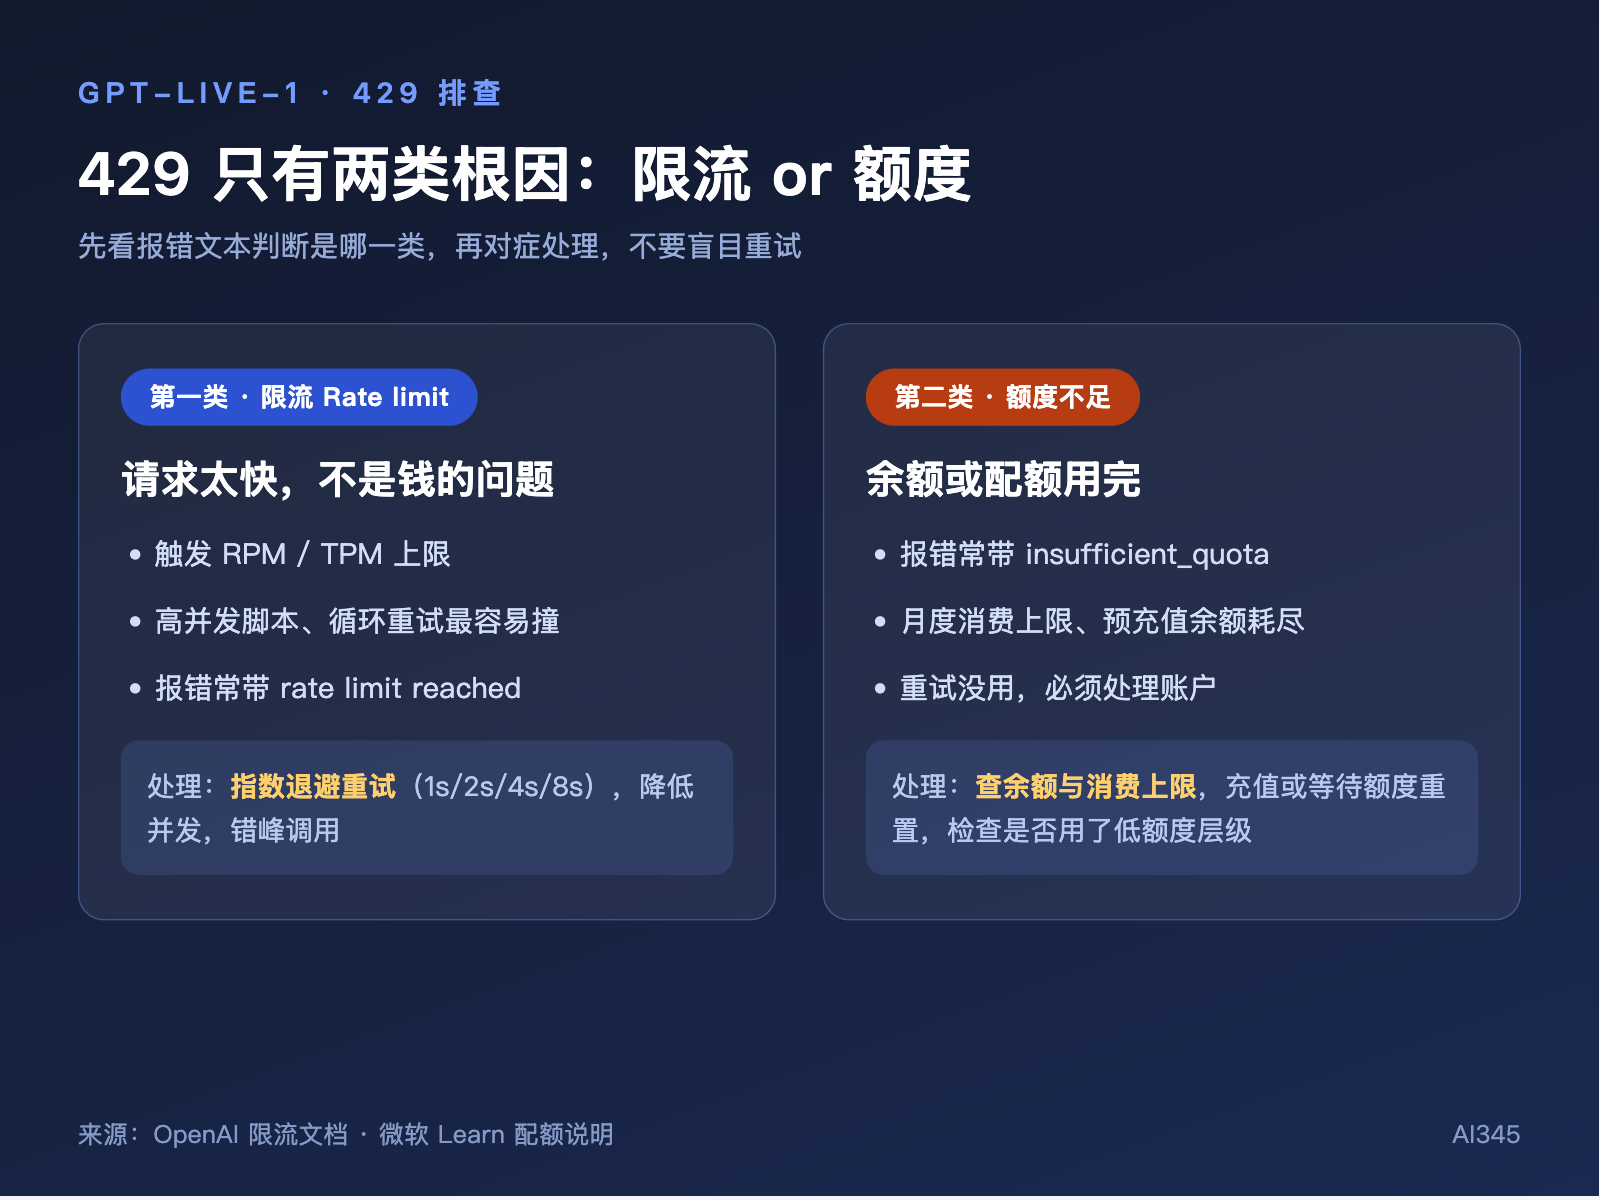
收到 429 时,先别急着改代码,把响应体里的 type 和 message 看一遍,判断属于哪一种:
type: requests且提示rate limit:命中 RPM/TPM 上限,这是真正的限流。type: insufficient_quota、提示You exceeded your current quota, please check your plan and billing details:这是账户余额或配额用完了,跟请求速度无关。organization_usage_limit_exceeded、organization_spend_limit_exceeded、project_spend_limit_exceeded、credit_balance_exhausted:也都是额度类报错,不是限流。
最坑的就是把额度类报错当限流反复重试,既解决不了,还白白烧掉调用次数。先上图,记住判断路径。
根因一:限流,RPM/TPM 撞线怎么解决
OpenAI 的限流按两个维度卡:RPM(每分钟请求数)和 TPM(每分钟消耗 token 数),任何一项超了都返 429。GPT-Live-1 属于实时音频,单次会话吞吐 token 大,更容易被 TPM 拖累。分三步下手:
- 读
Retry-After响应头,服务端返回的等待秒数最可靠,按它等再重试。 - 没有 Retry-After 时用指数退避加抖动,按 1 秒、2 秒、4 秒翻倍,加随机抖动避免重试风暴扎堆,最多 3 到 5 次。
- 代码层降速:把并发收敛,单路请求之间留间隔;同一前缀的固定上下文走缓存命中,能显著降 TPM 消耗。
如果限流是常态而不是偶发,各 tier 的 RPM/TPM 基准可查 OpenAI 官方的 限流配额文档,Azure 侧的配额分层逻辑可以参考 微软 Learn 的 OpenAI 配额说明,低档位本身就低,升级或提交配额申请才是更长远的解。
根因二:额度耗尽怎么解决
额度耗尽跟重试无关,处理靠「输血」而不是「减速」:
- 打开 OpenAI 控制台的
Billing检查余额是否清零,Usage看本周期用量,Organization/Project看有没有设置支出上限(spend limit)。 - 余额没了就充值,绑定支付方式,可设置自动充值下限。
- 被企业级支出上限或项目预算卡住,由组织管理员调高额度,或走配额申请表。
- 若在 Azure AI Foundry 上调用实时语音类模型,2026 年 5 月 7 日起配额改为订阅级共享池,多个区域共用一个额度池,撞限后查看配额 tier,系统会自动上调。
预防:让 GPT-Live-1 的调用不频繁撞 429
把护栏做在前头,比每次报错去修更省心:
- 给 SDK 统一封装重试器:对所有模型调用统一走指数退避加次数上限,别让每个函数各自重试。
- 跑前先做 token 估算:实时语音会话长,先估算单次消耗,避免单次输入接近 TPM 上限。
- 分类型监控告警:对 429 分别统计限流对配额,配额类告警要第一时间触达负责人,而不是让重试器傻等。
(占位:OpenAI 平台限额与余额管理页截图)
GPT-Live-1 相关背景速览
如果你刚接触这个模型,别把 429 和它的定位搞混。GPT-Live-1 能同时听和说,C 端默认面向 Go、Plus、Pro 付费用户,API 端 2026 年 9 月对外开放并公布定价。它的免费档位、收费标准、与其他实时语音模型的差异可参考站内这几篇:
常见问题
GPT-Live-1 429 报错是限流还是欠费?怎么区分?
答:看响应里的 `type` 字段。`type: requests` 且提示 rate limit 是限流;`type: insufficient_quota` 或提示 `You exceeded your quota` 是额度耗尽。两者处理逻辑完全不同。
OpenAI 的 429 限流多久自动恢复?
答:限流按 RPM/TPM 按分钟窗口限制,超过一分钟窗口后通常自动放行,配合指数退避与 `Retry-After` 头等待即可。额度耗尽的 429 不会自动恢复,必须充值或提额。
重试 GPT-Live-1 429 时设多少间隔最合适?
答:优先取响应头 `Retry-After`。没有时用指数退避(1s、2s、4s、6s)并加随机抖动,最多重试 3 到 5 次,别扎堆。
额度不够怎么办?要升级配额吗?
答:先看 `Billing/Usage` 是不是到了月度支出上限或余额清零。若只是超大 token 一次撞 TPM,先收敛上下文复用缓存;业务量上升再走配额申请。
 京ICP备2024094994号-29