
GLM-5.3-Prime 是什么?1M 上下文超快变体详解
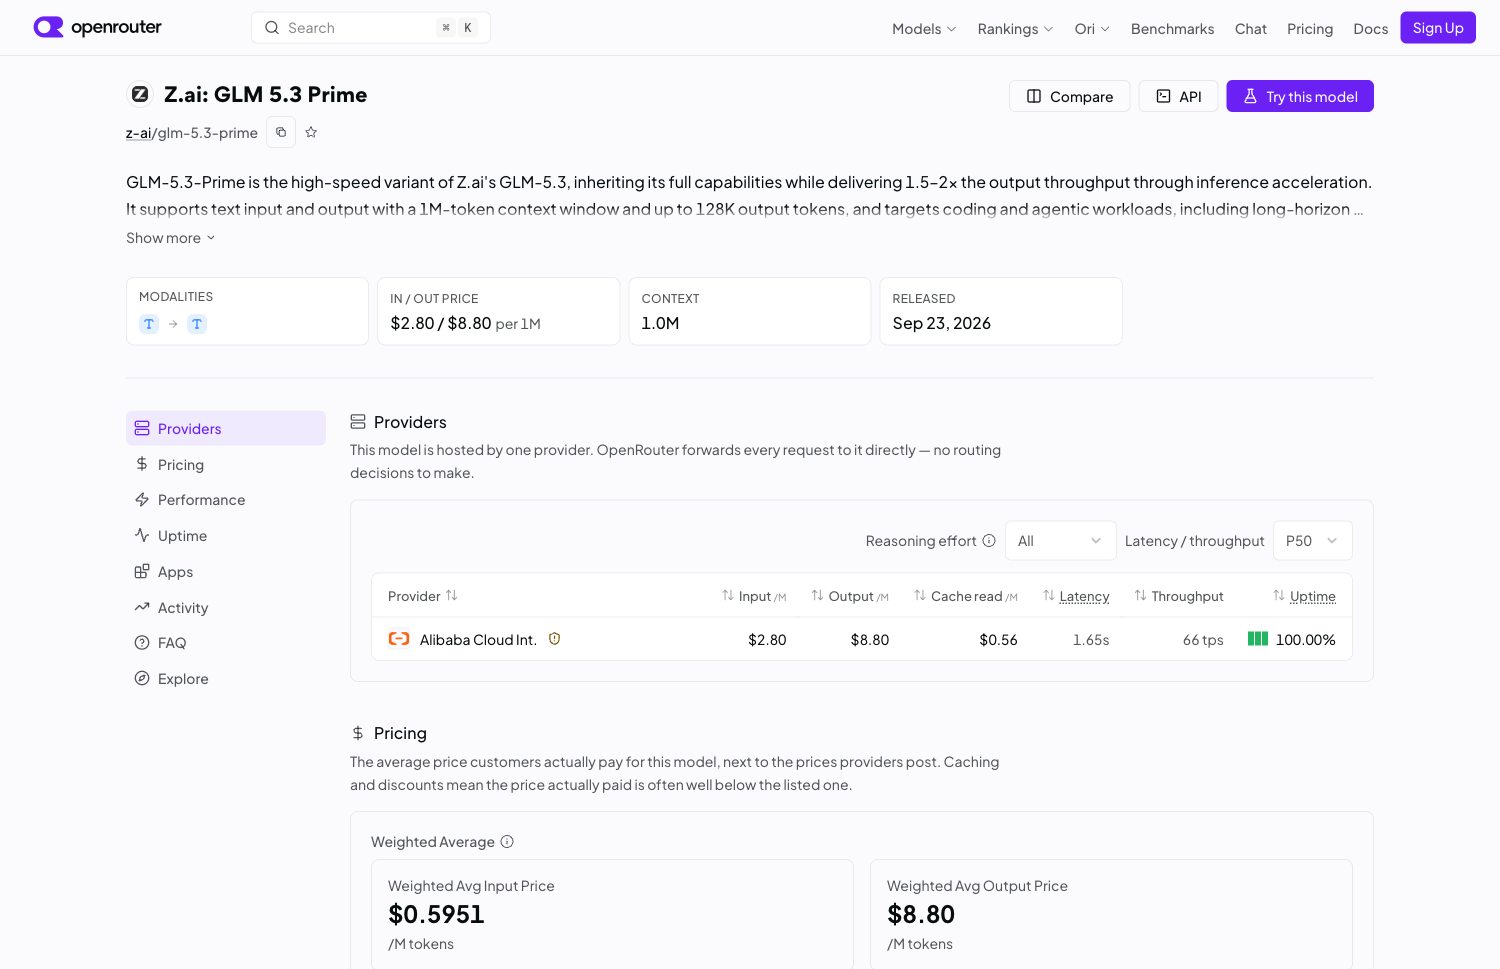
GLM-5.3-Prime 是智谱 GLM-5.3 家族的高速变体,2026-09-23 在 OpenRouter 上线,主打 1M 上下文、128K 输出、推理常开与 1.5-2 倍吞吐。 它的定位和 FlashX、Flash 不同:Flash 系列追求轻量低价,而 Prime 是把吞吐和高档推理打满,适合 coding 与需要长程推理的 Agent 任务。本文先聚焦 Prime 这个 SKU 本身,再给你一段和 FlashX、Flash 的定位差异,方便选型。
GLM-5.3-Prime 是什么
GLM-5.3-Prime 是智谱(Z.ai)GLM-5.3 路线上的高速变体,以 z-ai/glm-5.3-prime 标识对外提供服务。这里的 Prime 可以理解成「品质档」,在保持 5.3 能力的前提下,把吞吐和推理深度往上提。
- 1M 上下文:长对话、长文档、整库分析都放得下。
- 128K 输出:一次生成很长的代码或文章,输出窗口大。
- 推理常开:reasoning 默认开关,分 low/high/max 档,默认最高档 max。
- 1.5-2 倍吞吐:比标准版更快的 token 产出,适合对延迟敏感的任务。
- OpenRouter 上架:通过
z-ai/glm-5.3-prime调用,复用 Chat Completions 接口。
它解决什么问题:你需要一个「能力够强、能处理超长上下文、推理质量高」的模型来跑长程 Agent 或代码任务,又不想自己处理网络与部署,OpenRouter 这一条正好到位。
事实核对:截至 2026-09-26,
z-ai/glm-5.3-prime在 OpenRouter 的 API 文档可查,endpoint 为https://openrouter.ai/api/v1/chat/completions,model 填z-ai/glm-5.3-prime,支持 reasoning / reasoning_effort / max_tokens / tools 等参数。
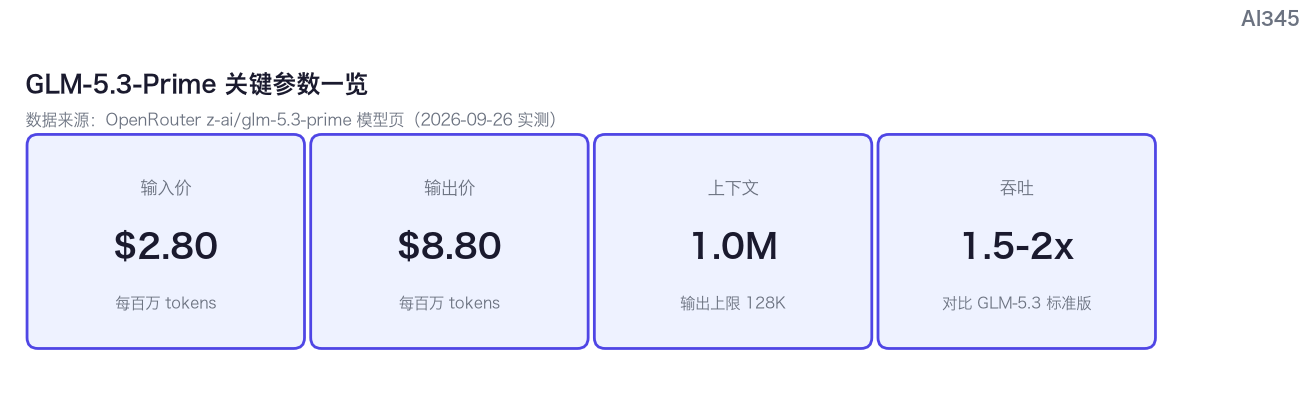
核心参数与价格(一张表看明白)
| 维度 | GLM-5.3-Prime | 说明 |
|---|---|---|
| 上下文 | 1M tokens | 长文档 / 长 Agent 会话不愁 |
| 最大输出 | 128K tokens | 一次生成长代码、长文 |
| 输入价格 | $2.80 / M tokens | 按 token 计费 |
| 输出价格 | $8.80 / M tokens | 输出更贵 |
| 推理档位 | low / high / max,默认 max | 用 reasoning 控制 |
| 吞吐 | 1.5-2 倍 | 相对 5.3 标准档 |
| 接入模型 ID | z-ai/glm-5.3-prime | OpenRouter |
价格与参数来自 OpenRouter 模型页,以你调用时刻页面显示为准;价格会随版本调整,正文不重复猜测以免误导。
和 FlashX、Flash 的区别才是关键
很多人会把 Prime 和 Flash、FlashX 混淆,这里用一个段落讲清定位差异(完整拆解可看站内《GLM-5.3-FlashX 是什么》)。
- Flash(轻量、快、便宜):面向即时轻量对话,推理档位更轻,单位成本更低,适合高频低难任务,详见《GLM-5.3-Flash 指南》。
- FlashX(1M 上下文,主流通用):上下文窗口和 Prime 一样做到 1M,但仍偏通用对话,速度介于 Flash 与 Prime 之间。
- Prime(主攻 coding / 长程 Agent):把高吞吐和最高档推理一起打满,是三者里单价更高的一档,适合要速度要质量的关键任务。
一句话结论:轻对话用 Flash,通用长任务用 FlashX,重推理与 coding 才切 Prime。三者按任务强度分档,能在不牺牲质量的前提下省钱。
想看 5.3 这一代整体表现,或和 GLM-6 的差异,可看站内《GLM-5.3 评测》与《GLM-6 与 GLM-5.3 的差异》,别把「GLM-5.3-Prime」和另一个独立版本更名混淆。
上手:3 步在 OpenRouter 调起 Prime
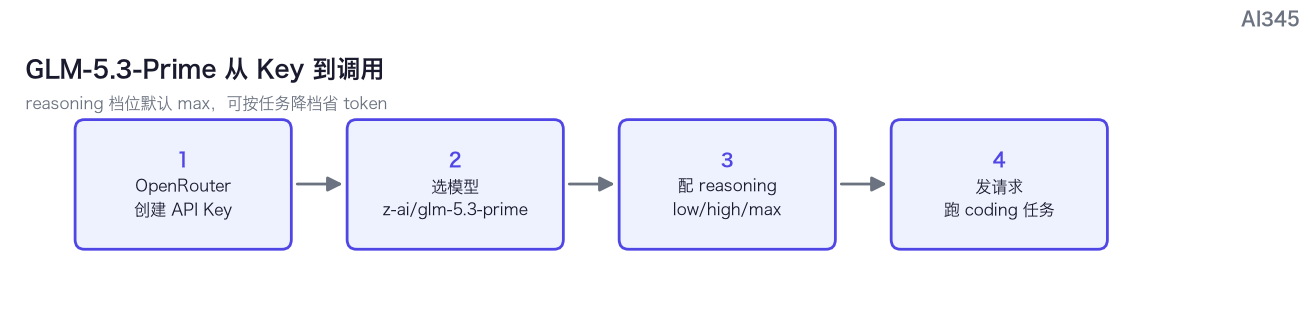
- 注册 OpenRouter 并创建 API Key:到 openrouter.ai,设置里建 key。
- 用 curl 调一次(默认够用,不用改参数):
curl -X POST https://openrouter.ai/api/v1/chat/completions   -H "Authorization: Bearer $OPENROUTER_API_KEY"   -H "Content-Type: application/json"   -d '{
  "model": "z-ai/glm-5.3-prime",
  "messages": [{"role": "user", "content": "把这段代码重构并加注释:def f(x): return x*2"}]
}'
- 切推理档:想省成本把
reasoning设成 low;要最高质量设 max。响应里usage会返回 token 与 cost,多轮实验前先看计费。
适合谁用、不适合谁用
- 适合:跑 Agent 的工具调用与长程多轮任务;需要处理 1M 长代码的工程师;把 coding 质量放第一位的开发者。
- 不适合:只发几句日常聊天、追求最低成本的场景,这类用 FlashX/Flash 更划算,没必要为高档推理多付费。
常见问题
GLM-5.3-Prime 和 GLM-5.3-FlashX 有什么区别?
答:两者都是 5.3 家族,FlashX 偏轻量化更便宜,Prime 是高吞吐 + 最高档推理更贵、更快,主打 coding 与长程 Agent。轻对话选 FlashX,重推理与 coding 选 Prime。
GLM-5.3-Prime 免费吗?价格多少?
答:Prime 不是免费模型,输入 $2.80/M tokens、输出 $8.80/M tokens(OpenRouter)。价格会随调用时刻变化,以控制台为准;它比 Flash 系列贵,但速度与推理质量更高。
GLM-5.3-Prime 支持多少上下文和输出?
答:上下文 1M tokens,最大输出 128K tokens,适合长文档直接喂入、一次生成超长代码或报告。
GLM-5.3-Prime 推理档怎么切?
答:通过请求里传 `reasoning`(或 reasoning_effort)参数,取值 low/high/max,默认 max。简单任务用 low 更省钱,复杂任务用 max 更稳。
GLM-5.3-Prime 在 OpenRouter 报 429 怎么办?
答:429 是限流,多数情况下退避重试即可;超过并发联会触发,建议拆小批量、控并发后重试。
 京ICP备2024094994号-29