
GLM-5.3-FlashX 是什么?比 Flash 快多少
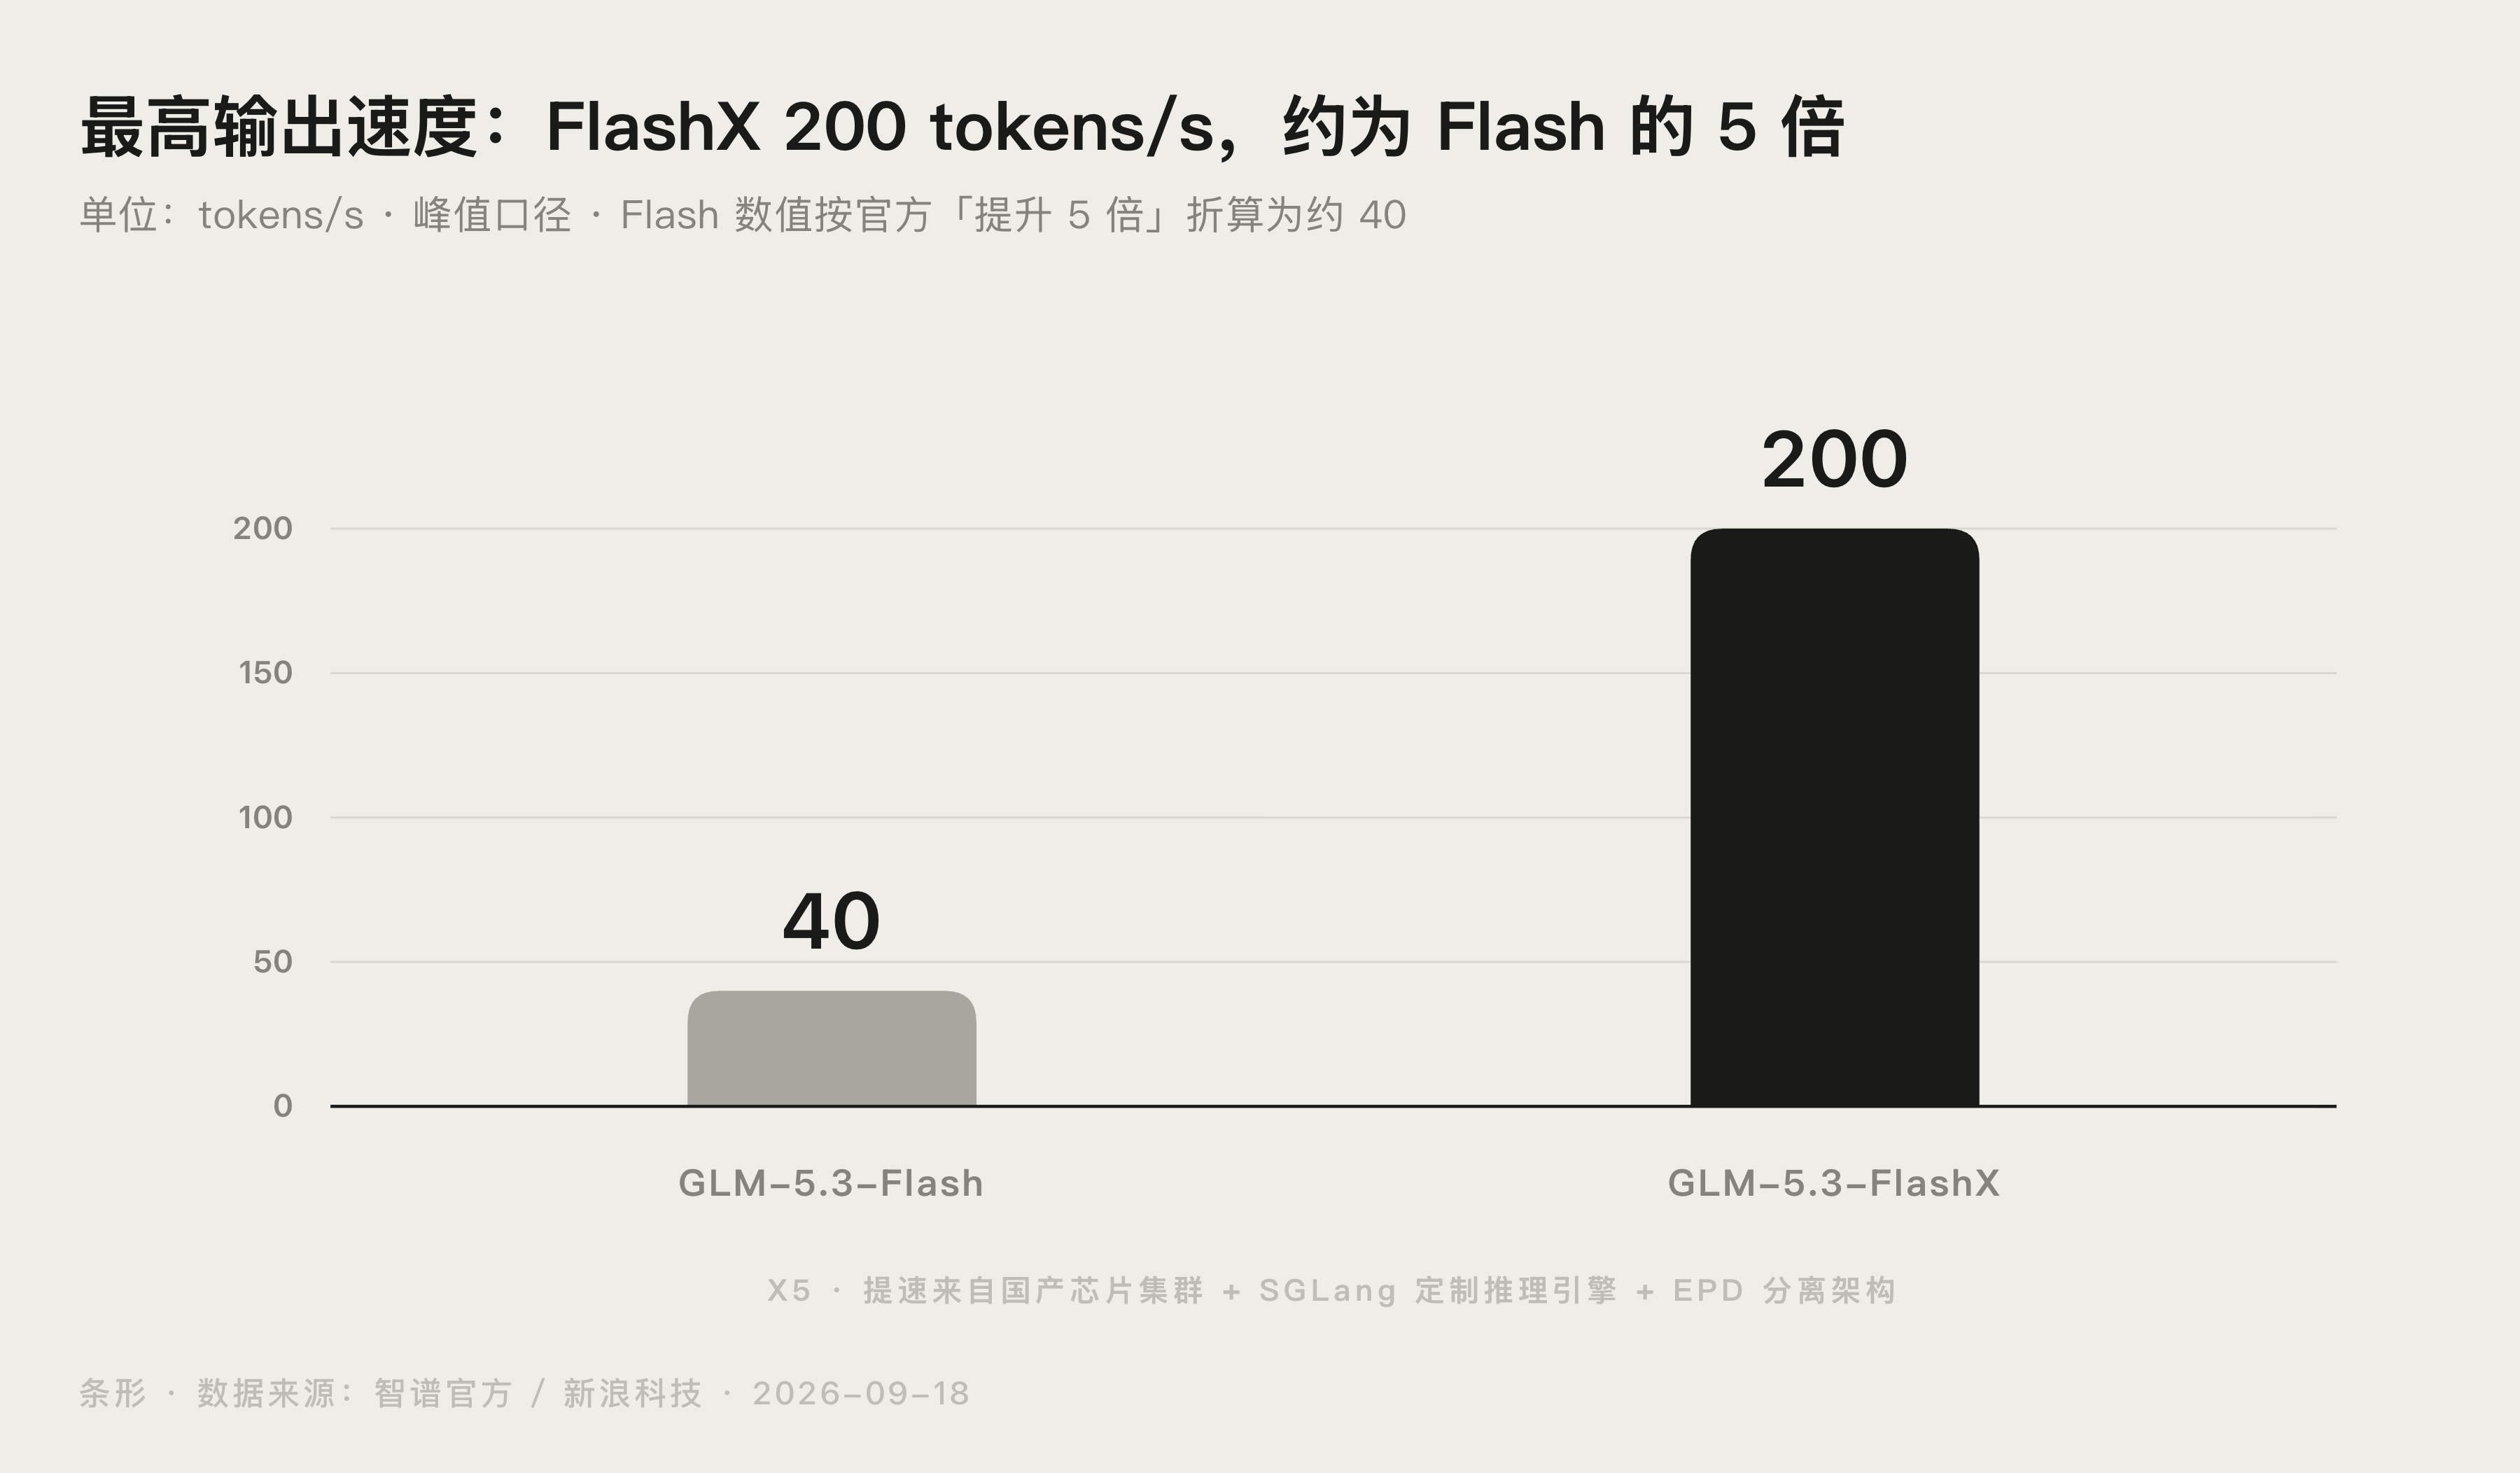
GLM-5.3-FlashX 是智谱 2026 年 9 月 18 日上线的高速版模型:底座和 GLM-5.3-Flash 完全一样,官方把推理速度拉到最高 200 tokens/s,约为 Flash 的 5 倍,同时把定价提到 Flash 的 2.5 倍。一句话,它不是新模型,而是给 Flash 换了台更快的发动机,然后按速度重新标了一次价。
下面按「是什么、和 Flash 的区别、价格、提速原理、怎么接入、免费情况」依次讲清。数据核查于发布当天,来源为智谱官方文档与定价页、新浪科技与 IT 之家报道。
最后更新:2026 年 9 月 18 日
GLM-5.3-FlashX 是什么?
GLM-5.3-FlashX 是智谱面向高并发场景推出的高速版模型,2026 年 9 月 18 日与 API 同步上线,Model Key 为 glm-5.3-flashx。它的底座与 8 月发布并开源的 GLM-5.3-Flash 完全一致。
| 项目 | 规格 |
|---|---|
| 参数规模 | 总参数 320B,激活参数 18B(MoE) |
| 上下文窗口 | 1M tokens |
| 最大输出 | 128K tokens |
| 输入模态 | 图片、视频、文件、文本 |
| 智能水平 | Artificial Analysis 智能指数 57 分 |
也就是说,FlashX 没有重新训练、没有加参数。官方在文档里的原话是「更快、更流畅的 GLM-5.3-Flash」,它和 Flash 的关系更像同一款车的性能模式。
一个容易被忽略的细节:GLM-5.3-Flash 就是此前在 OpenRouter 匿名爆火的 Ox Alpha,所以 FlashX 也可以理解为「牛来的提速版」。
GLM-5.3-FlashX 和 GLM-5.3-Flash 有什么区别?
把两款模型并排放,差异只有两项:速度和价格。
| 对比项 | GLM-5.3-Flash | GLM-5.3-FlashX |
|---|---|---|
| 最高输出速度 | 基准 | 200 tokens/s,约 5 倍 |
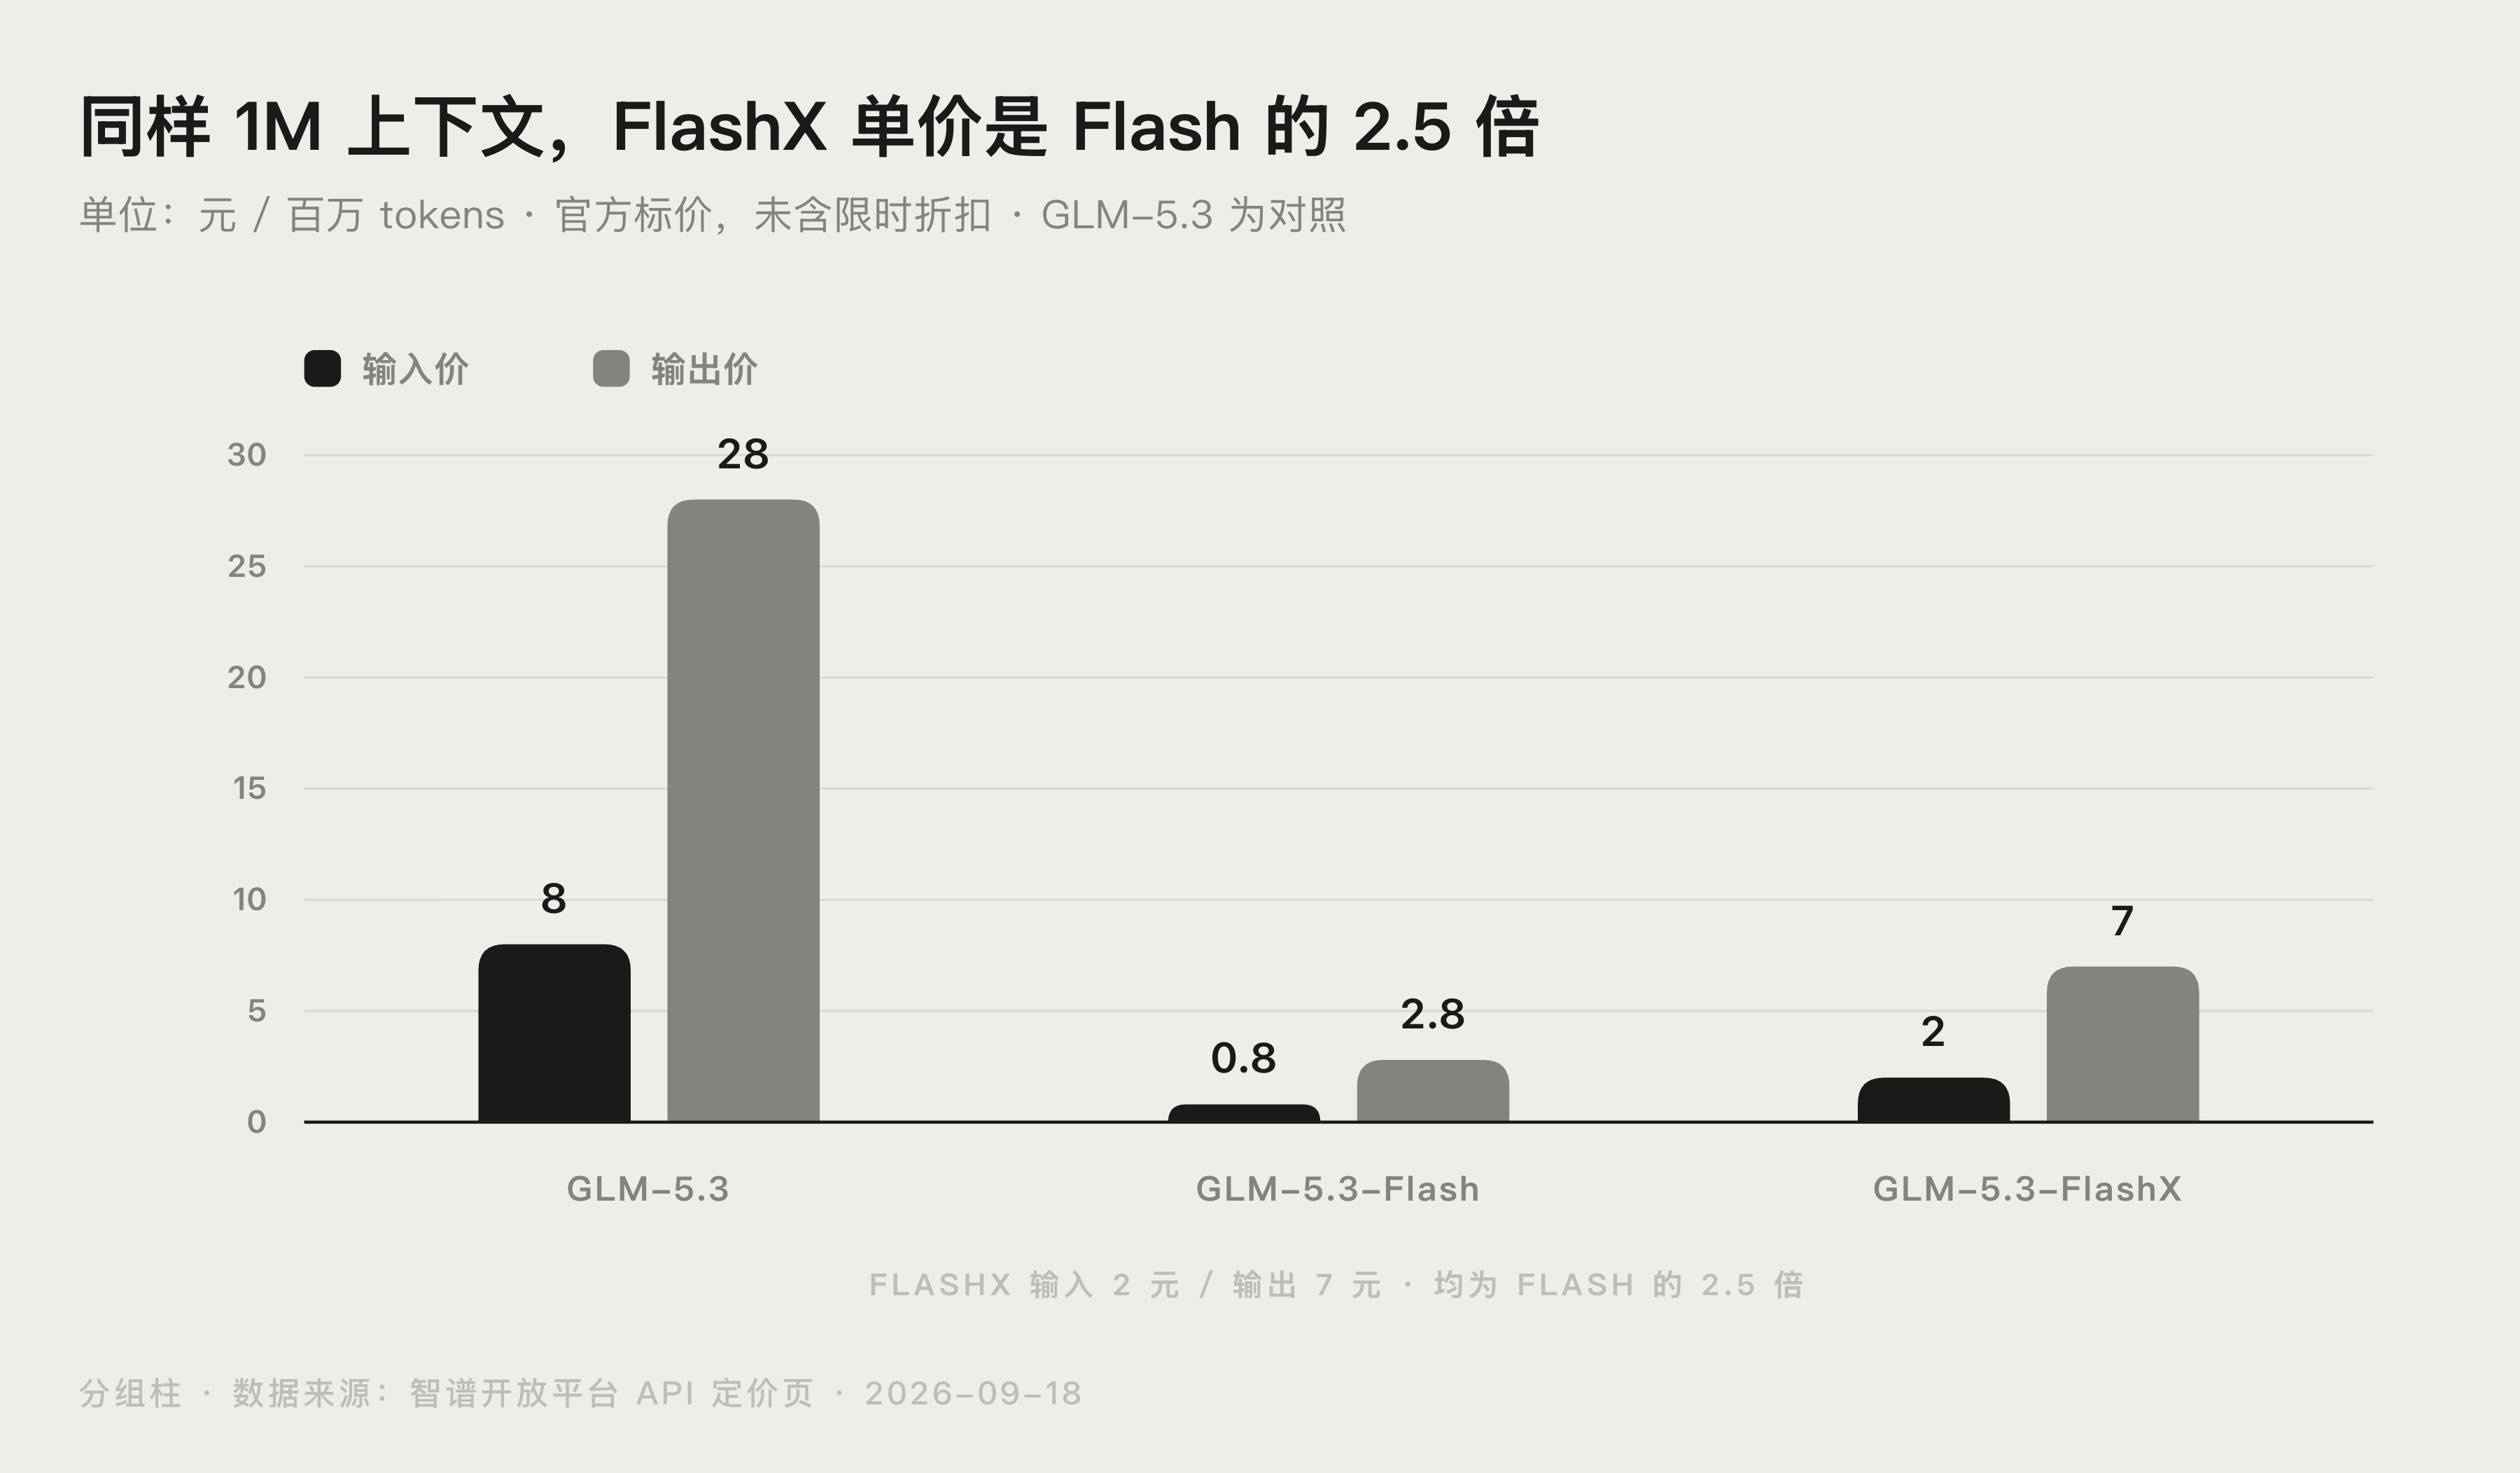
| 输入价格 | 0.8 元 | 2 元 |
| 输出价格 | 2.8 元 | 7 元 |
| 缓存命中 | 0.23 元 | 0.57 元 |
| 上下文 / 最大输出 | 1M / 128K | 1M / 128K |
| 智能水平 | AA 指数 57 | 同底座,57 |
(价格单位为元/百万 tokens)。结论很直白:智力一样、能力一样、上下文一样,只有速度和价格变了。智谱官方对这次更新的概括是「扩算力、提速度、提定价」,即用更高的价格承接更旺的调用需求,同时给对延迟敏感的用户一个更快的选项。
GLM-5.3-FlashX 价格:2.5 倍贵在哪
按官方定价页的数字,FlashX 的输入、输出、缓存命中价都正好是 Flash 的 2.5 倍(0.8 到 2 元、2.8 到 7 元、0.23 到 0.57 元)。
换算成日常场景更直观:
- 单次请求输入 1 万 tokens、输出 2000 tokens:Flash 约 0.0136 元,FlashX 约 0.034 元,单次多花约 2 分钱;
- 每天 1 万次调用:Flash 约 136 元,FlashX 约 340 元,一天多花约 204 元。
以上为按官方单价做的量级估算,实际以平台扣费为准。值不值取决于你要不要那 5 倍速度:Agent 一次任务常常几十轮调用,每轮省两三秒,累积起来就是体感差距。想继续压成本,可以配合我们整理的 省 token 技巧。
200 tokens/s 是怎么做到的
提速不是靠超频,而是把推理侧的工程做透。综合官方文档与新浪科技报道:
- 10 万张国产芯片集群:推理由国产加速卡承担,通过自研高带宽网络互联。此前集群上线即被打满,这次扩大算力才支撑起 FlashX 的吞吐;
- 专用推理引擎:在 SGLang 基础上定制,加入张量并行、W8A8 量化、混合缓存量化、Layer Split 等优化;
- EPD 分离架构:把多模态编码、预填充和逐 token 解码拆成可独立扩缩容的算力池,端到端性能相比基线提升约 3 倍。
再加上底座的高效架构(稀疏注意力加线性注意力混合,注意力计算量比 GLM-5.3 降低 3.01 倍、KV 缓存降低 4.44 倍),长上下文下的成本才压得住。
GLM-5.3-FlashX 怎么接入
接口与 GLM-5.3-Flash 完全兼容,切换成本就是把模型名换掉。完整参数说明见智谱官方对话补全文档。
第一步,拿 API Key。 登录智谱开放平台(bigmodel.cn)在控制台创建,base_url 为 https://open.bigmodel.cn/api/paas/v4/。
第二步,改 Model Key。 把请求里的 model 从 glm-5.3-flash 换成 glm-5.3-flashx:
from openai import OpenAI

client = OpenAI(
    api_key="你的Key",
    base_url="https://open.bigmodel.cn/api/paas/v4/",
)

resp = client.chat.completions.create(
    model="glm-5.3-flashx",   # 从 glm-5.3-flash 换成这一行
    messages=[{"role": "user", "content": "用 Python 写一个快速排序并解释复杂度"}],
    temperature=1.0,
    stream=True,              # 高吞吐下建议开流式,体感提升最明显
)
for chunk in resp:
    print(chunk.choices[0].delta.content or "", end="")
第三步,先试用再上量。 不想写代码的可在官方体验中心选 glm-5.3-flashx 对话。官方推荐参数是 temperature: 1、top_p: 0.95、reasoning_effort: max,思考模式只支持开启,流式建议同时开 stream 和 tool_stream。
GLM-5.3-FlashX 免费吗?Coding Plan 能用吗
这两条要分清楚:
- 按量 API 不免费,按上面的单价计费,缓存存储目前限时免费;
- GLM Coding Plan 套餐暂不包含 FlashX,官方文档明确写着「套餐当前暂未开放 GLM-5.3-FlashX」,套餐里能用的是 GLM-5.3-Flash,额度相较 GLM-5.3 增加到 3 倍。
想走套餐白嫖,目前只能用到 Flash。另外 9 月 3 日至 20 日有夜间畅用活动:每晚 23:00 至次日 9:00,在官方编程工具 ZCode 里调用套餐内的 GLM-5.3-Flash,额度消耗为 0。注意该活动针对 Flash,FlashX 是否参与官方未说明。
GLM-5.3-FlashX 适合谁用
- 适合:高并发 AI 编程、Agent 多步调用、实时对话与代码补全、长上下文多模态任务,以及任何等待时间直接影响体验的场景;
- 不适合:对价格极度敏感、对时延不敏感的离线批量任务,这类场景用 Flash 更划算,输出价只要 2.8 元/百万 tokens。
想系统了解底座能力,可以看我们的 GLM-5.3-Flash 全解;想横向对比旗舰模型,可以看 GLM-5.3 评测;如果你分不清模型名后缀的含义,模型版本号怎么读讲得更清楚。
总结
GLM-5.3-FlashX 是一次「同底座提速提价」的版本更新:智能、参数、上下文都没动,换来最高 200 tokens/s 的输出速度和 2.5 倍的单价。它解决的是调用量爆发下的吞吐压力,用国产芯片集群加推理工程把速度顶上去。要不要用,按场景对号入座即可:延迟敏感就上 FlashX,成本敏感就留在 Flash。
资料来源:
- 智谱 GLM-5.3-Flash/FlashX 官方文档
- 智谱开放平台 API 定价页
- 智谱 GLM Coding Plan 夜间畅用活动说明
- IT 之家:智谱 GLM-5.3-FlashX 模型上线
作者:AI345
最后更新于 2026 年 9 月 18 日
常见问题
GLM-5.3-FlashX 和 GLM-5.3-Flash 有什么区别?
答:只有速度和价格不同。底座、参数(320B 总参 / 18B 激活)、1M 上下文、多模态能力和智能水平完全一致;FlashX 最高 200 tokens/s、约为 Flash 的 5 倍,价格是 Flash 的 2.5 倍。
GLM-5.3-FlashX 免费吗?
答:按量 API 不免费,输入 2 元 / 输出 7 元每百万 tokens,缓存存储限时免费。GLM Coding Plan 套餐当前暂未开放 FlashX,套餐白嫖目前只能用 GLM-5.3-Flash。
GLM-5.3-FlashX 怎么用?接入要改多少代码?
答:几乎不用改。接口与 Flash 完全兼容,把请求里的 model 从 glm-5.3-flash 换成 glm-5.3-flashx 即可,OpenAI SDK 格式不变;不写代码也可以在官方体验中心直接试用。
GLM-5.3-FlashX 是开源的吗?
答:不是。FlashX 是推理侧提速的在线版本,官方未放出独立权重;开源的是它的底座 GLM-5.3-Flash,权重按 MIT 协议在 Hugging Face 开放。
什么情况下值得从 Flash 换成 FlashX?
答:当输出延迟直接影响体验时值得,比如实时对话、代码补全、Agent 多轮工具调用。反过来,离线批量处理、时延不敏感的任务继续用 Flash 更省钱。
 京ICP备2024094994号-29