
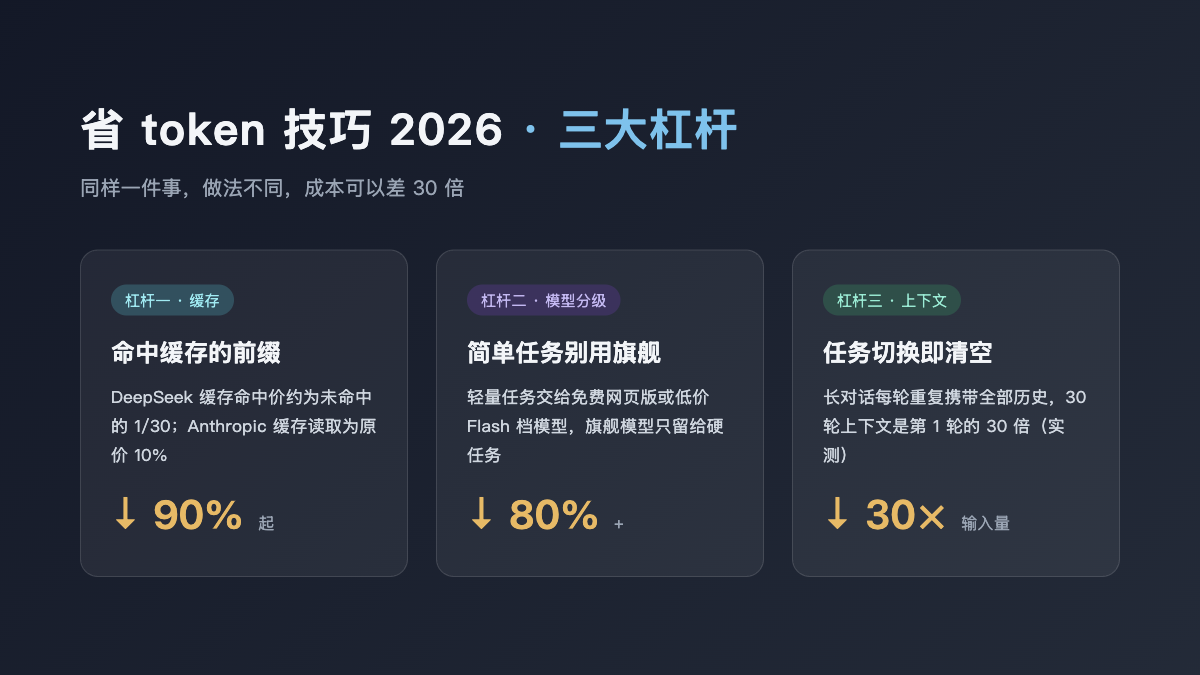
省 token 技巧 2026:实测有效的 10 招,最高省下 90% 费用
先说结论:省 token 靠的不是"把话写短"。最有效的是三件事:给任务配对模型、把重复内容交给缓存、控制上下文长度。这三件做好,日常使用可以省 50% 以上,API 调用最高能省 90%——本文所有数据都来自官方定价页和我们的真实实测,不是拍脑袋的估值。
很多人以为省 token 就是把提示词写短。我们实测后发现这恰恰是个误区:当消息里附带长代码或文档时,客套话只占总量的 1% 左右,删掉它几乎不省钱;真正吞 token 的是每轮都重复发送的长对话历史。下面按"先抓大头"的顺序,给你 10 个 2026 年实测有效的省 token 技巧。
本文目录:①模型分级 ②开启缓存 ③及时清空上下文 ④长任务压缩 ⑤一次说清需求 ⑥管住输出 ⑦用文件代替重复粘贴 ⑧批量与错峰 ⑨工具按需挂载 ⑩用量监控 | 附:三类人群配方、常见坑、FAQ
先搞懂:token 是怎么算钱的
token 是大模型计量文本的最小单位。费用 = 输入 token × 输入单价 + 输出 token × 输出单价,输出单价通常是输入的 3~5 倍。以 2026 年 8 月的官方价格为例:
| 模型(官方价) | 输入(元/百万 tokens) | 输出(元/百万 tokens) |
|---|---|---|
| DeepSeek V4-Flash(高峰) | 3.0 | 9.0 |
| DeepSeek V4-Pro(高峰) | 9.0 | 27.0 |
| Claude Opus 4.7 / Opus 5 | 约 36 元($5) | 约 180 元($25) |
| Claude Sonnet 档 | 约 21 元($3) | 约 108 元($15) |
数据来源:DeepSeek 官方定价页、Anthropic 官方 Prompt Caching 文档。可以看出:选错一档模型,同样的活儿成本能差 5 倍起。这就是第 1 招排在最前面的原因。
省 token 的 10 个技巧(2026 实测版)
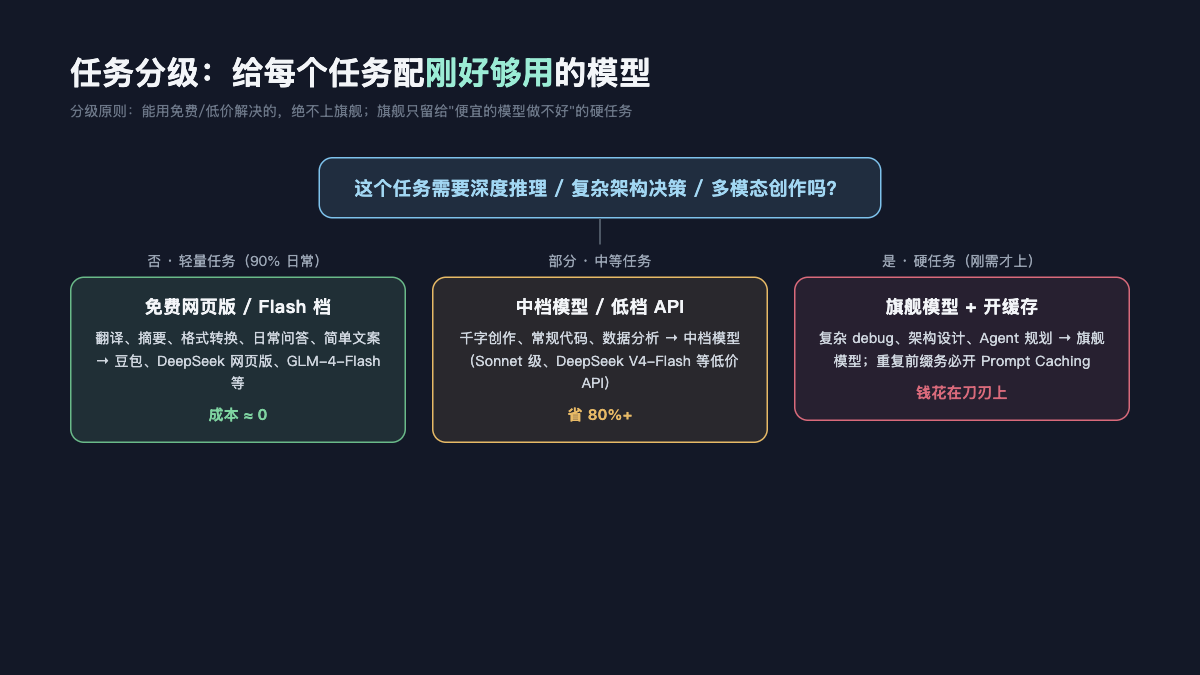
1. 模型分级:90% 的任务不需要旗舰模型
翻译、摘要、格式转换、日常问答这类轻量任务,用免费网页版或低价 Flash 档模型完全够用;只有复杂推理、架构决策才值得上旗舰模型。把任务按"轻 / 中 / 重"分三档,给每档配刚好够用的模型,是省 token 最大的单一杠杆。
不知道有哪些免费或低价的模型可选?可以在 AI345 的 AI 工具导航里按"免费 / 低价"筛选一遍,把主力、备用的模型先定下来。
2. 开启 Prompt Caching:重复前缀最高省 90%
如果你用 API,固定不变的 system prompt、长文档、工具定义都可以声明为缓存前缀。官方规则很明确:
- Anthropic:缓存命中的读取价格是原价的 10%(Opus 档 $5 → $0.50/百万 tokens),写入收 1.25 倍(5 分钟 TTL)或 2 倍(1 小时 TTL)。
- DeepSeek:自动开启上下文缓存,命中输入价约是未命中的 1/30(如 V4-Flash 高峰时段命中 0.10 元 vs 未命中 3.0 元)。
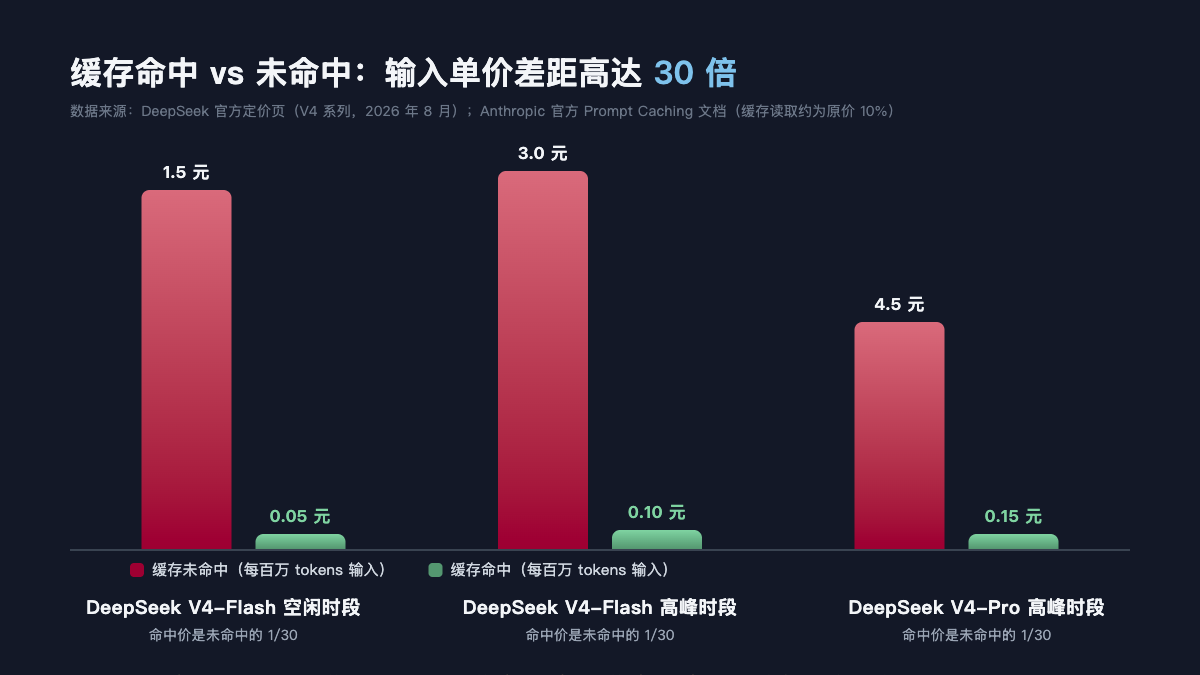
注意两个坑:缓存命中率低于 60% 时,写入成本可能吃掉省下的钱;TTL 有时效(默认 5 分钟,使用即免费续期),两次调用间隔太久缓存就失效了。
3. 任务切换就清空上下文(最容易被忽视)
多轮对话里,每一轮都要把全部历史重新发一遍。我们用 GPT-4o 同族分词器实测:同一会话里每轮带一段 50 行代码提问,30 轮后单轮上下文达到 16 万 tokens,是第 1 轮的 30 倍;累计输入量高达 250 万 tokens。如果拆成 3 个会话各做 10 轮,输入量直接降到约 1/3。
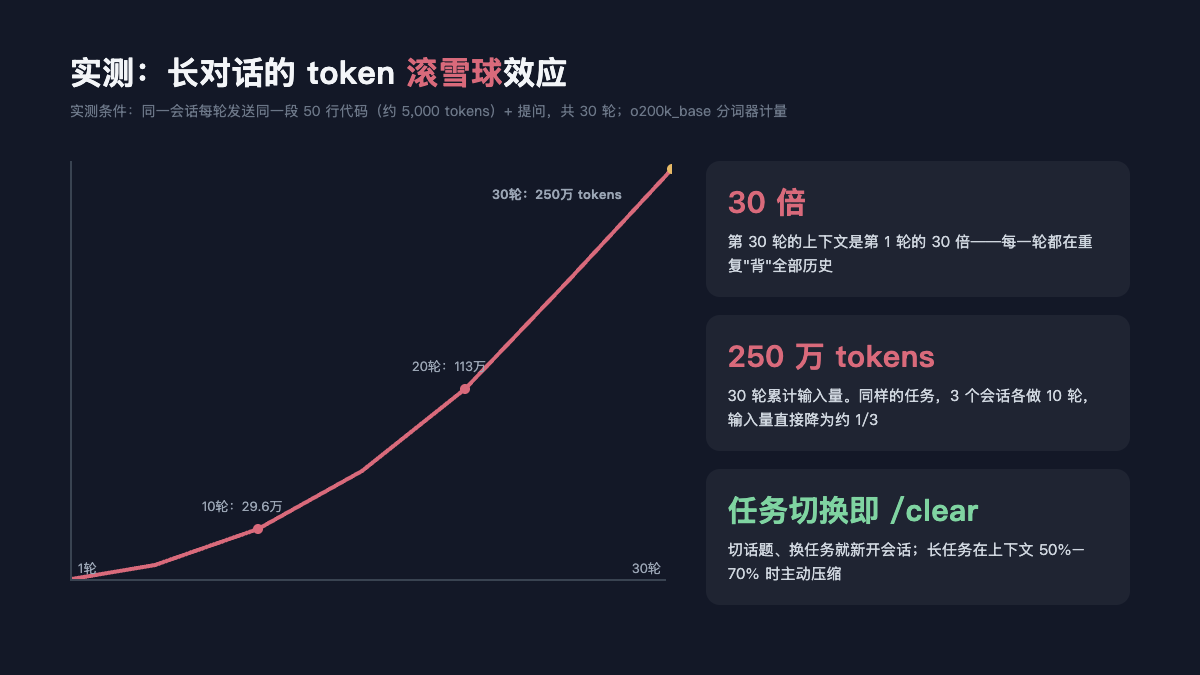
做法:聊天用户切话题就开新会话;Claude Code 用户在任务之间执行 /clear;养成习惯即可,零成本。
4. 长任务在上下文 50%~70% 时主动压缩
不得不做长任务时,别等到撑爆上下文才处理。Claude Code 的 /compact 可以把历史压缩成摘要继续工作;聊天场景可以让 AI 先把前面的讨论总结成一段要点,新会话贴上要点再继续。越早压缩,重复发送的无效历史越少。
5. 一次说清需求,但别在措辞上过度纠结
"挤牙膏式"的多轮试探会成倍增加轮次,每轮又都在复利计息。我们在纯文本场景实测:把 106 字的口语化请求改写成 94 字的结构化指令,输入 token 省 23%。但注意:当消息里附带着大段代码或文档时,这些措辞优化只占总量的 1%~5%——这时该优化的是"别重复发送大块内容"(用第 2、7 招),而不是抠字眼。
6. 管住输出:输出 token 单价是输入的 3~5 倍
让 AI"分点说、控制在 X 字内、只给结论",比输入端任何优化都直接。我们实测同一问题的两种回答风格:口语化长答案 82 tokens,直接给步骤的短答案 29 tokens,省 65%。批量处理场景尤其要限制每条的输出格式,比如要求固定字段返回。
7. 用文件和记忆代替重复粘贴
每次对话都重新粘贴 60 页 PDF?每次都是几万 tokens。正确做法:Claude 用 Projects / Memory 把常驻资料放进项目知识库;API 调用把固定前缀交给缓存(第 2 招);多人或多 Agent 协作时把中间结果写到共享文件里互相引用,而不是在消息里来回传。一句话:不变的内容只发一次。
8. 批量任务走 Batch API、用非高峰时段
不要求实时结果的任务(夜间摘要、批量文档处理、评测),用 Anthropic 的 Message Batches API 官方直接打五折;DeepSeek 则按时段计价,工作日 9:00–12:00、14:00–18:00 是高峰,其余时段(含周末)输入输出全部半价,把定时任务排在空闲时段跑,等于自动打折。
9. 工具和 MCP 服务按需挂载
每个挂载的工具都会把它的定义塞进每次请求。挂几十个工具、每个定义几百 token,一条简单指令可能凭空多出上万 tokens 的固定开销。只开当前任务真正用得上的工具,用完就关。
10. 监控用量,先找到你的"吞金兽"
优化前先看数据:Claude Code 用 /context 查看上下文构成;API 用户在控制台看用量明细。多数人会发现 80% 的消耗来自一两类调用——通常是长对话或重复的大前缀。对症下药,比全面撒网有效得多。
三类人群的省 token 配方
| 人群 | 优先做 | 预期效果 |
|---|---|---|
| 聊天用户(小白) | 日常任务用免费网页版;切话题开新会话;要求"分点、简短" | 基本零成本 |
| 编程工具用户(Claude Code 等) | 任务间 /clear;Plan 模式先确认再执行;限制终端输出;大搜索交给子代理 | 省 50%~80% 额度 |
| API 开发者 | 开 Prompt Caching;非实时任务走 Batch;错峰调用;工具按需挂载 | 最高省 90% 账单 |
新手最容易踩的 3 个坑
- 坑一:把"写短提示词"当万能药。 带长内容时措辞只占 1%~5%,省 token 要抓上下文和缓存这些大头。
- 坑二:什么都用最强模型。 改个错别字也调旗舰模型,等于用 5 倍价格办同样的事。
- 坑三:缓存开了却没命中。 两次调用间隔超过 TTL、每次前缀都在变,写入成本反而更高。先看命中率,再决定要不要开。
总结
2026 年省 token 的逻辑已经从"抠提示词字数"升级为"工程化管理":配对模型、用好缓存、控制上下文。先把模型分级和 /clear 这两个零成本动作养成习惯,再根据你的使用方式叠加缓存和 Batch 折扣。想找免费或低价的模型和工具,可以从 AI 工具导航开始;更多实战经验欢迎到 AI345 知识论坛交流,或在注册 AI345 账号后订阅你关注的栏目,第一时间获取新技巧更新。
本文由 AI345 内容团队撰写。实测数据基于 o200k_base 分词器(GPT-4o 同族)本地计量,2026 年 8 月测得;模型价格以各厂商官方页面为准,可能随时间调整。最后更新:2026 年 8 月 30 日。
常见问题
省 token 是不是把提示词写短就行?
不是。提示词措辞只在纯文本轻量场景有明显收益(实测约 20%);带长代码或文档时占比不到 5%。真正的大头是模型选档、缓存命中和控制上下文长度。
我是 ChatGPT Plus / Claude Pro 订阅用户,省 token 跟我有关吗?
有关。订阅制按用量限流,token 省着用等于同样的额度干更多活、少撞"本月使用上限",不需要额外花钱。
Prompt Caching 为什么能省钱?缓存命中是什么意思?
模型处理你的请求时,不变的部分(system prompt、长文档)要重复"阅读"计费。开启缓存后,这部分结果会被服务端保存,下次直接复用,读取价格只有原价的 10%(Anthropic)到约 1/30(DeepSeek)。
中文是不是比英文更费 token?
现在的分词器已经大幅改善。我们实测同一段语义,34 个汉字编码为 25 个 tokens(约 0.74 token/字),对应的英文是 17 个 tokens。中文确实略费一些,但远没有"1 个汉字=2 个 token"的旧说法夸张,不必为此刻意改用英文提问。
怎么查看自己用了多少 token?
聊天工具看会话详情或用 `/context` 类命令;API 在各厂商控制台的用量页有按模型、按天的明细;本地粗估可以用各家官方的 tokenizer 工具粘贴文本估算。
新手先做哪三件事?
第一,把任务分级,轻量任务换免费或低价模型;第二,切任务就开新会话或 /clear;第三,要求 AI 简短输出。这三步不花任何成本,就能省下大部分浪费。
 京ICP备2024094994号-29