
Gemini 3.8 Live 是什么?谷歌实时语音模型能力与定价全解读
Gemini 3.8 Live 是谷歌 2026 年 9 月 15 日发布的最新实时语音对话模型,与它一同发布的还有 Gemini 3.8 Live Extended Thinking。简单说:前者负责"听得清、答得快、成本低",适合大规模语音产品;后者能"边推理边说话",适合要边聊边干活的复杂任务。两个模型当天起就能在 Gemini API 和 Google AI Studio 使用,普通用户在 Search Live、Gemini 应用里也能体验到。下面把功能、定价、体验方式和开发者迁移要点一次讲清。
先分清:3.8 Live 和 Extended Thinking 是两个模型
这是媒体报道里最容易混淆的一点:Extended Thinking 不是 3.8 Live 上的一个开关,而是带独立端点的另一个模型,模型 ID 也不同。
| 对比项 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| 模型 ID | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| 定位 | 低延迟、大规模、成本优先 | 高复杂度任务、多步推理 |
| 交互方式 | 立刻回答 | 边推理边说话,实时播报进展 |
| 思考深度设置 | 不支持 thinking_level | 支持 low / medium / high 三档 |
| 普通用户入口 | Search Live | Gemini Live、Workspace 的 Docs/Gmail/Keep |
| 发布状态 | Stable(Gemini API) | Stable(Gemini API) |
一张图记忆:3.8 Live 立刻回答你;Extended Thinking 当着你的面干活,干活时还会用"我看一下"这类短句保持对话不断线。
Gemini 3.8 Live 的四个核心能力
按官方公告(Google 博客)的说明,它对普通用户最有感知的四点是:
- 对话中自动切换语言:官方发布材料称支持 97 种语言,能在一次对话中自动检测并切换,中英混说不用手动调设置。
- 近实时看懂画面:可以处理视觉输入。在 Search Live 里把摄像头对准断掉的自行车链或漏水的水管,它会一步步用语音给维修指引。
- 后台执行任务不打断对话:模型在对话进行中就能调用工具和 API,任务在后台跑,对话继续,干完再汇报结果。
- SynthID 水印:所有 AI 生成的音频都带不可感知的 SynthID 水印,可被检测为 AI 生成内容。
一个需要交代的细节:97 种语言是发布营销口径,Live API 文档目前仍写 70 种,以 API 参考文档后续更新为准。
Extended Thinking:边推理边说话是怎么做到的
传统语音模型要么"快而不深",要么"深而卡顿"——推理时用户只能干等静默。Extended Thinking 的解法是把推理过程"说出来":处理"帮我策划一场活动"这类多步骤请求时,它会先给口头确认,然后一边查工具、调 API,一边实时讲解进度。
对开发者来说,这意味着协议层面的一个关键变化:以前 Live 模型里 turnComplete 事件代表模型空闲、可以安全发下一轮输入;在 Extended Thinking 上这个假设不再成立,客户端要改跟踪 interaction_status信号——IN_PROGRESS 表示它还在推理或调工具,IDLE 才是真正空闲。工具也必须声明为 NON_BLOCKING,阻塞式声明会直接报错。
官方公布的基准成绩(均为谷歌自报,对比配置由谷歌选定)如下:
| 基准测试 | 3.8 Live Extended Thinking | GPT-Live-1 Astra (Medium) | Grok Voice Think Fast 2.0 (High) |
|---|---|---|---|
| Artificial Analysis 语音对语音质量指数 | 82.6(自报第一) | 81.5 | 81.3 |
| τ-Voice 智能体任务完成率 | 68.6% | 67.9% | 56.5% |
| Sierra τ³-Voice-Banking(银行客服) | 35.1% | 32.0% | 16.5% |
| Big Bench Audio | 97.7% | 未公布 | 未公布 |
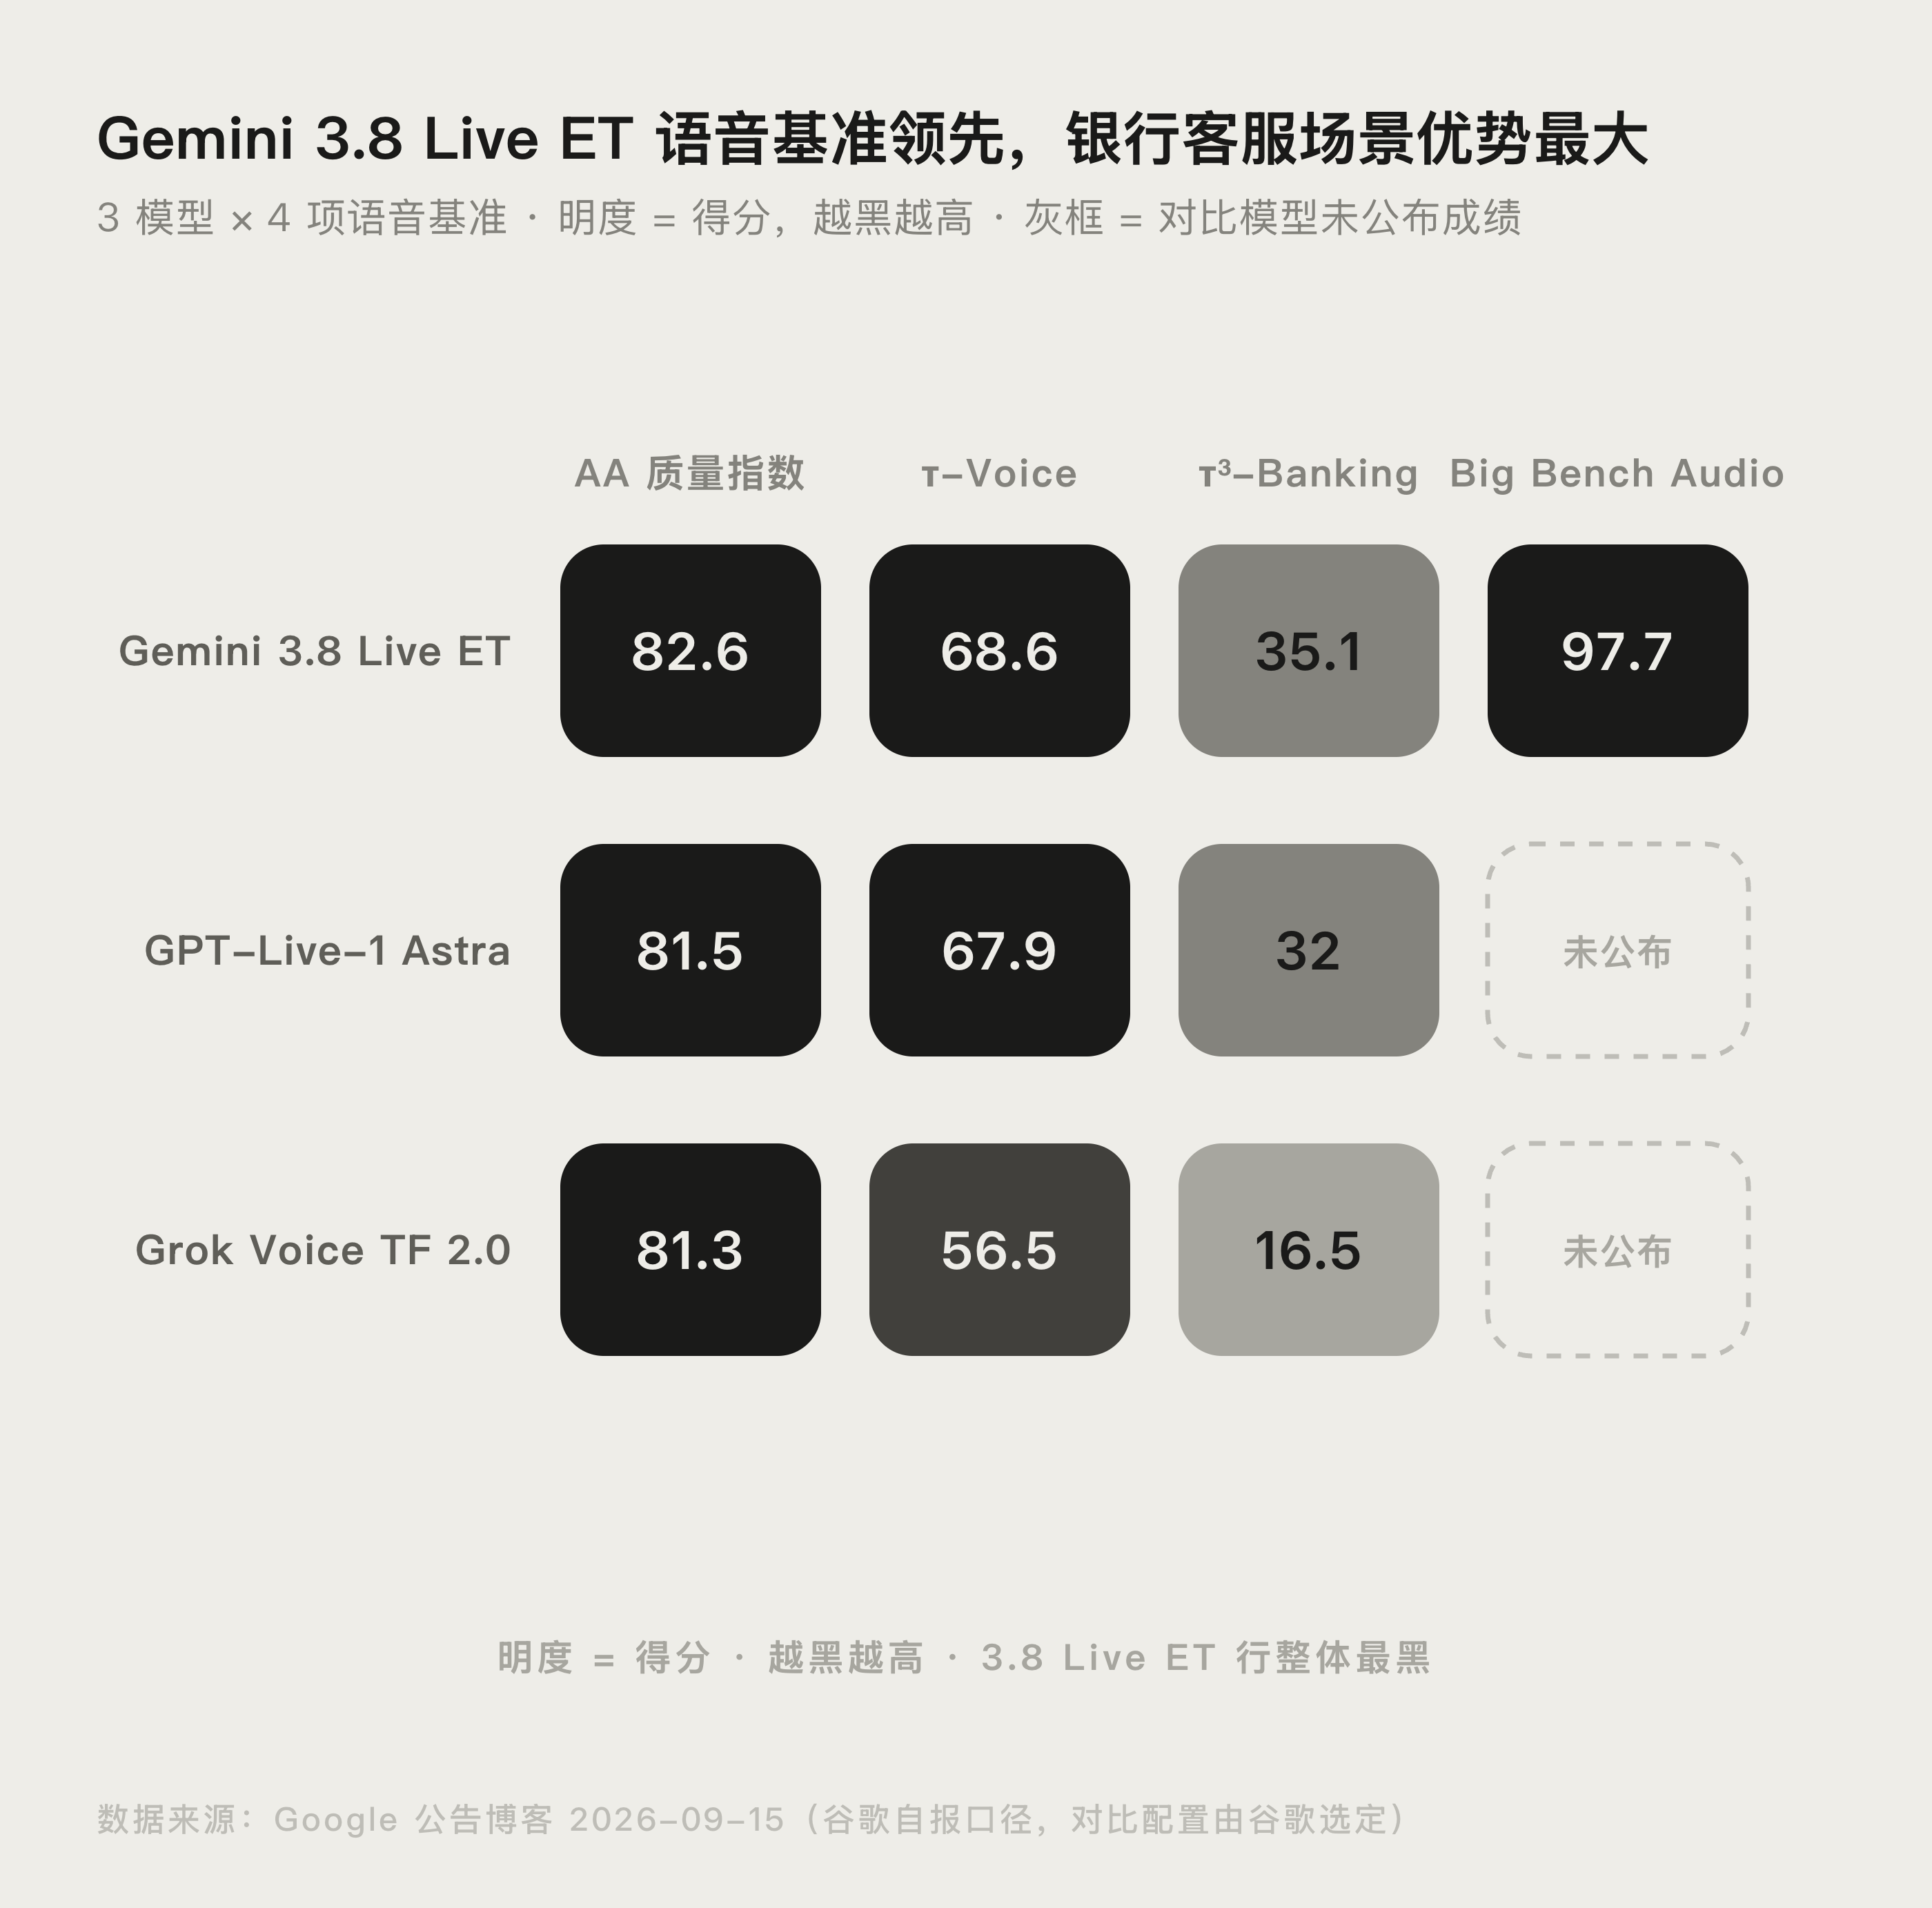
普通 3.8 Live 在 Speech Agent Arena 用户偏好榜排第二,媒体报道其每小时输入音频成本约 $0.84、Extended Thinking 约 $3.50。作为参照,同一语音质量指数在 2026 年 6 月时由 GPT-Realtime-2 以 77.2 领跑,上一代 Gemini 3.1 Flash Live Preview 是 69.5——82.6 是一次明显的跃升,但独立复现要等指数维护方发布。
定价:音频输入 $0.005/分钟,输出 $0.018/分钟
两个 3.8 模型在官方定价页共享同一行价格,Extended Thinking 不加价。注意思考 token 按输出计费——Extended Thinking 不说话时也在推理,也在消耗输出 token。
| 计费项 | 免费层 | 付费层 |
|---|---|---|
| 输入:音频 | 免费 | $3.00 / 百万 token,或 $0.005 / 分钟 |
| 输入:文本 | 免费 | $0.75 / 百万 token |
| 输入:图片/视频 | 免费 | $1.00 / 百万 token,或 $0.002 / 分钟 |
| 输出:音频(含思考 token) | 免费 | $12.00 / 百万 token,或 $0.018 / 分钟 |
| 输出:文本 | 免费 | $4.50 / 百万 token |
规模感参考:付费层上一次两分钟的语音对话,输入成本约 1 美分、输出不到 4 美分。免费层数据会被用于改进谷歌产品,生产流量建议走付费层。和 OpenAI 的全双工语音模型 GPT-Live-1($0.05/分钟按秒计费,见站内 GPT-Live-1 上手指南)相比,Gemini 的输入定价低一个量级,但两者架构不同——GPT-Live 把推理交给后端模型单独计费,直接比单价意义不大,要按自己的链路算总账。
普通用户怎么免费用上
按你的身份选入口,全程不需要写代码:
- 最简单:Search Live。在谷歌 App 里使用 Search Live 功能,就是 3.8 Live 驱动的,可以直接开摄像头让它看现场、给指引。
- 语音对话:Gemini 应用。打开 gemini.google.com 或 Gemini App,Extended Thinking 版已进入 Gemini Live 语音对话。
- 办公场景:Google Workspace。订阅 Google AI Pro / Ultra 的用户可以在 Docs 里用 Docs Live 对着文档语音提问;Gmail 和 Keep 的 Live 功能对所有 Google AI 订阅者开放。
- 想自己调着玩:Google AI Studio。打开 ai.studio(需 Google 账号登录),用免费额度就能在 Stream Realtime 界面里和模型语音对话。
国内用户提醒:以上入口都需要 Google 账号,且谷歌服务在大陆无法直连,请先评估访问成本。
开发者快速上手:最小可用代码
Live API 是有状态的 WebSocket 会话。最小 setup 消息只需要模型字符串:
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "response_modalities": ["AUDIO"]
  }
}
要用思考能力,换模型 ID 并设置思考档位:
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "response_modalities": ["AUDIO"],
    "thinking_config": { "thinking_level": "medium" }
  }
}
音频规格:输入 16 kHz 原始 PCM,输出 24 kHz PCM,视频帧不超过 1 FPS 的 JPEG。生产环境推荐用 ephemeral token 而不是裸 API key 直连客户端。更多示例见官方 Live API 文档。
从 3.1 Flash Live 迁移,这 6 处会 breaking
官方迁移文档列出的破坏性变更,我们提炼成检查清单:
- 模型字符串换成
models/gemini-3.8-live; - 删掉 thinking_level:3.8 Live 不支持这个参数,发了会报错(要思考能力请换 Extended Thinking 的模型 ID);
- 异步函数调用成为默认:
behavior: NON_BLOCKING,阻塞模式要显式声明BLOCKING兼容; - 主动音频永久开启:设
proactive_audio: false会报错; - 情感对话已移除:删掉
enable_affective_dialog配置; - 音频是唯一输出模态:需要文字稿要开启输出音频转录,且视频帧默认全部进入上下文,注意控制成本。
一句话判断要不要迁:如果你的场景依赖情感对话或阻塞式工具,先改代码再换模型字符串;其余场景基本可以平替,且延迟和成本都有改善。
总结
Gemini 3.8 Live 系列把"实时语音"和"深度推理"拆成了两个专职模型:要快、要便宜、要规模化,用 3.8 Live;要边聊边干复杂任务,用 Extended Thinking。对普通用户,今天就能在 Search Live 和 Gemini 应用里免费体验;对开发者,$0.005/$0.018 的每分钟定价是目前头部语音模型里的低位,从 3.1 Flash Live 迁移的六处变更也都有明确的官方指引。想了解同代的文本模型,可以看站内 Gemini 3.8 Flash 解读;语音转文字需求则参考 Gemini 语音转写使用指南。
作者:AI345
最后更新于 2026 年 9 月
本文事实核对来源:Google 官方公告(2026 年 9 月 15 日)、Gemini 3.8 Live 官方模型页(更新于 2026-09-15)、Gemini 3.8 Audio 模型卡。基准成绩均为谷歌自报口径。
常见问题
Gemini 3.8 Live 是免费的吗?
答:分两层。普通用户在 Search Live、Gemini 应用里免费使用;开发者 API 有免费层但数据会被用于改进产品,生产流量走付费层,音频输入 $0.005/分钟、输出 $0.018/分钟。
Gemini 3.8 Live 和 Extended Thinking 应该选哪个?
答:做实时语音客服、语音助手这类高并发对话选 3.8 Live,延迟低、成本低;如果智能体要在对话中查数据、调 API、做多步规划,选 Extended Thinking,它边推理边说话,但要为思考 token 的额外输出费用做预算。
它支持中文吗?
答:支持。官方发布材料称支持 97 种语言且对话中自动切换(API 文档当前仍写 70 种),中英混说可以自动识别,无需手动设置。
国内用户能用上吗?
答:官方入口(Search Live、Gemini 应用、AI Studio、Gemini API)都需要 Google 账号且大陆无法直连。个人体验需自备合规网络环境,企业建议评估海外主体接入。
API 模型 ID是什么?取代 3.1 Flash Live 了吗?
答:两个 ID:`gemini-3.8-live` 和 `gemini-3.8-live-extended-thinking`,均为 Stable 状态。它们取代的是上一代 `gemini-3.1-flash-live-preview`,迁移有 6 处破坏性变更,见上文检查清单。
怎么分辨一段音频是不是 AI 生成的?
答:所有 3.8 Live 系列生成的音频都嵌入了 SynthID 隐形水印,人耳听不出,但可以被检测工具识别为 AI 生成内容。
 京ICP备2024094994号-29