Convai Laya 是什么?不生成文本的决策模型,38 毫秒出结果
Convai Laya 是什么?它是 Convai Innovations 于 2026 年 9 月 18 日开源的非自回归决策模型,参数量 421M。给它一段邮件、工单或 JSON 文档,再给几道选择题,它直接返回带概率和置信度的结构化答案,全程不生成文本,也就没有解析失败和幻觉输出。
Laya 是什么:只做判断、不做写作
底座是 ModernBERT-large(395M,双向注意力,全量微调),上面接一个从零训练的决策头,包含 2 层 Transformer、一个选项标记打分器和一个 act/escalate 头,总参数 421M。
输入输出都是结构化的:给它一个 state(文本、邮件、工单或 JSON 文档)和一组带类型的问题,它返回选项、分数或概率,一次前向完成。它不是聊天模型,也不是 Agent 框架,更像一个能被程序直接调用的判断函数。
三种问题类型,覆盖大多数分类与打分需求
| 问题类型 | 返回什么 | 典型场景 |
|---|---|---|
| choice | 选中的选项、每个选项的概率、校准后的置信度 | 该转给哪个部门、这条内容属于哪一类 |
| score | 有序量表上的期望等级、分布、置信度 | 紧急程度打分、优先级排序 |
| noul | 校准过的布尔概率 P(true),取值 0.0 到 1.0 | 是不是钓鱼邮件、有没有流失风险 |
对你意味着什么:以前这类判断要么写 if-else,要么让大模型写一段话再正则提取。Laya 直接把结果变成可计算的数值,阈值判断和自动放行都能落地。
官方模型卡里的延迟与准确率
延迟单位为毫秒,准确率为 macro accuracy,ECE 越低说明概率越准。
| 指标 | 数值 |
|---|---|
| 单问题 P50 延迟 | 38.4 ms(p95 42.1 ms) |
| 10 个问题批量延迟 | 156.0 ms |
| 50 个问题批量延迟 | 721.4 ms |
| 任务内 macro accuracy | 0.838(ECE 0.060) |
| 零样本 macro accuracy | 0.651(ECE 0.207) |
| 意图与路由 | 0.991(ECE 0.009) |
| 审核与安全 | 0.967(ECE 0.061) |
| 情绪与语气 | 0.906(ECE 0.018) |
| 邮件分诊与钓鱼识别 | 0.732(ECE 0.017) |
| 推理与事实核查 | 0.883(ECE 0.054) |
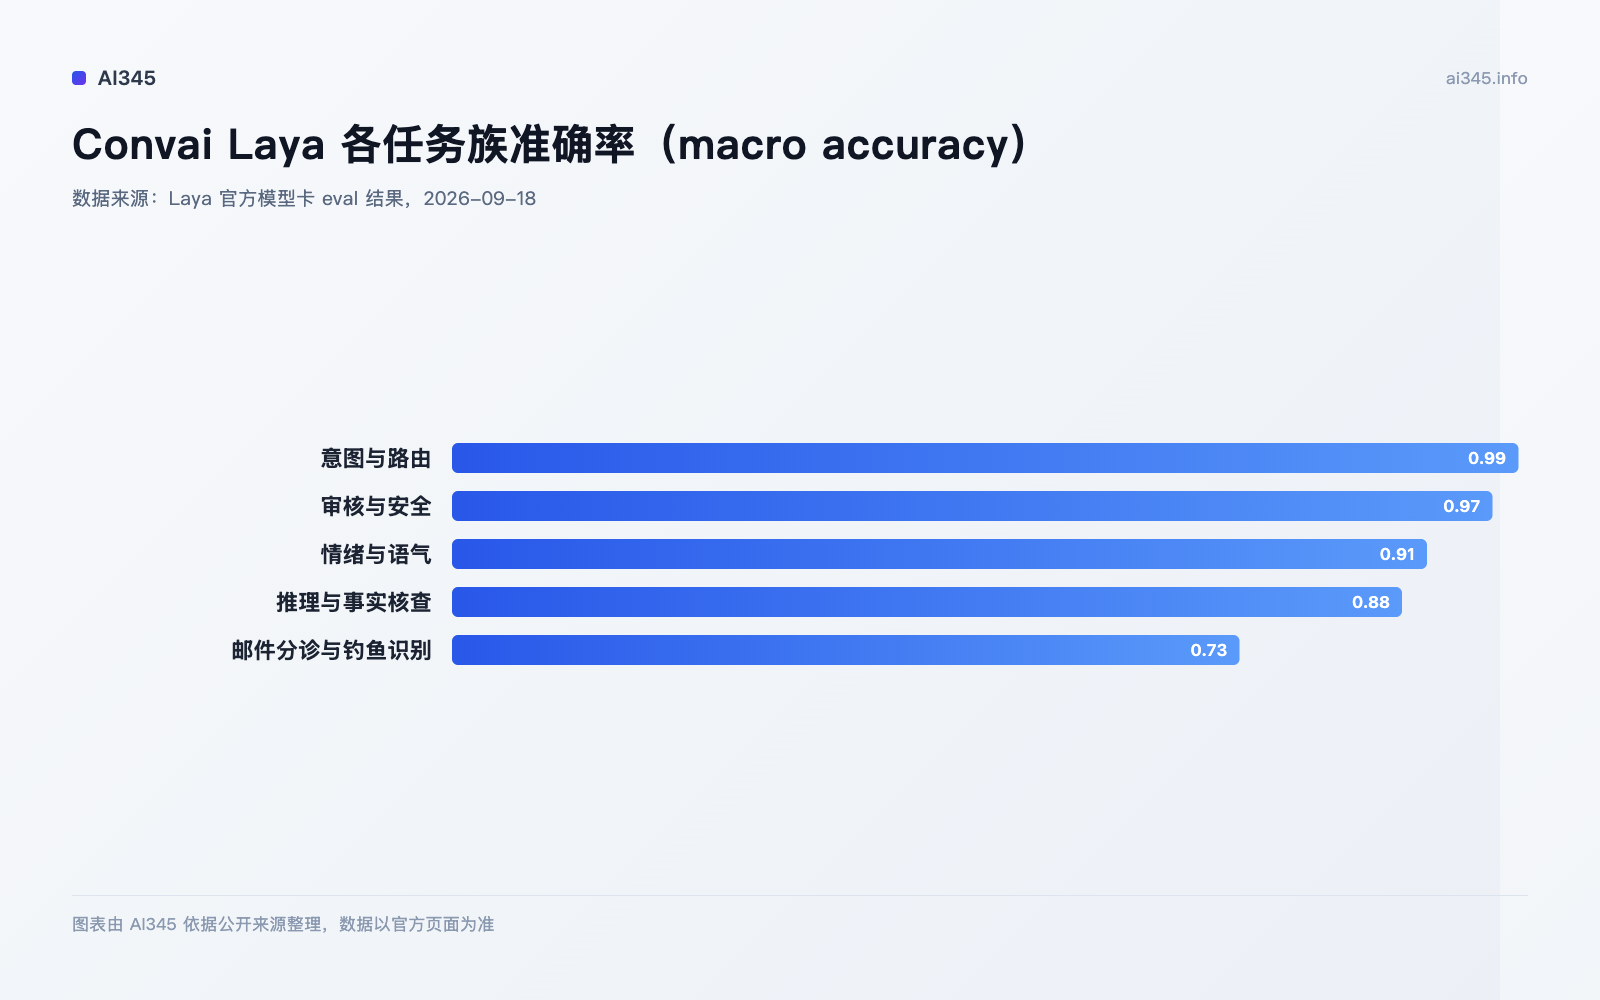
模型卡里拿来做对比的 TypeSafe Jev 用的是对方公布的数字,两家并非同硬件、同数据集实测,横向结论只能当参考。真正该看的是任务内与零样本之间的差距:0.838 对 0.651,ECE 从 0.060 涨到 0.207。意思是它擅长训练里见过的任务类型,遇到完全没见过的任务族,概率会明显不准,上生产前必须用你自己的数据复测。
为什么它能给出校准过的概率
Laya 用 RLCD(Reinforcement Learning for Calibrated Decisions)训练:策略输出概率分布,探索时给 logits 加零均值高斯噪声,奖励用严格恰当评分规则,也就是 log score 加 spherical score,序数题再叠加 ranked probability score。这类规则的性质是只有输出真实且校准的概率时期望奖励才最大,所以它没法靠赌一个高置信度拿高分。
训练上,官方给的是 7,313 次更新、1 个 epoch、约 1.96 小时,校准温度 1.637、1.251、1.983。对你意味着什么:它输出的 0.85 是在训练分布上调过温度的数值,可以直接写「置信度 ≥ 0.85 才自动处理,否则转人工」这类规则。
国内能用吗,最快怎么跑起来
权重在 Hugging Face 的 convaiinnovations/laya 仓库,Python 包在 PyPI 上的 laya,两者国内访问都可能不稳,超时换镜像源即可。推理完全在本地,不依赖任何外部 API。官方说可以跑在消费级 GPU、Mac 的 MPS 后端或纯 CPU 上。
三步走:
- 执行 pip install laya 安装官方包。
- 用 laya.load("convaiinnovations/laya") 从 Hugging Face 拉取权重,首次运行会自动下载。
- 把 state 和 questions 传给 agent.predict(),从返回的 answers 里取 choice、score 或 noul 字段。
import laya

agent = laya.load("convaiinnovations/laya")

state = "Customer reports a duplicate charge on the March invoice and threatens to cancel"

questions = {
    "churn_risk": {
        "type": "noul",
        "instructions": "Does the user threaten to cancel or switch to a competitor?",
    }
}

result = agent.predict(state, questions)
print(result["answers"]["churn_risk"]["noul"])
官方模型卡里还有 choice 和 score 的完整写法,可以直接对照抄。想先看效果再决定要不要装,可以打开 官方在线 Demo 试一句。
放在 2026 年的模型版图里看
同期发布里大家盯的多是能力更全的通用模型,比如 GLM-6.0 和主打免费匿名调用的 Union Alpha。Laya 走的是相反的路:不做通用,只做判断,用 421M 换稳定和便宜。
按站内 Fable 5.1 成本拆解 的思路,自托管小模型能把单次分类成本压到几乎可忽略。如果你的场景还涉及 Agent 操作真实环境,那是 Anthropic MHS 覆盖的范围,Laya 做不了。
适合谁用,不适合谁
适合有稳定分类、路由、审核、打分需求,希望结果可计算、可写阈值的工程团队;也适合对数据出境敏感、需要自托管或私有化部署的人。
不适合需要生成文字、对话和摘要的场景,Laya 根本不输出自然语言;不适合纯中文业务,当前只支持英文纯文本;也不适合长上下文或多跳推理,每个问题只有 512 token 预算。模型卡另外提醒,算术、计数、日期比较、多跳索引查找应当继续交给确定性代码。
常见问题
Convai Laya 是免费的吗?
答:是。权重和代码以 Apache 2.0 协议开源,个人和商用都可以,自托管不产生推理费用。Convai Innovations 另外提供商业支持、企业集成和定制微调服务,那部分是付费的。
Laya 和 GPT 这类大模型有什么区别?
答:定位不同。大模型生成文字再由程序解析;Laya 直接把判断结果输出成概率和分数,不做文本生成,所以没有解析失败和幻觉输出,延迟也压到几十毫秒。
Laya 支持中文吗?
答:目前不支持。模型卡的 Limitations 写明只支持英文纯文本,每个问题 512 token,超长内容会被截断。中文场景需要先做一层翻译,或等后续版本。
它的置信度可以直接当阈值用吗?
答:可以,但前提是先在自己的数据分布上复测。官方明确提醒校准是在它的基准数据集上测的,零样本场景 ECE 会明显变高,直接套阈值有风险。
 京ICP备2024094994号-29