
Embedding 是什么?图解文字变数字与向量检索原理
Embedding(嵌入向量)就是让计算机把文字变成一串数字的方法:意思相近的内容,变成的数字也相近。你在搜索框搜「苹果手机多少钱」能命中讲 iPhone 价格的文章,背后靠的就是它。这一篇用一张地图的比喻,把它的原理、用法和讲法一次说清。
Embedding 是什么:一句话定义
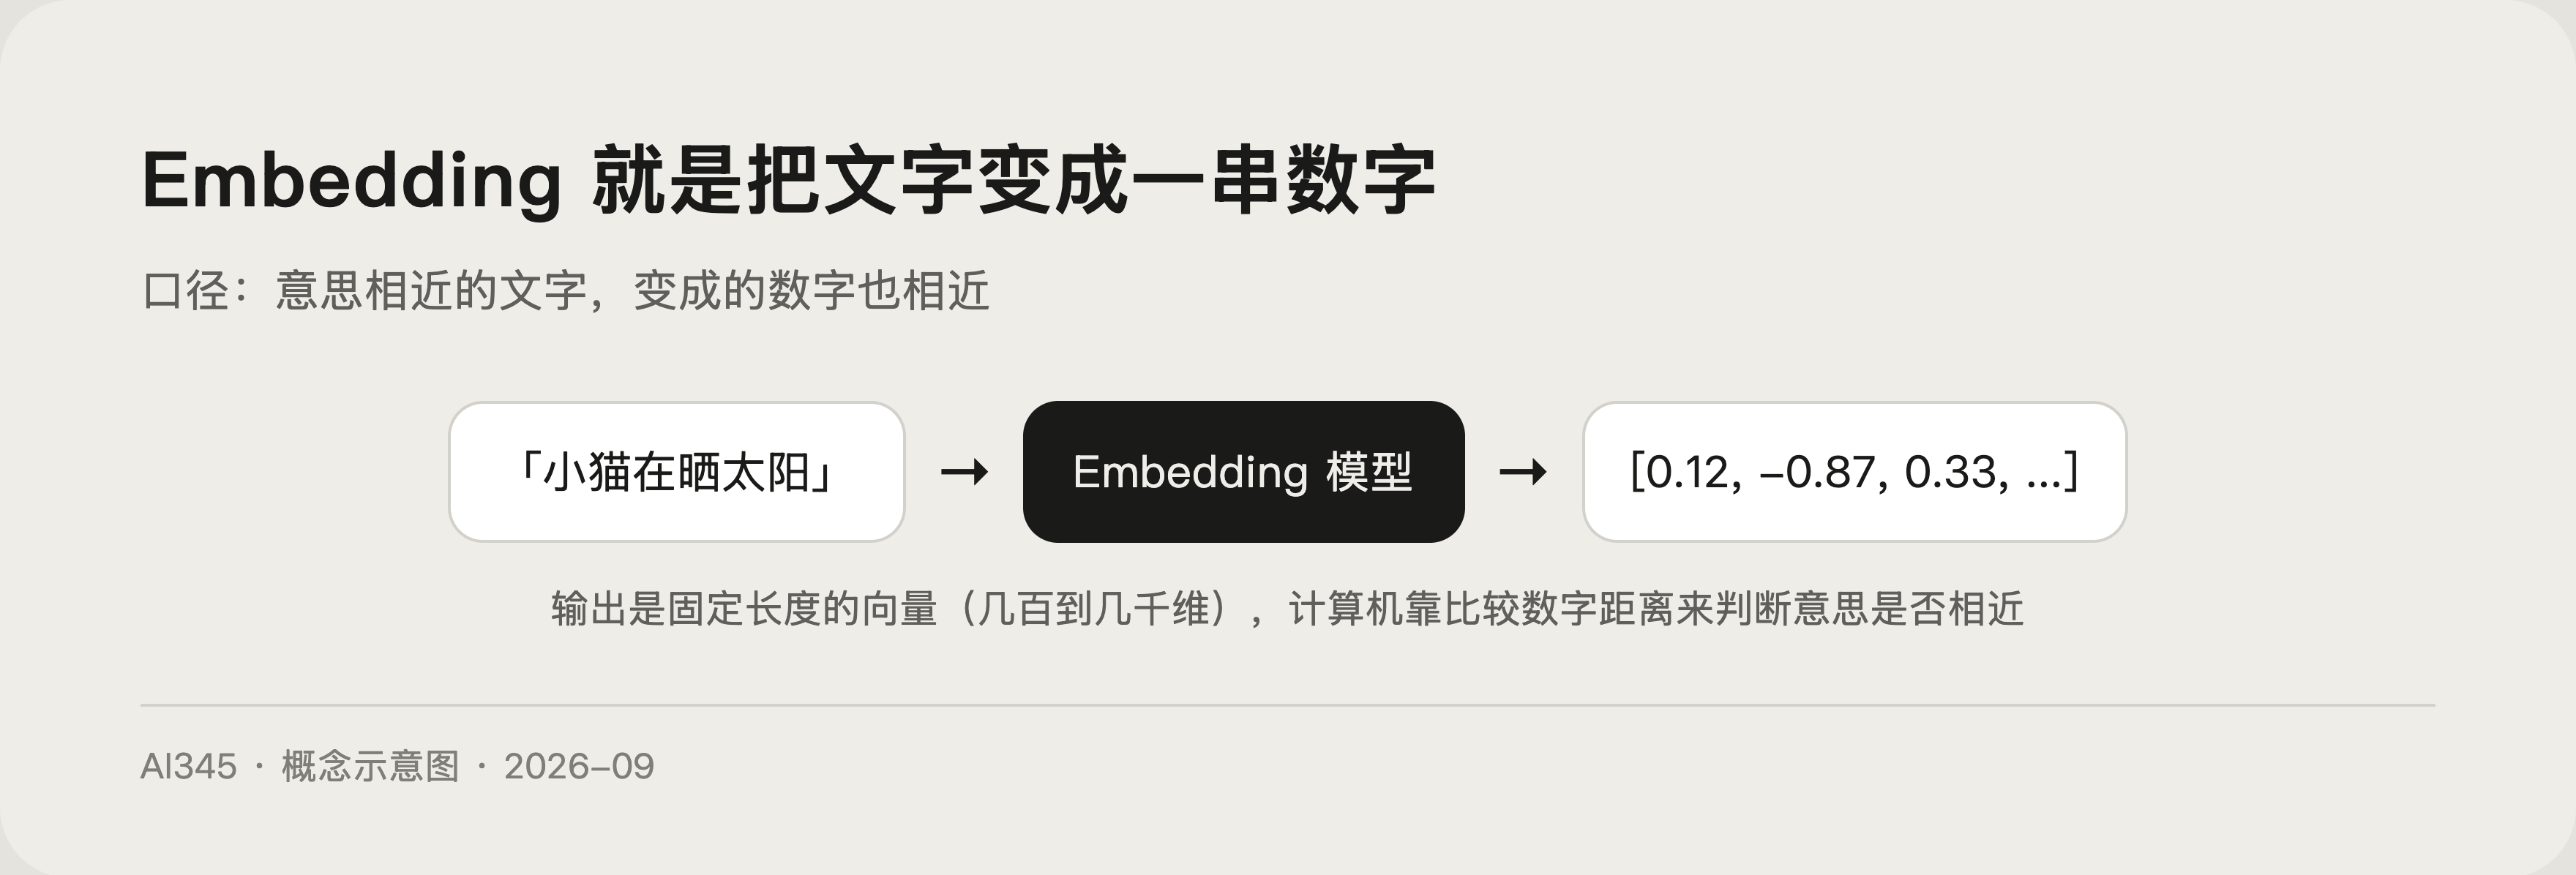
Embedding 的中文叫「嵌入」,指把一段文字、一句话甚至一张图片,转换成一串固定长度的数字,这串数字叫向量。向量里每个数字记录了内容某一方面的语义特征,两个向量越接近,代表两段内容的意思越接近。
这件事为什么重要?因为计算机不认识文字,只认识数字。要让机器判断「小猫」和「猫咪」意思相近、「苹果手机」和「iPhone」是一回事,就必须先把文字翻译成数字,再去比较数字之间的距离。
比喻主线:把所有内容放进一张巨大的地图
理解 Embedding 最好的比喻,是想象一张巨大的地图。
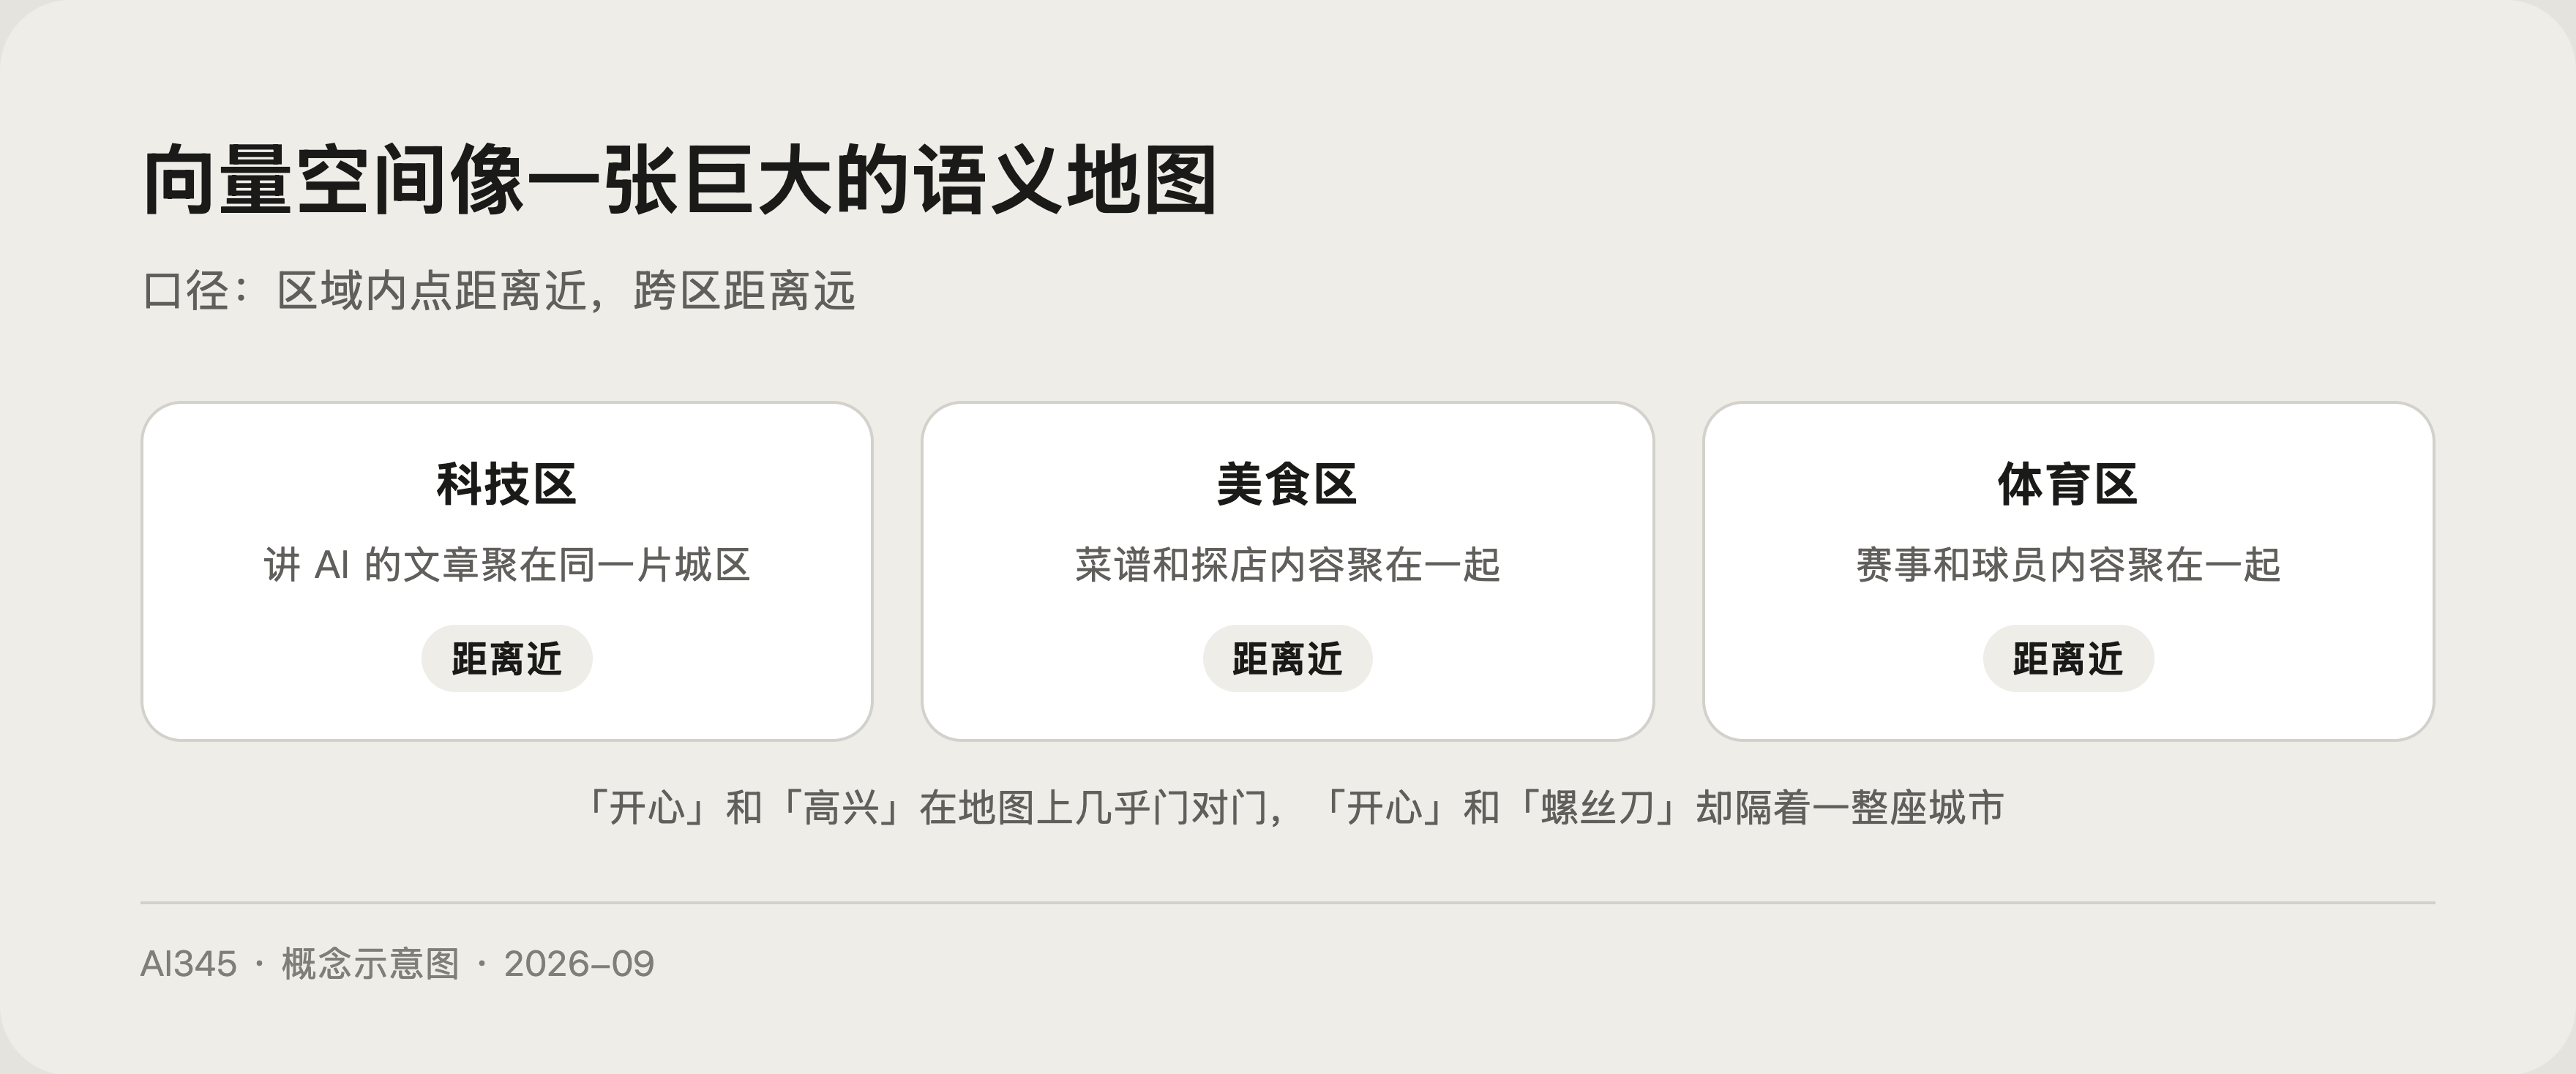
把互联网上每篇文章、每个词都想成地图上的一个地点:讲 AI 的文章聚在同一片城区,讲美食的聚在另一片;「开心」和「高兴」在地图上几乎门对门,「开心」和「螺丝刀」却隔着一整座城市。
地图放好之后,很多任务就变成了「在地图上找地点」:
- 搜索:把用户输入的一句话变成地图上的一个点,找出离它最近的那些文档。
- 推荐:把你看过的内容变成点,找出离它们最近、你还没看过的内容。
- 聚类:让机器把地图上扎堆的内容自动圈出来,形成话题分类。
这张地图就是向量空间,常说的「向量检索」,本质上就是在地图上找最近邻居。
文字怎么变成一串数字
把文字变成向量,流程分三步:
- 分词:先把文本切成模型能处理的最小单位,这一步就是 Token 化,Token 怎么切、为什么按它计费,之前那篇讲得很细。
- 过模型:把 Token 喂给一个训练好的 Embedding 模型,模型给每个 Token 分配一个初始向量,再根据上下文反复调整。
- 输出向量:最后得到一串固定长度的数字,常见维度从几百到几千,维度越高能承载的语义细节越丰富。
这条技术路线的里程碑,是 2013 年 1 月 Google 的 Mikolov 等人提出的 word2vec 论文:它证明了用 16 亿词的数据集,不到一天就能训练出高质量词向量,而且向量之间的距离能真实反映词义上的语法和语义相似关系。今天各家模型厂商的 Embedding 服务,比如 Cohere 的 Embed 系列文档,都是这条路线的后代。
向量检索:搜索和推荐的核心引擎
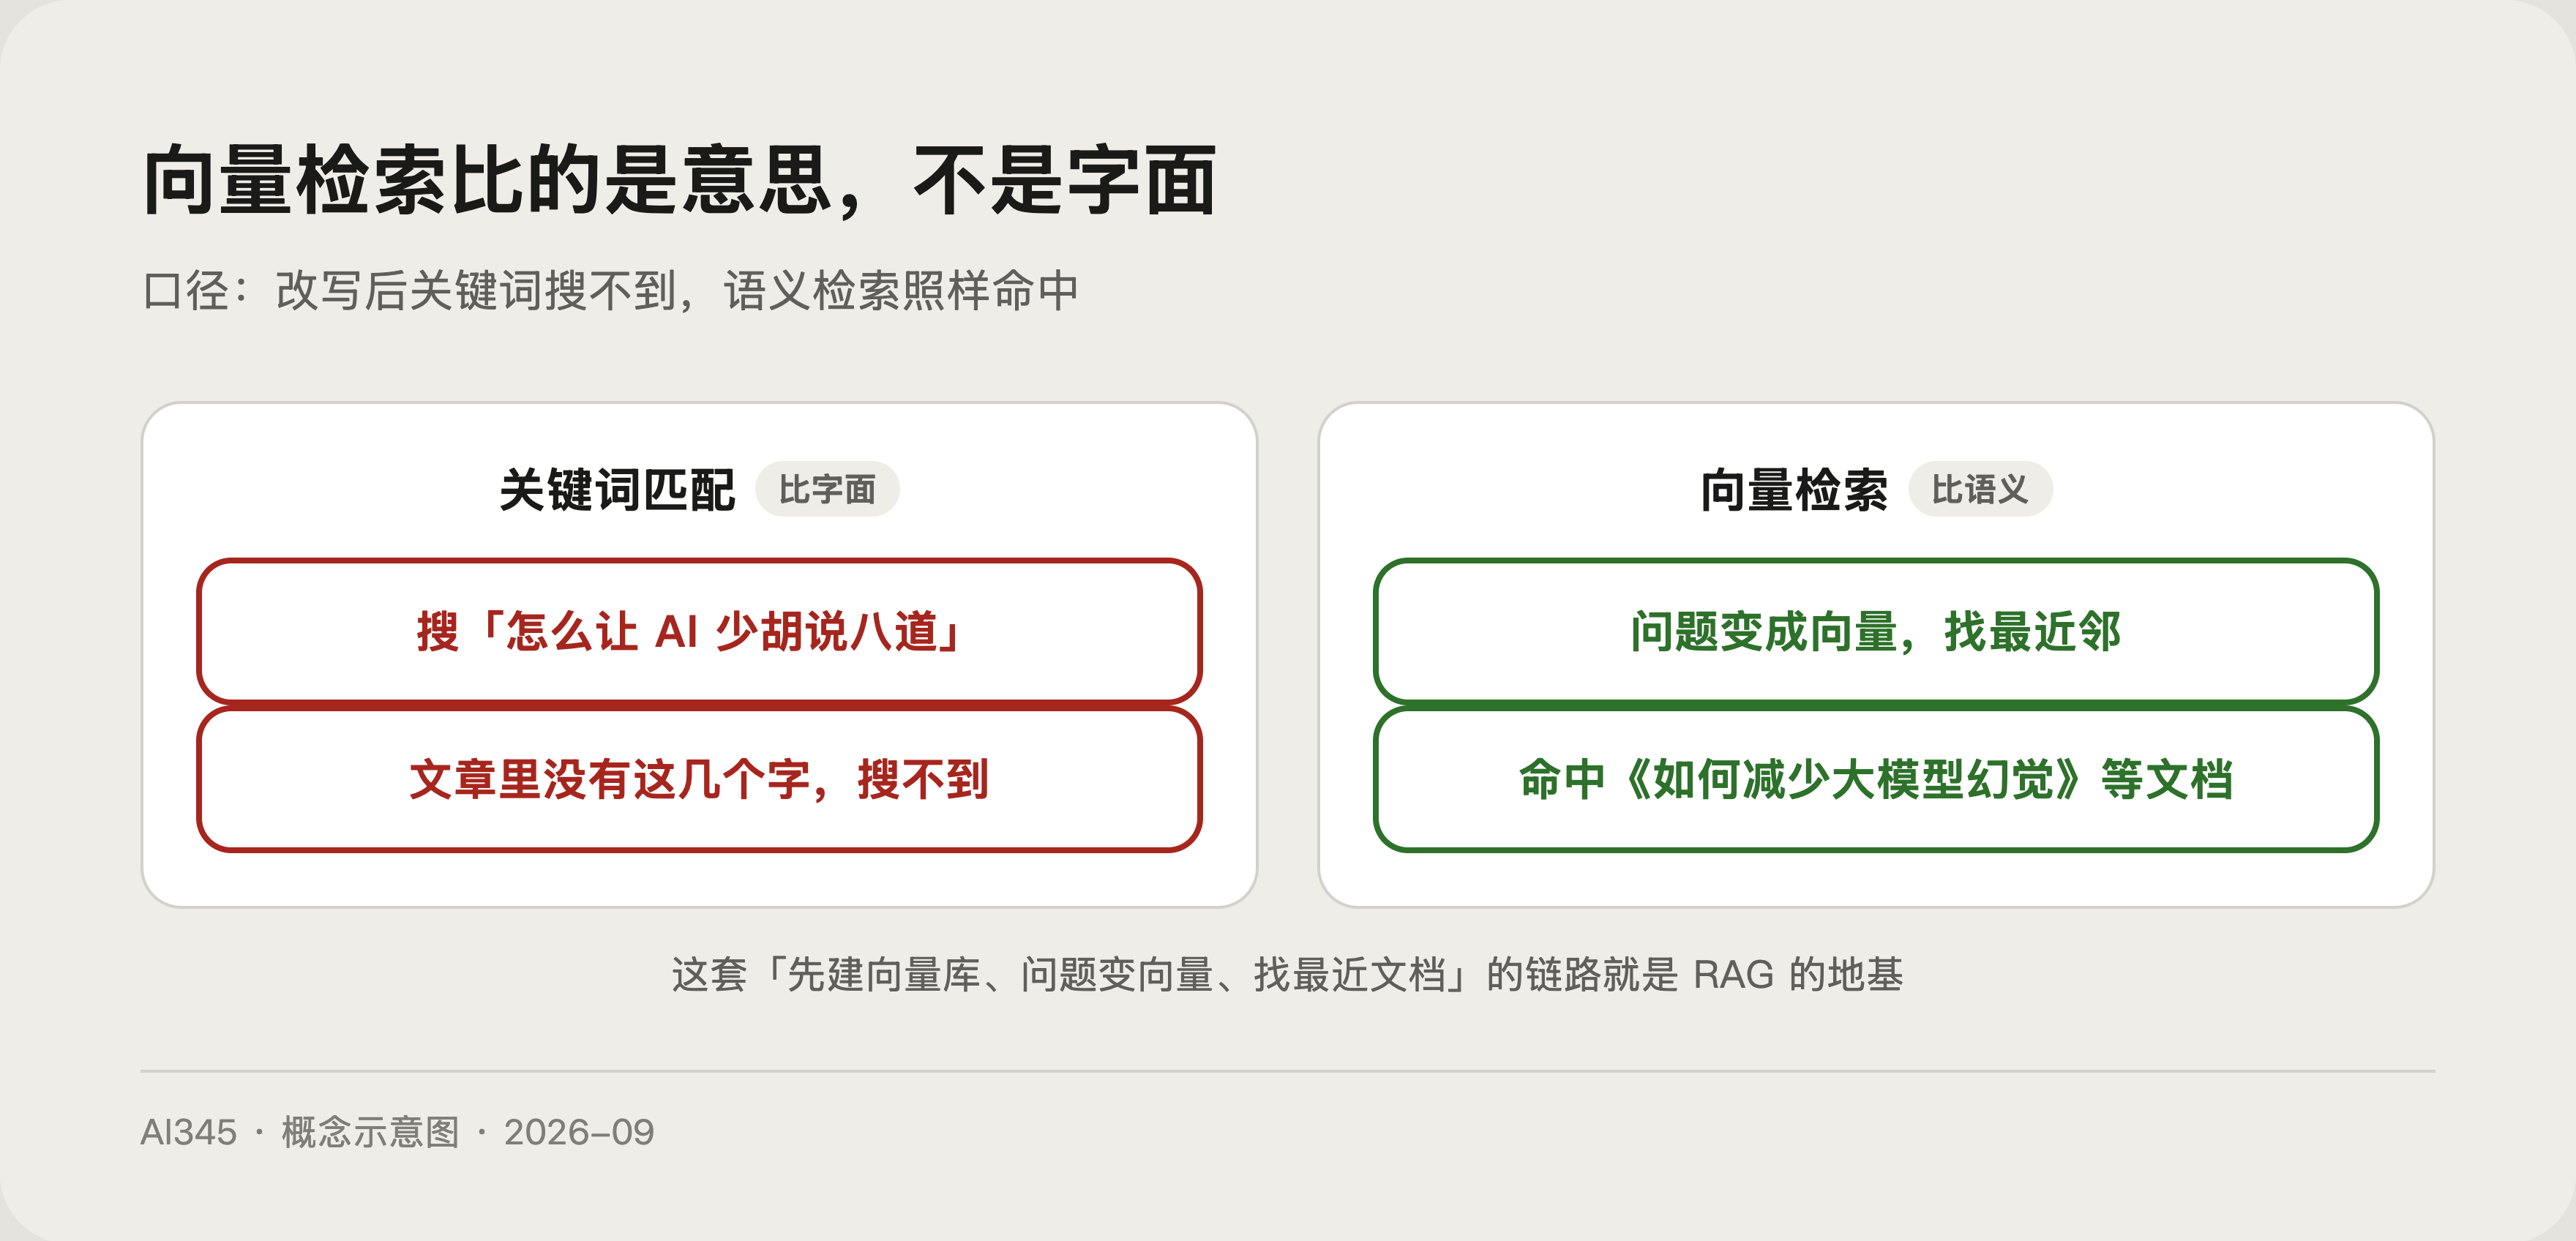
传统搜索靠关键词匹配,你搜「怎么让 AI 少胡说八道」,文章里没有这几个字就搜不到。向量检索比的是意思,不是字面。
- 提前把知识库里的每篇文档算好向量,存进向量数据库。
- 用户提问时,把问题也变成向量。
- 在地图上找出离问题最近的几篇文档,交给大模型组织答案。
这套组合拳就是 RAG 检索增强生成的地基,做 RAG 项目的产品经理绕不开它。另外,图片和音频同样能变成向量,甚至能和文字放进同一个向量空间对齐,这是以图搜图和跨模态检索的基础,细节可以看我们讲多模态大模型的那篇。
一段话讲清 Embedding
被问到「讲讲什么是 Embedding」,可以按这个口径复述:
「Embedding 就是把文字变成一串数字向量,让计算机能计算语义。它像一张巨大的地图,每段内容是地图上的一个点,意思越近的点离得越近。有了这张地图,搜索、推荐、RAG 都变成了找最近邻的数学问题。经典实现是 2013 年的 word2vec,如今它是向量数据库和 RAG 系统的核心组件。」
最常见的追问有两个。问「和 Token 什么关系」:Token 是切分单位,Embedding 是切分之后每个单位的数字表示,先切再变。问「怎么衡量两个向量像不像」:常用余弦相似度,可以粗略理解为量两个向量的夹角,夹角越小越相似。
哪些产品在用 Embedding
你每天都在用 Embedding,只是没意识到:电商的「猜你喜欢」、视频平台的推荐流、网盘的以图搜图、客服机器人的知识库问答,底层都是向量检索。判断一个 AI 需求要不要用 Embedding,就问一句:这个需求本质上是不是「找相似」。是,就用它;不是,别硬套。想系统补齐大模型基础概念的,可以先看大语言模型是怎么工作的。
常见问题
Embedding 和 Token 是什么关系?
答:Token 是文本切分后的最小单位,Embedding 是每个 Token 对应的数字向量。流程上是先切 Token,再把 Token 变成向量。
向量维度越高越好吗?
答:不一定。维度高能装更多语义细节,但存储和计算成本也随之上升,选型时要在效果和成本之间权衡。
图片也能做 Embedding 吗?
答:可以。多模态模型能把图片、音频映射到向量空间,甚至和文字共用同一个空间,这是以图搜图的基础。
Embedding 模型需要自己训练吗?
答:通用场景直接调现成的 Embedding 服务即可。垂直领域效果不好时,可以用领域数据微调,或换更合适的预训练模型。
向量检索能完全替代关键词检索吗?
答:不能。型号、代码、专有名词这类精确匹配需求,关键词更稳;自然语言描述、同义改写多的需求,向量更准。生产系统常两者混用。
 京ICP备2024094994号-29