
Temperature 和 Top P:AI 随机性一次讲透
同一个问题问 AI 两遍,回答可能不一样,秘密就在两个采样参数上。Temperature 决定概率分布被拉多平,Top P 决定候选名单多长,一个管稳、一个管准,这篇一次讲透,并给出写作和写代码场景的调法。
先搞懂:AI 每生成一个字都在抽奖
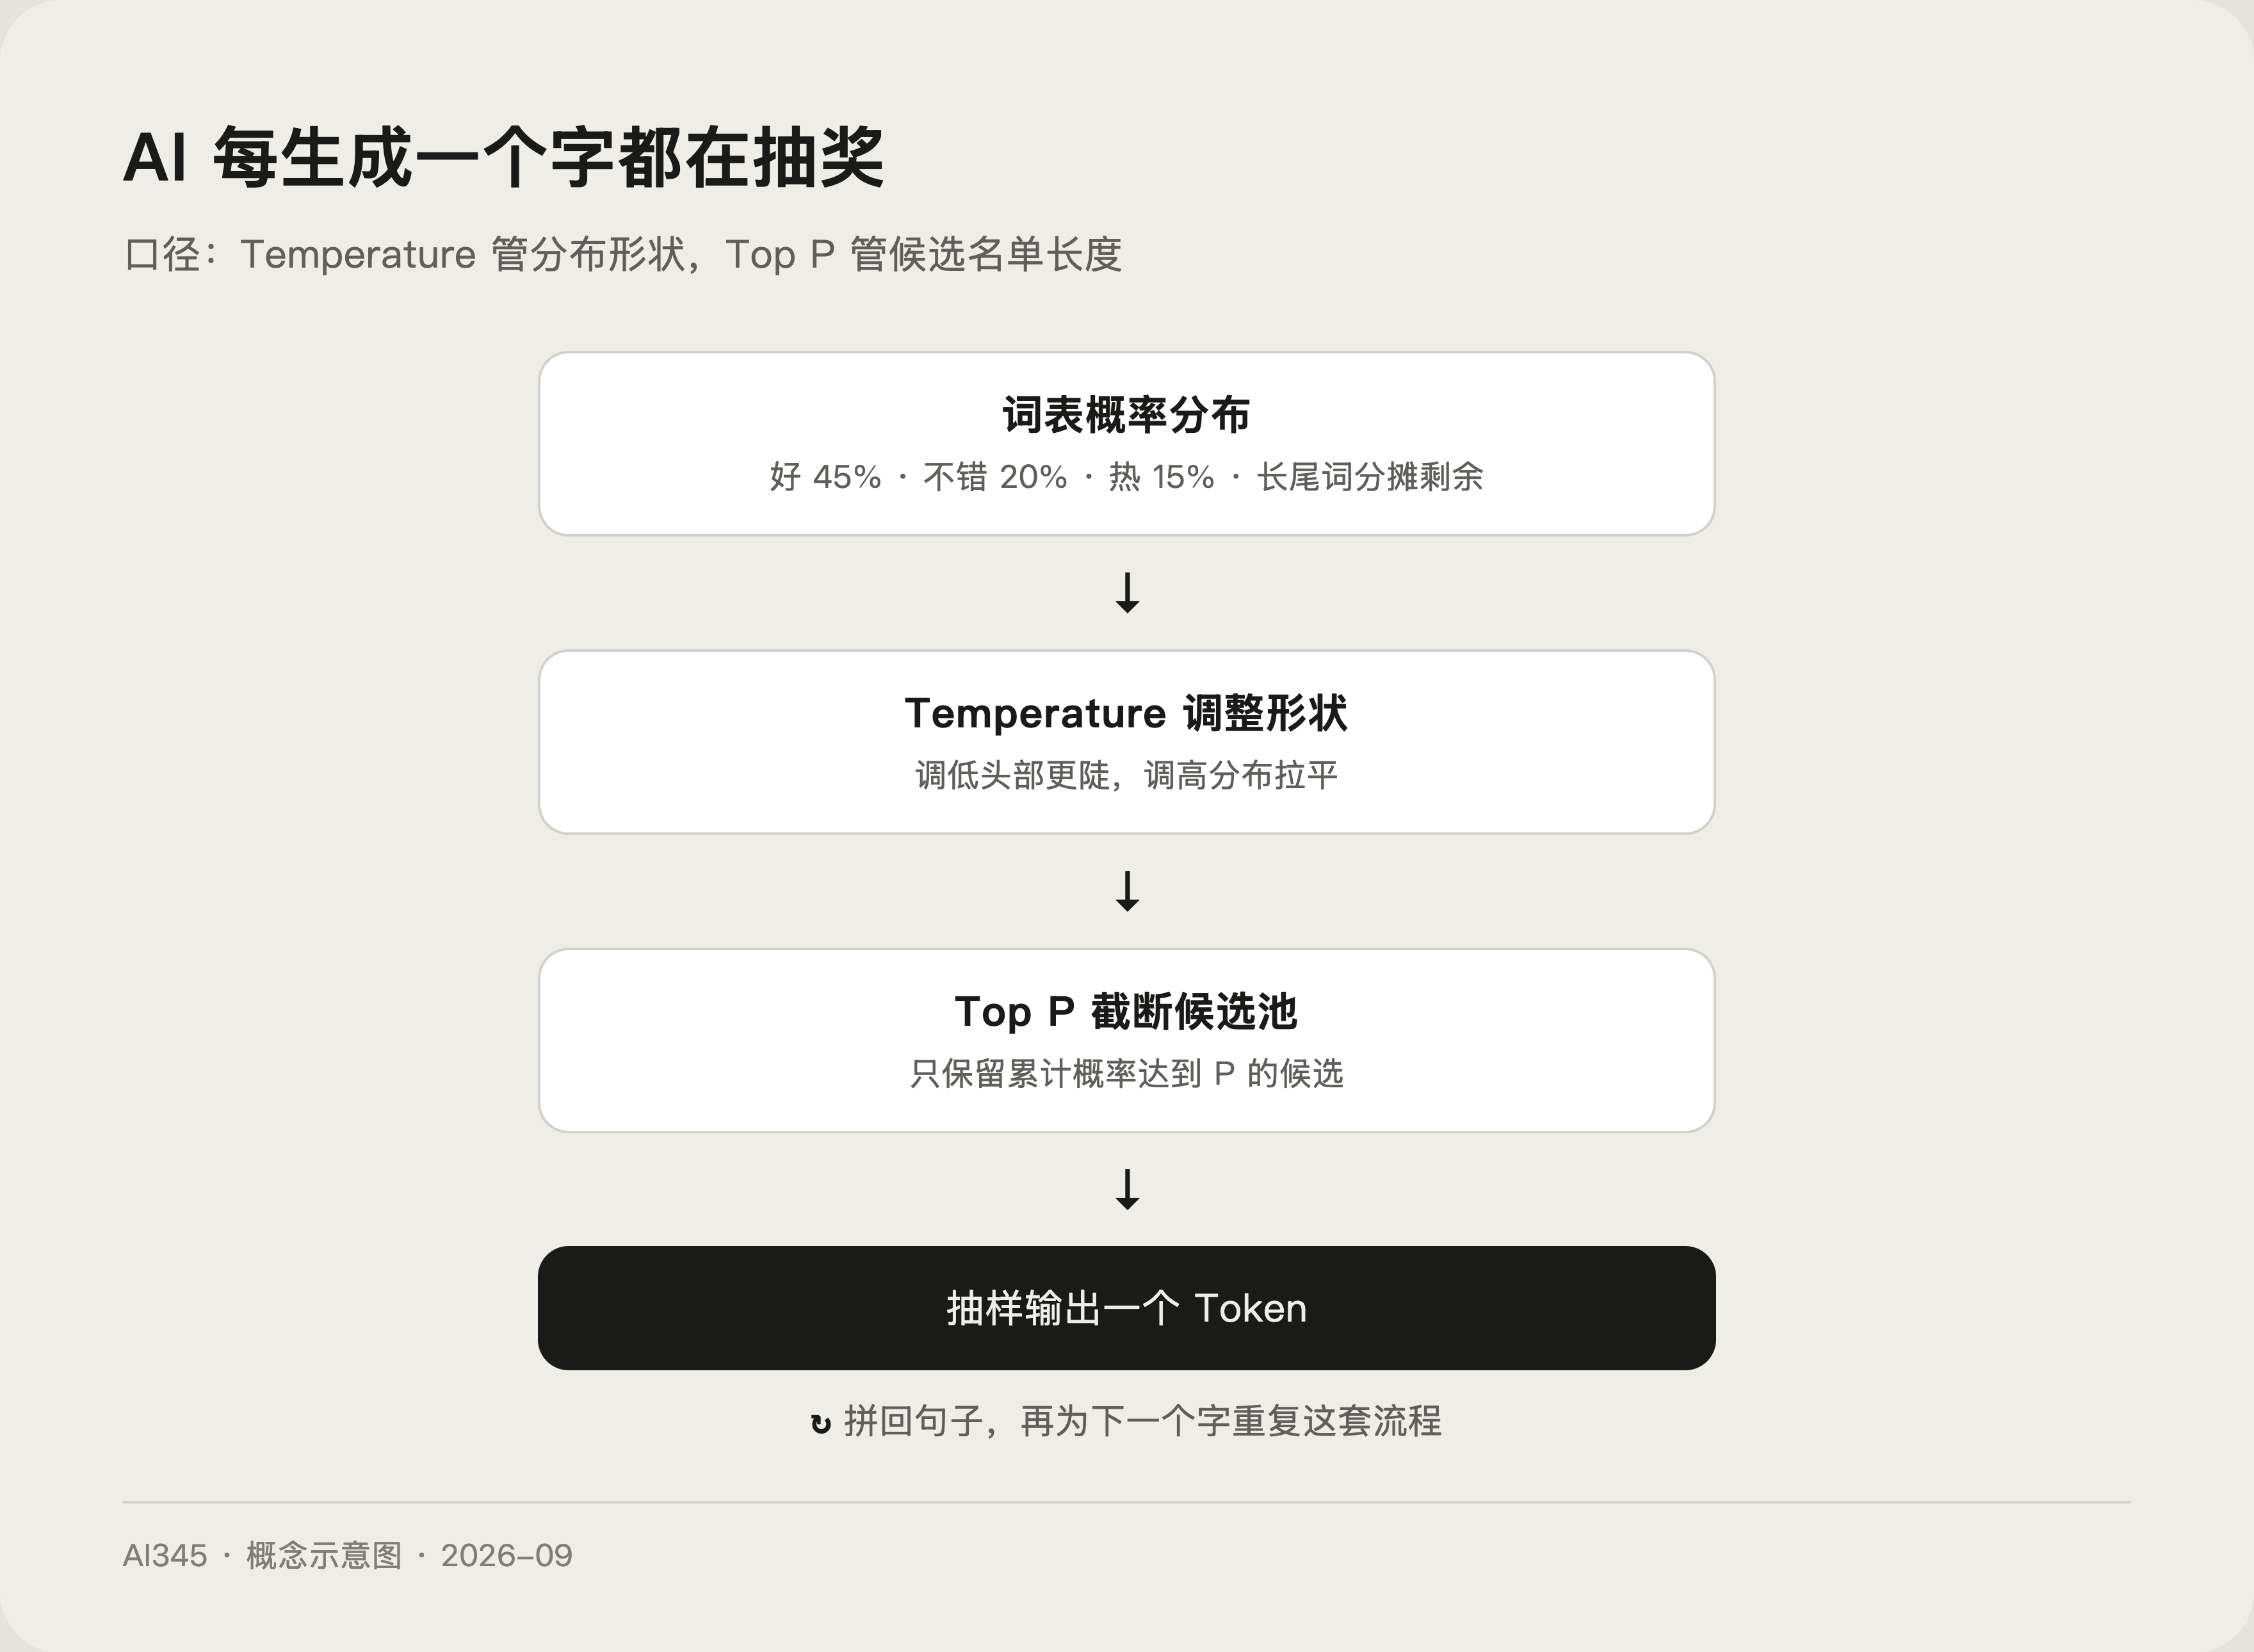
大语言模型生成文字的方式,是每次给词表里所有候选算一遍概率,抽一个出来,拼回句子再算下一个,如此循环。比如「今天天气真」的下一个字,「好」可能 45%、「不错」可能 20%、「热」可能 15%,剩下的概率摊给长尾词。
既然是抽奖,就有抽法问题:永远抽最大的那个最稳,但千篇一律;放开了抽有惊喜,也容易翻车。Temperature 和 Top P 就是控制抽法的两个旋钮,每生成一个 Token 都影响一次。
Temperature:调低变轴,调高变疯
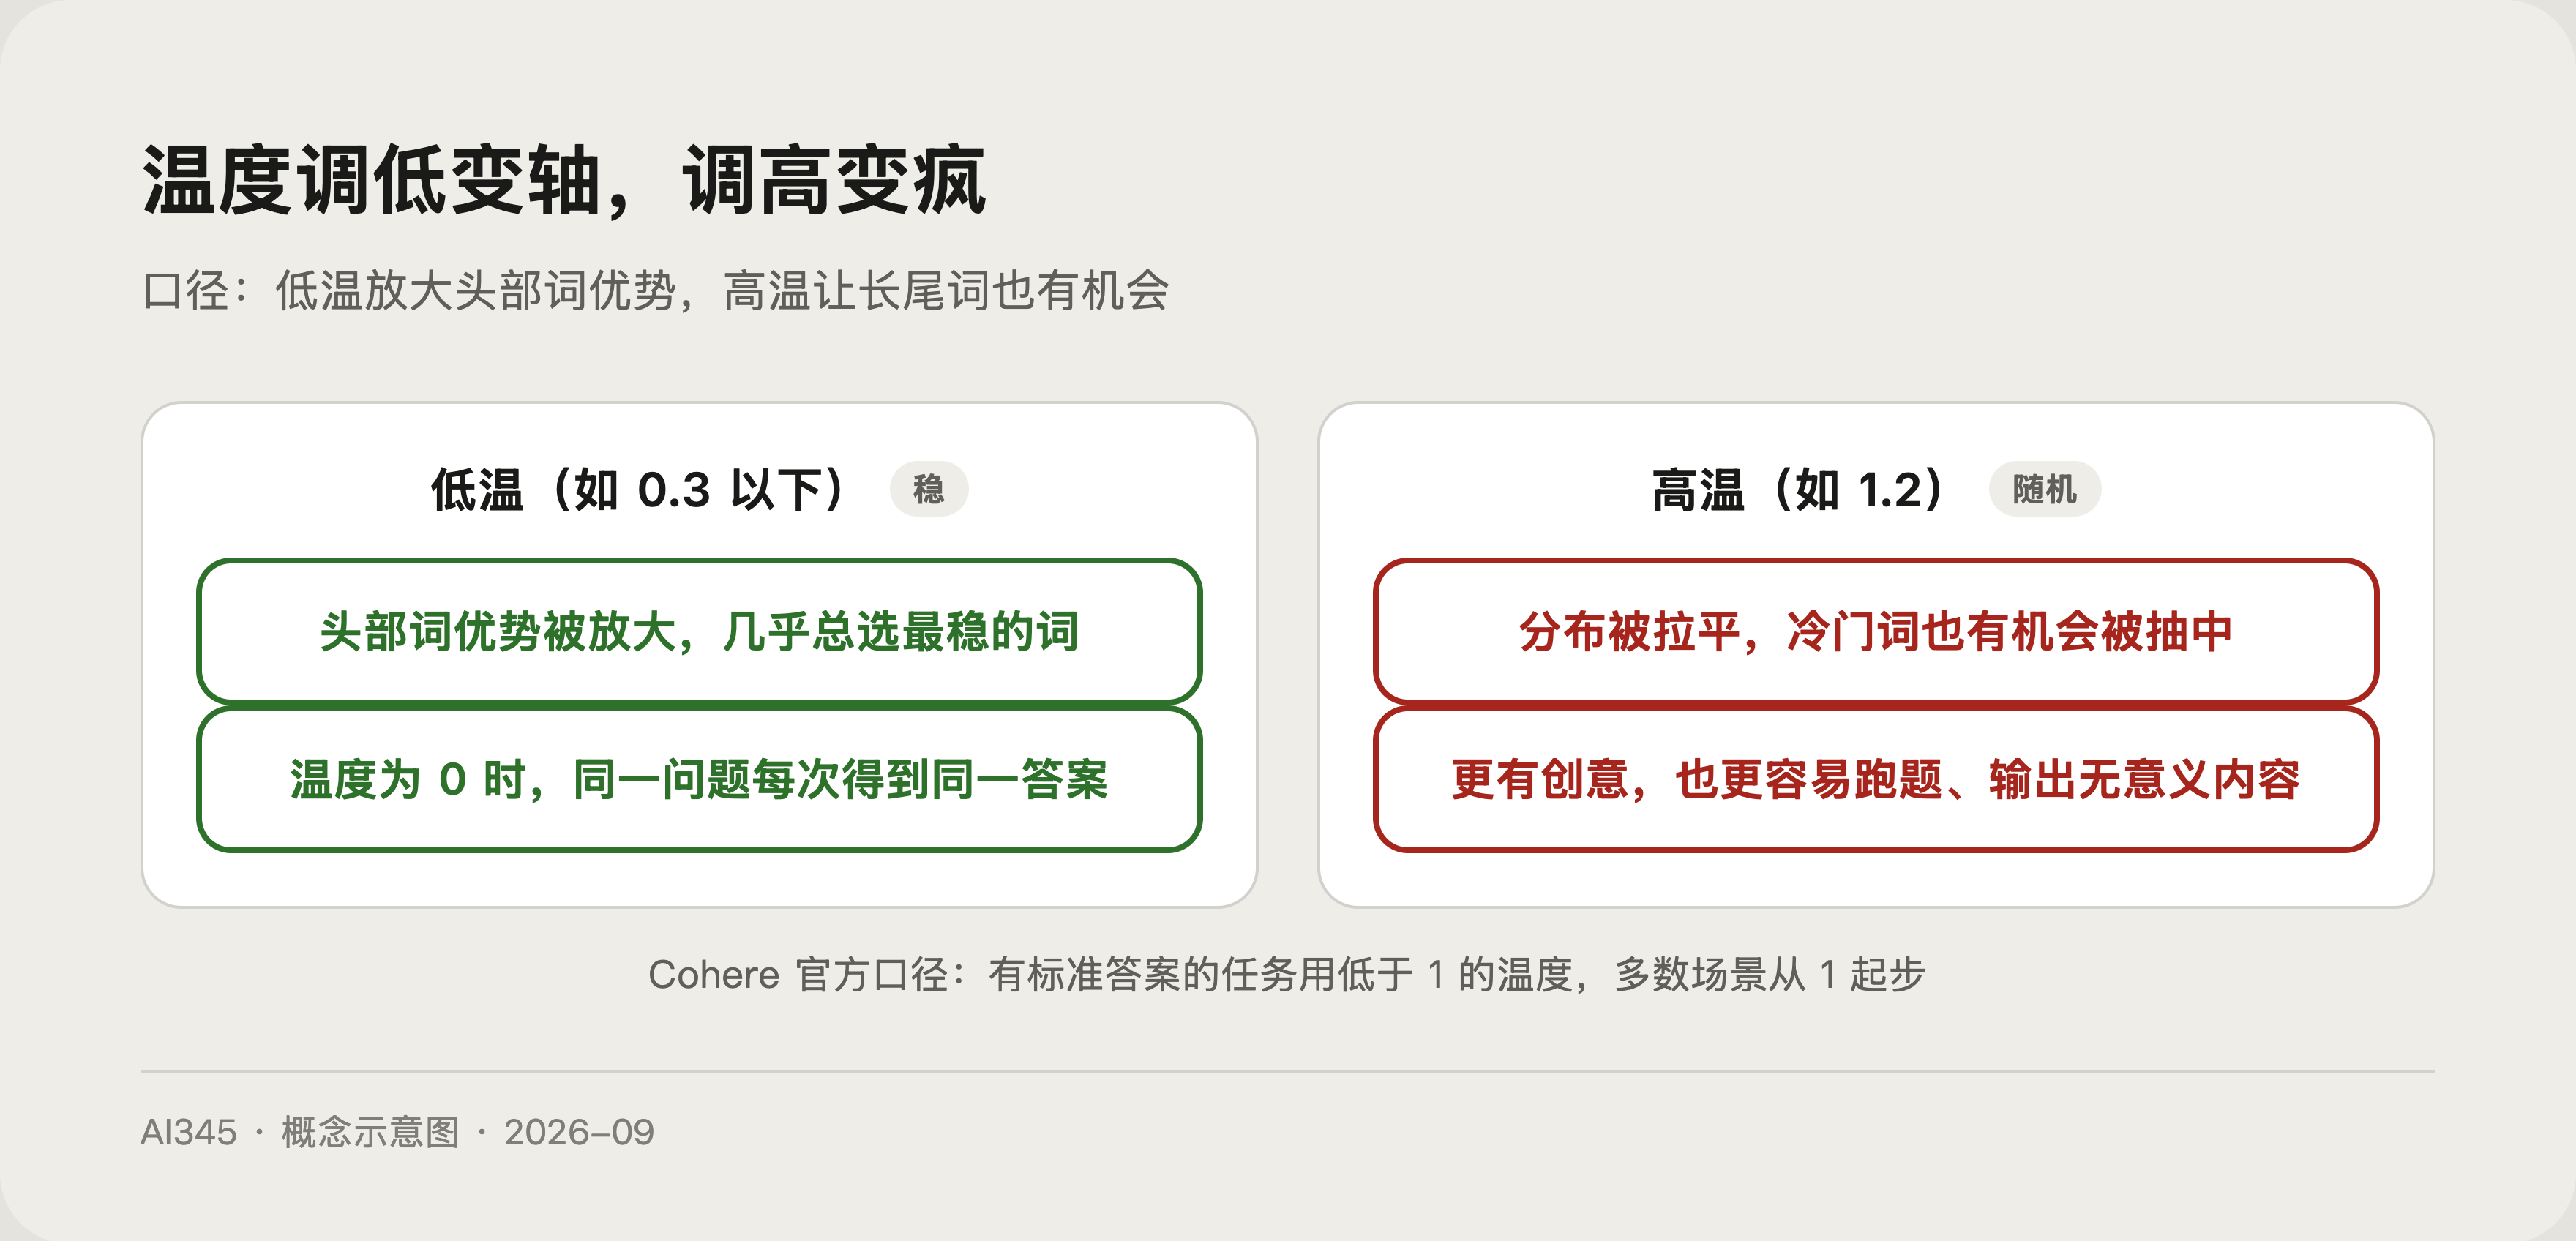
Temperature 的作用是调整概率分布的形状。调低,头部候选的优势被放大,模型几乎总选最稳的词;调到 0,同一个问题每次都得到同一个答案。调高,分布被拉平,冷门词也有机会被抽中,回答更有创意也更容易跑偏。
Cohere 官方文档的口径是:有「正确答案」的任务,比如问答和摘要,适合低于 1 的温度;温度过高会跑题、给出无意义输出,做 RAG 时还会不好好利用你提供的资料;多数场景从 1 起步比较稳。
Top P:只从最靠谱的候选里抽
Top P 也叫核采样,思路不同:先按概率从高到低排队,只保留累计概率达到 P 的那一小撮候选,再从这个池子里抽。Top P 设 0.9,就是只从加起来占九成概率的词里选,长尾冷门词直接出局。
举个具体例子:候选概率是「好」45%、「不错」20%、「热」15%、「糟」10%。Top P 设 0.9 时,凑不满剩余概率的长尾词直接出局;Top P 设 0.5 时,只剩「好」和「不错」两个候选。名单越短,输出越可预测。细节可看 Cohere 的高级生成参数说明。
分工可以这样记:Temperature 改变候选之间的相对差距,Top P 决定候选名单的长度。两者可以搭配,但一般场景调一个就够了,同时大幅调两个,出了问题很难说清是谁的锅。
写作调高、写代码调低的实际影响
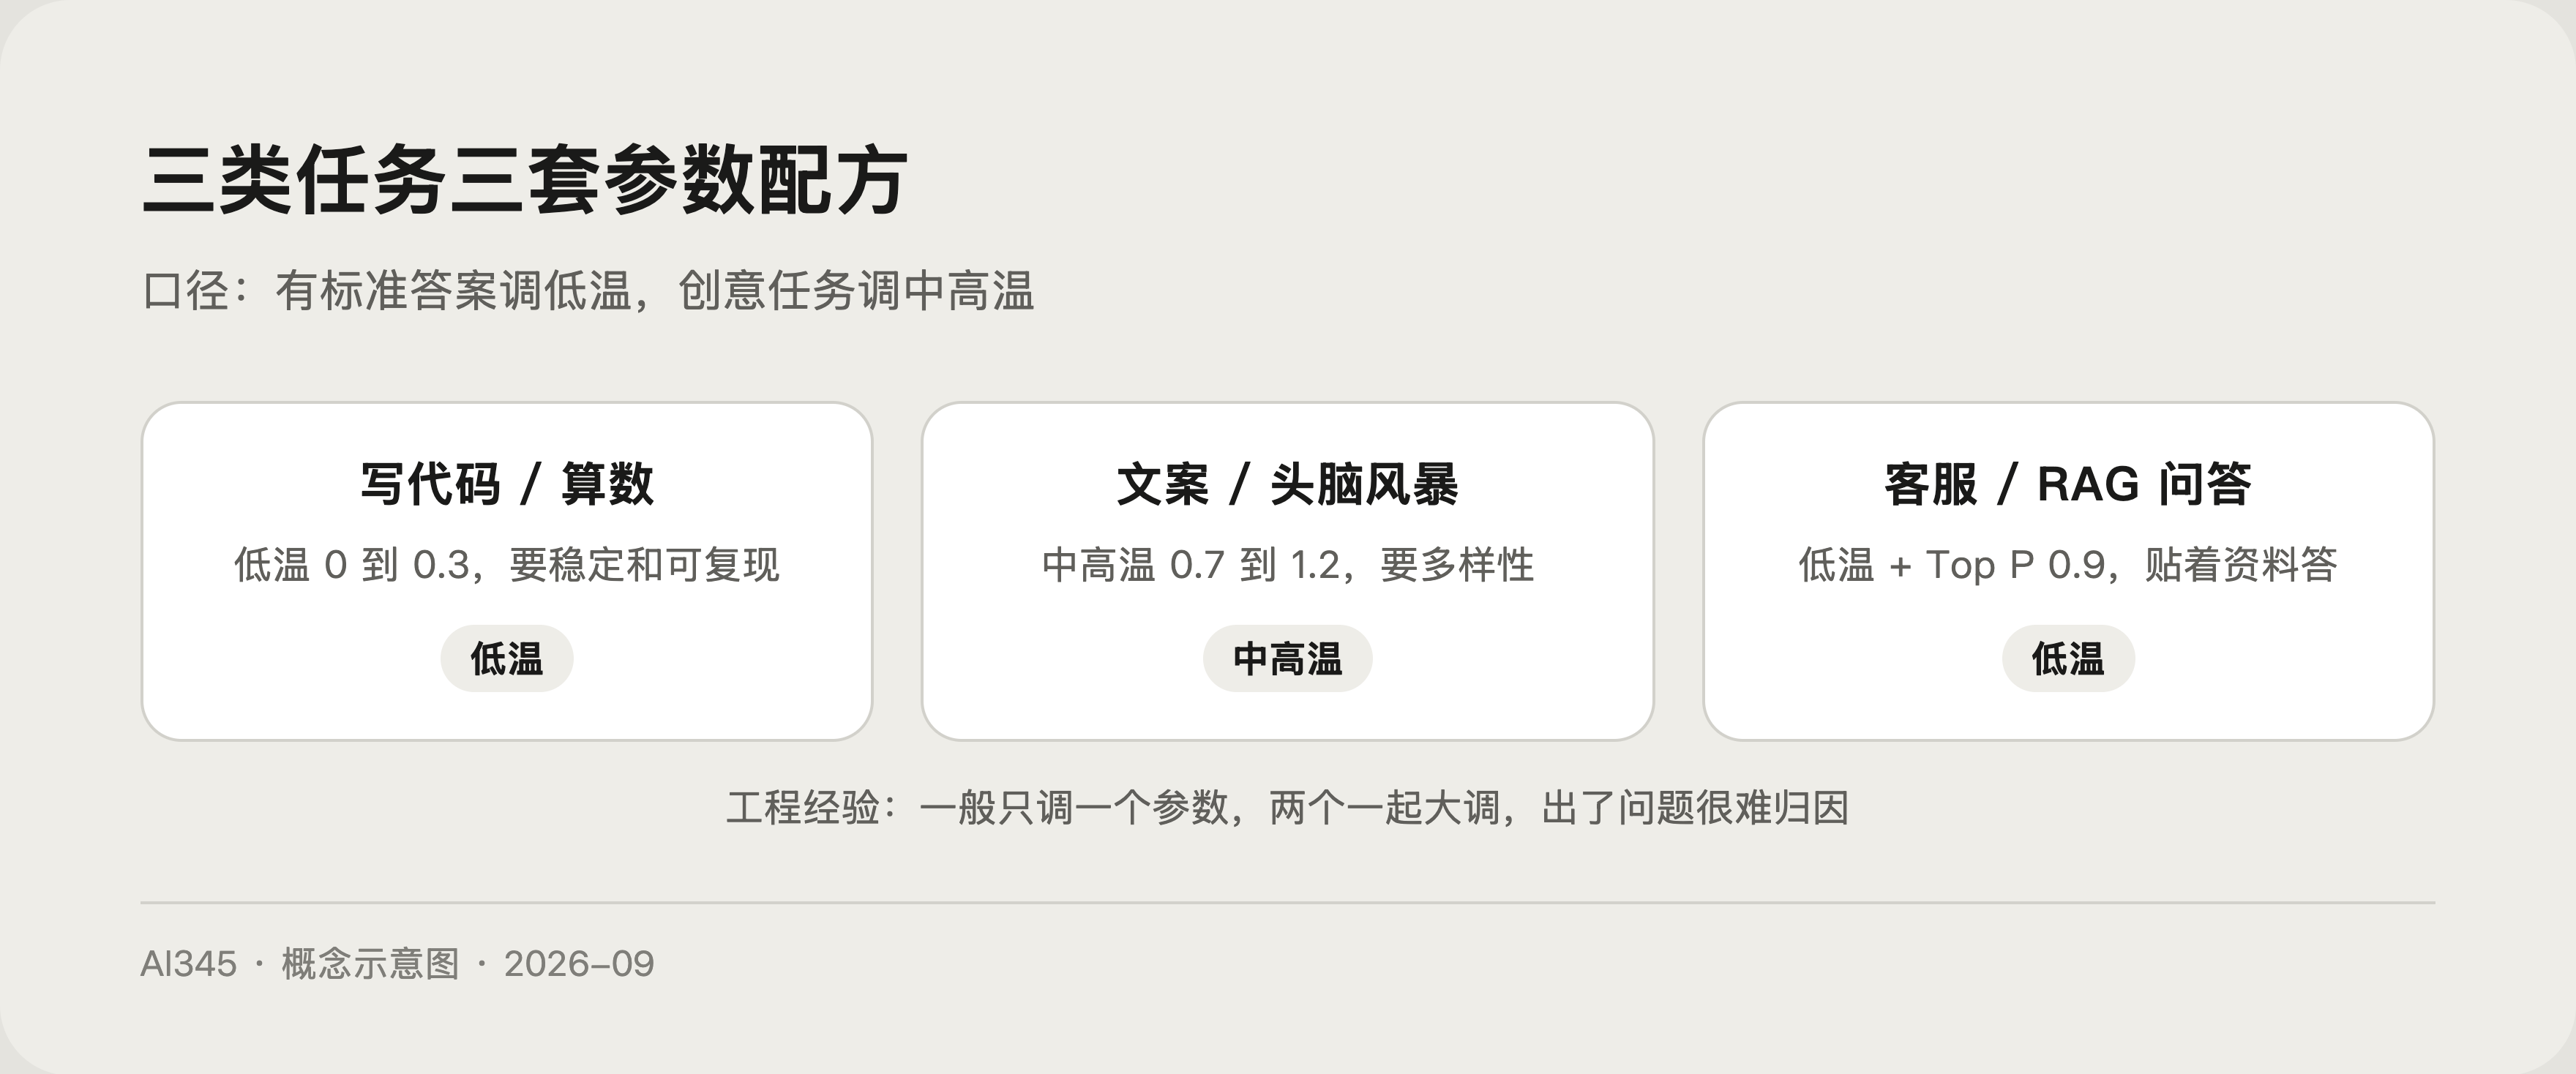
- 写代码、算数、抽取字段:用低温,比如 0 到 0.3。这类任务有标准答案,要的是稳定和可复现,随机性只会带来语法错误和格式跑偏。
- 写文案、起标题、头脑风暴:用中高温,比如 0.7 到 1.2。要的是多样性和惊喜感,温度太低每次都是同一套陈词滥调。
- 客服和 RAG 问答:低温加 Top P 0.9 左右。核心诉求是贴着资料答,不允许发挥,还要配合减少幻觉的手段一起用。
用错参数的典型症状:调 API 时温度设太高,答案时好时坏没法复现;温度设太低,长文写到后面开始复读机式重复。另一个常见误区是把随机性当成模型变笨了,其实参数不改变能力,只改变怎么从能力里抽签。
三个常见调参误区
- 一上来就大调 Temperature:先看默认值下的输出质量,再小幅调 0.2 到 0.3 观察差异,大幅调整容易把问题归因搞混。
- 把随机性当能力问题:回答不稳时先查参数,再怀疑模型,很多「时好时坏」只是温度在作怪。
- 以为参数能救回错误答案:温度只影响「从哪里抽」,不改变「会什么」,答案本身错要靠换模型、换提示词或补资料解决。
一段话讲清这两个参数
「大模型每生成一个 Token 都是在概率分布里抽样。Temperature 控制分布形状,越低越确定,为 0 时输出基本固定;Top P 控制候选池大小,只从累计概率前 P 的词里抽。工程经验是:有标准答案的任务用低温,创意任务用中高温,一般只调一个参数。」
高频追问是「温度设 0 就完全确定吗」。答案是基本确定但不绝对:受浮点精度和并行调度影响,个别情况下仍可能有细微差异,所以关键业务还要靠结果缓存和回归测试兜底。
常见问题
Temperature 和 Top P 要一起调吗?
答:建议先只调一个。两个一起动,效果变化很难归因。常见起点是固定 Top P 0.9,再按任务调 Temperature。
温度越高 AI 越聪明吗?
答:不是。温度只影响随机性,不改变模型能力,温度太高反而容易跑题和胡编。
为什么我的应用每次回答都不一样?
答:默认温度通常大于 0,抽样本身带随机性。想稳定输出,把 Temperature 设为 0 或很低,服务支持的话再固定随机种子。
Top K 和 Top P 有什么区别?
答:Top K 限制候选的个数,Top P 限制候选的累计概率。前者一刀切,后者自适应:分布集中时候选少,分布平时候选多。
聊天产品的默认参数是多少?
答:多数产品默认温度在 1 附近、Top P 0.9 左右,兼顾稳定和自然,具体以各家官方文档为准。
 京ICP备2024094994号-29