
Stable Audio 3.0 更新解读:6 分钟+开放权重
Stable AI 的音频生成模型家族 Stable Audio 3.0 已在 2026 年 5 月 20 日发布,官方随后于同年 8 月 18 日上线 DAW 插件和 StableAudio.com 进阶生成体验。这次更新最值得关注的:曲目长度从 2.0 的最长 3 分钟翻倍到 6 分 20 秒,新增音频转音频,多款模型开放权重。对普通用户和开发者的意义都很大。
如果你之前接的是它的 API,可先参考Stable Audio 3.0 API Key 配置,再看本文的版本背景会更顺。
这次发布的是什么
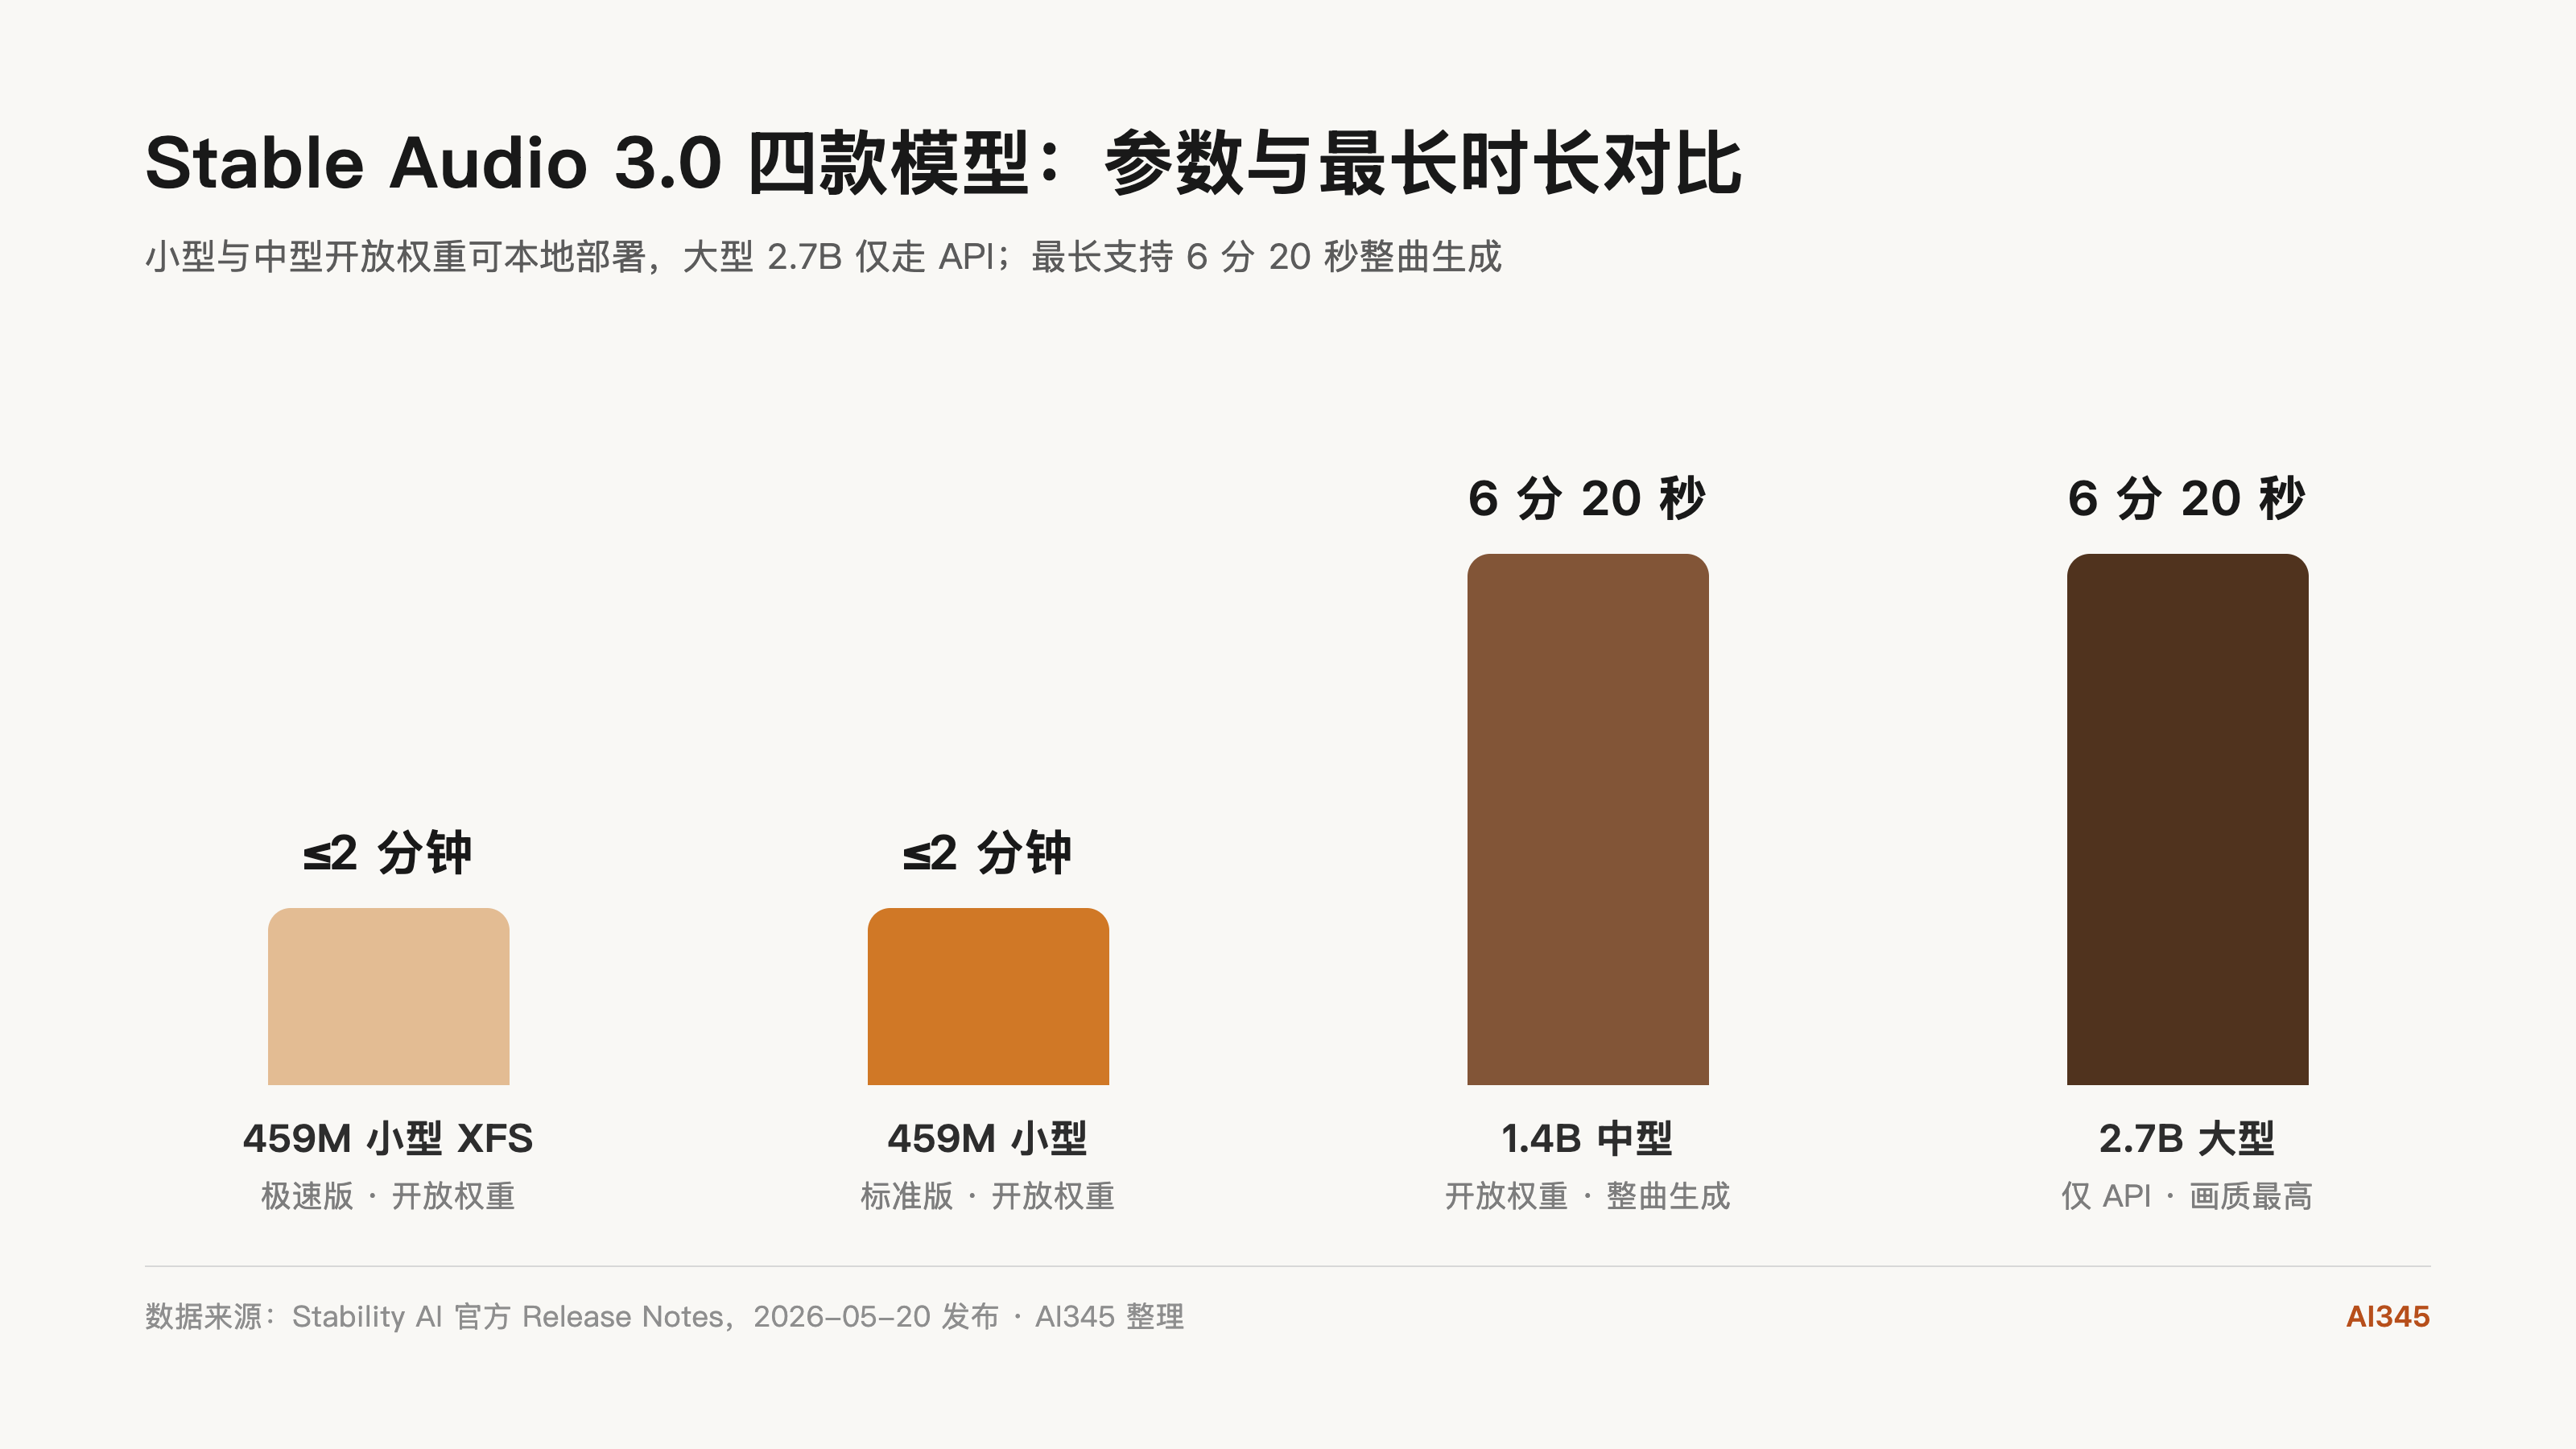
Stable Audio 3.0 不是单款模型,而是一个家族,官方按参数规模出 4 个规格:
- 小型 SFX:459M 参数,面向音效
- 小型:459M 参数,设备端运行
- 中型:14 亿(1.4B)参数
- 大型:27 亿(2.7B)参数
其中两款小型模型面向设备端,可本地生成两分钟以内的声音与音乐;中型和大型模型具备更强的结构控制力,能创作最长达 6 分 20 秒的完整乐曲,并保持音乐结构与旋律基调。这个长度相对 2024 年发布、最长 3 分钟的 2.0 实现了翻倍以上跨越。
。
核心更新点
- 曲目时长翻倍:最长达 6 分 20 秒完整曲目,超过 2.0 的一倍以上,更适合完整编曲与配乐
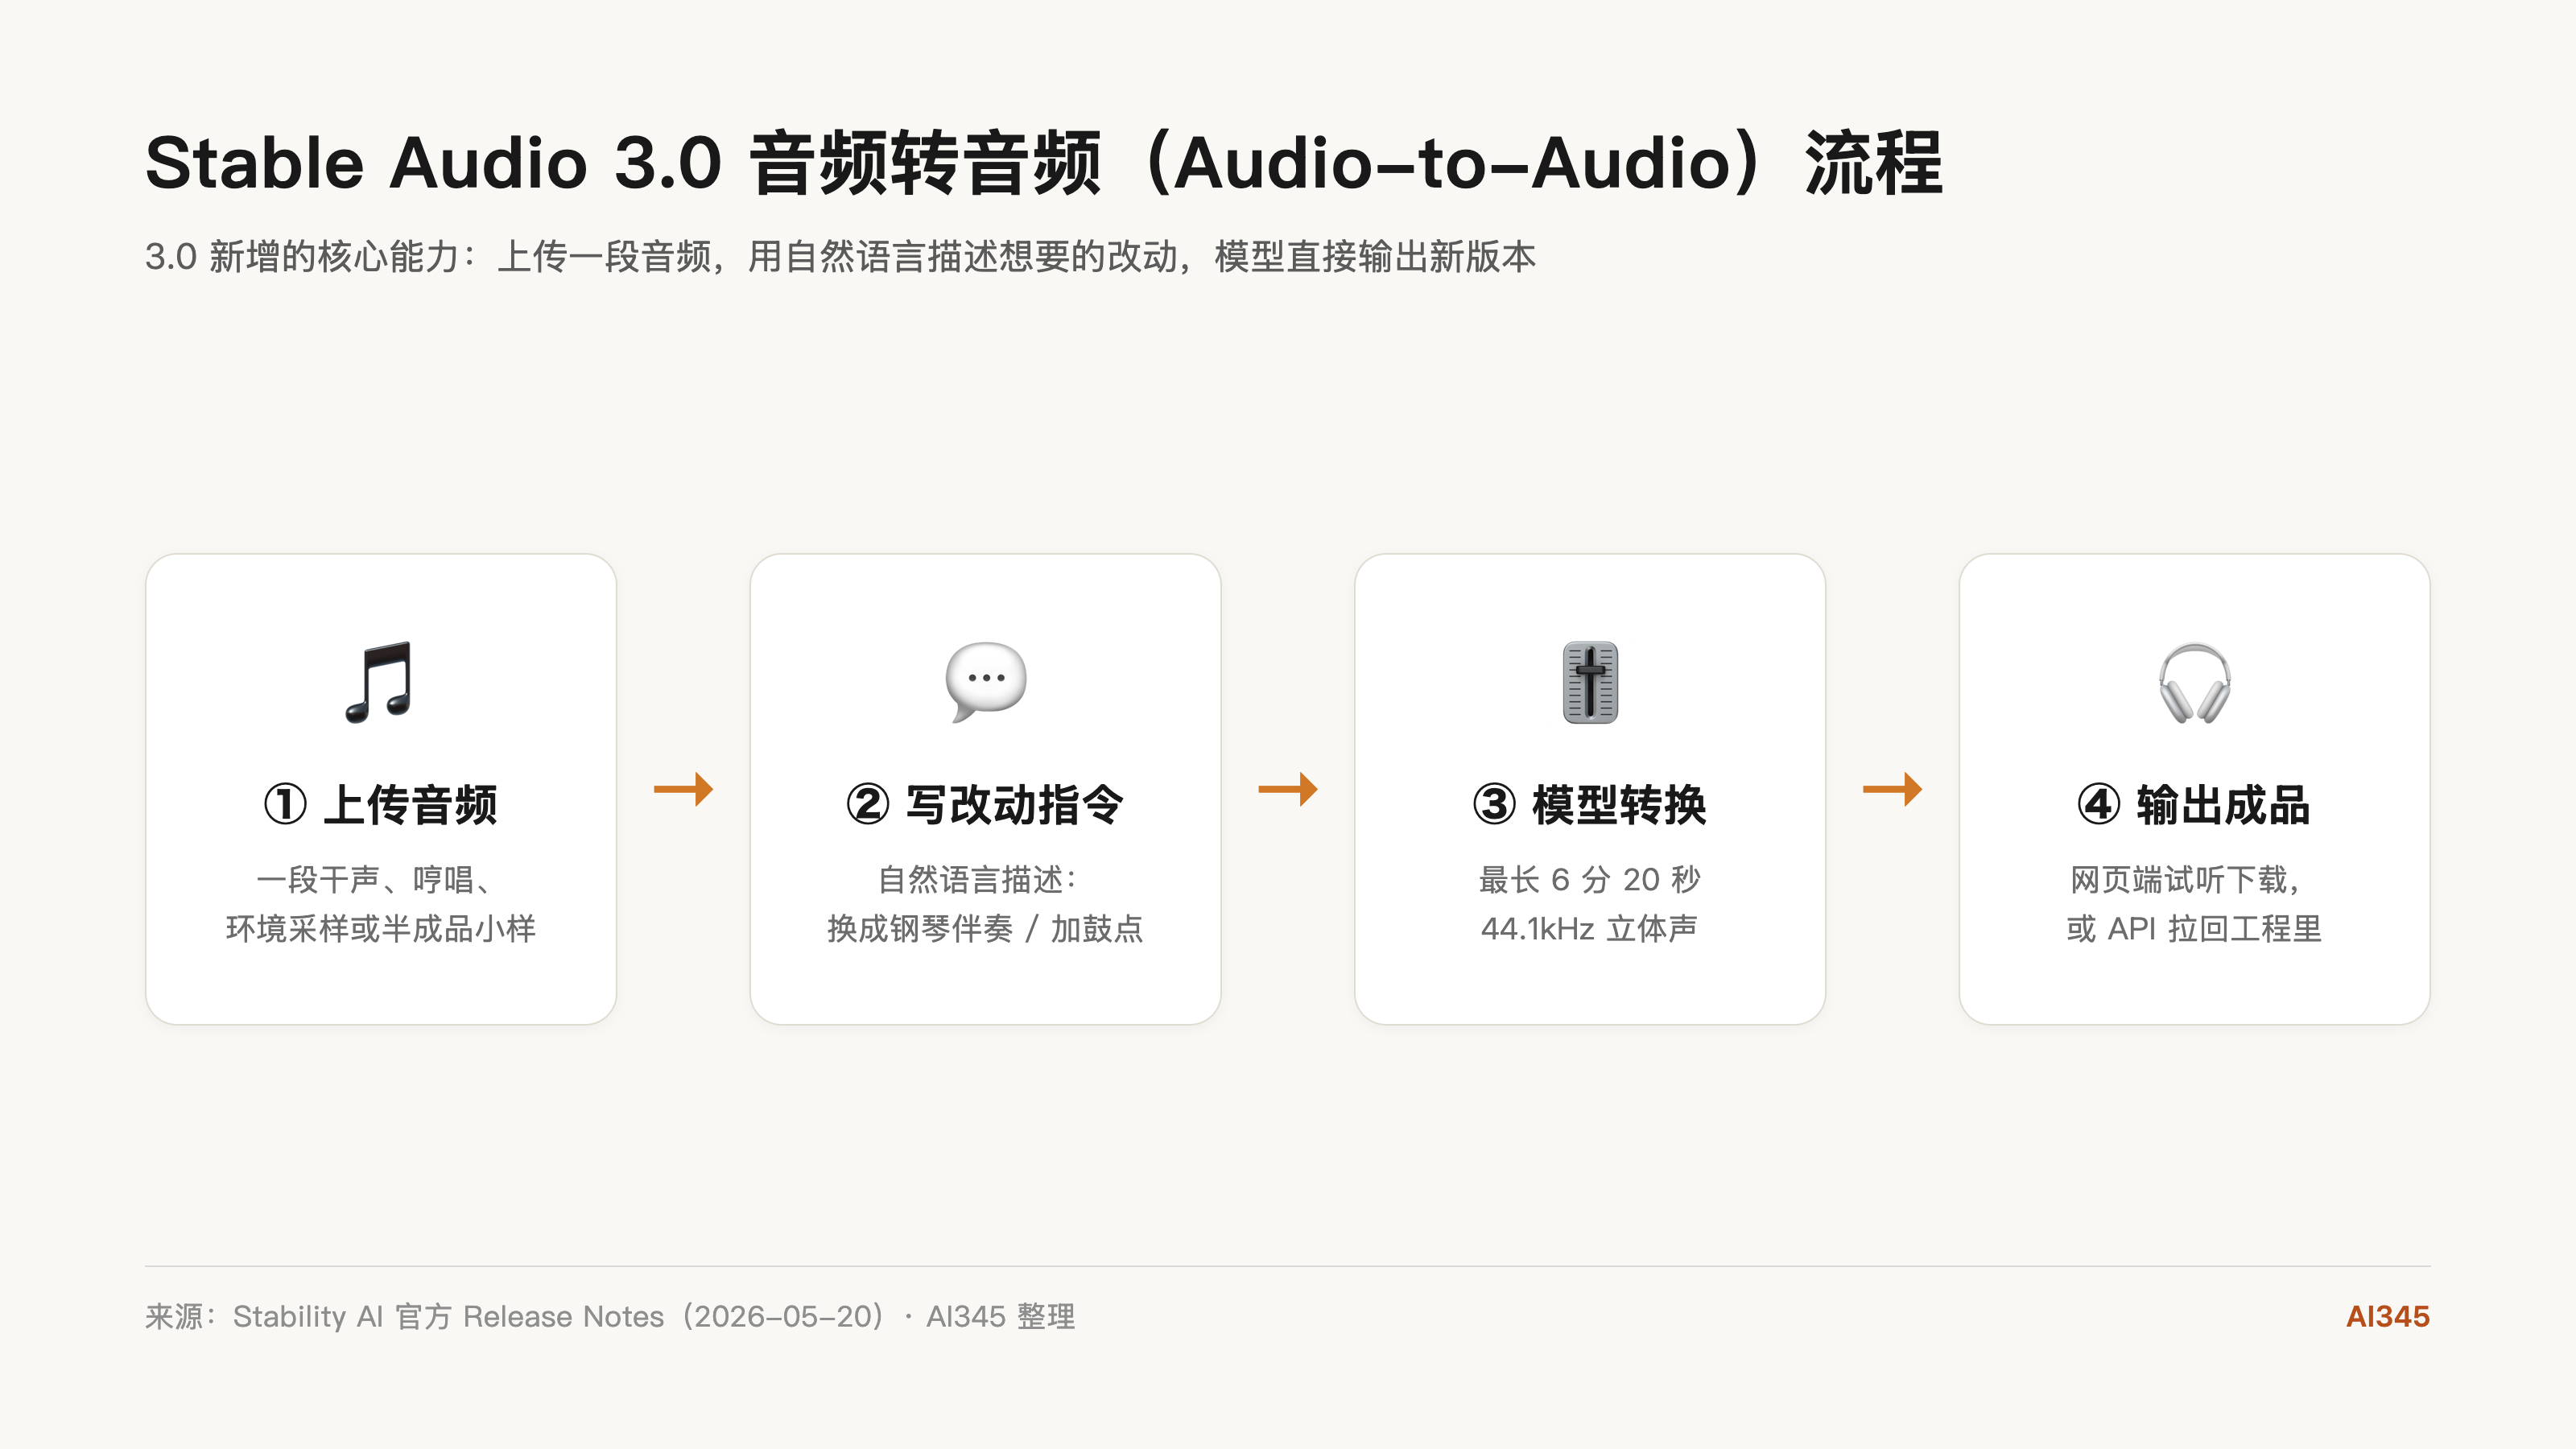
- 音频转音频(audio-to-audio):上传一段音频,用自然语言描述就能变换风格或生成变体,创作卡壳时可以上传 Demo 让模型扩展补全
- 开放权重:小型 SFX、小型与中型模型已开源,可在本地下载并修改权重;最顶尖的大型模型仅通过 API 与付费托管服务提供
- 更快的推理与更高压缩:基于潜扩散架构,音频压缩率做到 4096 倍,消费级硬件就能实时生成,渲染效率较前代提升 300% 以上
对比功能差异可用官方 release note:API 上线等信息在 Stability AI 官方发布说明 都能查到。
授权与价格:谁觉得贵,谁免费
- 声明极小/中型模型已在开源社区开放,大型模型走 API 和付费托管
- 如果企业年营收超过 100 万美元,使用大型模型需购买商业授权
- 个人试用:到 stableaudio.com 免费体验
对想拿去商用又不想买授权的团队,要注意这条营收线,别用完后被授权卡住。具体额度接入方式见我们另一篇免费额度与使用指南。
数据与授权背景
Stable Audio 3.0 全量基于合法授权的 AudioSparx 音乐库数据训练,沿用选择退出机制,并已与华纳音乐集团、环球音乐集团达成授权合作。官方强调会保障创作者获得补偿。
怎么第一时间用上(国内视角)
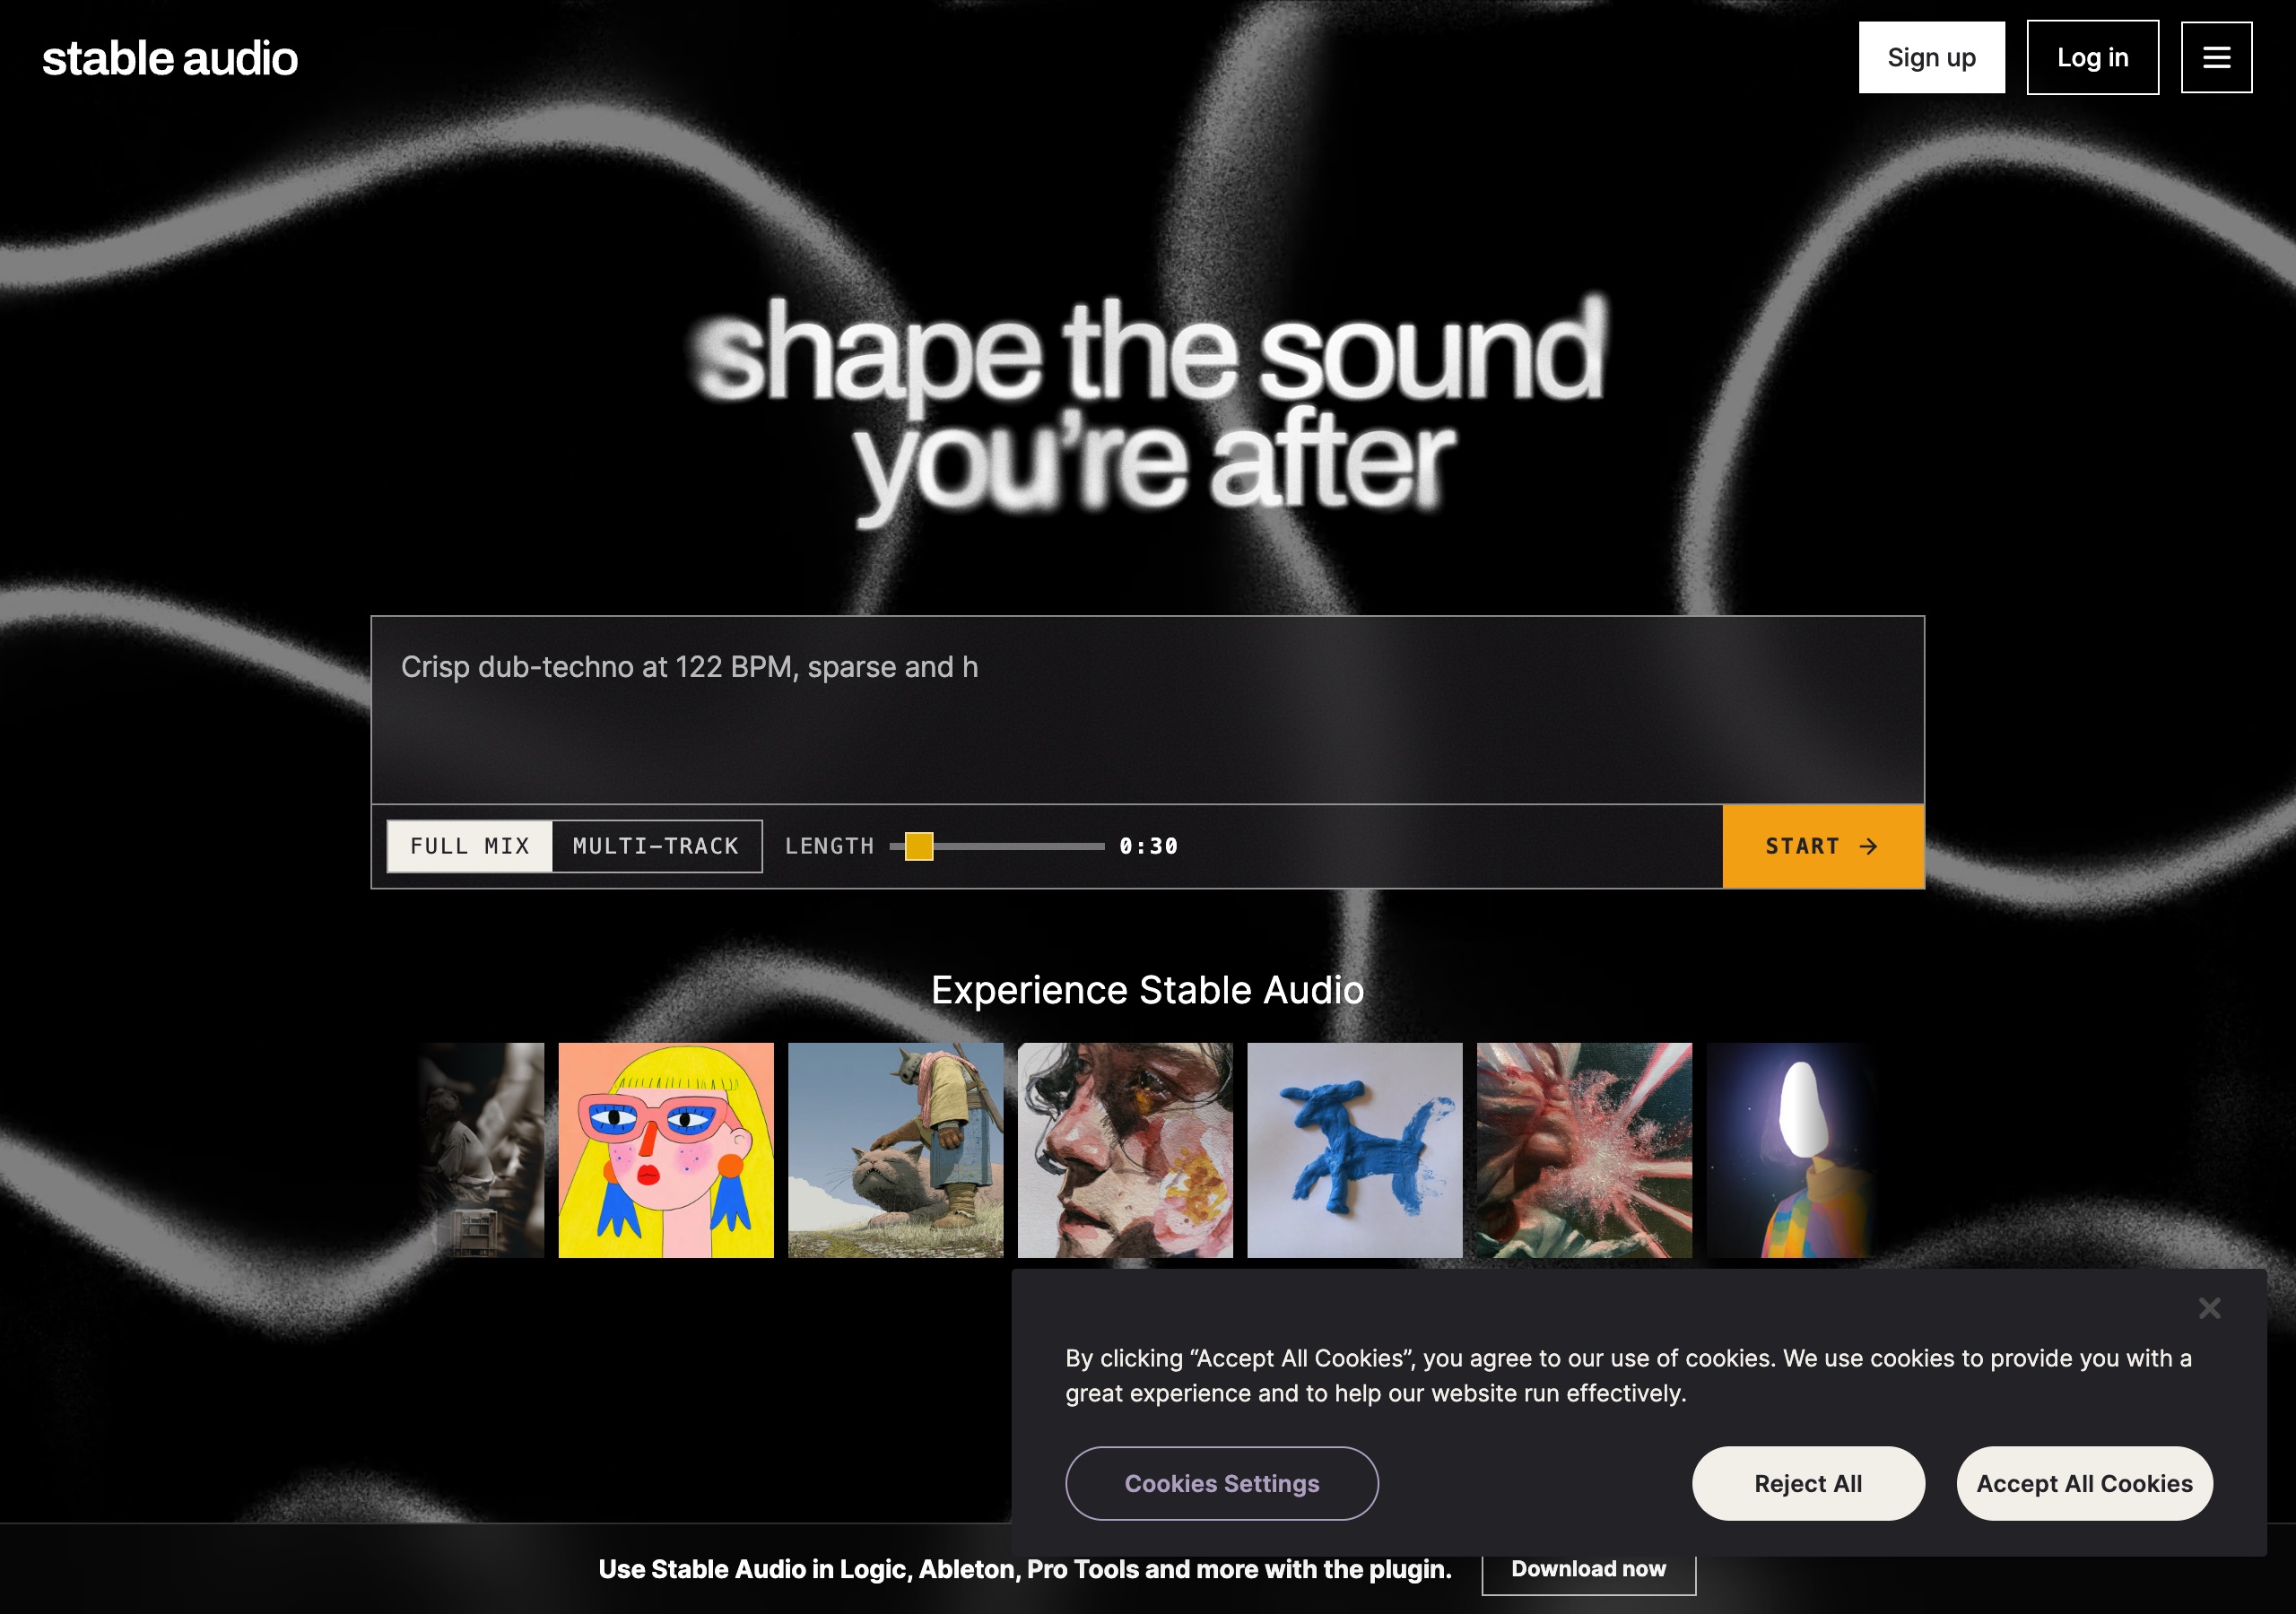
- 免费入口:直接访问 stableaudio.com,注册即可生成,网页版界面有进阶生成体验
- 想要本地跑:小型/中型权重开放,可在 GitHub 上
Stability-AI名下找到模型与推理脚本,配合 8GB 以上显存基本能跑 - 想要接 API:先拿 Key,Key 申请方式看这篇API Key 配置与本地环境搭建
国内访问 stableaudio.com 一般可直连。
具体网络情况详见国内访问实测。
和 Suno 怎么选
同样是 AI 音乐,Suno 强在整首歌的演唱与编曲一体,Stable Audio 强在可控的题材变换、音频转音频与开放权重(可自行微调)。想按风格结构精细控制、或想本地部署的选 Stable Audio;想要成品歌卷上手快选 Suno。详细对比咱们写过一篇Stable Audio 3.0 与 Suno 的完整对比,按场景给建议,不再赘述。
结语
Stable Audio 3.0 的本质变化就三件事:时长翻倍、音频转音频、开放权重。长更适合完整配乐,音频转说让它能续写你的半成品 Demo,开放权重让它能本地部署微调。先在 stableaudio.com 免费跑一遍感受音质,再决定要不要接 API 或下载权重。
署名:AI345
最后更新:2026 年 9 月
常见问题
Stable Audio 3.0 是几点发布的?
答:模型家族于 2026 年 5 月 20 日发布,随后官方开放 API;2026 年 8 月 18 日又上线 DAW 插件与 StableAudio.com 进阶生成体验。
Stable Audio 3.0 能生成多长时间的歌曲?
答:中型和大型模型最长可生成 6 分 20 秒的完整乐曲,小型模型面向设备端,最长约 2 分钟。比 2.0 的最长 3 分钟翻倍。
Stable Audio 3.0 免费吗?
答:stableaudio.com 可免费试用;小型 SFX、小型与中型模型开放权重可本地部署。最顶的大型模型走 API 与托管服务,企业年营收超 100 万美元需买商业授权。
音频转音频是干什么的?
答:上传一段你录的音,结合自然语言描述即可去变换风格或生成变体。写歌卡壳时,可用一段 Demo 让模型补全,扩展前奏、副歌或收尾。
会用到我的 4096 倍压缩吗?
答:不涉及。4096 倍是模型内部的潜在空间压缩率,让消费级硬件能实时生成、渲染更快(较前代提升 300% 以上),你只管输入提示或音频拿结果。
 京ICP备2024094994号-29