
Qwen3.8-Omni-Flash 是什么?1M 上下文音视频 Agent 能力解读
Qwen3.8-Omni-Flash 是千问(Qwen)在 2026 年 9 月 18 日上线的原生全模态模型,也是千问第一个围绕 Agent 能力构建的 omni 模型。它支持文本、图片、音频、视频四种输入,上下文 1M token,输出只有文本;音频输入成本比上一代 Qwen3.5-Omni-Plus 降幅超过 98%。这篇文章把官方规格表、跑分、真实价格和 API 接入方式整理成一份可以直接查的数据清单。
Qwen3.8-Omni-Flash 是什么:一句话定义
一句话说清:它是一个「能听懂、能看懂,然后自己动手」的模型。
过去的多模态模型做的是"理解全模态内容":你给它一段视频,它给你一段描述。Qwen3.8-Omni-Flash 想往前再走一步,变成"规划任务、调用工具、完成创作":你给它一段长视频加一句需求,它自己决定看哪几分钟、调什么工具、最后交出什么结果。
官方在发布说明里把这条路径总结为:音视频从模型的感知输入,变成 Agent 理解环境、开展推理并执行任务的核心载体。这也是它和普通多模态模型最大的区别。
Qwen3.8-Omni-Flash 核心规格一览
下面这张表的每个数字都来自千问官方模型库和阿里云百炼文档,可以直接当作选型依据。
| 规格项 | 官方数值 |
|---|---|
| 上线时间 | 2026 年 9 月 18 日 |
| 输入模态 | 文本、图片、音频、视频 |
| 输出模态 | 文本 |
| 上下文长度 | 1M token |
| 最大输入长度(非思考模式 / 思考模式) | 991,808 / 983,616 token |
| 最大输出长度 | 131,072 token |
| 深度思考 | 默认开启,reasoning_effort 支持 xhigh(默认)、medium、low |
| Function Calling | 支持自定义工具调用 |
| 联网搜索 | 支持,Responses 内置工具为 web_search |
| 上下文缓存 | 支持自动隐式缓存与 Responses Session 缓存 |
| 音频输入语种 | 113 种语言和方言 |
| 多通道音频 | 支持空间音频输入,Chat Completions 通过 use_multichannel 开启 |
| 可用地域 | 华北 2(北京)、新加坡、中国香港、日本(东京)、德国(法兰克福)、美国(弗吉尼亚) |
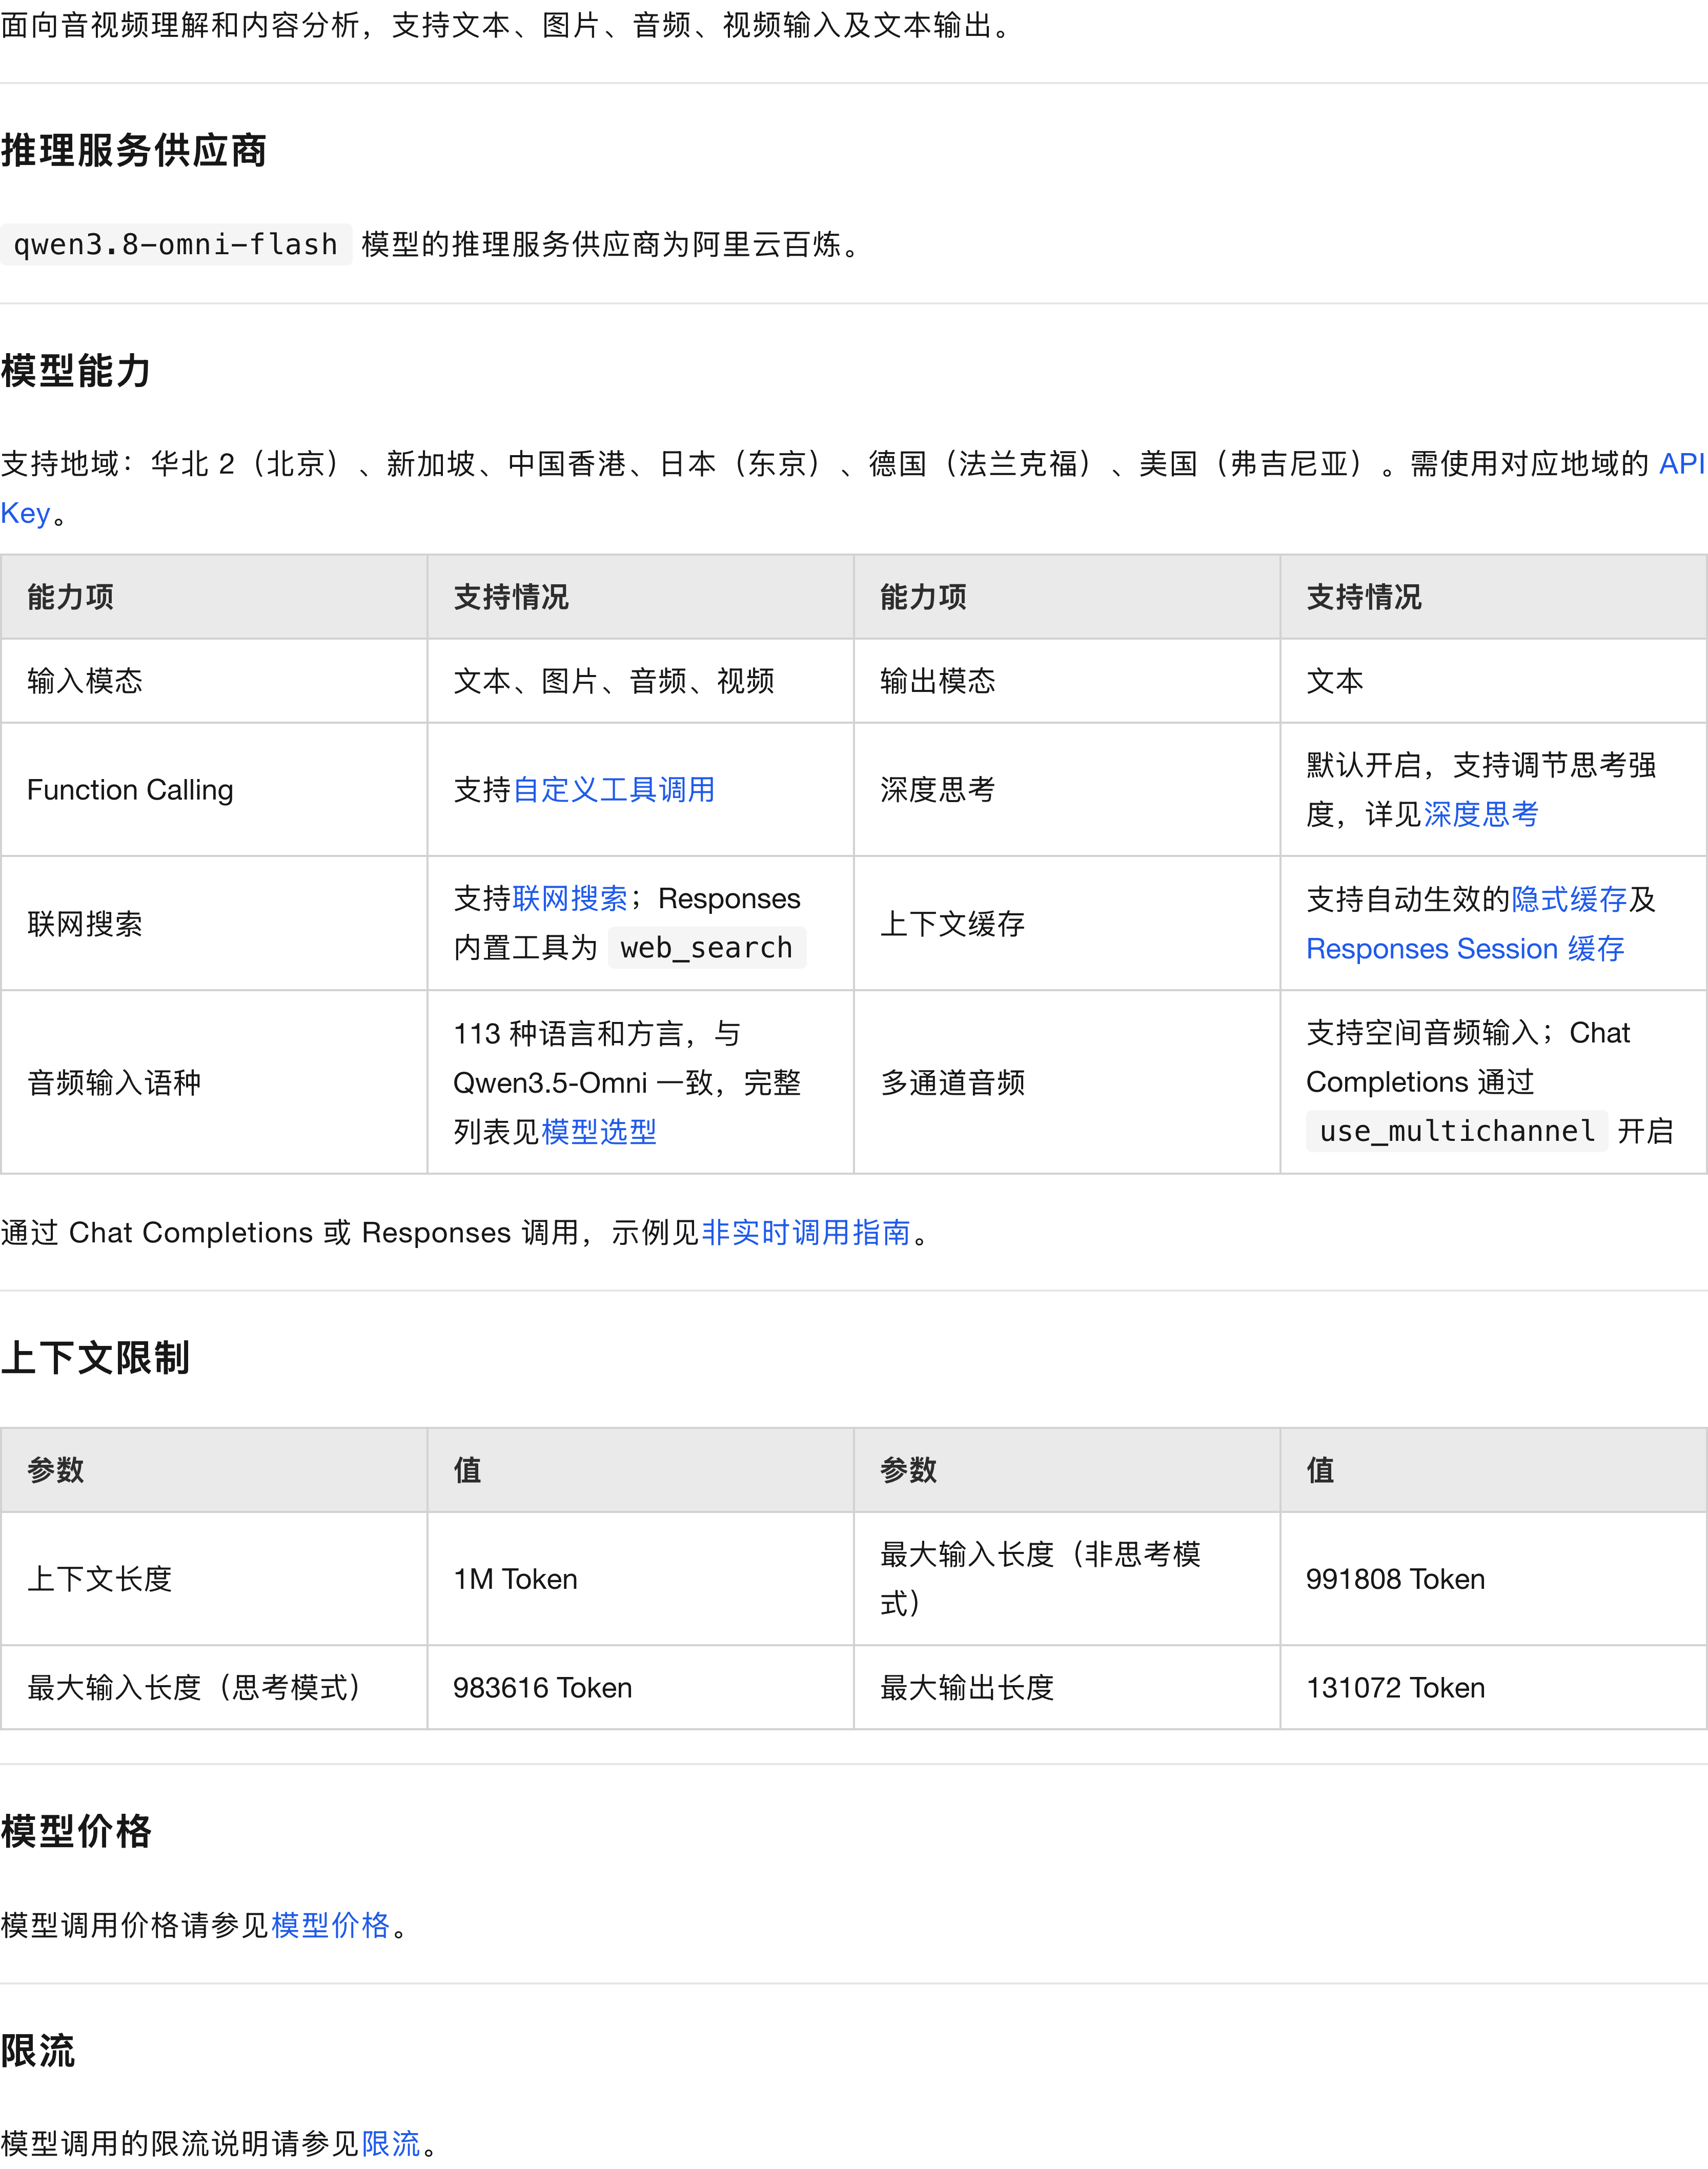
有一处细节值得单独说:模型默认就开着深度思考,而且 preserve_thinking 默认开启。官方给的调法是,需要深挖复杂任务用 xhigh,想省钱提速就降到 low。它意味着你在做成本预算时,思考链路的 token 消耗必须算进去,不能只按输入长度估。
Qwen3.8-Omni-Flash 跑分:能力提升集中在音视频 Agent
官方在 29 项评测上做了对比,相比上一代 Qwen3.5-Omni-Plus 平均得分提升超过 25%。其中最值得看的几条:
| 评测项 | Qwen3.5-Omni-Plus | Qwen3.8-Omni-Flash | 变化 |
|---|---|---|---|
| WildClawBench-MM(多模态工具调用) | 34.5 | 71.0 | +36.5 |
| StreamingBench(音视频交互) | 57.1 | 80.8 | +23.7 |
| AgenticVBench(多模态工具调用) | 14.5 | 36.8 | +22.3 |
| OmniGAIA(联网搜索) | 57.2 | 74.0 | +16.8 |
| LVOmniBench(长视频推理) | 53.2 | 63.3 | +10.1 |
| OmniVideoBench(音视频推理) | 53.8 | 63.4 | +9.6 |
| LongAudioSpan 准确率(长音频推理) | 74.4 | 82.7 | +8.3 |
| AliMeeting cpWER(多说话人识别,越低越好) | 89.61 | 17.18 | 大幅下降 |
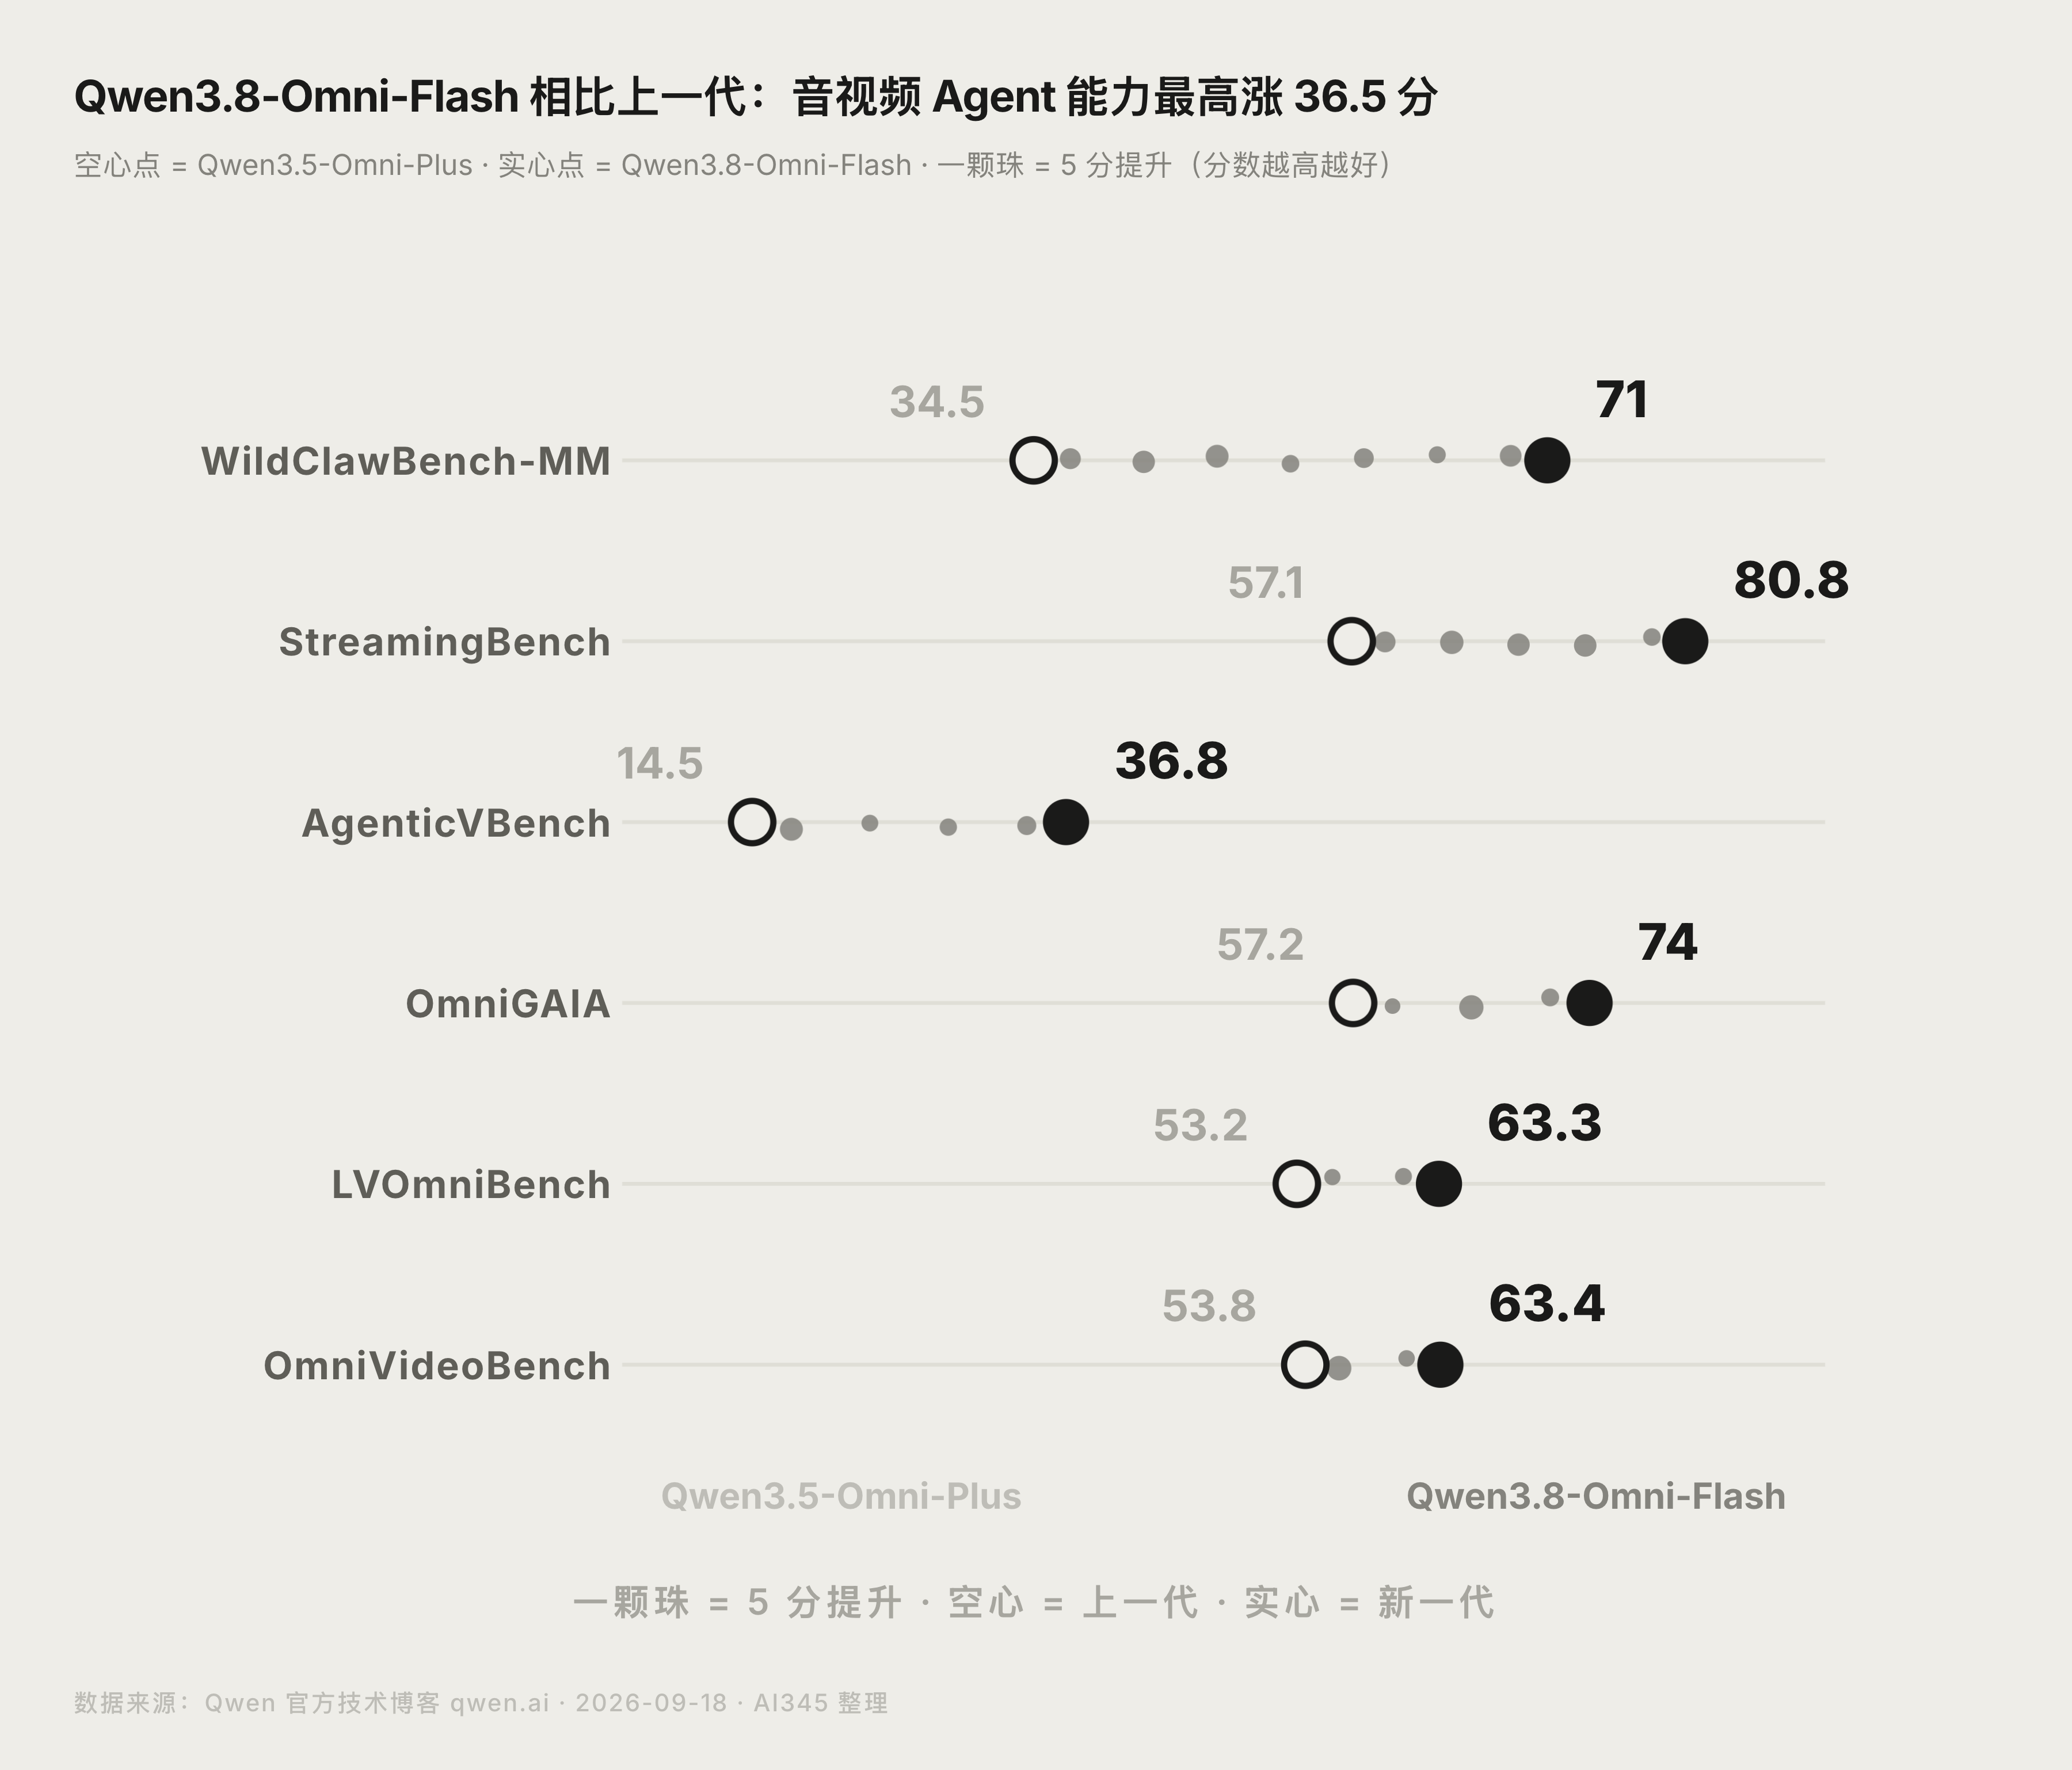
涨幅最大的三项全在 Agent 方向(工具调用、音视频交互、联网搜索),说明这一代的升级重点不是"看得更清楚",而是"更会干活"。AliMeeting 的 cpWER 从 89.61 掉到 17.18,是多人会议这种场景从基本不可用变成了可用,这条对做会议纪要产品的人价值最大。
它同时保留着同尺寸文本模型的能力:LiveCodeBench v6 拿 92.6、SWE-bench Pro 拿 63.3、GPQA Diamond 拿 91.0、IFBench 拿 81.5。也就是说你不必为了全模态能力额外牺牲一个文本模型。
Qwen3.8-Omni-Flash 价格:文本按 token 计费,音视频按小时省
价格是这次最实在的升级。官方口径是:API 每小时音频输入价格降幅超过 98%,每小时音视频输入价格降幅超过 93%。
文本 token 部分,按每百万 token 计算:
| 部署范围 | 输入价格 | 缓存命中输入价格 | 输出价格 |
|---|---|---|---|
| 国际站 | USD 0.15 | USD 0.016 | USD 0.47 |
| 中国内地 / 全球 | USD 0.113 | USD 0.014 | USD 0.382 |
这里的口径要看准:上面是文本 token 的价目,音视频另有一套按素材时长估算的计费方式。官方给出的估算前提是,音频或音视频每小时价格按 2 分钟素材的输入成本乘以 30 计算,音视频采用 720p、1 fps。做预算时这两个口径不能混着算。
它到底能干什么:六个已经跑通的音视频 Agent 场景
官方演示里跑通的不只是"看懂视频",而是一条条完整的生产流程:
- Video2Note(视频转图文笔记):自动梳理知识结构、拆解关键步骤、筛选代表性画面,生成图文对应的 PDF 笔记,把几小时的视频压成可复习的文档。
- Omni Skill Creator(从演示里学技能):录一段操作软件的视频丢进去,它就能把标准作业流程(SOP)提炼成可复用的 Agent Skill。录屏时可以同步解说"为什么这么做",提炼出来的 Skill 会更准。
- Music2MV(音乐视频创作):细粒度理解歌曲的结构、节奏、情绪、人声与乐器变化,输出带时间戳的句级歌词,让歌声、字幕与画面精准对齐。
- 短剧翻译:区分角色的台词识别、口语化翻译、角色克隆配音、音轨重混与成片质检串成一条流程,主打视频出海。
- 长电影解说:长视频全模态理解、关键情节提炼、解说规划、配音配乐、剪辑渲染与成片质检,还能自动穿插电影原声对白与解说配音。
- 长会议从记录到执行:原生支持最长一小时音视频输入,端到端完成说话人切分、内容转录与身份对应,再输出纪要、待办和风险,必要时继续调工具发邮件。
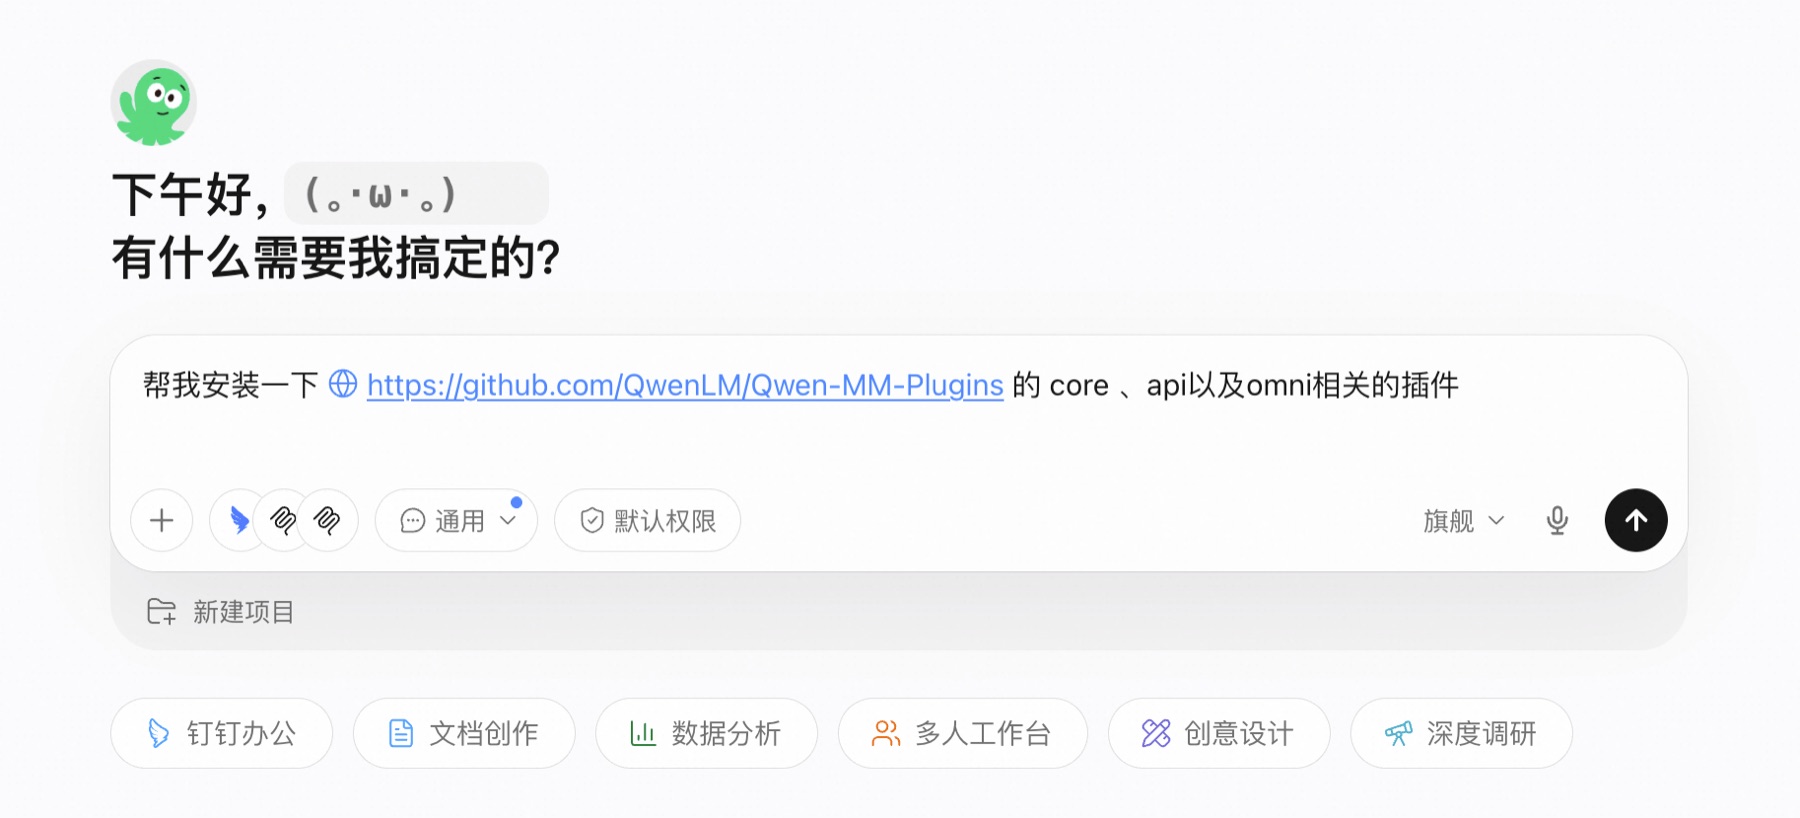
配套还开源了两个东西:Qwen-MM-Plugins 给 Agent 装多模态能力,支持 Codex、Claude Code、Qwen Code、Gemini CLI、Qoder、CodeBuddy、OpenClaw 等;Qwen-Live Harness 面向实时、持续的全模态交互。想自己搭音视频 Agent 流程的,这两个仓库是起点。
Qwen3.8-Omni-Flash 和 Gemini 3.8 Flash 怎么选
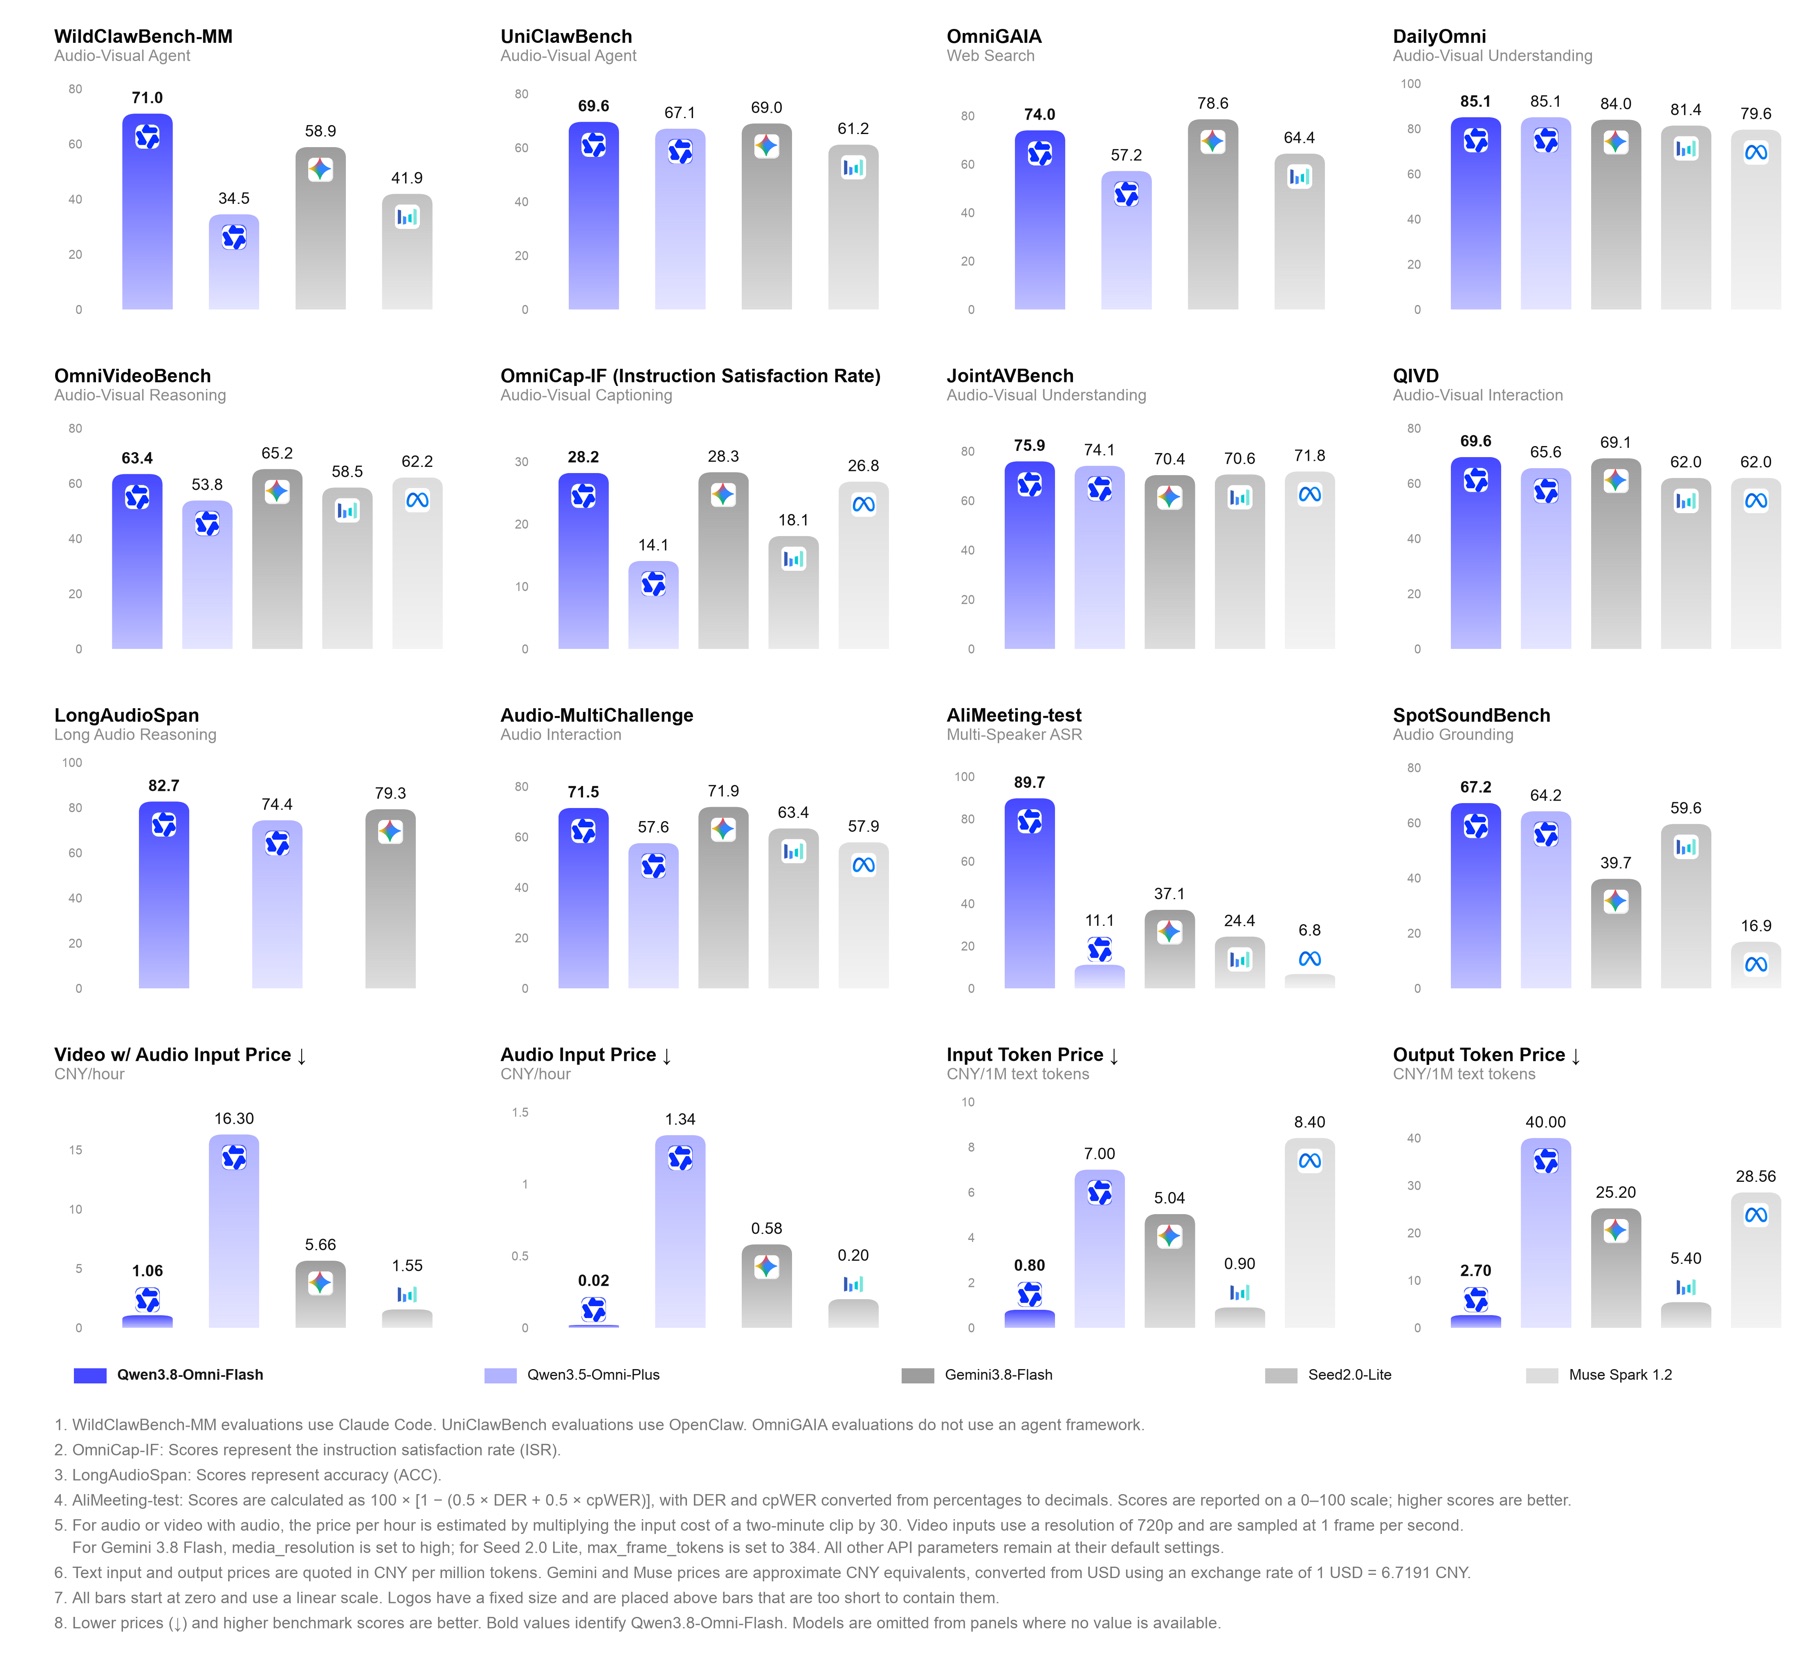
官方自己的表述是:音视频能力接近 Gemini 3.8 Flash,音频能力整体超过。把完整对照表拆开看,这个说法是准确的,但两家的强弱项很分明:
Qwen 明显领先的地方:多说话人识别(AliMeeting cpWER 17.18 对 53.1)、AISHELL-4(11.2 对 56.9)、音乐理解(MuchoMusic-RUL 72.6 对 53.7)、多模态工具调用(WildClawBench-MM 71.0 对 58.9)。
Gemini 仍然领先的地方:多模态工具调用 AgenticVBench(45.0 对 36.8)、联网搜索 OmniGAIA(78.6 对 74.0)、长视频推理 LVOmniBench(70.7 对 63.3)、音视频推理 Video-MME-v2(71.0 对 65.0)。
所以选型逻辑很清楚:做会议、语音、音乐、中文方言这类音频密集型任务,Qwen 更划算;做长视频理解、实时联网检索这类任务,Gemini 还是更强的一侧。想看同类评测方法论,可以对照我们整理的 AI Agent 评测指南,里面的指标口径和基准选取逻辑同样适用于全模态模型。
Qwen3.8-Omni-Flash 怎么接入:三种调用方式
模型兼容 OpenAI 规范的 Chat Completions 与 Responses 接口,接入成本和普通文本模型基本一致。下面是最小可运行示例,图片和音频可以同时传:
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image_url", "image_url": {"url": "https://example.com/frame.jpg"}},
            {"type": "input_audio", "input_audio": {"data": "https://example.com/clip.wav", "format": "wav"}},
            {"type": "text", "text": "这段素材里讲了什么,关键步骤在第几秒?"},
        ],
    },
]

completion = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=messages,
    extra_body={"enable_thinking": True},
    reasoning_effort="xhigh",
    stream=True,
)

for chunk in completion:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
三种接入方式各有用处:
- Chat Completions:最省事,适合把图片、音频、视频一次性塞进去做理解和分析。
- Responses:想用内置的 web_search 联网工具,或者需要 Session 级上下文缓存,走这条。
- Qwen3.8-Omni-Flash-Realtime:面向实时音视频流,边说边感知边响应。官方实测音频输入 6 秒场景的首 token 延迟约 591 毫秒,音视频 6 秒场景约 838 毫秒。做实时客服、口语陪练、导航这类场景用它。
想横向了解多模态模型怎么选,可以顺带看 微信开源多模态嵌入模型 WeMM-Embedding 的对比;如果拿到模型之后要接进编程 Agent,Everything Claude Code 完整教程 里的插件装配思路可以直接复用。
三个容易被误读的点
这三条是官方宣传里最容易让人预期错位的地方,选之前先清楚:
第一,输出只有文本,它不会直接给你成片。 它能做的是理解素材、制定剪辑安排、调用工具链;真正截取、排列、导出还得靠剪辑软件和上层应用。官方演示的 MV、解说、翻译成片,都是"模型加插件加 Harness"的组合结果,不是模型单独吐了一个视频文件。
第二,1M token 不等于 1M 汉字,也不等于任意长度视频都能读全。 token 是模型处理信息的单位,中文大致 1 个汉字对应 1 到 2 个 token 不等,叠加音视频帧的消耗,实际可用长度要打折扣。
第三,文本 token 价和音视频时长价是两套账。 只盯着"输入 USD 0.113/百万 token"会严重低估长视频场景的成本,音视频部分要按每小时口径单独算。
这三个点想明白,再决定要不要把它放进你的产品链路,会少踩很多坑。
总结
Qwen3.8-Omni-Flash 的价值不在"又一个多模态模型",而在于它把音视频从感知输入变成了 Agent 的执行载体:1M 上下文让它能装下长素材,Agentic 能力让它能自己规划取证,98% 的音频降幅让它终于能被规模化调用。
如果你的产品里涉及会议纪要、课程切片、短剧出海、长视频解说这类音视频长流程工作,它是目前中文生态里最值得先跑一遍的原生全模态模型。跑之前记住三件事:输出只有文本、token 不等于汉字、音视频计费另算一套账。
参考来源
- Qwen 官方技术博客:Qwen3.8-Omni-Flash 发布说明
- 阿里云百炼:qwen3.8-omni-flash 模型说明
- Alibaba Cloud Model Studio:模型定价页
- Qwen-MM-Plugins 开源仓库
最后更新时间:2026 年 9 月 20 日 · 作者:AI345
常见问题
Qwen3.8-Omni-Flash 是什么时候发布的?
答:2026 年 9 月 18 日。千问官方博客和阿里云百炼模型库都在当天更新了 Qwen3.8-Omni-Flash 的说明,同步上线的还有实时版本 Qwen3.8-Omni-Flash-Realtime。
Qwen3.8-Omni-Flash 免费吗?
答:不免费,走阿里云百炼按量计费。国际站文本输入 USD 0.15 每百万 token、输出 USD 0.47 每百万 token;中国内地输入 USD 0.113、输出 USD 0.382。音视频输入按素材时长单独估算,比上一代便宜 93% 以上。
Qwen3.8-Omni-Flash 支持多大的上下文?
答:1M token。非思考模式最大输入 991,808 token,思考模式最大输入 983,616 token,单次最大输出 131,072 token。深度思考默认开启,可以用 reasoning_effort 调成 medium 或 low 来控制成本。
它能直接生成视频文件吗?
答:不能。它的输出模态只有文本,定位是理解音视频、规划任务并调用工具。要拿到成片,需要搭配 Qwen-MM-Plugins 等工具链和剪辑、配音、渲染环节,由上层应用完成最后的导出。
Qwen3.8-Omni-Flash 和 Gemini 3.8 Flash 哪个好?
答:看任务类型。音频密集型任务(多说话人识别、语音转写、音乐理解)Qwen 领先明显,AliMeeting cpWER 是 17.18 对 53.1;长视频推理、实时联网检索这类任务 Gemini 仍占优,LVOmniBench 是 70.7 对 63.3。官方自己的说法是音视频能力接近、音频能力整体超过。
Qwen3.8-Omni-Flash 支持哪些语言和方言?
答:音频输入支持 113 种语言和方言,其中语音识别覆盖 74 种多语言加 39 种中文方言(含粤语、四川话、上海话、闽南语等),语音生成支持 29 种语言加 7 种中文方言。
 京ICP备2024094994号-29