
MiniMax M3.1 Flash Mac 2-bit 本地部署实测
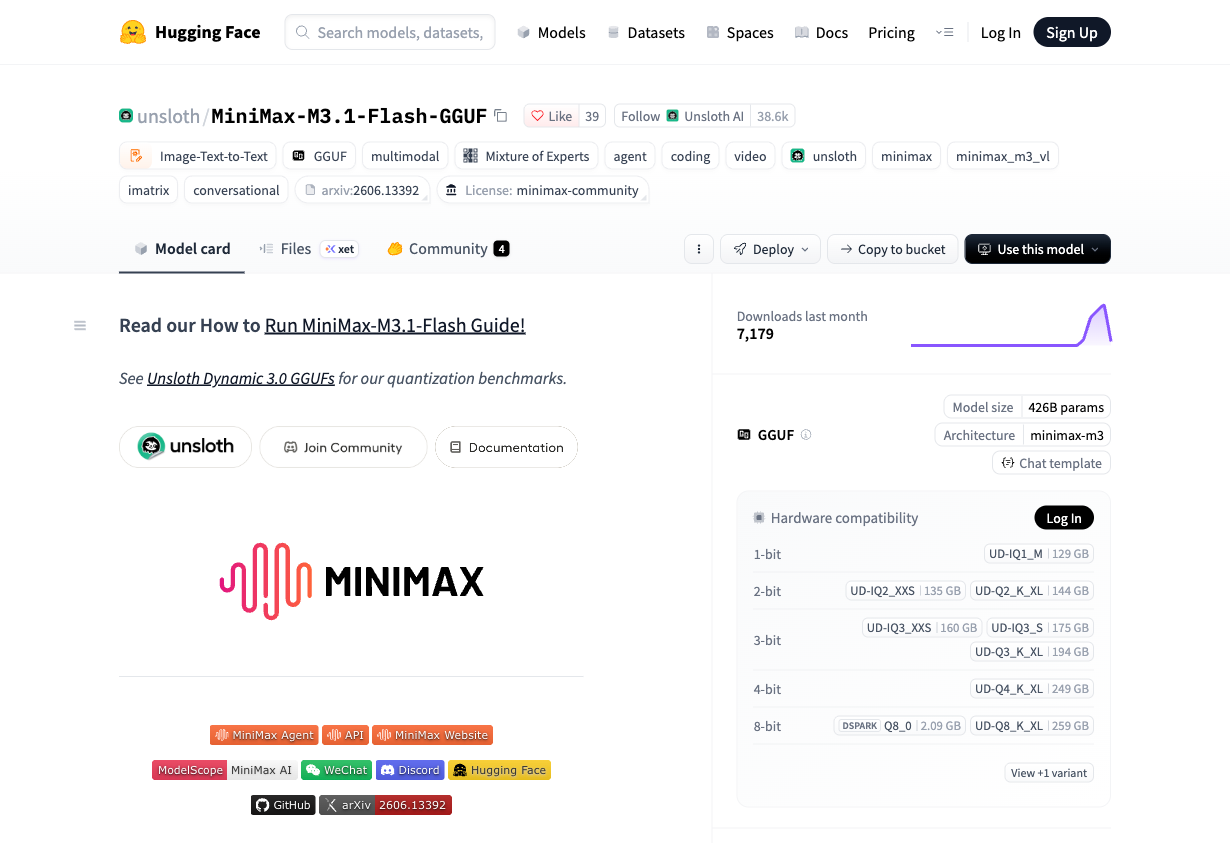
2026 年 10 月 27 日,MiniMax 与 UnslothAI 合作发布 M3.1 Flash 的 2-bit GGUF 量化版,把 428B 混合专家模型从多卡服务器才能跑的门槛压到 143.9GB,150GB 内存就能本地运行。完整流程就三步:去 Hugging Face 下模型文件、装一个推理工具(LM Studio 或 Ollama)、加载跑通,全程免费,不需要搭建多 GPU 集群。这篇实测专门写给 Mac 用户,下面给出 M 系列统一内存机型的配置门槛、两条部署路径和常见卡点排查。
前置准备:你的 Mac 够不够
先对号入座。2-bit GGUF 版官方口径是 143.9GB 模型体积,官方说 150GB 内存即可运行,跨七个领域评测保持 91.5% 的 top-1 token 一致率,体积较原版缩小 45%。换算到 Mac 上,关键在统一内存,不是显存。
| Mac 机型 | 统一内存 | 能否跑 | 体验预期 |
|---|---|---|---|
| Mac Studio / Mac Pro(M2/M3 Ultra) | 128GB 以上 | 能跑 | 全量加载,流畅跑代码与 Agent 任务 |
| MacBook Pro(M3/M4 Max) | 128GB | 能跑 | 全量加载,适合离线调试 |
| MacBook Pro / Studio(M 系列 Max) | 96GB | 勉强 | 可能触发交换分区,速度明显下降 |
| 64GB 统一内存机型 | 64GB | 不建议 | 内存不足,会频繁交换导致闪退 |
一句话结论:128GB 或更高的 M 系列 Mac 是甜点配置,96GB 能跑但别指望流畅,64GB 直接放弃。理由很简单,143.9GB 的权重在 64GB 上根本放不下,强行加载靠系统交换会把硬盘当内存用,速度惨不忍睹还容易闪退。
想确认自己机器的内存,点左上角苹果菜单选「关于本机」,看「内存」一栏即可。
第一步:从 Hugging Face 下载 2-bit GGUF 模型文件
Unsloth 在 Hugging Face 上托管了 MiniMax-M3.1-Flash-GGUF 项目,2-bit 档位文件在里面。下载前注意三点。
- 打开 Hugging Face 模型仓库,进入 unsloth 发布的 MiniMax-M3.1-Flash-GGUF,选 2-bit 量化版本文件。
- 用 hf-cli 工具下载,自带断点续传,避免 143.9GB 的大文件中途断了重来。
- 把模型放到英文路径的文件夹,路径里不要出现中文、空格和特殊符号,否则 LM Studio 索引会出问题。
文件很大(一百多 GB),下载时间取决于你的网络,国内直连 Hugging Face 可能慢,建议挂代理或选镜像站。这是教程里最容易卡住的点,先有心理预期。
第二步:装推理工具,二选一
工具选型就两条路,看你的习惯。
路线 A:LM Studio,新手首选
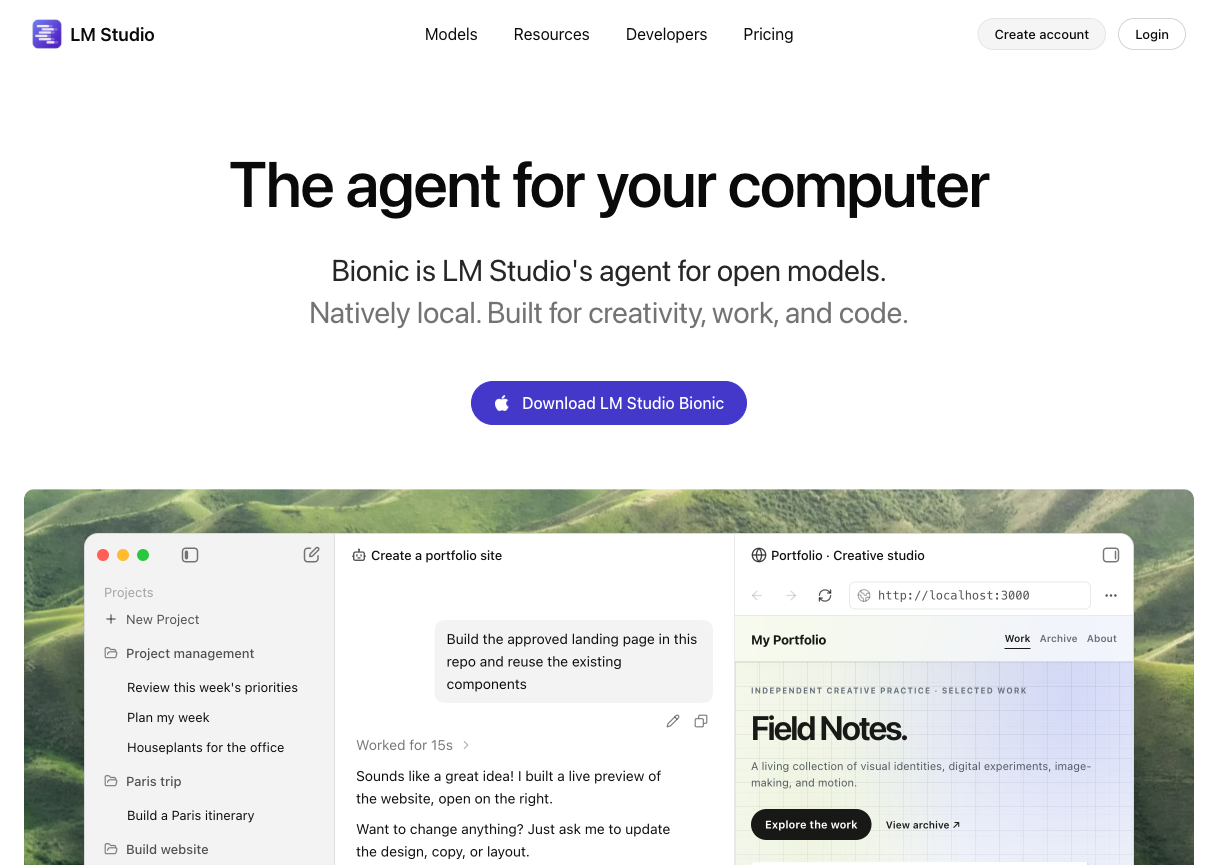
- 装最新版 LM Studio 客户端,打开进入本地模型管理页面。
- 点导入模型文件,选中刚才下载的 2-bit GGUF 文件,等软件自动索引。
- 在设置里开「本地 API 服务」,一键启动推理服务,之后任何程序都能通过 OpenAI 兼容接口调用它。
LM Studio 的优势是全程图形界面,不用碰命令行,加载进度、内存占用都看得到。
路线 B:Ollama,命令行党首选
- 新建一个 Modelfile 文件,内容指向 2-bit GGUF 模型的地址。
- 执行
ollama build命令打包模型。 - 执行
ollama run一键拉起本地服务。
命令长这样(模型路径换成你实际的):
FROM /Users/yourname/models/MiniMax-M3.1-Flash-2bit.Q4_K_M.gguf
ollama build minimax-m31-flash-2bit
ollama run minimax-m31-flash-2bit
第三步:调推理参数,跑通并验证
模型加载完成后,调试这几组参数决定输出质量。
- 上下文长度:默认按 100 万 token 设置,内存紧张就调低,能明显省内存。
- 量化加速:开启 GPU offload,把能放的权重塞进显存,减轻内存压力。
- 采样参数:temperature 设 0.2 到 0.4 适合代码生成,调到 0.6 到 0.8 适合文案创作。
怎么确认真的跑通?两个信号:一是 LM Studio 或 Ollama 日志显示模型已加载、内存占用稳定;二是丢一个需要推理的问题过去,能在合理时间内给出回复。建议先跑一段代码补全或长文本总结,验证核心能力在量化后还在。
进阶:跑本地 Agent 与离线知识库
2-bit 版保留了代码生成、Agent 调用、百万长上下文这些核心能力(t0001 的快讯实测口径),本地部署后最值钱的玩法是离线。
- 离线代码开发:断网环境下调试程序、生成工程代码。
- 私有长文档总结:导入百万字文档离线提炼要点,数据不出设备。
- 本地 Agent:对接本地文件与脚本工具,跑无网络自动化任务。
- 私有知识库:embedding 与大模型全放本地,数据全程不联网。
这几类场景对隐私敏感的用户最友好,因为推理发生在你自己的机器上,不经过任何云端。
常见报错速查
| 现象 | 原因 | 解法 |
|---|---|---|
| 加载到一半内存耗尽 | 统一内存不足,权重放不下 | 换 128GB 以上机型,或调低上下文长度 |
| 模型频繁闪退 | 触发交换分区,硬盘当内存 | 关掉后台内存清理程序,降低上下文窗口 |
| 下载中断 | 大文件网络不稳 | 用 hf-cli 断点续传,别用浏览器直接下 |
| 推理速度极慢 | 纯 CPU 加载,权重没进显存 | 开启 GPU offload,把权重尽量塞进显存 |
| 工具识别不了模型文件 | 路径含中文或空格 | 把模型移到纯英文路径 |
常见问题
Mac 上跑 MiniMax M3.1 Flash 2-bit GGUF 需要多大内存?
官方口径是 150GB 内存即可运行,模型文件约 143.9GB。对应到 Mac,128GB 统一内存的 M 系列机型是最优解,96GB 勉强能跑,64GB 不建议,会触发交换导致闪退。
M3.1 Flash 2-bit 量化版相比原版损失多少?
官方数据是保持 91.5% 的 top-1 token 一致率,体积缩小 45%。代码生成、Agent 调用、长文本总结能力衰减控制在合理范围,满足本地开发、离线调试使用。
这个 2-bit 版本是不是免费的?
是免费的。模型文件从 Hugging Face 下载,推理工具 LM Studio、Ollama、llama.cpp 都是开源免费。唯一的花费是你的 Mac 硬件和下载流量。
Windows 大内存电脑能跑吗?
能。2-bit GGUF 版遵循通用 GGUF 格式,Windows 上同样用 Ollama、LM Studio、llama.cpp 加载。但如果你只有 32GB 内存,只能走纯 CPU 推理,速度较慢,适合小批量文本测试。
有哪些推理工具支持这个模型?
标准 GGUF 格式,兼容 Ollama、LM Studio、llama.cpp 三大主流工具,下载后直接加载,不需要格式转换。
 京ICP备2024094994号-29