
LifeVal 是什么:OpenAI 11月2日新评测基准解读
OpenAI LifeVal 是什么
LifeVal 是 OpenAI 在 2026 年 11 月 2 日发布的一套评测基准,量 AI 在日常生活任务上的完成度。它不是模型,不开放接口,是一把尺子。官方发布页在 openai.com/index/lifeval。
稀奇的是评测对象换了。过去比知识、数学、代码,LifeVal 比找幼儿园、做预算、组织社区防汛志愿者这类事。
它测什么
官方说得很直白:全球每周有超过 10 亿人在用 ChatGPT,想要的不只是「给点建议」,而是「把事办成」。所以判定标准是动作有没有落地,不是回答得好不好看。
任务分七个领域:照护、健康、教育、家庭事务、个人财务、购物、政务办理。定位是研究输出。
题目从哪来
题目不是研究员拍脑袋想的。
OpenAI 先拿两套现成的时间使用调查打底,一套是美国的 American Time Use Survey,一套是跨国的 Multinational Time Use Study,把普通人一天到晚在干什么列得很细。在这之上又做了一份 3995 人、人口结构有代表性的新调查,逐项问受访者最希望 AI 帮哪些忙。
所以题目分布跟着人的痛点走,不跟着学术难度走。这也是它跟 SWE-bench、GPQA 的根本区别。
五个公开示例和分数
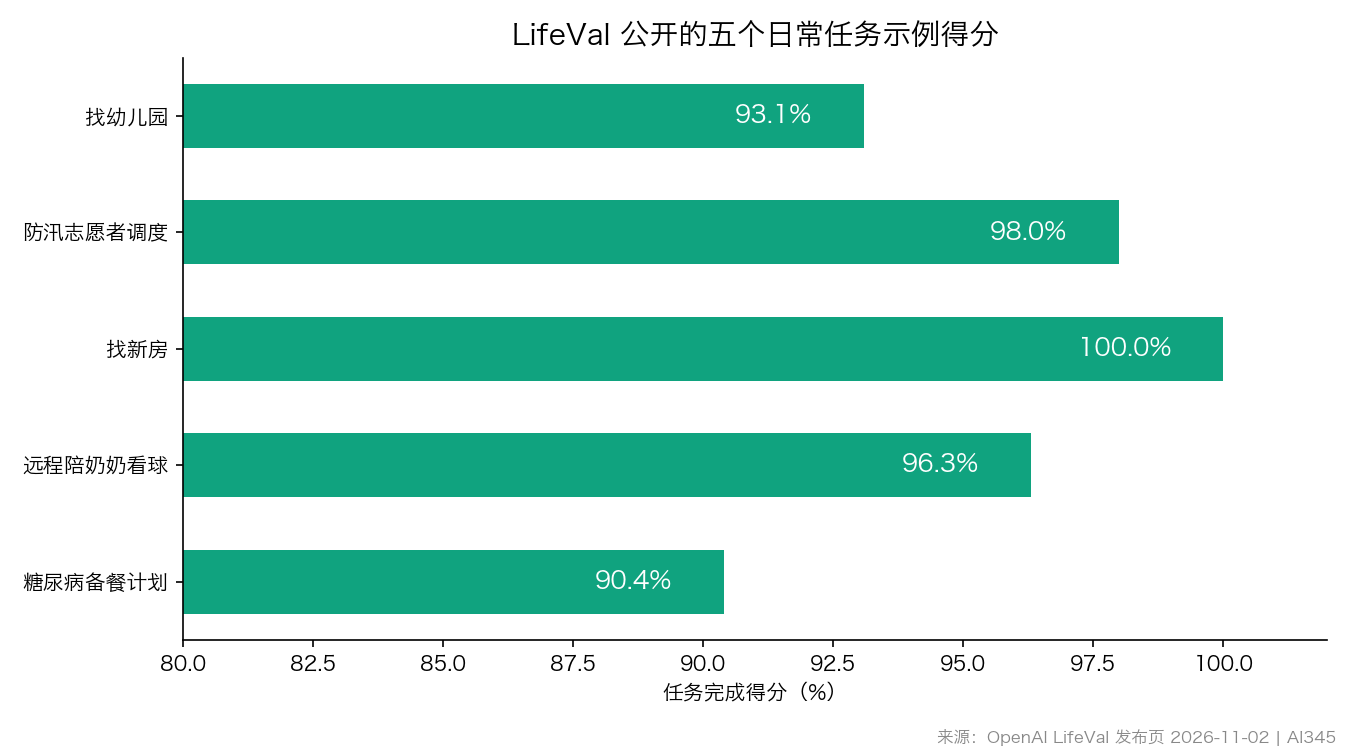
发布页给了五个场景,每个带一个分数。这是全文最值得细读的部分。
| 任务场景 | 分数 | 模型交付物 |
|---|---|---|
| 搬家后给孩子找对口幼儿园 | 93.1% | 比完附近幼儿园,缩到三所,整理报名信息,留两个偏好等用户拍板 |
| 防汛前组织社区志愿者 | 98.0% | 出行动方案,帮志愿者评估几户要防水处理的家庭 |
| 给一家人找新房 | 100% | 找到满足预算、独立居住单元、通勤要求的房子,算好过户税,把契约放进政务记录购物车 |
| 远程陪奶奶看球赛 | 96.3% | 给最省事的观看方案,外加备用方案 |
| 父母确诊糖尿病之后的备餐 | 90.4% | 出第一周计划,含餐食、提醒事项、要问医疗团队的问题 |
最高 100%,最低 90.4%,四个在 96% 以上。
分数高不等于任务简单
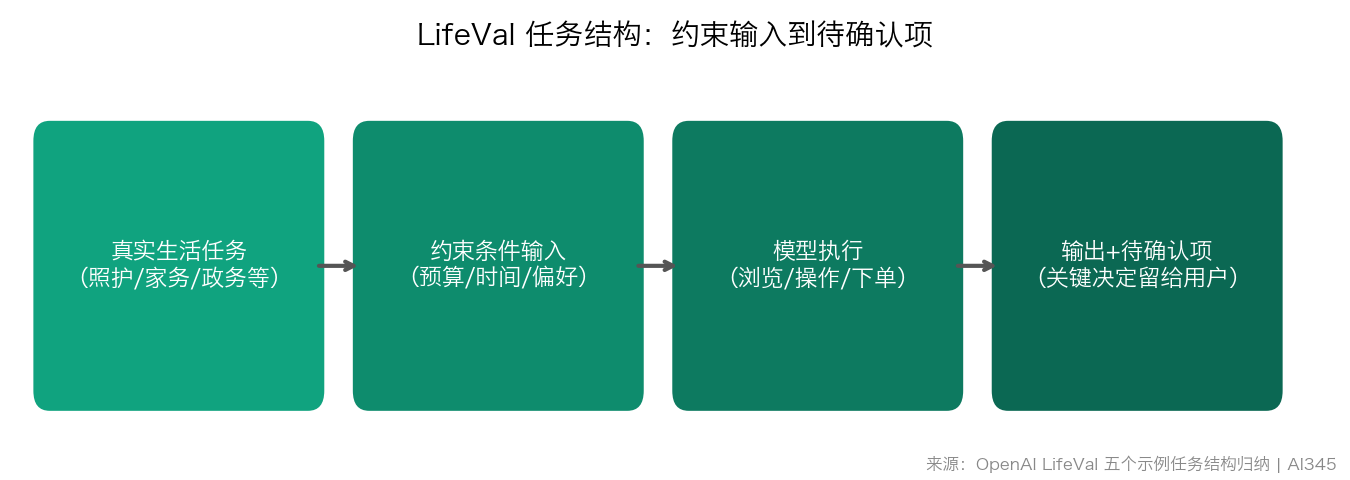
第一,这分数不是「答对率」,是「任务完成度」。模型最后说的是「三所选校清单准备好了,两个偏好等你定」,是带待确认项的半成品,不是标准答案。
第二,官方没公开题集和评分细则,只给五个示例各附一句输出。100% 只能读成「这个场景这一次跑通了」,推不出「买房这类事百分百可靠」。
为什么要测「办事」
官方给的设计动机只有一句话:要当真正有用的个人助理,ChatGPT 得能采取动作,把事情真正办完。
所以过去一年 OpenAI 在浏览器操作、电脑操作、连接器上投入很多,让 ChatGPT 往智能体助手走,LifeVal 就是这条路线配的验收标准。
站内这三篇可以接着看:GPT-6 发布与迭代梳理 记模型侧变化,ChatGPT Work 和 Claude Cowork 的差别 讲智能体工作台,GPT Image 2 是什么 是生成侧的切片。
中文用户能怎么用
直接用不上,它不开放接口。但有三条路能吃到信息价值。
- 拿七个领域当自测清单,逐项写下你最近真实想找人代办的一件事。
- 照示例的问法提问。共同点是约束条件一次给足,预算、通勤、独立居住单元、学区要求,别分五轮挤牙膏。
- 观察模型输出的「待确认项」。五个示例有四个结尾在问要不要确认,说明设计上是让模型停在关键决策点前面。
看懂之后,下次看到某家说「我们的模型在生活任务上接近人类」,你知道该追问三件事:谁定义的日常任务、多少人参与的调查、评分细则公开了吗。
常见问题
LifeVal 是一个新模型吗?
不是。它是 2026 年 11 月 2 日发布的一套评测基准,衡量模型在日常生活任务上的完成度,属于研究输出,不能单独调用。
分数 100% 是不是说明任务很简单?
不能这么推。100% 只对应「给一家人找新房」这一个示例,官方只给了一句模型输出,没公开完整题集和细则。它应理解为特定场景下的完成情况,不是通用能力评级。
那 3995 人调查是怎么用的?
据发布页说明,OpenAI 在两套现成时间使用数据之上,新做了一份 3995 人、人口结构有代表性的调查,逐项问受访者最希望 AI 帮哪些忙,用来决定评测题目的领域分布。
国内能直接用 LifeVal 吗?
用不了,它没有面向用户的产品形态。能用的只有披露的方法和示例问法,把七个领域当自查清单,按「约束条件一次说全」的方式提问即可。
它跟 MMLU、SWE-bench 有什么不同?
评判对象不同。MMLU 考知识题,SWE-bench 考代码修复,LifeVal 考日常生活里的动作能不能落地,判定看任务是否推进到可交付状态,而不是答案对不对。
之后还会更新吗?
官方写的是用它「在过去一年里跟踪并推动模型在日常任务上的进步」,说明内部连续使用。后续是否公开更多题集、是否定期发榜,官方没公布。
 京ICP备2024094994号-29