
HeyGen Avatar IV 是什么?一张照片生成口播视频全解读
HeyGen Avatar IV 是 HeyGen 推出的照片转口播视频模型:给一张照片和一段文本或音频,它就能生成会说话、带表情和手势的口播视频。2026 年 8 月 24 日起,它通过 OpenRouter 以 API 形式开放,价格每秒 0.05 美元,最高支持 1080p。
Avatar IV 是什么:一句话讲清
HeyGen 是一家主打 AI 数字人视频的公司,Avatar IV 是它的新一代照片说话模型。OpenRouter 官方页对它的定义很直接:把单张照片动画化成一个有表现力、口型同步的说话人头视频。
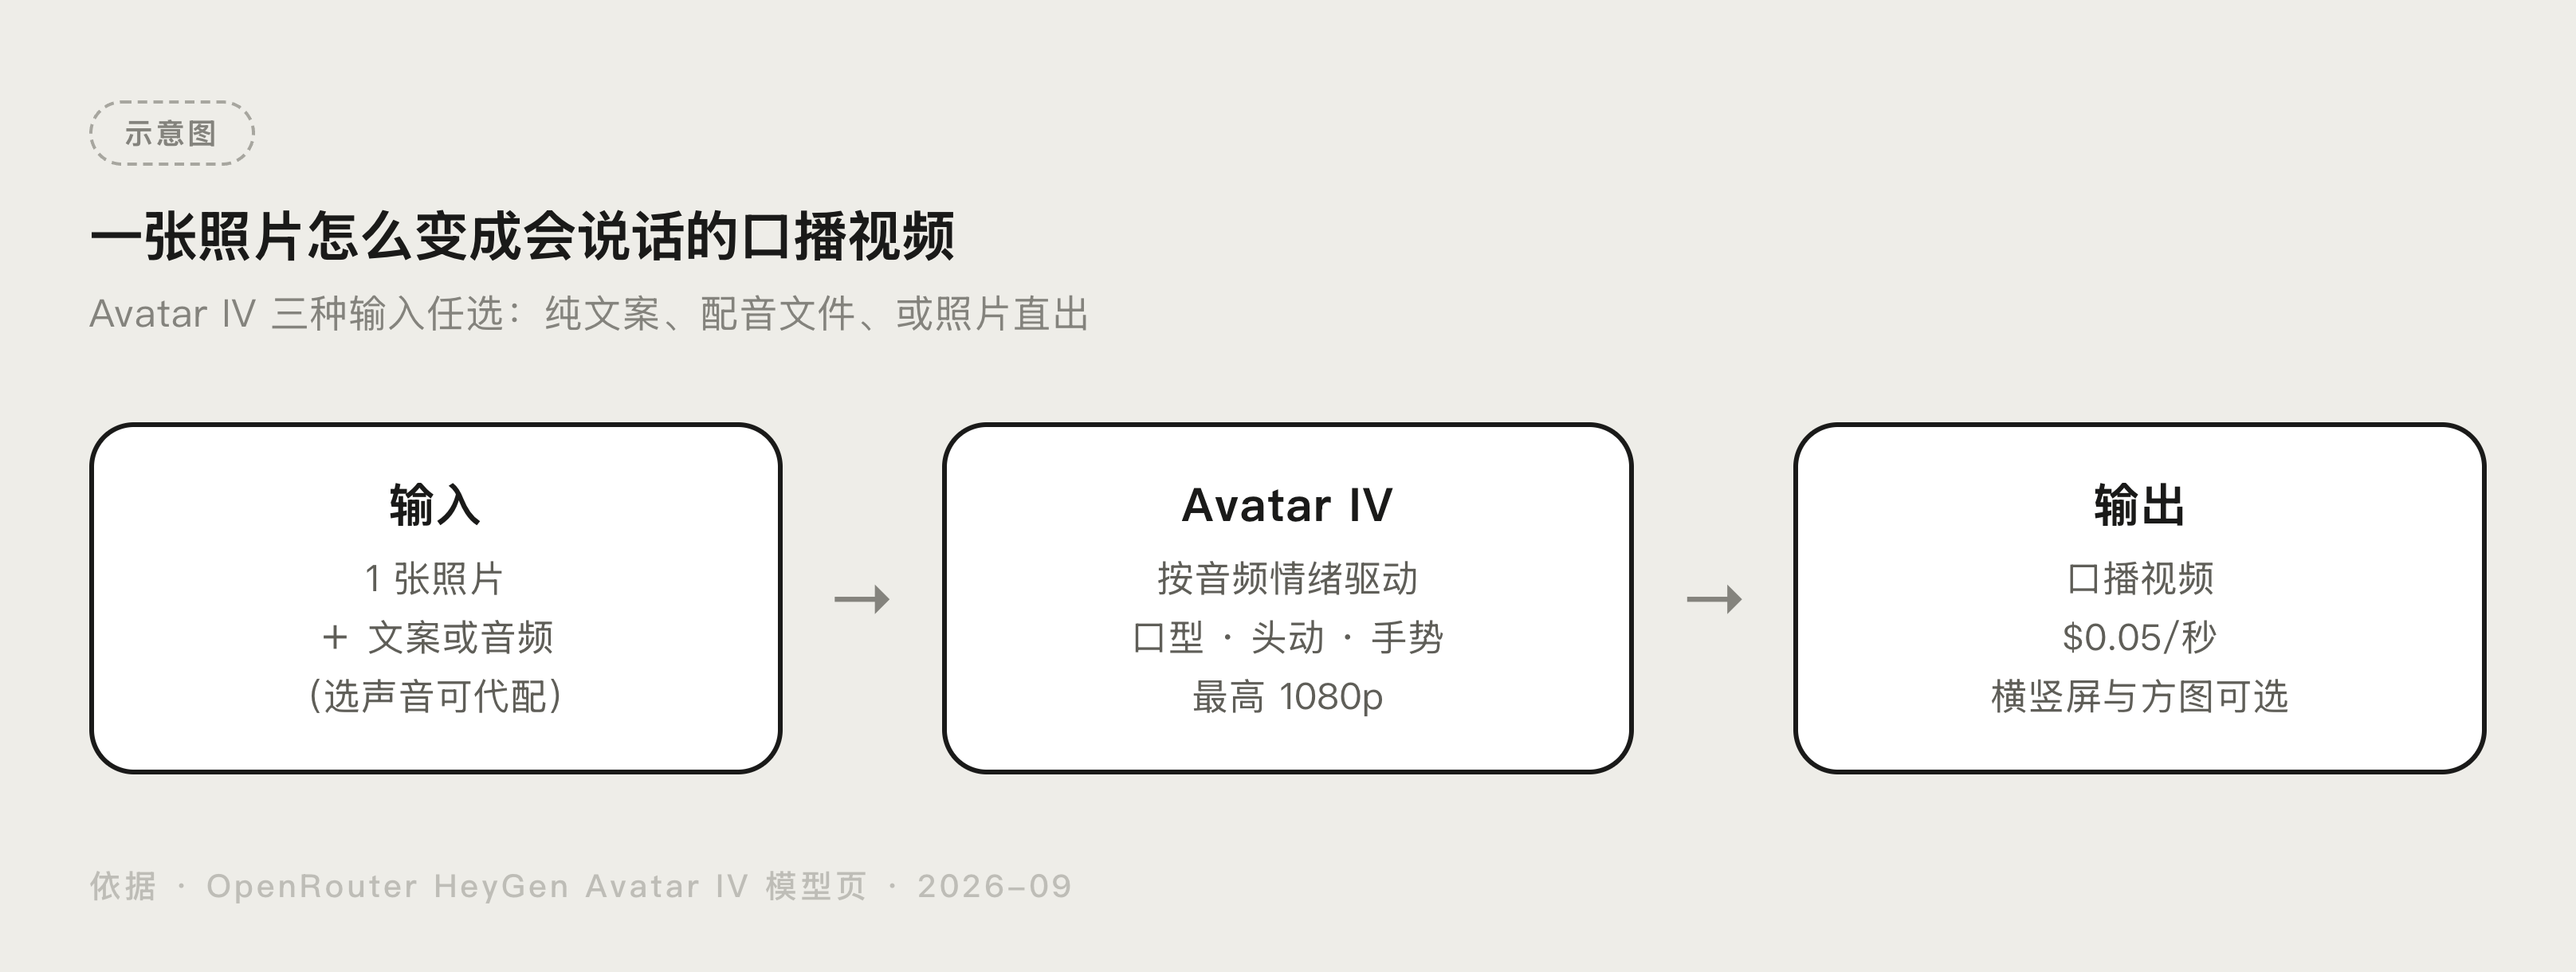
它和普通图生视频模型的边界在于用途:不是让照片里的场景动起来,而是专门让人物「开口讲话」。你给它两样东西,一张人物照片,一个音频来源(文本脚本或音频文件),它输出一段口型对齐、姿态自然的口播视频。
它最值得关注的技术点是情绪驱动:模型不只匹配嘴型,还会解读音频的语气、节奏和情绪,用这些信号去驱动头部动作、面部表情和手势。同一份讲稿用平静语气和激昂语气各读一遍,生成的肢体表现是不一样的。
核心能力:每一条对你意味着什么
- 单照片生成口播视频:不需要棚拍、不需要绿幕、不需要真人出镜录制,一张照片就是一个数字分身。
- 情绪驱动的头动、表情和手势:成片不像「机器人念稿」,对做知识口播和产品讲解的人,意味着更少的「AI 味」。
- 两种音频输入方式:可以直接给文本脚本,由 HeyGen 自家的文字转语音配音;也可以上传现成音频,让照片对口型。
- 最高 1080p,支持 16:9、9:16、1:1 三种比例:横屏视频、竖屏短视频、方形封面素材都能覆盖。
- API 参数可调:语音选择、表现力强度、指定动作提示、背景替换或去除、自动字幕,都能通过参数控制。
Avatar IV 怎么收费:每秒 0.05 美元折算
OpenRouter 页面公示的价格是每秒 0.05 美元,按生成视频时长计费。按 1 美元约合 7.1 元人民币估算,成本大致如下:
| 视频时长 | 美元成本 | 人民币折算(约) |
|---|---|---|
| 1 秒 | $0.05 | 0.36 元 |
| 30 秒 | $1.50 | 10.7 元 |
| 1 分钟 | $3.00 | 21.3 元 |
| 10 分钟 | $30.00 | 213 元 |
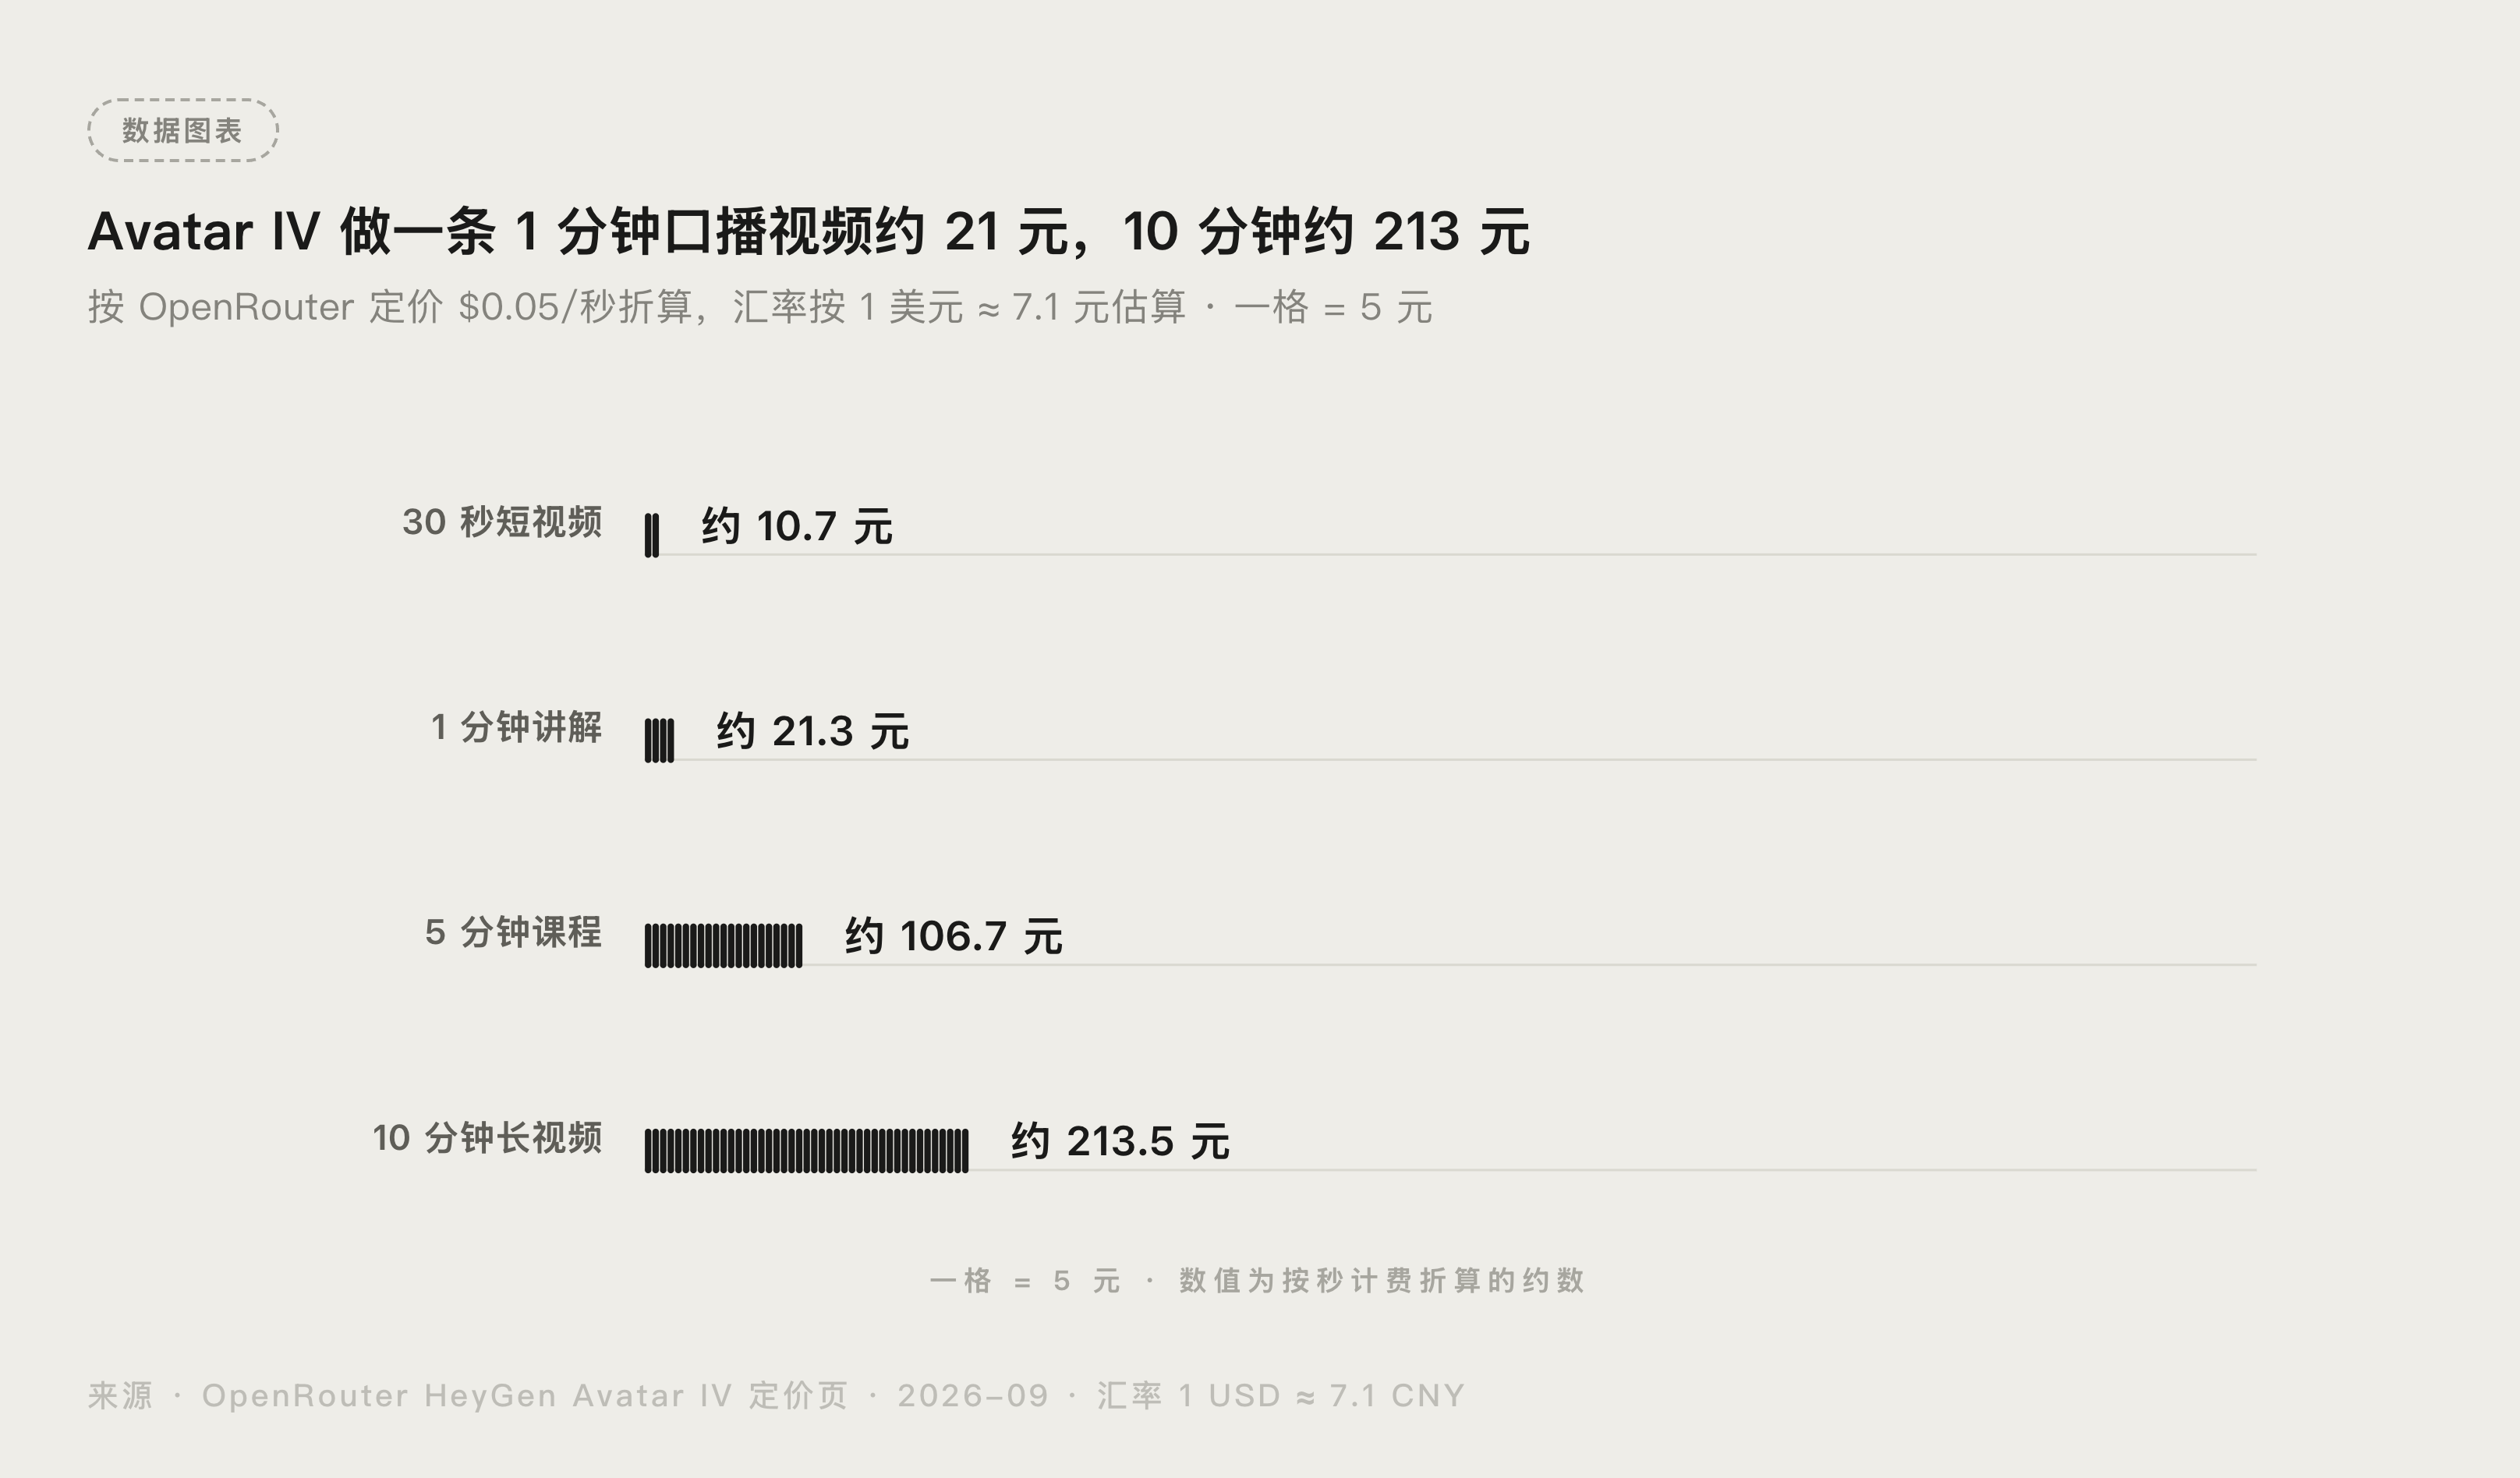
这个定价模式决定了它的适用边界:做一分钟以内的口播片段很划算,但成本随秒数线性增长,批量做长视频之前必须先算总成本。
和传统数字人产品的区别
传统数字人工具(包括 HeyGen 自家的订阅制产品)的典型形态是:形象库加模板,按月付费,你在产品界面里挑选数字人、贴上文案就能出片。
Avatar IV 走的是另一条路:它是通过 OpenRouter 开放的底层模型 API,任意一张照片都能当形象,按秒付费,没有套餐。可以这么理解:HeyGen 官网是成品店,Avatar IV 是通过 OpenRouter 出售的发动机,适合开发者把照片转口播的能力嵌进自己的应用里。
国内用户怎么调用:三步上手
- 注册 OpenRouter 账号:模型托管在 OpenRouter 上,模型 ID 为 heygen/avatar-iv,注册后可在页面直接查看调用示例。
- 准备支付方式并充值:OpenRouter 支持信用卡等海外主流支付方式,国内用户需要自行准备对应的支付手段。
- 发起 API 调用:输入支持文本、图片和音频三类,先用几秒钟的短脚本测试效果和计费,确认符合预期再放量。
需要提醒的是,网络可达性因网络环境而异,建议先小成本实测再决定是否正式接入。如果只是想先免费体验多模态 AI 的能力边界,可以先看我们整理的 Google AI Studio 使用指南,或者关注国产模型的最新进展,比如 GLM-6 最新消息汇总。
适合谁用,不适合谁
适合:做知识口播、产品讲解、多语言短视频的内容创作者,以及想在自己的产品里集成数字人口播能力的开发者。
不适合:需要批量生成长视频的团队(按秒计费扛不住),以及对品牌形象一致性和授权合规要求高的项目,这类需求更适合走订阅制的成熟数字人产品,形象授权链条更清晰。学生党如果只是想先玩转 AI 工具,可以先从免费额度入手,参考我们的 Gemini 学生认证教程。
常见问题
Avatar IV 和 HeyGen 官网的数字人是一回事吗?
答:不完全一样。Avatar IV 是 HeyGen 的底层照片转口播视频模型,2026 年 8 月 24 日起通过 OpenRouter 以 API 开放,按生成秒数计费;HeyGen 官网产品是在这之上的成品化工具,按订阅套餐收费,两者面向的使用方式不同。
每秒 0.05 美元贵不贵?
答:折算下来一条 1 分钟视频约 3 美元(约 21 元人民币)。短口播、社媒短视频成本可控,但成本随时长线性增长,批量做长视频前建议先按秒数估算总成本。
它支持哪些输入和输出?
答:输入支持文本、图片和音频三类:给文本脚本时由 HeyGen 文字转语音配音,给音频文件时照片直接对口型;输出是视频,最高 1080p,支持 16:9、9:16 和 1:1 三种比例。
表情和手势是怎么控制出来的?
答:模型会解读音频的语气、节奏和情绪,自动驱动头部动作、面部表情和手势。你还可以通过 API 参数调整表现力强度,或用动作提示指定想要的动作,背景也可以替换或去除。
国内用户能直接调用吗?
答:目前通过 OpenRouter 的 API 开放,需要注册 OpenRouter 账号并准备海外支付方式,网络可达性因网络环境而异。建议先用几秒钟的短脚本小成本测试效果和计费,再决定是否正式接入。
它和普通的对口型模型有什么区别?
答:普通对口型模型只让嘴型匹配词语,Avatar IV 还会解读音频的情绪、语气和节奏,据此生成头部动作、表情和手势,成片的表现力明显更接近真人讲话的状态。
 京ICP备2024094994号-29