
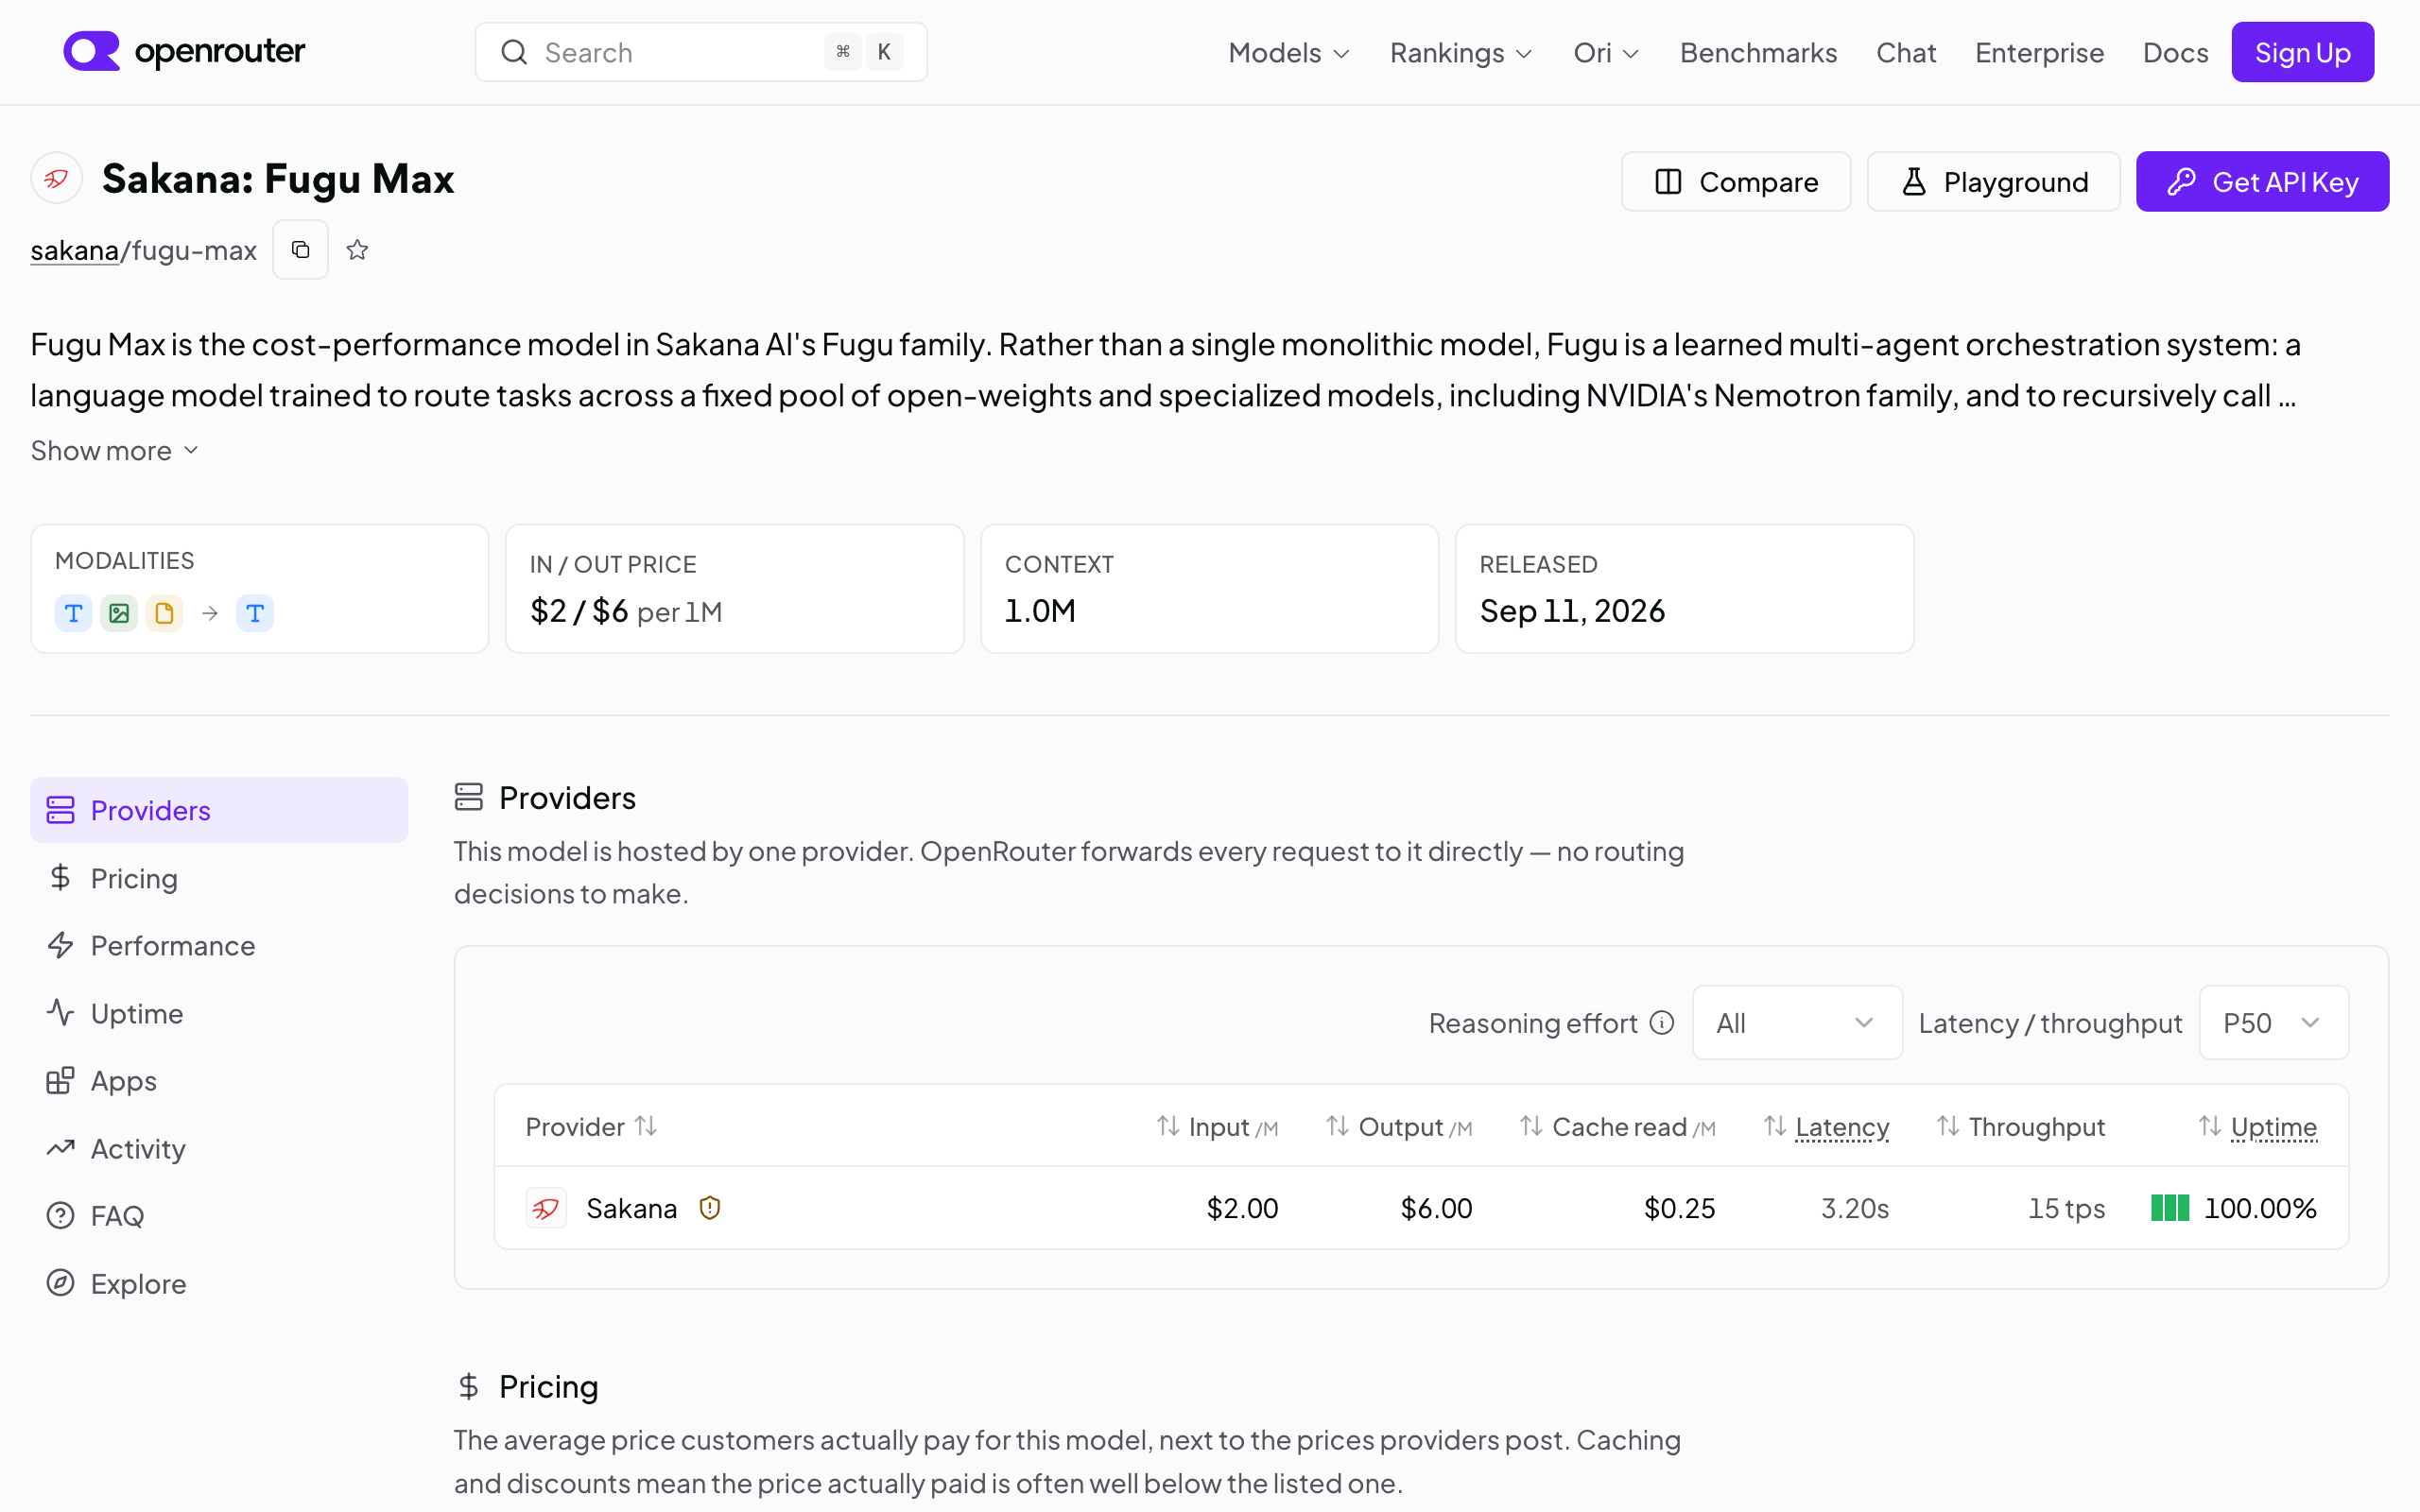
Fugu Max 和 Fugu Ultra v2 哪个好?差价 5 倍怎么选
直接给结论:绝大多数日常任务选 Fugu Max,它便宜得多且能力足够;只有复杂推理、高难度分析这类硬骨头才值得上 Fugu Ultra v2,后者的输出价格是前者的 5 倍。两款模型 2026 年 9 月 11 日同日在 OpenRouter 上线,接入方式完全一样,切换零成本。下面把差异掰开讲。
先认识 Fugu 家族:不是单个模型,是编排系统
按照 OpenRouter 上 Sakana Fugu 系列页面的官方描述,Fugu 不是传统意义上的单体大模型,而是一个「习得式多智能体编排系统」:由一个语言模型负责把任务路由和调度给多个执行单元协同完成。Max 和 Ultra v2 是同一套系统里的两个档位,官方定位分别是「性价比款」和「高性能款」。
这个设计直接影响你对两者的预期:你感受到的响应质量来自整个编排链路,而不是某一个参数规模。两款都强制开启推理(reasoning 为必开项),区别在于默认推理档位和算力投入。
总对比表:10 个维度一次看全
数据来自 OpenRouter 模型页与接口端点信息,2026 年 9 月 17 日核实:
| 维度 | Fugu Max | Fugu Ultra v2 |
|---|---|---|
| 官方定位 | 性价比款 | 高性能款 |
| 输入价格(每百万 tokens) | 2 美元 | 5 美元 |
| 输出价格(每百万 tokens) | 6 美元 | 30 美元 |
| 缓存读取 | 0.25 美元 | 0.5 美元 |
| 上下文长度 | 100 万 tokens | 100 万 tokens |
| 最大输出 | 12.8 万 tokens | 12.8 万 tokens |
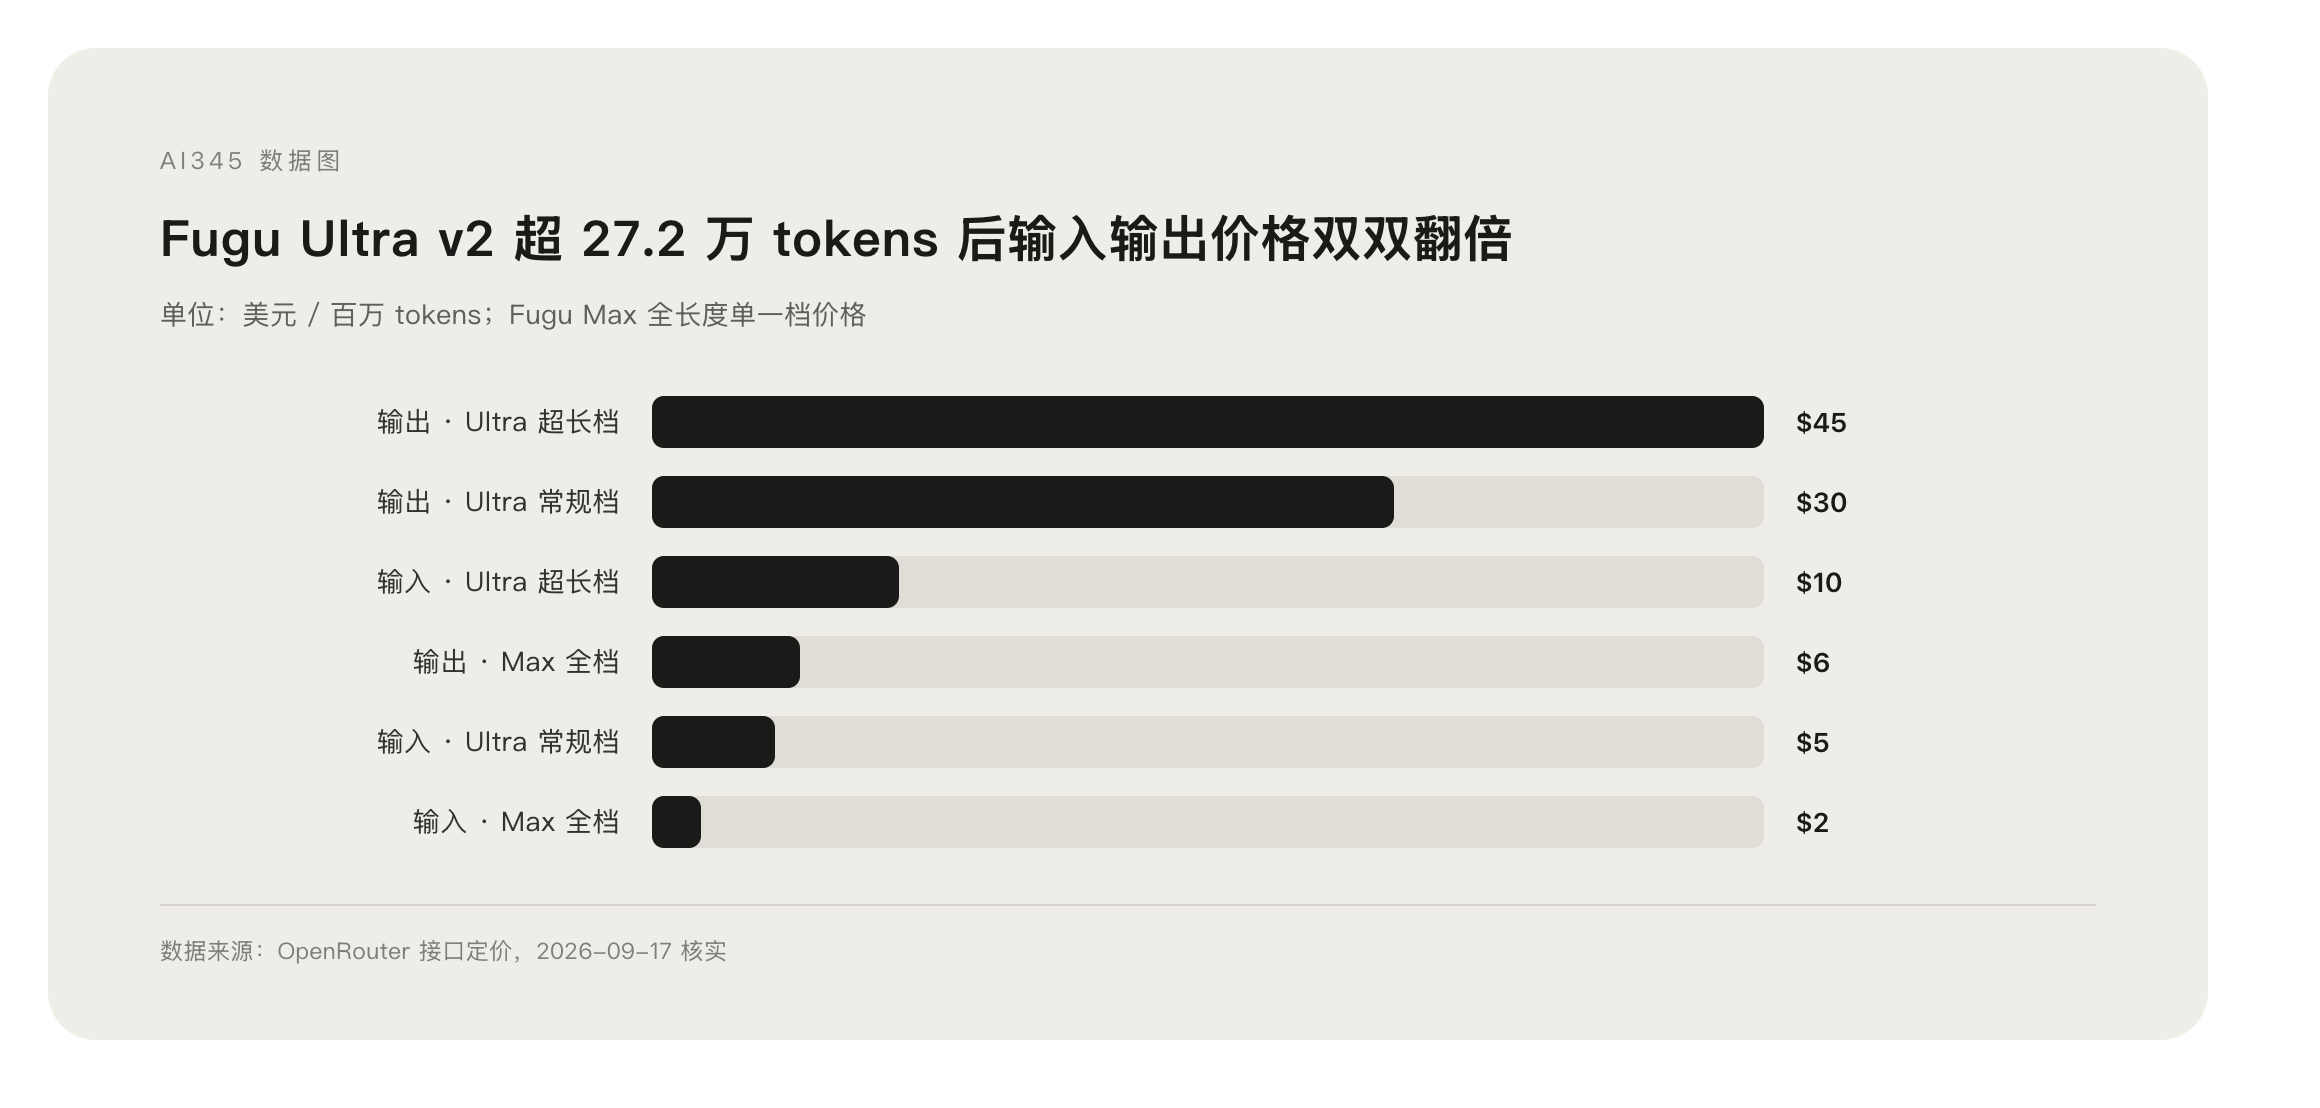
| 长上下文加价 | 无(单一价格) | 提示词超 27.2 万 tokens 后输入 10 美元、输出 45 美元 |
| 推理档位 | max、xhigh、high,默认 high | max、xhigh、high,默认 xhigh |
| 知识截止 | 未标注 | 2026 年 8 月 28 日 |
| 输入模态 | 文本、图片、文件 | 文本、图片、文件 |
两款都支持函数调用、结构化输出和联网搜索(搜索单独计费 0.01 美元一次),工具协议一致。
价格差多少:一个算例看懂
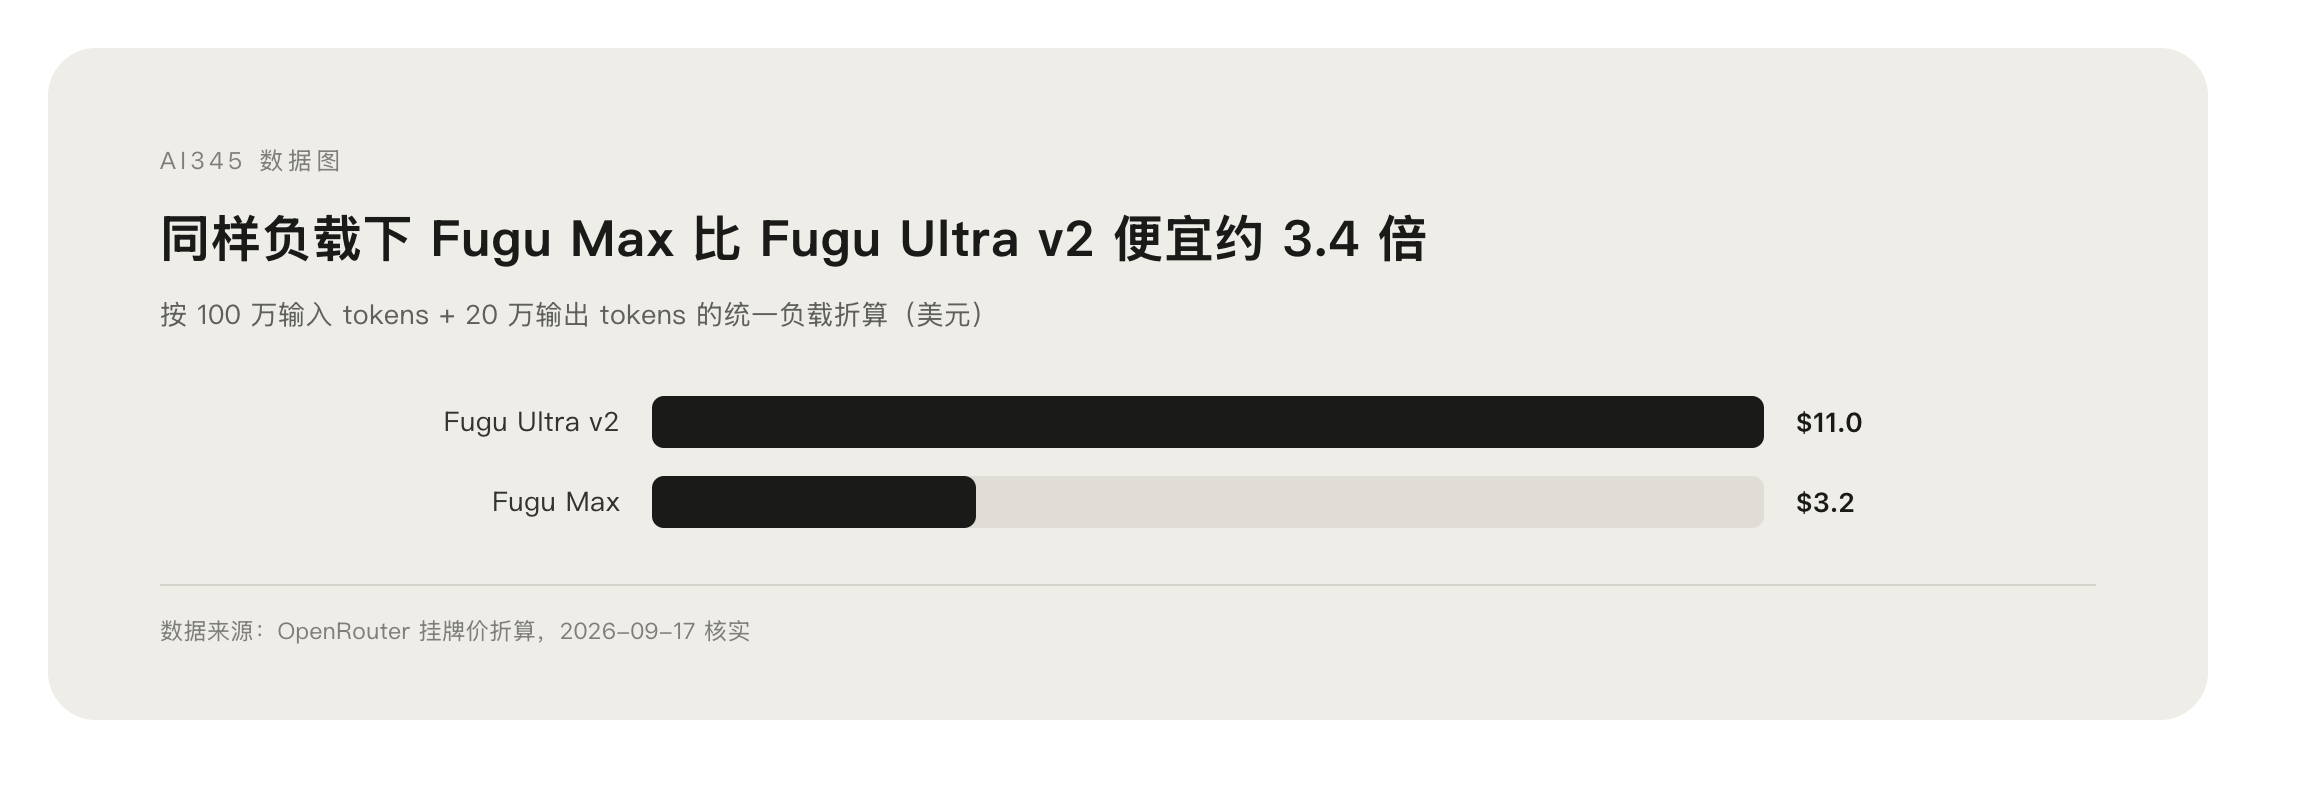
单价差距要放到真实负载里才有感觉。假设一个典型的 Agent 任务消耗 100 万输入 tokens 和 20 万输出 tokens:
- Fugu Max:输入 2 美元 + 输出 1.2 美元,合计约 3.2 美元。
- Fugu Ultra v2:输入 5 美元 + 输出 6 美元,合计约 11 美元。
同样一轮任务,Ultra v2 花费约是 Max 的 3.4 倍;如果任务输出更重(比如批量生成内容),输出价 5 倍的差距会被进一步放大。反过来,如果只做短输入长思考的难题,差距会收窄。
还有一个容易踩的坑在长上下文:Fugu Ultra v2 的提示词一旦超过 27.2 万 tokens,输入价从 5 美元涨到 10 美元、输出涨到 45 美元;Fugu Max 没有这档加价。喂超大文档给 Ultra v2 时,账单可能是你预期的两倍以上。
质量差在哪:推理档位和知识截止
两款最大的隐性差异是默认推理深度。Fugu Ultra v2 默认 xhigh 档推理,Max 默认 high 档,官方给 Ultra v2 的定位就是用更多算力换更高回答质量。实践中这意味着:
- 复杂多步推理、数学、代码难题:Ultra v2 的默认配置就更偏向想得更深。
- 常规问答、摘要、格式化转换:Max 的默认档位已经足够,多花的推理算力是浪费。
另一个差异是知识截止:Ultra v2 标注 2026 年 8 月 28 日,Max 未标注,结合它 9 月 11 日才上线的节奏,训练数据较新这件事基本可以放心,但涉及最新动态仍建议开联网搜索参数。
场景化推荐:什么人用哪个
如果你是下面这些情况,选 Fugu Max:
- 批量处理:分类、抽取、改写、摘要等量大、单题不难的任务,成本直接砍到五分之一。
- Agent 高频调用:编排系统本身就会产生大量内部请求,用 Max 当执行层更扛得住账单。
- 长文档日常分析:1M 上下文一样有,还没有长上下文加价。
如果你是下面这些情况,选 Fugu Ultra v2:
- 疑难杂症攻坚:Max 试过答不好的问题,换 Ultra v2 默认 xhigh 再跑一轮。
- 高价值低频任务:一份要交给客户的分析报告,单价贵几美元但质量优先。
- 需要最新知识截止的领域研究。
拿不准的话,最务实的路径是 Max 起步:把 Max 设为默认模型,个别任务手动切 Ultra v2。两款切换不需要改任何接入代码,只换模型 ID。对比思维不熟的读者可以看站内怎么看模型版本号和DeepSeek V4.1 Flash 与 V4 Pro 对比,同类「一快一强」的双档策略在各家已经很常见,Meta 的Muse Spark 1.2 解读也是类似路数。
迁移成本:几乎为零
两款模型同属一个平台、同一套协议、同一批参数支持,从任何一方切到另一方只需要改模型 ID 字符串:sakana/fugu-max 换成 sakana/fugu-ultra-v2。没有专属 SDK、没有数据格式差异,也就没有传统意义上的迁移成本。唯一要改的是预算逻辑,尤其注意 Ultra v2 的长上下文加价档。
常见问题
Fugu Max 和 Fugu Ultra v2 是什么时候上线的?
答:两款都是 2026 年 9 月 11 日在 OpenRouter 上线,模型版本号里也带着 20260911 的日期标记,属于同批发布的双档产品。
两款模型都支持图片和文件输入吗?
答:都支持。两款输入模态均为文本、图片、文件,输出为文本,函数调用和结构化输出的支持也完全一致,差异集中在价格和推理档位上。
为什么 Ultra v2 喂长文档时账单暴涨?
答:它的定价分两档:提示词在 27.2 万 tokens 以内按 5 美元输入、30 美元输出计费,超过后输入涨到 10 美元、输出涨到 45 美元。Fugu Max 没有这档加价,超大上下文场景反而是 Max 更划算。
可以手动调低 Ultra v2 的推理档位来省钱吗?
答:可以。两款都开放 max、xhigh、high 三档推理参数,把 Ultra v2 调到 high 能压缩部分算力消耗,但那样它的质量优势也会缩水,不如直接用 Max 更简单。
Fugu Max 和 Ultra v2 的中文能力怎么样?
答:官方页面未单独标注语言支持数据。两款上线仅一周,中文长文本和指令遵循的实测口碑还需要社区积累,建议你用自己的典型任务各跑一轮再决定主力档位。
 京ICP备2024094994号-29