
ElevenLabs CLI 替代品实测:6 款终端 TTS 对比
ElevenLabs 提供了 npm 包 @elevenlabs/cli,让你能在终端里管理语音 Agent、生成语音。关于安装和 Key 配置,可以参考 ElevenLabs CLI 安装教程 和 API Key 配置说明。
但它的核心限制也很明确:需要 API Key、每月 免费额度 只有 10,000 字符(超了就要按订阅付费)、必须联网。
如果你在找能在终端里用、最好还能本地跑且不花钱的方案,下面这 6 款替代品(Piper TTS、Kokoro、Fish Speech、Coqui、ChatTTS、OpenAI TTS)值得逐一对比。
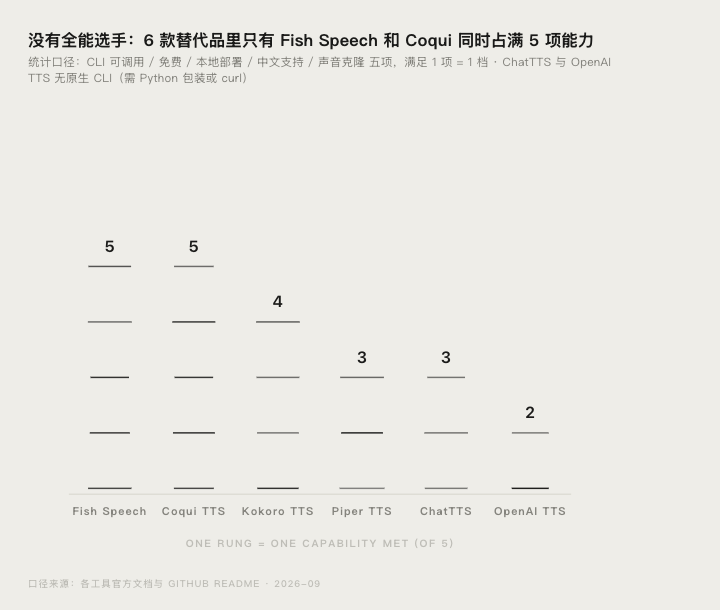
本文六款工具的筛选原则只有一个:必须能在命令行/终端里用。没有 CLI 工具、没有 REST API、不能用 curl 或管道调用的,不进这张表。
一图看懂:6 款 CLI TTS 工具总对比
| 工具 | 调用方式 | 是否免费 | 本地部署 | 中文支持 | 声音克隆 | 活跃状态 |
|---|---|---|---|---|---|---|
| Piper TTS | 原生 CLI(echo 管道) | 完全免费 | 支持(本地 ONNX) | 一般(英文模型为主) | 不支持 | 维护中(主仓库已归档,迁移至 OHF-Voice) |
| Kokoro TTS | 原生 CLI(管道/文件输入) | 完全免费 | 支持(CPU 可运行) | 支持(含中、日、韩) | 语音融合 | 活跃(2025 年初发布) |
| Fish Speech | REST API(curl) | 免费(本地)+ 云 API 付费 | 支持 | 支持(13 种语言) | 零样本克隆 | 活跃(1.5 版本) |
| Coqui TTS | Python API(可包成 CLI 脚本) | 完全免费 | 支持 | 1100+ 语言含中文 | 支持(XTTSv2) | 社区 fork 维护 |
| ChatTTS | Python API(可包成 CLI 脚本) | 完全免费 | 支持 | 中英文优化 | 多说话人 | 活跃(28k+ stars) |
| OpenAI TTS | REST API(curl) | 付费(按字符) | 不支持 | 支持(30+ 语言) | 不支持 | 官方维护 |
Piper TTS:最快的本地 CLI TTS 引擎
Piper TTS 由 Open Home Foundation 旗下项目出品,是一个用 C++ 编写的快速本地神经 TTS 引擎。需要留意的是,它的原仓库 rhasspy/piper 已于 2025 年 10 月归档为只读,开发迁移到了新仓库 OHF-Voice/piper1-gpl,截至 2026 年 9 月仍在正常发版(最新 v1.8.0),工具本身可以放心用。它的核心优势是极简的 CLI 接口,单行命令就能从文本生成语音:
echo 'Welcome to the world of speech synthesis!' | ./piper --model en_US-lessac-medium.onnx --output_file welcome.wav
Piper 基于 VITS 模型架构,导出为 ONNX 格式,专为树莓派这样的低功耗设备优化,在普通 x86 机器上几乎瞬间完成合成。
优点: 速度极快、无依赖(单二进制文件)、优化了低功耗场景。 缺点: 模型以英文为主,中文模型质量一般;不支持声音克隆;每个语音模型独立下载。 适合: 只需要英文语音合成,且希望嵌入 shell 脚本或 CI/CD 管线的开发者。
Kokoro TTS:真正的全功能 CLI TTS 工具
如果说哪个项目的 CLI 体验最接近 ElevenLabs CLI 的「开箱即用」,Kokoro TTS(nazdridoy/kokoro-tts)是目前最完整的答案。它不仅提供了标准的命令行接口,还支持通过 stdin 接受管道输入,这对脚本集成极为重要:
echo 'Kokoro TTS supports stdin piping from other programs.' | kokoro-tts --voice af_bella --output output.wav
核心参数一览:
--voice选择音色(支持美式英语男声/女声、英式英语、日语、韩语、中文等)--speed控制语速--split_pattern支持分段生成--input_file直接传入 EPUB、PDF 或 TXT 文件--output_dir指定输出目录
这款工具基于 Kokoro 82M 参数模型(StyleTTS 2 架构),采用 Apache 2.0 开源许可证,商业使用无限制。它不需要 GPU,在标准 CPU 上即可实时合成。
优点: 真正原生 CLI、支持管道和多格式文件输入、多语言含中文、CPU 可运行。 缺点: 不支持声音克隆(仅语音融合);模型体积较小,音质不如大模型。 适合: 需要中文语音输出、想在终端里批量转换文档为语音的用户。
Fish Speech:零样本克隆的 API 路线
Fish Speech(fishaudio/fish-speech)是目前开源社区最活跃的零样本语音克隆项目之一。它本身以 Python 库和 Web API 形式提供,但通过内置的 API 服务可以用 curl 轻松集成到命令行管线:
curl http://localhost:8000/audio/speech \
  -X POST \
  -F model="fish-speech-1.5" \
  -F voice="english-nice" \
  -F input="This is a test of Fish Speech API." \
  --output speech.wav
Fish Speech 1.5 版本支持 13 种语言(中英日韩等),零样本克隆只需数秒参考音频。它也可以在 Docker 容器中运行,非常适合部署到服务器然后通过 curl 远程调用。
优点: 零样本声音克隆效果好、多语言、REST API 标准接口、Docker 一键部署。 缺点: 需要 GPU 才能获得实时推理速度;配置门槛高于 Piper 和 Kokoro。 适合: 需要声音克隆、有 GPU 资源、喜欢 REST API 集成方式的开发者。
Coqui TTS:经典开源方案的选择
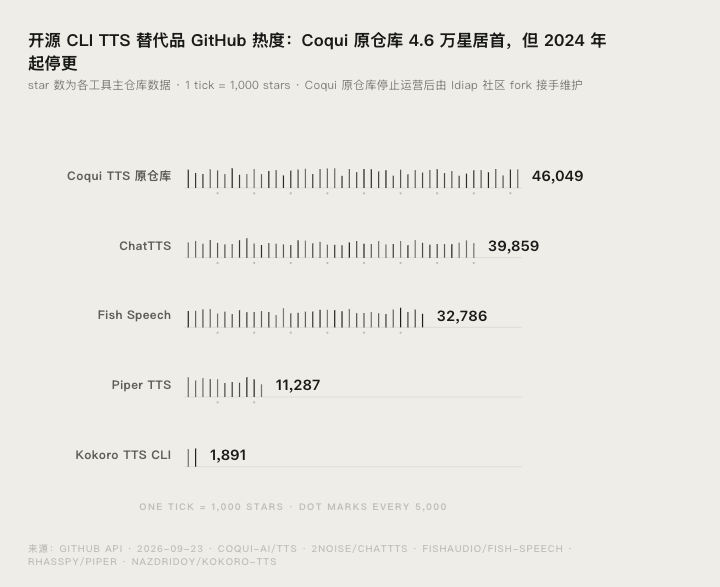
Coqui TTS 曾经是开源 TTS 领域最知名的项目(20.5k GitHub stars)。原仓库由 Coqui AI 公司维护,但公司已于 2024 年初停止运营,原仓库最后提交停在 2024 年 8 月。好消息是社区接手了维护,新的 PyPI 包 coqui-tts 0.25.0 已经发布,支持 macOS 和 Windows 的预编译 wheel。
Coqui TTS 本身是 Python 库,但可以通过几行脚本包装成命令行工具:
# 安装
pip install coqui-tts

# 命令行调用示例(一行 Python)
python -c "from TTS.api import TTS; TTS('tts_models/zh-CN/baker/tacotron2-DDC-GST').tts_to_file('你好,这是一段中文语音测试。', file_path='output.wav')"
XTTSv2 是它目前最强的模型,支持 17 种语言和语音克隆,流式延迟低于 200ms,还支持音色微调(fine-tuning)。
优点: 语言覆盖面最广(1100+ 语言预训练)、XTTSv2 质量优秀、社区活跃。 缺点: 原公司已停止运营、依赖 Python 环境(非原生 CLI)、安装依赖较多。 适合: 不介意写几行 Python 包装、需要多语言支持且希望保留训练能力的开发者。
ChatTTS:对话场景的中文优化方案
ChatTTS 由 2noise 团队于 2024 年 6 月开源,GitHub 三日内斩获 9.2k stars,目前稳定在 28k+。它专为对话场景优化,中英文混读自然度极佳,支持笑声、停顿、语气词等副语言控制:
import ChatTTS
chat = ChatTTS.Chat()
chat.load_models()

texts = ["ChatTTS 是一款强大的对话式文本转语音模型。它有中英混读和多说话人的能力。"]
wavs = chat.infer(texts)
torchaudio.save("output.wav", torch.from_numpy(wavs[0]), 24000)
它同样可以通过 Python 脚本包装为 CLI 调用,适合需要批量生成对话式语音的场景。
优点: 中文自然度极高(目前开源 TTS 中最佳之一)、细粒度韵律控制(笑声/停顿/语速)、多说话人。 缺点: 没有原生 CLI 工具、需要 Python 和深度学习框架环境、不支持声音克隆(官方后续计划中)。 适合: 中文短视频配音、播客开场白、对话流内容生成的用户。
OpenAI TTS API:最高音质的云端方案
如果你愿意支付费用,OpenAI 的 TTS API 是音质天花板。通过一行 curl 就能调用:
curl https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "这是一段中文测试语音。",
    "voice": "alloy",
    "response_format": "wav"
  }' \
  --output speech.wav
OpenAI 当前推荐使用 gpt-4o-mini-tts 模型,速度快、性价比高。它支持 30+ 种语言、6 种预设音色,延迟通常在 1-2 秒内。
优点: 音质最高最稳定、多语言支持好、curl 一行搞定。 缺点: 按字符计费、必须联网、不支持声音克隆(仅预设音色)。 适合: 预算充足、追求音质且不介意云端调用的团队。
场景化选型建议
场景一:你只要英文语音,追求最简单的 CLI 体验
选 Piper TTS。 单二进制文件,echo 管道输入输出 WAV,不需要 Python、不需要 GPU、不需要网络,一条命令搞定。
场景二:需要中文语音,预算为零
选 Kokoro TTS 或 ChatTTS。 Kokoro 有原生 CLI 且 CPU 可跑,上手最快;ChatTTS 中文自然度更高但需要 Python 环境,也多一道包装步骤。
场景三:需要声音克隆,有 GPU
选 Fish Speech 或 Coqui TTS。 Fish Speech 的 REST API 接口更标准,集成到 CI/CD 更顺手;Coqui XTTSv2 的微调能力更适合定制专属音色。
场景四:团队项目,可以付费,追求最高音质
选 OpenAI TTS 或 ElevenLabs CLI。 音质天花板,API 文档完善,但成本和数据隐私需要权衡,如果涉及用户数据出境敏感场景则优先考虑本地方案。
迁移成本说明
从 ElevenLabs CLI 切换到开源替代品需要评估以下投入:
- 环境搭建:Piper 是零安装优势最突出(单二进制),Coqui 和 ChatTTS 则需要 Python + PyTorch 环境,初期配置时间 30-120 分钟。
- 管线改造:如果现有脚本基于
@elevenlabs/cli命令,需要改写为 curl/Python 调用。Piper 和 Kokoro 的管道式 CLI 改造工作量最小。 - 音质调校:开源方案在部分语种(如中文)上已经接近商用水平,但如果你的应用对自然度要求极高(如客服外呼、有声书),需要先做 A/B 测试确认可接受。
- 维护负担:开源方案需要自己管理模型更新和依赖安全,云端方案(OpenAI/ ElevenLabs)则不需要操心这些。
关于国内网络环境和支付问题,可以参考 ElevenLabs 国内网络与支付指南。
常见问题
ElevenLabs CLI 和这些替代品有什么本质区别?
答:ElevenLabs CLI(`@elevenlabs/cli`)是 ElevenLabs 官方发布的 npm 包,用于在终端管理语音 Agent 和生成语音,需要 API Key 且必须联网。而替代品中 Piper 和 Kokoro 是完全本地离线运行的,OpenAI TTS 是通过 REST API 调用的云端方案。从命令行体验来说,Piper 和 Kokoro 提供了类似甚至更简洁的原生 CLI 接口。
这些替代品里有不需要 GPU 就能跑的吗?
答:Piper 和 Kokoro TTS 在 CPU 上就能流畅运行。Piper 专为树莓派 4 设计,在普通 x86 机器上几乎是瞬时输出。Kokoro 的 82M 参数模型在标准 CPU 上也能实现实时合成。ChatTTS 和 Coqui TTS 的大模型在 CPU 上能跑但速度较慢,建议有 GPU 时使用。Fish Speech 强烈建议使用 GPU。
中文语音质量最好的是哪个?
答:从自然度来看,ChatTTS 的中文表现是目前开源方案中最好的,专为对话场景优化,中英文混读流畅自然。Cocoui TTS 提供了中文预训练模型(如 baker/tacotron2),音质也不错但偏朗读感。Kokoro 支持中文但音色库相对有限。如果你追求最高中文音质且预算充足,OpenAI TTS 和 ElevenLabs 的多语言模型仍然是天花板。
这些工具能嵌入 Shell 脚本或 CI/CD 流水线吗?
答:可以。Piper 和 Kokoro TTS 是原生 CLI,直接嵌入 shell 脚本最方便。Fish Speech 和 OpenAI TTS 通过 curl 调用 REST API,同样适合 CI/CD。Coqui 和 ChatTTS 需要通过 Python 包装,但写成独立脚本后也能用。建议的做法是将命令行调用包装成 Makefile 或 npm script,统一管线入口。
这些开源工具可以商用吗?合规上需要注意什么?
答:Piper 采用 MIT 协议(部分模型使用 BSD),可商用无限制。Kokoro TTS 采用 Apache 2.0 许可,商用免费。Coqui TTS 采用 MPL-2.0 / CPOL 协议,需注意衍生作品的版权声明。ChatTTS 开源版(4万小时数据未 SFT)可用于研究,商用需联系 2noise 团队获取授权。Fish Speech 采用 CC-BY-NC-SA 4.0,禁止商用,如需商用需联系 fishaudio 获取商业许可。**商用前务必阅读各项目的 LICENSE 文件确认。**
我有 GPU 但显存只有 8GB,能跑 Fish Speech 或 ChatTTS 吗?
答:8GB 显存可以跑 Fish Speech 1.5 的推理,VITS 模型在 8GB 下能正常运行。ChatTTS 的最大模型在 8GB 显存下也能完成推理,建议使用 FP16 降低显存占用。如果不放心,Piper 完全不需要 GPU,是 8GB 显存用户的零风险选择。
 京ICP备2024094994号-29