
DeepSeek V4.1 Flash API Key 配置:3步跑通
DeepSeek V4.1 Flash API Key 配置 3 步:创建 Key、确认模型名与 base_url、跑通第一次调用。全程 10 分钟,按 token 计费,缓存命中时输入价格很低。
本文所有参数与价格来自 DeepSeek 官方 API 文档、官方模型价格页 与 Hugging Face 上的 DeepSeek-V4.1-Flash 模型卡。
前置准备:账号、余额与网络
开始之前先确认三件事:
- 账号。登录 DeepSeek 开放平台 platform.deepseek.com,用手机号或邮箱注册即可,不需要企业认证。
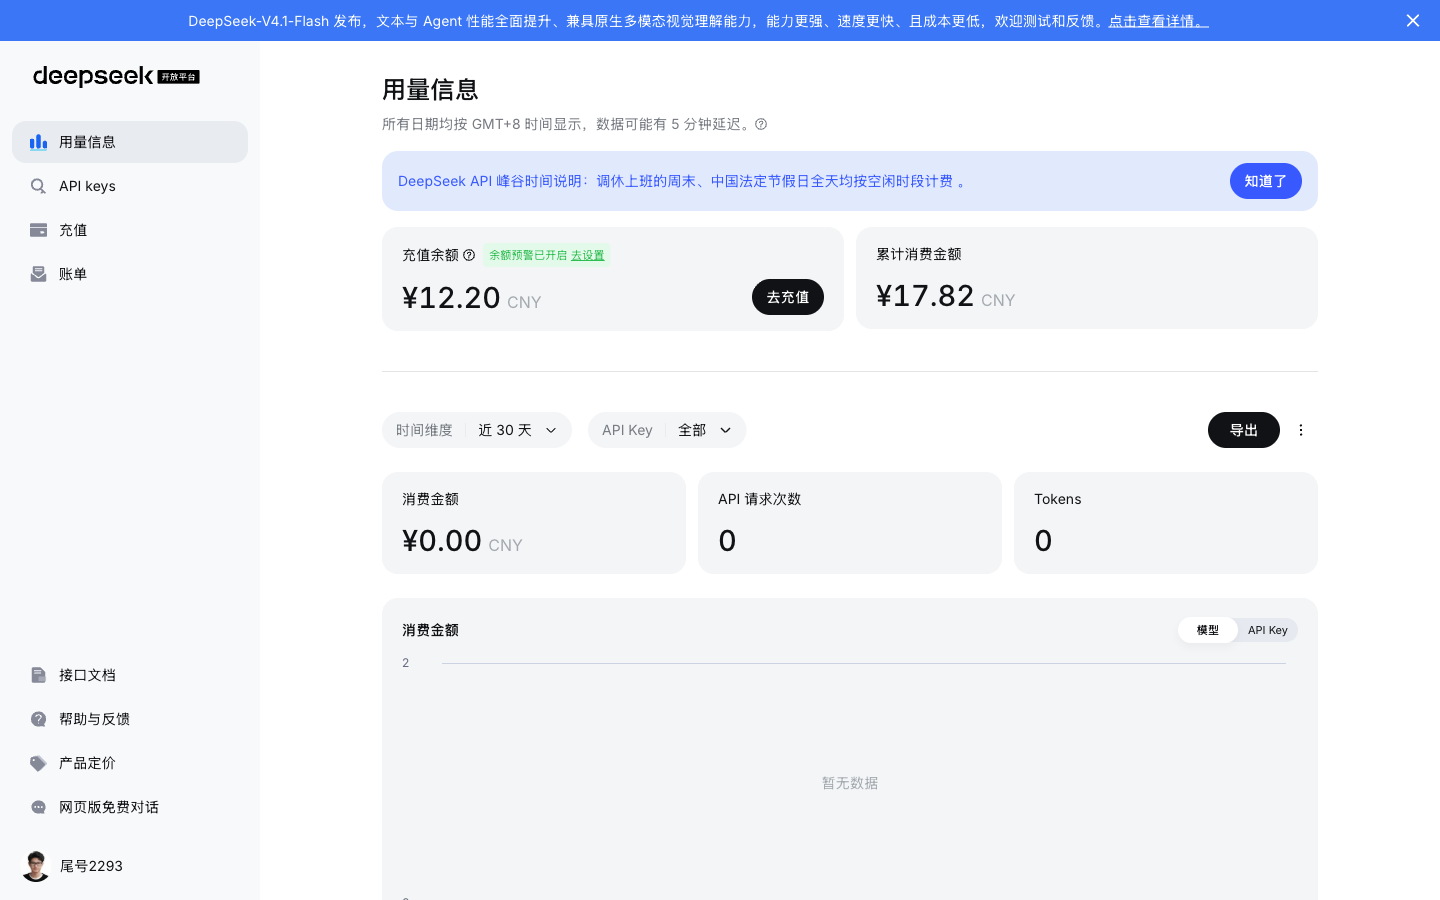
- 余额。接口按 token 扣费,费用从你充值的余额中扣除;如果账户里有赠送余额,官方会优先扣赠送的部分。所以建议先充一点钱再调用,否则会直接返回 402。
- 网络。api.deepseek.com 在国内可以直连,不需要额外代理,这一点对本地开发很省事。
环境方面,用来验证的方式三种任选:直接 curl、Python 3.8 以上、Node.js 18 以上。只做第一次连通性测试的话,curl 最快。
第一步:在开放平台创建 API Key
- 打开 platform.deepseek.com 并登录。
- 进入 API Keys 管理页面,点创建新的 API Key。
- 给 Key 起一个能认出用途的名字,例如项目名或机器名,方便以后按 Key 单独吊销和排查用量。
- 创建后立刻复制保存。大多数平台的 Key 只在创建时完整显示一次,关掉弹窗就再也看不到了。
两条安全习惯值得从一开始就养成:Key 不要写进代码里再推到 Git 仓库,也不要在前端页面里调用接口。正确的做法是放在服务端的环境变量里,由后端转发请求。
第二步:确认模型名和 base_url
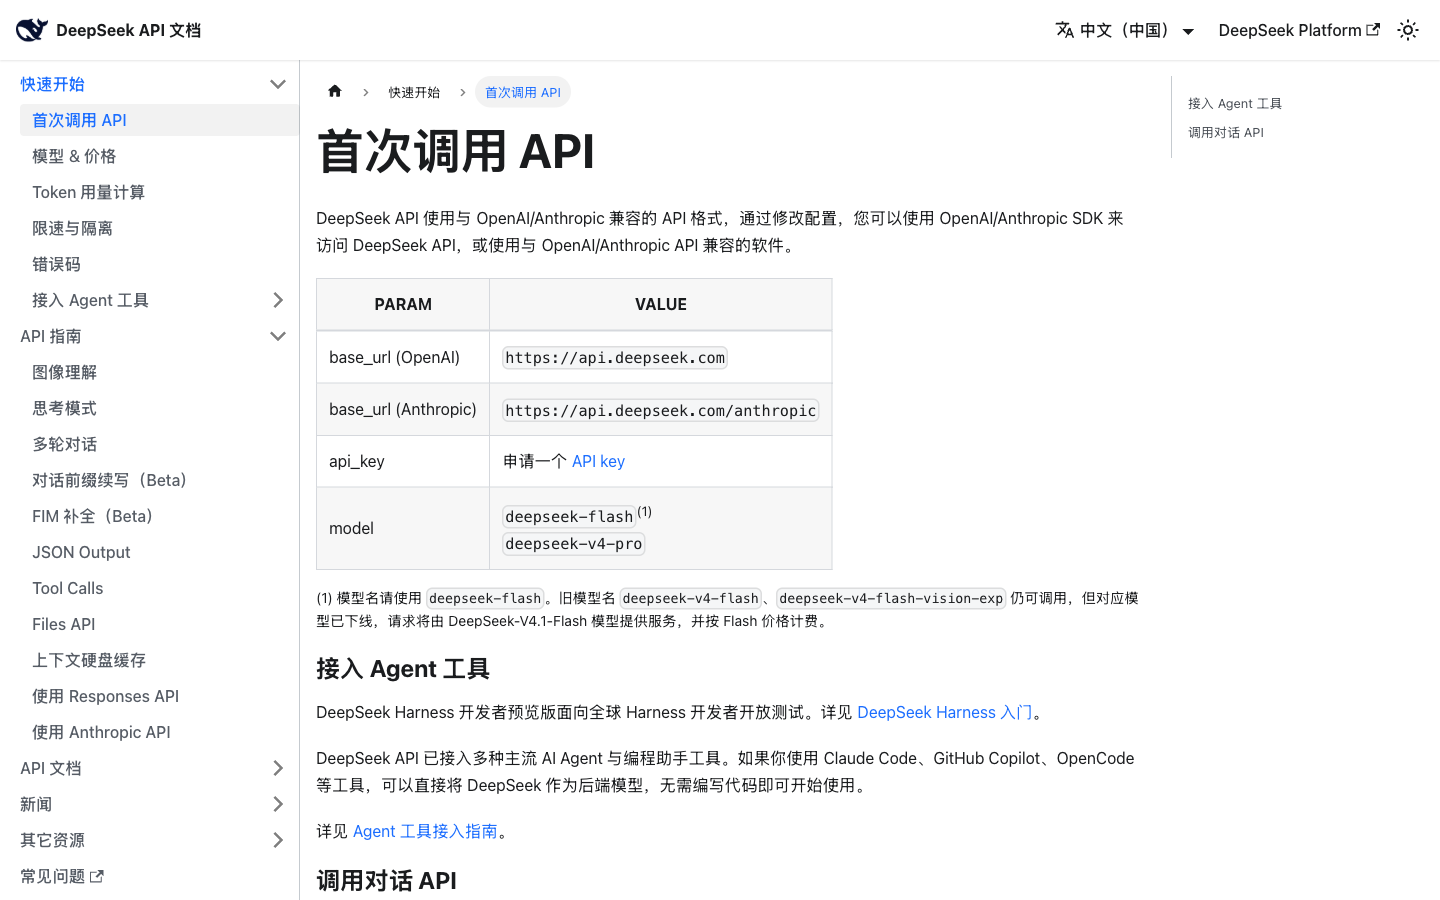
这一步是最容易出错的地方,参数写错就会出现 401 或 404。DeepSeek 的接口格式与 OpenAI、Anthropic 兼容,所以核心只有四个值:
| 参数 | 取值 |
|---|---|
| base_url(OpenAI 格式) | https://api.deepseek.com |
| base_url(Anthropic 格式) | https://api.deepseek.com/anthropic |
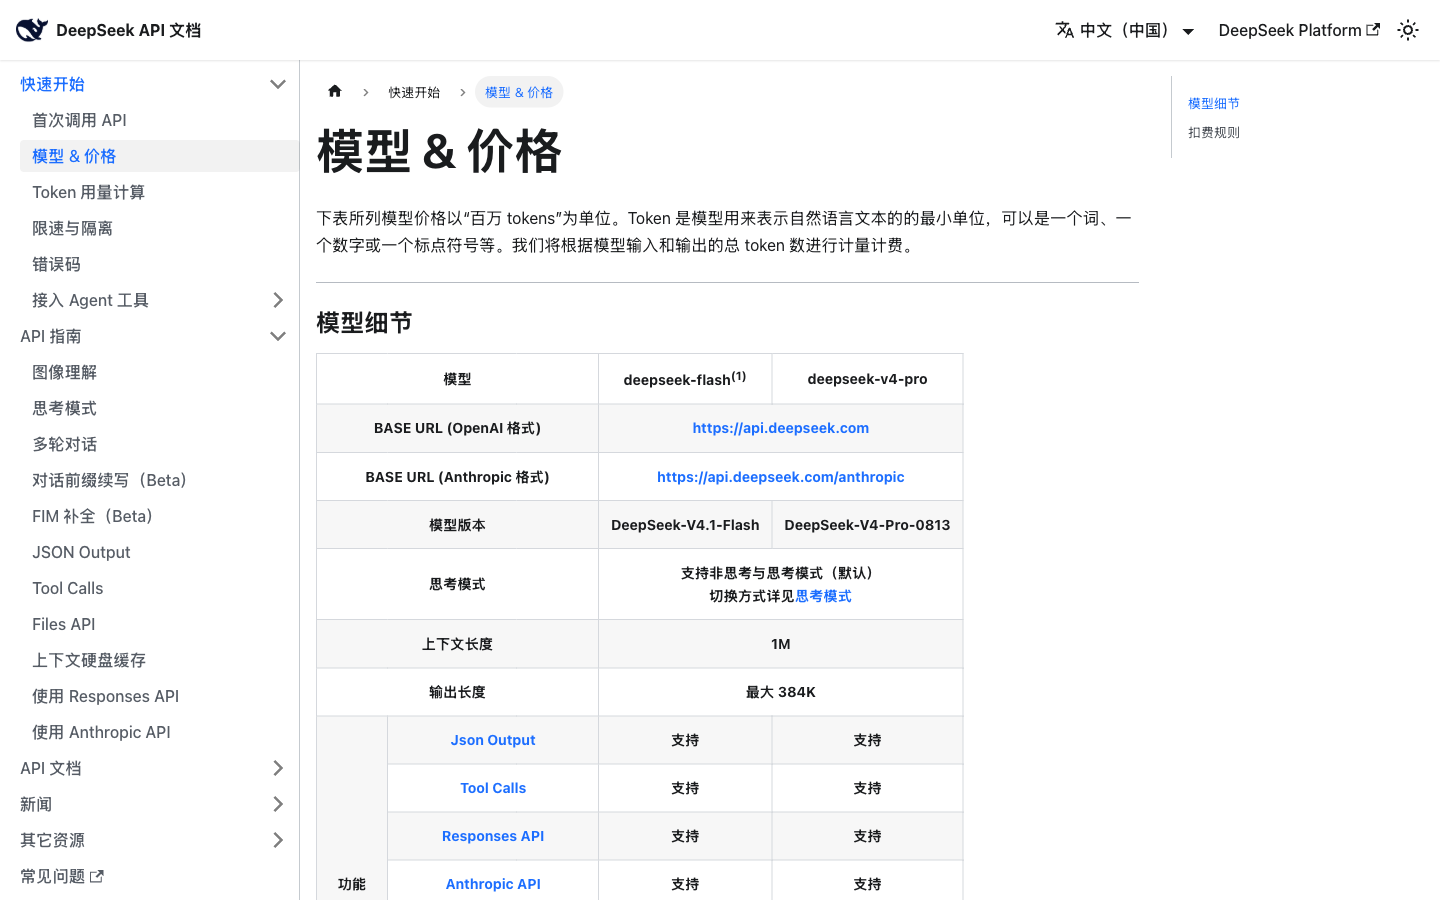
| 模型名(Flash) | deepseek-flash |
| 模型名(Pro) | deepseek-v4-pro |
鉴权方式是 HTTP Bearer,也就是在请求头里带上 Authorization 字段,值为 Bearer 加空格加你的 Key。
有一个坑必须提前说清楚:旧的模型名 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 目前仍然可以调用,但官方已明确对应的模型下线,请求实际会由 DeepSeek-V4.1-Flash 提供服务,并按 Flash 的价格计费。也就是说旧名字能跑通,但语义已经变了,新项目请直接用 deepseek-flash。
如果你在 Flash 和 Pro 之间犹豫,可以先看我们对 DeepSeek V4.1 Flash 和 V4 Pro 的价格与能力对比。
第三步:写入环境变量并跑通第一次调用
先设置环境变量,避免 Key 出现在命令历史里:
export DEEPSEEK_API_KEY="你的 API Key"
然后选一种方式发第一个请求。
方式一:curl
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-flash",
        "messages": [
          {"role": "system", "content": "You are a helpful assistant."},
          {"role": "user", "content": "Hello!"}
        ],
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
        "stream": false
      }'
方式二:Python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com",
)

resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "用一句话解释 KV cache 压缩"}],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)

print(resp.choices[0].message.content)
方式三:Node.js
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.deepseek.com",
  apiKey: process.env.DEEPSEEK_API_KEY,
});

const completion = await client.chat.completions.create({
  model: "deepseek-flash",
  messages: [{ role: "user", content: "你好" }],
  stream: false,
});

console.log(completion.choices[0].message.content);
三个例子里都用到了两个可选参数:thinking 用来开启或关闭思考模式,reasoning_effort 用来控制推理投入程度。Flash 支持 1 到 100 的连续取值,投入越高越准确,消耗也越多。
怎么判断配置成功
成功的判据很简单:HTTP 状态码是 200,返回体里 choices 数组第一项的 message.content 有正常文字,而不是报错信息。如果开了思考模式,返回里还会额外带一段模型的推理过程,那属于正常现象。
模型卡里还给了推荐的采样参数,照着配能少踩坑:temperature 取 1.0,top_p 取 0.95 或 1.0,上下文窗口 1M token,max_tokens 建议不低于 256K。
费用怎么算:官方价格表
DeepSeek 的价格分高峰和低峰,低峰价是高峰价的一半。高峰时段是 UTC 时间的周一到周五 01:00 到 04:00 与 06:00 到 10:00,不含中国法定节假日;其余时间都算低峰,周末与法定节假日全天低峰。
单位是美元每百万 token:
| 项目 | flash 低峰 | flash 高峰 | pro 低峰 | pro 高峰 |
|---|---|---|---|---|
| 输入(缓存命中) | 0.003 | 0.006 | 0.022 | 0.044 |
| 输入(缓存未命中) | 0.15 | 0.3 | 0.66 | 1.32 |
| 输出 | 0.6 | 1.2 | 1.98 | 3.96 |
两个结论对你很有用。第一,把批量任务挪到低峰时段跑,成本直接减半。第二,命中上下文缓存时输入价格只有未命中的五十分之一,多轮对话和长文档重复提问这类场景,缓存收益非常可观。
另外 Flash 的并发上限是 2500,Pro 是 500。做批量任务时按这个数字规划并发,别把请求一次性全打出去。
常见报错速查
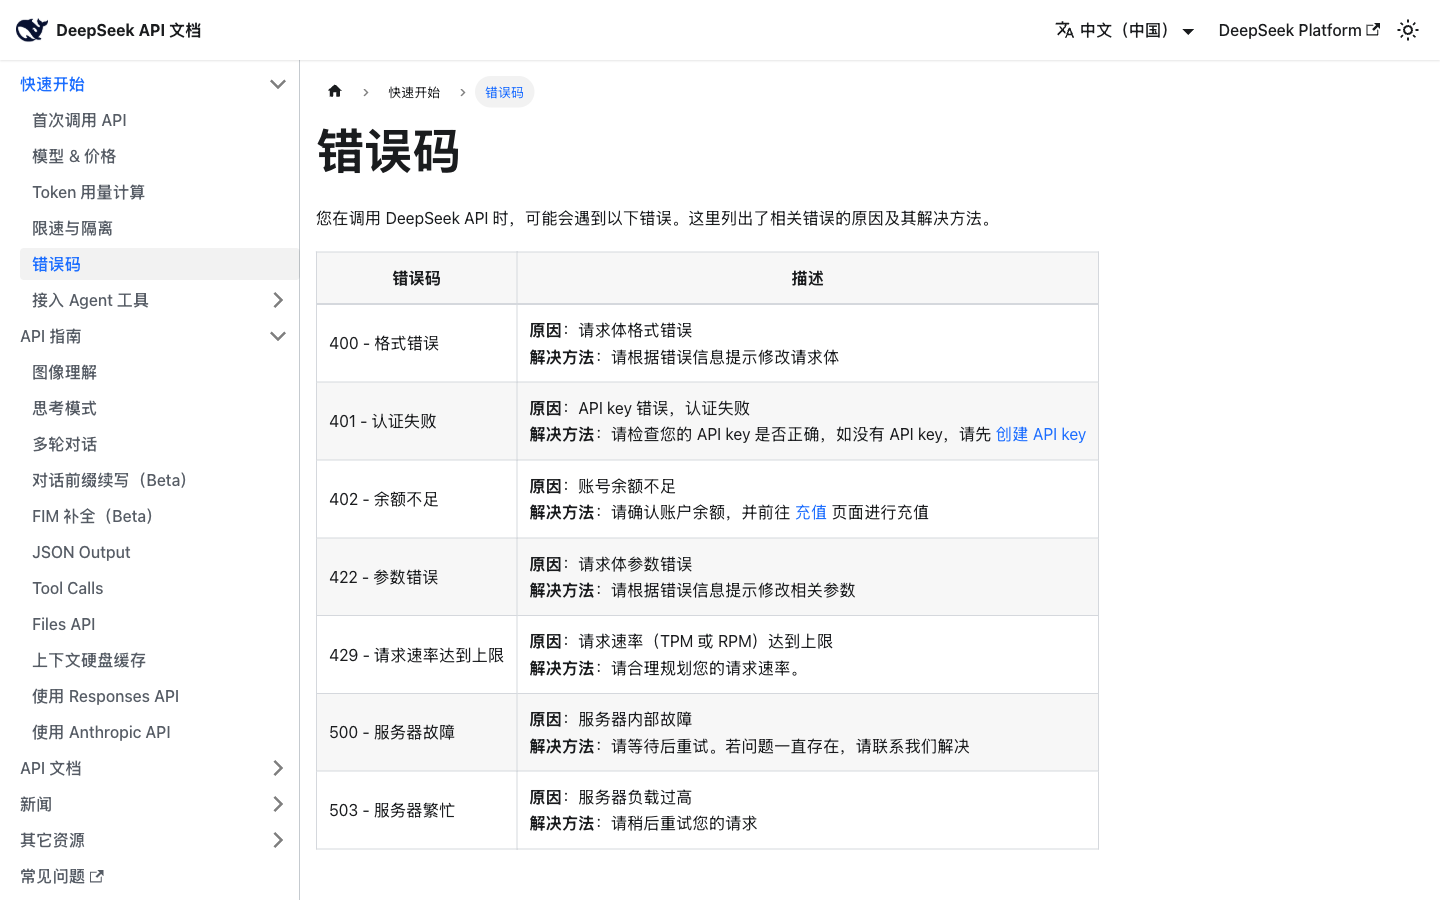
官方文档给出的错误码只有七个,对着表排查基本都能定位:
| 报错码 | 含义 | 常见原因与解法 |
|---|---|---|
| 400 | 请求体格式错误 | 请求体不是合法 JSON,检查引号与逗号 |
| 401 | 认证失败 | API Key 写错或没带 Authorization 头,确认 Key 前后没有多余空格 |
| 402 | 余额不足 | 账户没充值,去充值页面补上余额 |
| 422 | 参数错误 | 模型名写错,或参数类型不对,例如 reasoning_effort 传了非法值 |
| 429 | 请求速率达到上限 | 触发了 TPM 或 RPM 限制,降低并发或加重试退避 |
| 500 | 服务器内部故障 | 等一会儿重试 |
| 503 | 服务器繁忙 | 稍后重试 |
实测下来,401 和 422 占了绝大多数。401 常见于从聊天窗口复制 Key 时带上了看不见的空格,422 常见于模型名写成旧名字或者自己拼的名字。
进阶:把 DeepSeek 接到编程工具里
如果你本来就在用 AI 编程工具,不用写代码也能切到 DeepSeek。官方文档明确支持 Claude Code、GitHub Copilot、OpenCode 这类工具直接把 DeepSeek 作为后端模型,配置时把 base_url 指向 api.deepseek.com,需要 Anthropic 格式的工具就换成 api.deepseek.com/anthropic。
同类配置我们写过几篇,思路可以互相参照:Grok 4.8 API Key 配置步骤、Kimi K2.8 Preview API Key 配置、ElevenLabs CLI API Key 配置避坑。
还有一个效率细节:DeepSeek 这次没有随权重发布 Jinja 格式的对话模板,官方在仓库的 encoding 目录里给了 Python 参考实现,另外单独开源了 deepseek-recipe 工具库,负责把消息、请求编码成 V4 与 V4.1 的 prompt 或 token。自己搭推理链路时,用这个库比手写拼接可靠得多。
常见问题
DeepSeek API 有免费额度吗?
答:没有固定免费额度,接口按 token 计费,费用从充值余额里扣。如果账户里有官方赠送的余额,会优先扣赠送部分。
deepseek-flash 和 deepseek-v4-flash 有什么区别?
答:deepseek-flash 是当前推荐的模型名,对应的就是 DeepSeek-V4.1-Flash。deepseek-v4-flash 是旧名字,仍然可以调用,但对应模型已下线,请求实际由 V4.1-Flash 提供服务,按 Flash 价格计费。
国内能直接调用 DeepSeek 的 API 吗?
答:可以。api.deepseek.com 在国内可直连,不需要代理,用手机号或邮箱注册开放平台账号即可。
为什么账单比预估的贵?
答:先看两件事。一是高峰时段价格是低峰的两倍,批量任务可以挪到低峰跑;二是如果没命中上下文缓存,输入按未命中价计费,比命中价贵约五十倍,多轮对话里保持前缀稳定能显著省钱。
reasoning_effort 该怎么设置?
答:它是 1 到 100 的连续值,投入越高越准确、消耗越多。简单问答用低值,复杂推理或代码任务再调高,官方评测的满配是 100。
API Key 泄露了怎么办?
答:立刻去开放平台的 API Keys 页面吊销那个 Key,再新建一个替换。调用的 Key 都按名字区分用途,就是为了这种时候能精确定位和吊销,不影响其他服务。
 京ICP备2024094994号-29