
Claude Sonnet 5.5 发布:跑分逼平 Opus 5.5,价格与上代持平
2026 年 9 月 28 日,Anthropic 正式发布 Claude Sonnet 5.5,这是 Claude 5.5 家族的第二款模型。它比上一代 Sonnet 5 输出速度快 30% 以上,完成同样的任务最多便宜 30%,多项跑分已经逼平自家旗舰 Opus 5.5,而 token 单价维持不变:每百万 token 输入 2 美元、输出 10 美元。
简单说:日常编码、修 bug、写文档做表格这类活,Sonnet 5.5 可以直接顶上;只有复杂开放的大任务才需要 Opus 5.5。
本文整理了它的完整跑分对比、价格明细、发布时间线和真实用户反馈。更多模型动态可以在 AI345 的 AI 资讯 持续跟踪。
目录
- Claude Sonnet 5.5 是什么
- 发布时间线:一周内从爆料到上线
- 跑分对比:编码能力跃升最猛
- 价格:单价不变,账单更省
- 真实用户反馈
- 和 Sonnet 5、Opus 5.5 怎么选
- 在哪里能用
- 常见问题
Claude Sonnet 5.5 是什么
Claude Sonnet 5.5(model ID:claude-sonnet-5-5)是 Anthropic Claude 5.5 家族的中档模型,官方定位是 Opus 5.5 的「快速低价互补」。
两个模型的分工很明确:Opus 5.5 负责需要持续判断力的复杂工作,Sonnet 5.5 主打范围清晰的日常任务,比如修 bug、写文档、做幻灯片和电子表格,官方还特别强调它对界面设计的审美。家族第三款 Claude Haiku 5.5 将在未来几周发布,负责高吞吐、成本敏感的场景。
默认上下文窗口 200k token,最大可扩展到 1M,支持思考模式(thinking)。配合缓存读取只要每百万 token 0.2 美元的定价,构建超长上下文的常驻助手在成本上首次变得可行。
Claude Sonnet 5.5 发布时间线:一周内从爆料到上线
这次发布节奏非常快,把公开信息按时间串起来看更清楚:
- 9 月 22 日:Anthropic 发布 Opus 5.5,官方文档里顺手预告「Sonnet 5.5 和 Haiku 5.5 将在未来几周内推出」。
- 9 月 27 日前后:开发者 @Mr_Salio 在前端配置文件里抓到了 claude-sonnet-5-5 的模型标识符,同文件里还躺着 claude-opus-5-5 和 claude-sonnet-5,说明模型已经实装到服务器。另一位开发者 @notjazii 爆料,部分用户的请求其实早在一周前就被悄悄路由到 5.5 做暗测。
- 9 月 28 日:正式发布,AWS、Google Cloud、Azure 三大云平台同步上线。
- 9 月 29 日:OpenAI 举行年度 DevDay。发布卡在这个节点前一天,被普遍解读为对 OpenAI 价格战的正面回击。
顺便一提社区流传的「暗测自查法」:在 Claude Code 里关掉联网和记忆,问它「重置哥 tibo」的梗。如果它能讲出来龙去脉,说明你的请求已经被路由到了 5.5。这类野路子测试属于社区玩法,准确性以官方公告为准。
Claude Sonnet 5.5 跑分对比:编码能力跃升最猛
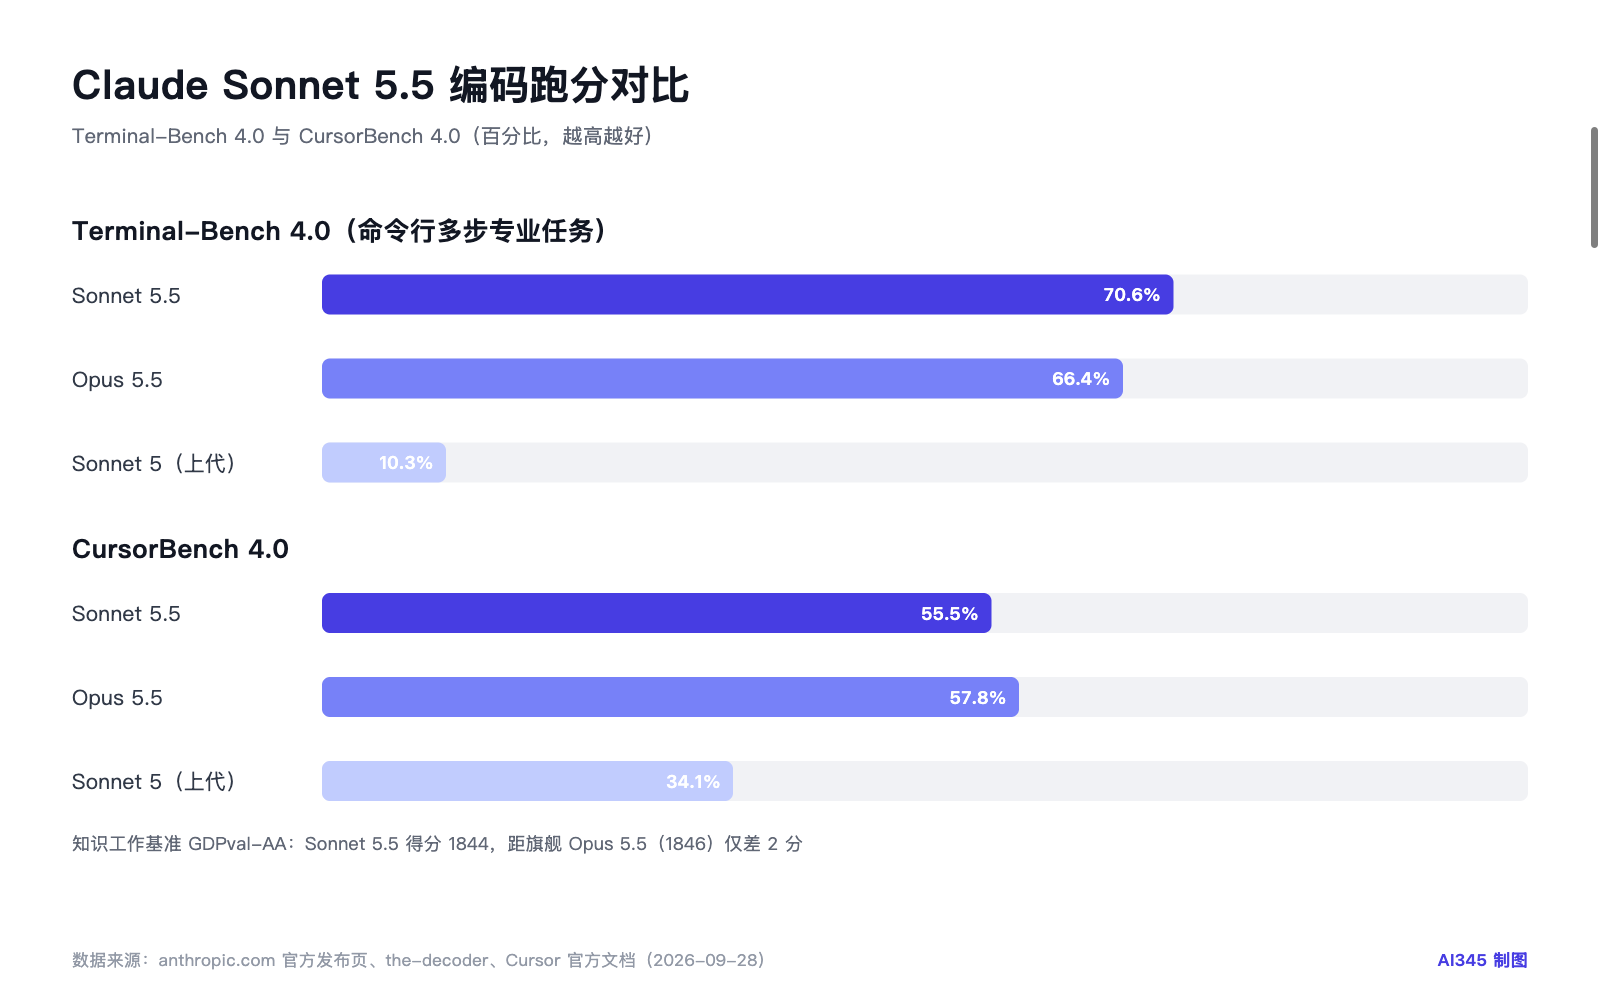
官方和 the-decoder 整理的完整跑分如下(分数越高越好):
| 类别 | 基准 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
| Agent 编码 | Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | 未公开 |
| Agent 编码 | FrontierCode 1.1 | 52.1%(Xhigh 档) | 42.4% | 54.4% | 49.3% |
| Agent 编码 | CursorBench 4.0 | 55.5% | 34.1% | 57.8% | 未公开 |
| 知识工作 | GDPval-AA | 1844 | 1449 | 1846 | 1487 |
| 知识工作 | AA Briefcase | 1811 | 1359 | 1822 | 1483 |
| 跨学科 | Humanity's Last Exam(带工具) | 64.5% | 54.9% | 67.7% | 未公开 |
| 电脑操作 | OSWorld 2.1(部分评估) | 80.1% | 57.0% | 81.8% | 未公开 |
| 图表识别 | Chartography(无工具) | 61.6% | 15.6% | 64.4% | 53.6% |
几个值得注意的点:
- Terminal-Bench 从 10.3% 到 70.6% 是这代最夸张的跃升,甚至超过了 Opus 5.5 的 66.4%。这个基准测的是模型在命令行里完成多步专业任务的能力。
- GDPval-AA 距离旗舰只差 2 分。这个 OpenAI 开发的基准覆盖 44 个职业的真实工作任务,Sonnet 5.5 拿到 1844 分,Opus 5.5 是 1846 分。
- 图表识别从 15.6% 跳到 61.6%,说明视觉理解短板被明显补齐。
- 它还是第一个只靠屏幕截图就能通关《Pokémon Red》的 Sonnet 模型,长程任务能力上了一个台阶。
需要泼一盆冷水的是:官方自己也承认,跑分只是能力的一个侧面,在复杂、开放、需要持续判断的任务上,Opus 5.5 仍然明显更强。另外社区发现一个怪现象:FrontierCode 上开到最高 effort(Max 档)反而比 Xhigh 档分数低,官方解释是 Max 档更频繁触发代码审查子代理拆分任务,偶尔导致超时或改动超出任务范围。跑分和设置细节,可以参考我们之前整理的 AI 指南 里的模型选择方法。
Claude Sonnet 5.5 价格:单价不变,账单更省
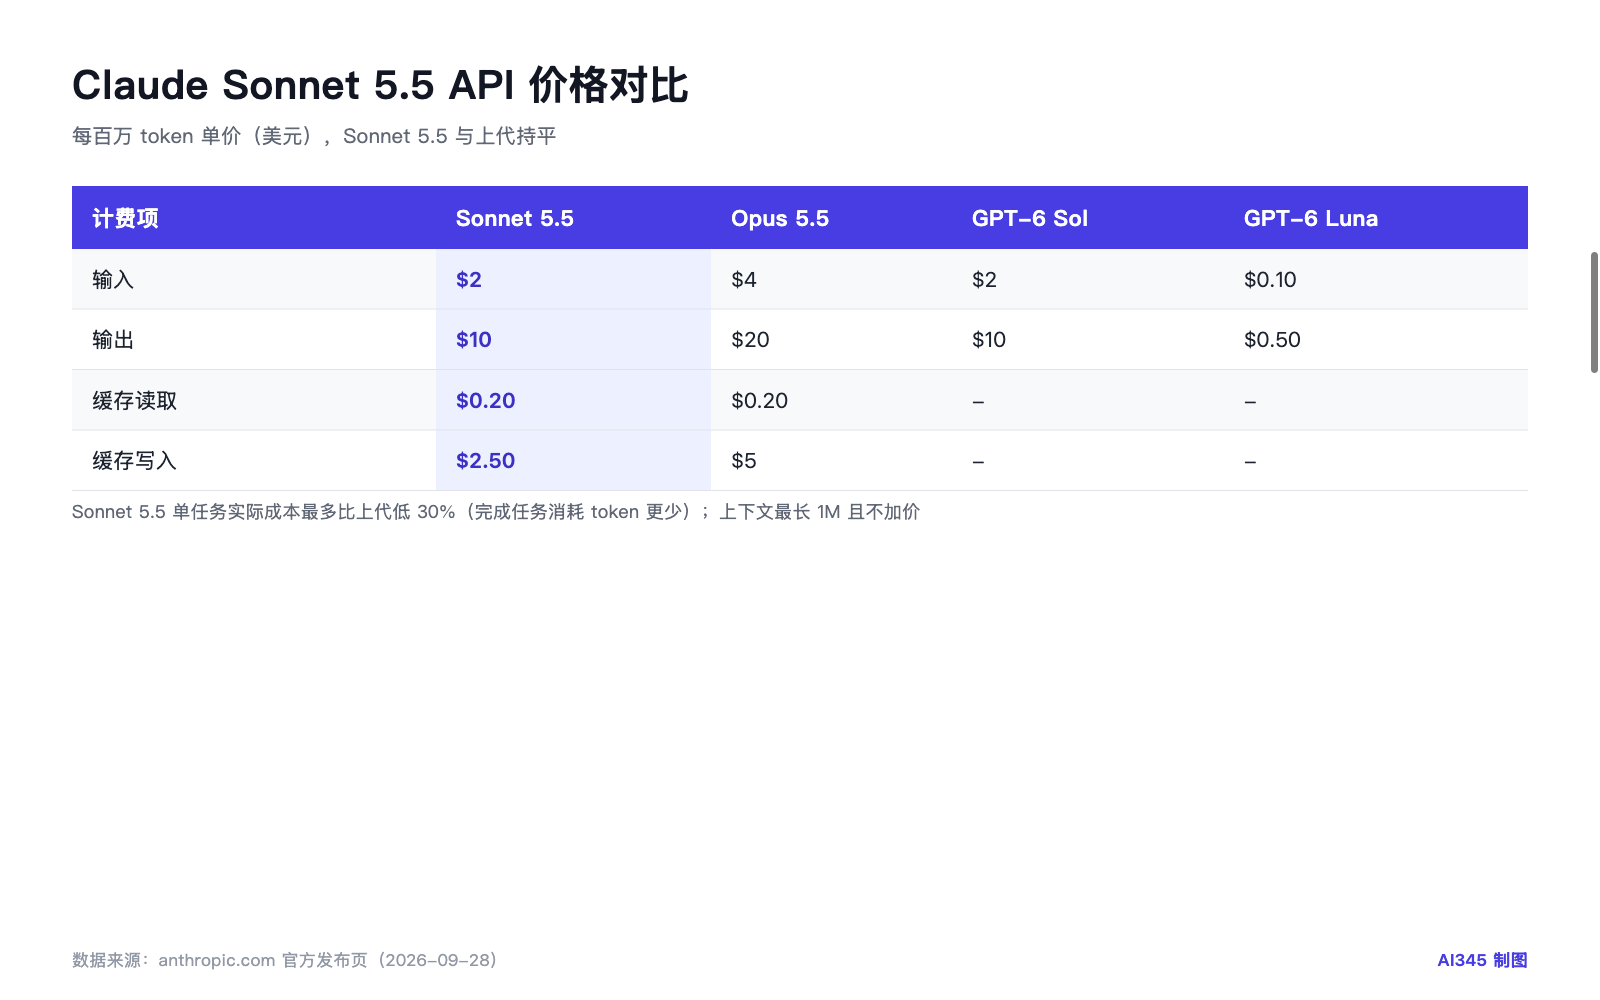
API 定价与 Sonnet 5 完全持平:
| 每百万 token | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| 输入 | $2 | $4 |
| 输出 | $10 | $20 |
| 缓存读取 | $0.20 | $0.20 |
| 缓存写入 | $2.50 | $5 |
省钱不在单价,在效率。官方测试显示它完成同样任务需要的 token 少得多,单任务实际成本最多比上代低 30%。早期客户的数据更直观:
- 资管公司 Balyasny 的 2441 项金融任务测试里,Sonnet 5.5 平均每个答案消耗约 121k token,Sonnet 5 要 497k。
- Slack 的离线评测显示输出 token 减少约 14%,步骤更少。
- Box 的测试里速度提升 2.4 倍,总 token 减少 12%。
再放上竞品价格一起看,格局更清楚:
| 每百万 token | Sonnet 5.5 | Opus 5.5 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| 输入 | $2 | $4 | $2 | $0.10 |
| 输出 | $10 | $20 | $10 | $0.50 |
OpenAI 在 GPT-6 Sol 和 Luna 上把价格砍到 GPT-5.6 的一半,Luna 甚至只卖 0.1 美元输入,用极低价抢高频场景。Sonnet 5.5 的应对思路不是跟着降价,而是「同价位给更强的性能」。谁更划算,取决于你的任务吃性能还是吃价格。
effort 档位怎么开最省钱
Sonnet 5.5 支持可调的 effort 档位(低、中、高、Xhigh、Max),这是最容易踩坑也最容易省钱的地方:
- 官方成本曲线显示,低档和中档就已经超过 Sonnet 5 的最佳成绩,成本只要约十分之一。日常任务不用开高档。
- Cursor 实测 max 档的成本约是默认 high 档的 6 倍,只在啃硬骨头时值得开。
- 超过 200k 的长上下文没有额外加价,按基础 token 单价计费。
真实用户反馈:快、省、有人味儿
归纳官方客户、X 社区和中文评论区的声音,正反面都有:
官方客户数据(来自 Anthropic 发布页):
- Base44 在 118 个真实应用构建中,Sonnet 5.5 平均 3.6 次迭代完成任务(Opus 5 需要 7.7 次),工具调用失败数是对比模型里最少的。
- CodeRabbit 反馈它不再像 Sonnet 5 那样动不动乱跳网页搜索,输出 token 明显变少。
- Unity 的多步任务基准里 90% 的任务通过了运行时验证。
- Zendesk 的工单处理速度快了 20%,Lovable 的编码评测里工具调用少了三分之一。
X 社区实测(经 IT之家转述):
- @notjazii 用同一提示词让四款模型生成复杂 UI 动效,Sonnet 5.5 的视觉完成度压过 GPT-6 Sol 和 Astra。
- @chetaslua 用 3 个提示词做 6 次并行实测:Sonnet 5.5 生成 90 至 131KB 的文件并触及 90 分钟时长上限,GPT-6 Sol 只产出 20 至 29KB、9 到 12 分钟就收工。他的评价是「快得离谱,而且找回了 Sonnet 4 时代那种自然的人味儿」。
- 开发者 Rajath Gowda 的判断流传最广:「Sonnet 5.5 正在成为 OpenAI 的一个大麻烦。」
中文评论区的真实反应(IT之家评论区):
- 有用户觉得「2 美元还是太贵」,也有人认为竞争加码是好事,用户受益。
- 国内访问依然是高频痛点,封号风险和区域限制的抱怨不少。
- 有网友注意到对比名单里没有 Gemini,好奇它的去向。
Claude Sonnet 5.5 和 Sonnet 5、Opus 5.5 怎么选
按场景对号入座:
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 日常编码、修 bug、写文档、做表格和幻灯片 | Sonnet 5.5 | 性能逼近旗舰,速度快 30%,单任务最多省 30% |
| 复杂架构设计、长程开放任务、高风险判断 | Opus 5.5 | 官方明确其在复杂任务上仍明显更强 |
| 海量高频、成本极敏感的调用 | 等 Haiku 5.5 或评估 GPT-6 Luna | Haiku 5.5 未来几周发布;Luna 单价低 20 倍 |
| 网络安全高风险请求 | 无需操作 | 会被自动重路由到 Sonnet 5,这是新增的防护机制 |
一个细节:因为 Sonnet 5.5 的网络安全能力已经接近 Opus 5,它是第一个上线网络安全防护的 Sonnet。涉及高风险网络安全任务的请求会被可见地重路由,符合资质的专业人士可以通过 Cyber Verification Program 申请分层访问。日常软件开发不受影响。
在哪里能用 Claude Sonnet 5.5
- Claude 应用与 Claude Code:网页端和桌面端可直接选模型,部分用户的请求此前已在灰度中被动切换。
- API:model ID 为 claude-sonnet-5-5,支持零数据保留(ZDR)。
- 云平台:AWS、Google Cloud Vertex AI、Microsoft Azure 已同步上线。
- 第三方工具:Cursor 等编码工具已接入,在模型列表里选择即可。
需要注意,Anthropic 官方支持区域不包含中国大陆,国内用户访问和账号稳定性一直是社区讨论的焦点,这个现状在 Sonnet 5.5 上没有变化。工具选型可以参考 AI345 的 AI 工具导航。
总结
Sonnet 5.5 的发布逻辑很清晰:不追新跑分纪录,而是把接近旗舰的能力压到中档价位。编码跑分逼平 Opus 5.5、速度提升 30%、单任务成本最多省 30%,对天天用 Claude Code 和 Cursor 的开发者来说,这是实打实的账单变化。
接下来两周值得盯两件事:Haiku 5.5 会把这条产品线补齐到第三档;OpenAI 在 DevDay 上如何回应这场价格与性能的贴身战。以上信息基于发布首日的公开资料,后续变动以官方公告为准。
本文由 AI345 整理,最后更新于 2026 年 9 月
常见问题
Claude Sonnet 5.5 多少钱?
答:API 定价与 Sonnet 5 持平,每百万 token 输入 2 美元、输出 10 美元、缓存读取 0.2 美元。因为完成任务消耗的 token 更少,实际单任务账单最多能省 30%。
Claude Sonnet 5.5 和 Opus 5.5 怎么选?
答:日常编码和文档类工作选 Sonnet 5.5 就够,性价比明显更高。需要长程复杂判断、架构级设计或开放性强的任务时,Opus 5.5 仍然更强,官方和外部测试者都确认了这一点。
上下文窗口多大?超过 200k 要加钱吗?
答:默认上下文 200k token,最大可扩展到 1M。长上下文没有单独的加价系数,超过 200k 的部分仍按基础 token 单价计费,这一点比很多竞品友好。
它比上一代 Sonnet 5 强多少?
答:编码能力跃升最大,Terminal-Bench 4.0 从 10.3% 升到 70.6%,输出速度快 30% 以上,图表识别从 15.6% 升到 61.6%。知识工作类基准(GDPval-AA)提高了约 400 分。
effort 档位开到最高更好吗?
答:不一定。低档和中档就已经超过 Sonnet 5 的最佳成绩,成本只有约十分之一;max 档成本约是默认高档的 6 倍,而且在 FrontierCode 上分数反而低于 Xhigh 档。日常任务建议从中低档起步。
国内能用 Claude Sonnet 5.5 吗?
答:Anthropic 官方支持区域不含中国大陆,国内用户访问 Claude 应用存在区域限制和账号风险,这一代没有变化。开发者可以通过 AWS、Google Cloud、Azure 的海外区域调用 API。
 京ICP备2024094994号-29