
Claude Opus 5.5 详解:便宜 40%,什么场景值得用
Claude Opus 5.5 是 Anthropic 在 2026 年 9 月 22 日发布的旗舰模型,也是 Claude 5.5 系列的第一款。API 价格为每百万输入 token 4 美元、输出 20 美元,比上一代 Opus 5 的典型使用成本约低 40%,官方称大多数工作能达到更贵的 Fable 5.1 的水平。一句话总结:更强、更便宜、更快,但思考 token 消耗更高。
本文整理它的核心参数、完整价格、关键跑分、与 Sonnet 5 和 Fable 5.1 的选型建议,以及官方宣传之外你需要注意的成本细节。在它发布之前,我们也写过 Claude Opus 5.5 的传闻与泄露价格梳理,现在可以给那些问题一个确定的答案了。
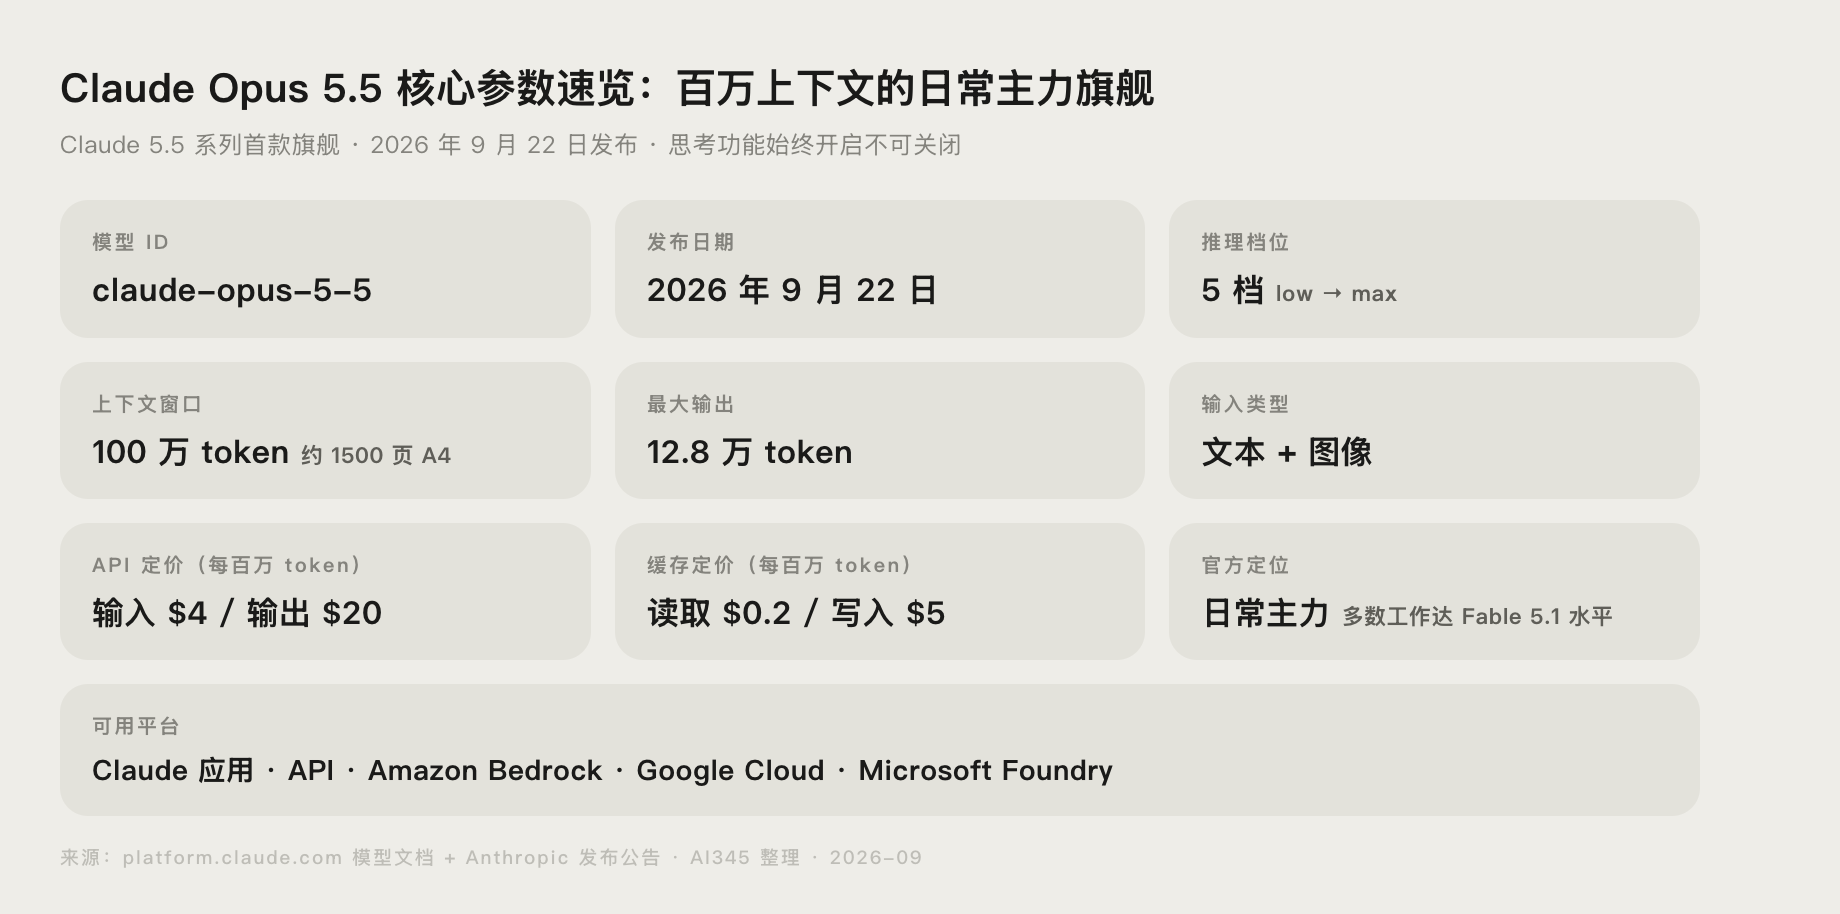
核心参数速览
| 项目 | 参数 |
|---|---|
| 发布日期 | 2026 年 9 月 22 日 |
| 模型 ID | claude-opus-5-5 |
| 上下文窗口 | 默认 100 万 token,约 1500 页 A4 文档 |
| 最大输出 | 12.8 万 token |
| API 定价 | 输入 4 美元 / 输出 20 美元(每百万 token) |
| 缓存定价 | 读取 0.2 美元,写入 5 美元(每百万 token) |
| 推理档位 | low / medium / high / xhigh / max 共 5 档 |
| 输入类型 | 文本 + 图像 |
| 可用平台 | Claude 应用、API、Amazon Bedrock、Google Cloud、Microsoft Foundry |
Claude Opus 5.5 是什么
Opus 5.5 是 Anthropic 当前定位最高的通用模型,官方给它的描述是「面向长时间运行的智能体编码和知识工作」,官方系统卡与模型文档均已同步上线。距离上一代 Opus 5 发布不到两个月,Anthropic 直接跳过了中间版本号,把 5.5 系列的首款产品给了 Opus。
它的核心卖点是官方反复强调的一句话:在大多数工作上的表现达到 Claude Fable 5.1 的水平。Fable 5.1 是 Anthropic 更大、更贵的模型(输入 10 美元、输出 50 美元),如果 Opus 5.5 真能以五分之一的价格给出接近的效果,对普通用户来说就是实打实的降价。
官方还给出一个明确的使用建议:大多数工作负载先用 Opus 5.5,只有当它在你的任务上仍不达标时,再考虑 Fable 5.1。这等于官方自己把「日常主力」的位置交给了 Opus 5.5。
Claude Opus 5.5 价格:API 与订阅
API 定价表
| 项目 | 价格(每百万 token) | 对比上一代 Opus 5 |
|---|---|---|
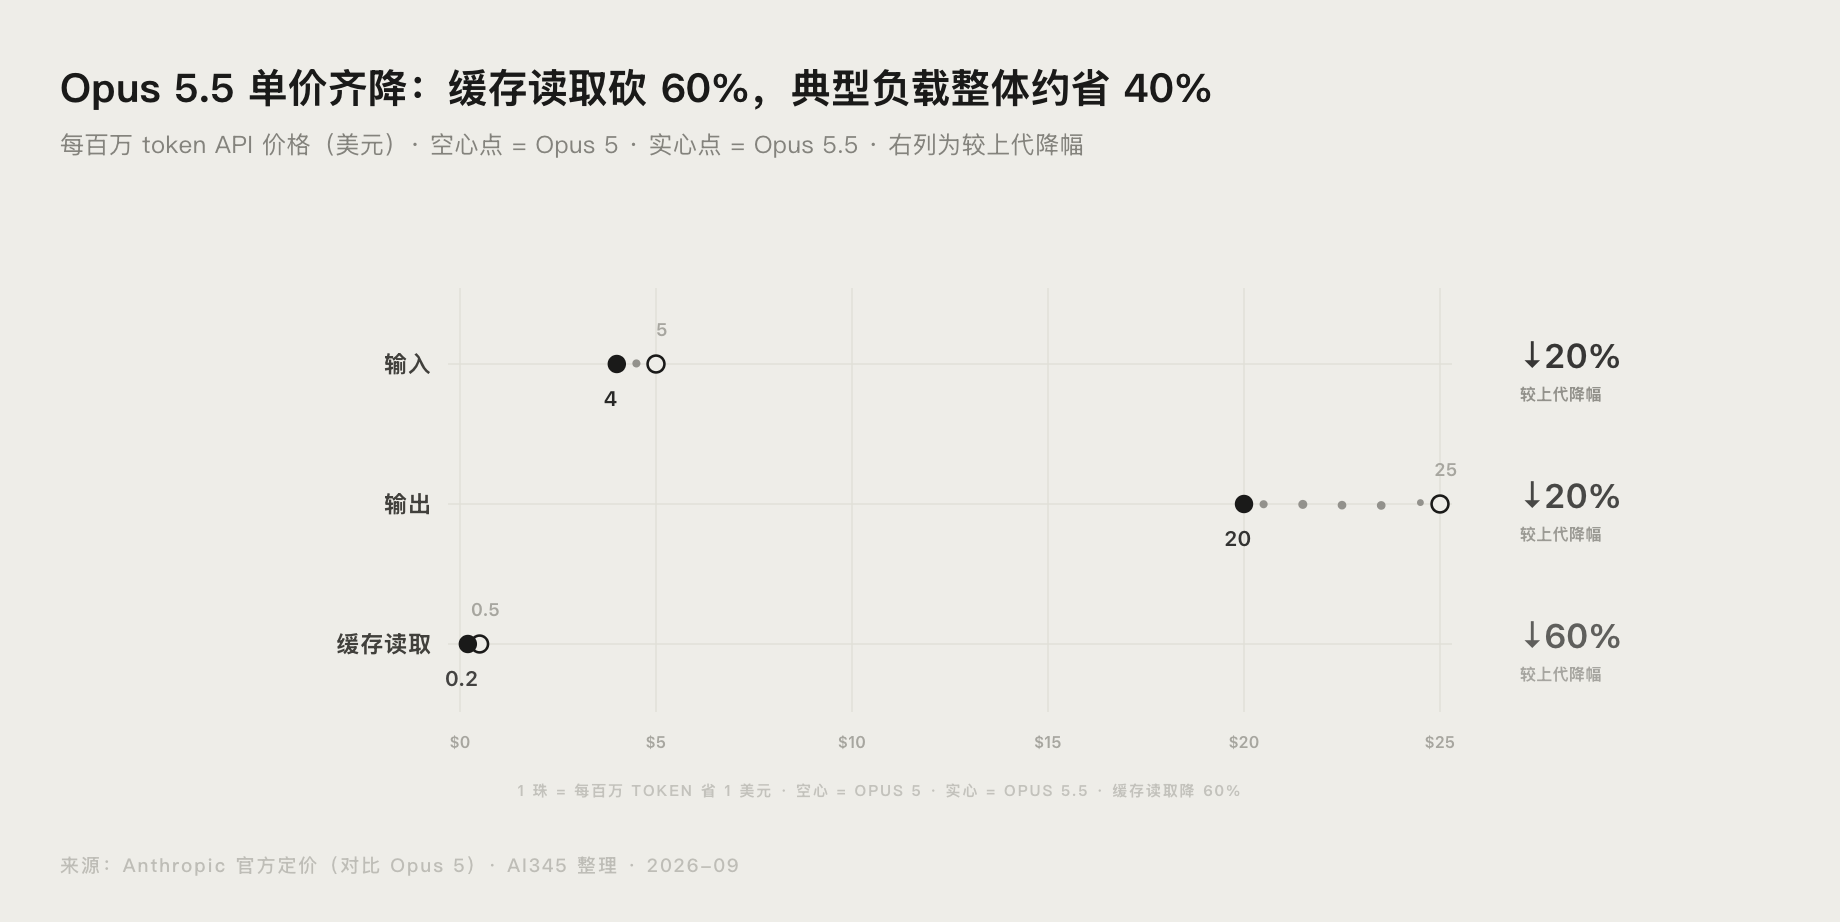
| 输入 | 4 美元 | 从 5 美元降 20% |
| 输出 | 20 美元 | 从 25 美元降 20% |
| 缓存读取 | 0.2 美元 | 从 0.5 美元降 60% |
| 缓存写入(5 分钟) | 5 美元 | 输入价的 1.25 倍 |
| 快速模式 | 8 美元 / 40 美元 | 标准价的 2 倍 |
对长期使用提示词缓存的智能体和编码场景来说,缓存读取降 60% 是这次降价里最实在的一项。Anthropic 自己也说明,缓存读取在智能体和编码工作的成本里占大头。
订阅计划价格
| 计划 | 价格 | 说明 |
|---|---|---|
| Free | 0 美元 | 可用性以官方页面为准 |
| Pro | 20 美元/月,年付 200 美元 | 发布时上调了 5 小时使用限额 |
| Max | 100 美元/月起 | 同步上调限额 |
发布的同时,Anthropic 把 Pro、Max、Team 和企业版的 5 小时使用限额都调高了,还新增了一个可以保存起来稍后使用的速率重置额度。订阅用户不需要做任何操作就能用上 Opus 5.5,具体充值和开通流程可以参考我们之前的 Claude Code 订阅充值攻略。
便宜 40% 的另一面:思考 token 才是大头
官方宣传「典型工作负载整体便宜 40%」,这句话需要拆开看。
第三方评测机构 Artificial Analysis 在该模型的发布评测页给出的实测数据显示,在最高档(max effort)下,Opus 5.5 平均每道题要输出 11.9 万 token,其中 8.4 万是思考过程;上一代 Opus 5 是 7.3 万,GPT-6 Astra 只要 2.7 万。也就是说,它比上一代多想了 60%,比 Astra 多想了 4 倍以上。
单价降两成,思考量涨六成,两头一抵,某些重度推理场景下的实际花费未必下降。结论很直接:单价确实便宜了,但你的账单最终取决于任务难度和推理档位,简单任务记得用低档位,钱是省在档位选择上的,不是省在单价上的。
Claude Opus 5.5 性能怎么样:关键跑分
| 基准测试 | Opus 5.5 | 主要对手 |
|---|---|---|
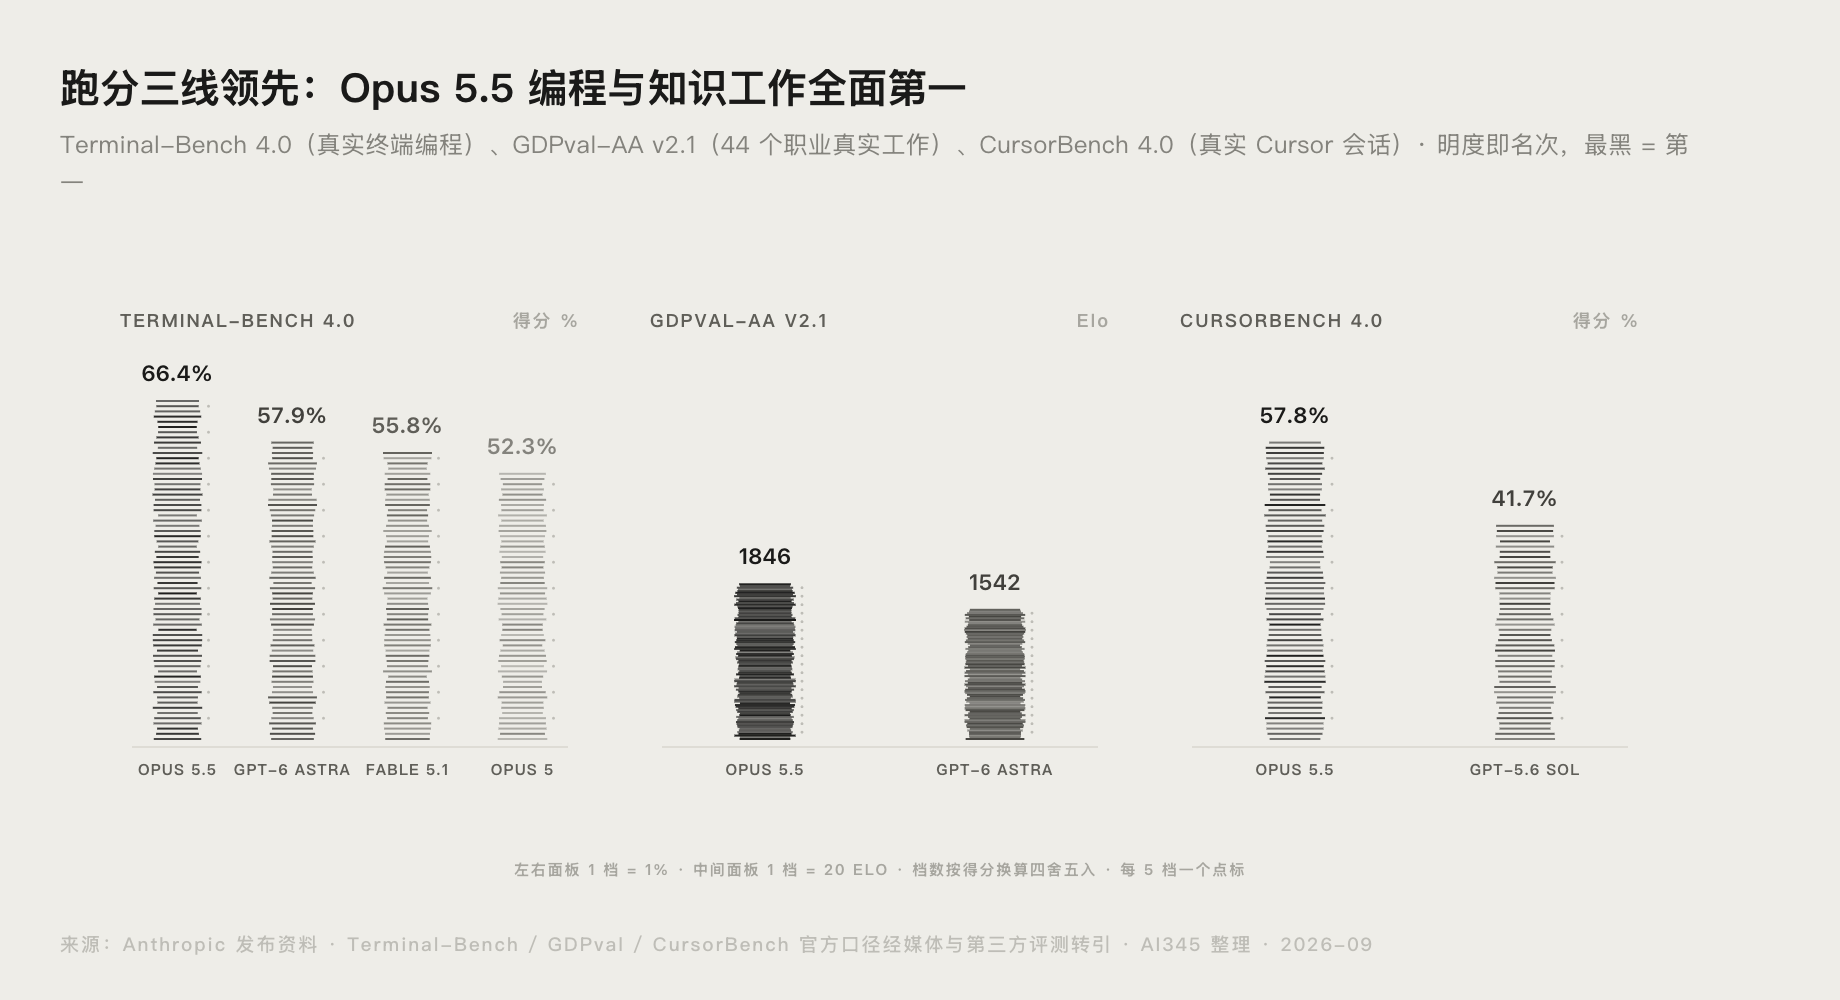
| Terminal-Bench 4.0(真实终端编程) | 66.4% | GPT-6 Astra 57.9%,Fable 5.1 55.8%,Opus 5 52.3% |
| GDPval-AA v2.1(44 个职业的真实工作,Elo) | 1846 | GPT-6 Astra 1542 |
| FrontierCode v1.1(真实代码合并) | 54.4% | GPT-6 Astra 53.3% |
| CursorBench 4.0(真实 Cursor 会话任务) | 57.8% | GPT-5.6 Sol 41.7% |
| Artificial Analysis 智能指数(max 档) | 58 | 榜单第一 |
编程是它拉开差距最大的地方。Terminal-Bench 衡量模型在真实终端环境里完成多步编程任务的能力,Opus 5.5 默认档的成绩就超过了上一代 Opus 5 的最高档,而成本只有后者的五分之一左右。
知识工作方面,GDPval-AA 覆盖 44 个职业的真实工作任务,300 多分的 Elo 差距在竞技评分体系里基本是代差。
比跑分更有参考价值的是官方发布时安排的两项实测:
- 从 Excel 模型到高管演示文稿:让 Opus 5.5 和 Opus 5 分析同一桩虚构并购案,各自在 Excel 里建财务模型再转成演示文稿。两个模型结论一致,但 Opus 5.5 的模型更彻底、演示文稿更好读,旧模型的版本有小错误。
- 无虚构数据报告测试:三个模型各写 18 份财报分析报告,自动评分器逐条核对数据和引用。Opus 5.5 有 16 份通过,Fable 5.1 和 Opus 5 一次都没通过。对要产出报告的人来说,这条可能比任何跑分都重要。
5 个推理档位怎么选
| 档位 | 智能指数 | 每任务成本 | 适合场景 |
|---|---|---|---|
| low | 42 | 约 0.55 美元 | 分类、改写、简单问答 |
| medium | 51 | 约 1.34 美元 | 日常写作、摘要 |
| high | 54 | 约 1.82 美元 | 常规编码、分析 |
| xhigh | 56 | 约 3.46 美元 | 复杂推理、多文件改动 |
| max | 58 | 约 5.98 美元 | 最难的架构和长程智能体任务 |
五个档位之间的成本相差最多 11 倍,但智能指数只差 16 分。日常使用从 medium 或 high 开始,打不赢再升档,是性价比最高的用法。
Opus 5.5、Sonnet 5、Fable 5.1 怎么选
| 对比项 | Opus 5.5 | Sonnet 5 | Fable 5.1 |
|---|---|---|---|
| 定位 | 日常主力旗舰 | 高性价比中端 | 顶级推理 |
| API 价格(输入/输出) | 4 / 20 美元 | 2 / 10 美元 | 10 / 50 美元 |
| 上下文 | 1M | 1M | 1M |
| 强项 | 智能体编码、知识工作、无虚构报告 | 计算机操作、大批量任务 | 最高难度推理、长程智能体 |
| 官方建议 | 大多数工作负载的首选 | 成本敏感的大批量任务 | Opus 5.5 搞不定的硬骨头 |
按场景给结论:
- 写代码、跑 Claude Code、做数据分析报告:直接用 Opus 5.5。它是官方钦定的日常主力,报告无虚构测试的表现也是三个模型里唯一的。
- 大批量、低难度、按 token 计费心疼的场景(批量分类、格式转换、简单摘要):用 Sonnet 5,价格正好是 Opus 5.5 的一半。
- Opus 5.5 升到 max 档还是失败的任务(极难的架构决策、超长程智能体工作):再考虑 Fable 5.1,它和 Mythos 5.1 的差异可以看我们的专门对比。
- 订阅用户:不用纠结,你的计划里 Opus 5.5 就是默认主力,限额还上调了。
和 GPT-6 Sol、Grok 4.7 比怎么样
同一周模型大战打得火热:9 月 21 日 SpaceXAI 发布 Grok 4.7,9 月 22 日 OpenAI 发布 GPT-6 Sol 和 Luna,Anthropic 同日甩出 Opus 5.5,官方公告发布仅 2 小时后 OpenAI 就跟进官宣迎战。
| 模型 | 发布日期 | API 价格(输入/输出) |
|---|---|---|
| Claude Opus 5.5 | 9 月 22 日 | 4 / 20 美元 |
| GPT-6 Sol | 9 月 22 日 | 2 / 10 美元 |
| GPT-6 Luna | 9 月 22 日 | 0.10 / 0.50 美元 |
| Grok 4.7 | 9 月 21 日 | 2 / 6 美元 |
单看价格,Opus 5.5 是这几款里最贵的。但看上文跑分表,它在 Terminal-Bench 和 GDPval 上对 GPT-6 Astra 的领先幅度也是最大的。中文科技媒体 InfoQ 也第一时间整理了发布要点。社区里第一波实测更说明问题:有人一句话生成出可玩的 FPS 游戏,谷歌 DeepMind 研究员的草图被它变成能跑物理仿真的 3D 动画,Bun 作者 Jarred Sumner 的评价是「写代码像 Fable 5.1,它会很快成为大部分人的主力模型」。
也有不客气的声音:Box 的 AI 产品副总裁实测后给出两个数字,token 用量只有上一代的三分之一,啰嗦度降了 40%,但写作手感像 Opus 4.6。也就是说,它的写作是「结论前置、干净利落」的实用型提升,不是文风突变。
至于订阅端的整体对比,可以看我们的 ChatGPT Work 和 Claude Cowork 对比。
上手前要注意的 4 件事
- 思考功能关不掉。Opus 5.5 的自适应思考始终开启,请求里关闭思考的参数会直接报错。旧项目迁移过来之前,先把禁用思考的配置删掉。
- 重度推理任务 token 消耗大。前面说过 max 档单题 11.9 万 token 的数据,API 用户务必给不同任务配好档位,别全用默认高档。
- 旧版集成需要回归测试。官方文档列了行为变化:写作结论前置、执行不可逆操作更谨慎、对提示词注入的抵抗力更强。官方自己的建议是切换模型 ID 后先重跑你的评估集,再改其他东西。
- 官方文档有区域限制。platform.claude.com 在中国大陆无法直接访问,参数以本页整理和官方公告为准。
什么场景值得为它多花钱
把官方数据和社区实测放在一起,我们认为有四类场景值得从 Sonnet 5 或旧款 Opus 换到 Opus 5.5:
- 长会话智能体编程:1M 上下文加缓存读取降 60%,越长的会话越划算,这正是官方博客给它定的定位。
- 要对外交付的报告和演示文稿:16/18 的无虚构通过率是目前独一份的,省下的返工和核对时间远超差价。
- 无人值守的长任务:输出速度提升 30%,配合更谨慎的操作倾向,适合挂机跑的批量活。
- 从 Opus 5 无脑迁移:默认档打上代最高档、成本五分之一,这种情况没有不换的理由。
反过来,如果你的工作只是简单问答和批量格式化,Sonnet 5 的一半价格足够,Opus 5.5 的思考开销对你是浪费。
Sonnet 5.5 快来了,要不要等
官方已确认 Claude 5.5 系列的另外两款会在未来几周发布,其中 Sonnet 5.5 据媒体报道性能会更接近 Opus 5.5、但价格便宜得多,Haiku 5.5 也会同步登场。也就是说,Sonnet 5 的继任者已经近在眼前。
给两类读者的建议:
- 订阅用户:不用等也不用选,你的计划里现在就是 Opus 5.5,先用起来,Sonnet 5.5 上线后自然会出现在模型菜单里。
- API 重度用户:如果你的场景是大批量中低难度任务,可以等几周 Sonnet 5.5 再做决定;如果是编程和报告这类高价值任务,Opus 5.5 现在就能用,等新模型出来后用同样的任务集横评一次再分配预算。
一个可以参照的判断标准:Anthropic 这代的产品逻辑是「用 Opus 的价格给 Fable 的能力」,等 Sonnet 5.5 出来,大概率是「用 Sonnet 的价格给 Opus 的能力」。预算敏感的话,到时候的 Sonnet 5.5 才是性价比之王;现在就要顶配能力的,Opus 5.5 不需要犹豫。
总结
Claude Opus 5.5 把旗舰模型的单价拉低了两成,缓存读取砍掉 60%,用官方的话说大多数工作已经达到 Fable 5.1 的水平,编程跑分是目前全行业第一。它不是没有代价:思考 token 消耗更高、思考功能无法关闭、写作只是实用型改进。对绝大多数订阅用户来说它就是现在该用的默认模型;对 API 用户来说,真正的省钱技巧在档位选择,而真正的选择题是等几周后的 Sonnet 5.5 还是现在就上顶配。
本文由 AI345 整理,最后更新于 2026 年 9 月。价格与参数以 Anthropic 官方公告为准。
常见问题
Claude Opus 5.5 的 API 价格是多少?
答:每百万 token 输入 4 美元、输出 20 美元,缓存读取 0.2 美元、写入 5 美元,快速模式为标准价的 2 倍。与上一代 Opus 5 相比,输入输出各降 20%,缓存读取降 60%。
Opus 5.5 和 Sonnet 5 怎么选?
答:编程、报告、长会话智能体任务选 Opus 5.5,它是官方钦定的日常主力,无虚构报告测试也是三款模型里唯一通过的。大批量低难度任务选 Sonnet 5,价格正好是一半,等几周后 Sonnet 5.5 发布,性价比选型会有更好的答案。
Claude Opus 5.5 能关闭思考功能吗?
答:不能。官方发布说明明确该模型的自适应思考始终开启,请求中带关闭思考的参数会返回错误。从旧模型迁移的集成需要先移除相关配置。
免费的 Claude 能用 Opus 5.5 吗?
答:可以,官方定价页把 Opus 5.5 列为各计划的日常主力模型,免费档也能选用,但受使用限额约束。发布同时 Pro、Max、Team 和企业版的 5 小时限额均已上调,重度使用建议付费计划。
Opus 5.5 比上一代便宜 40% 是真的吗?
答:单价口径成立(输入输出各降 20%、缓存读取降 60%),官方称典型负载整体成本约低 40%。但第三方实测显示它 max 档的思考 token 比上一代多 60%,重度推理任务的实际花费降幅会打折扣,省钱的关键在选对推理档位。
Sonnet 5.5 什么时候发布?
答:官方口径是未来几周内发布,媒体报道称其性能将更接近 Opus 5.5 且价格便宜得多,具体日期和定价以 Anthropic 官方公告为准。
 京ICP备2024094994号-29