
阿里 open-code-review 报错怎么解决
open-code-review(命令是 ocr)的报错基本落在三类:模型端点没配对、模型不支持原生工具调用、Git 或文件过滤条件没满足。官方 FAQ 列了报错原文,下面按现象对号入座。
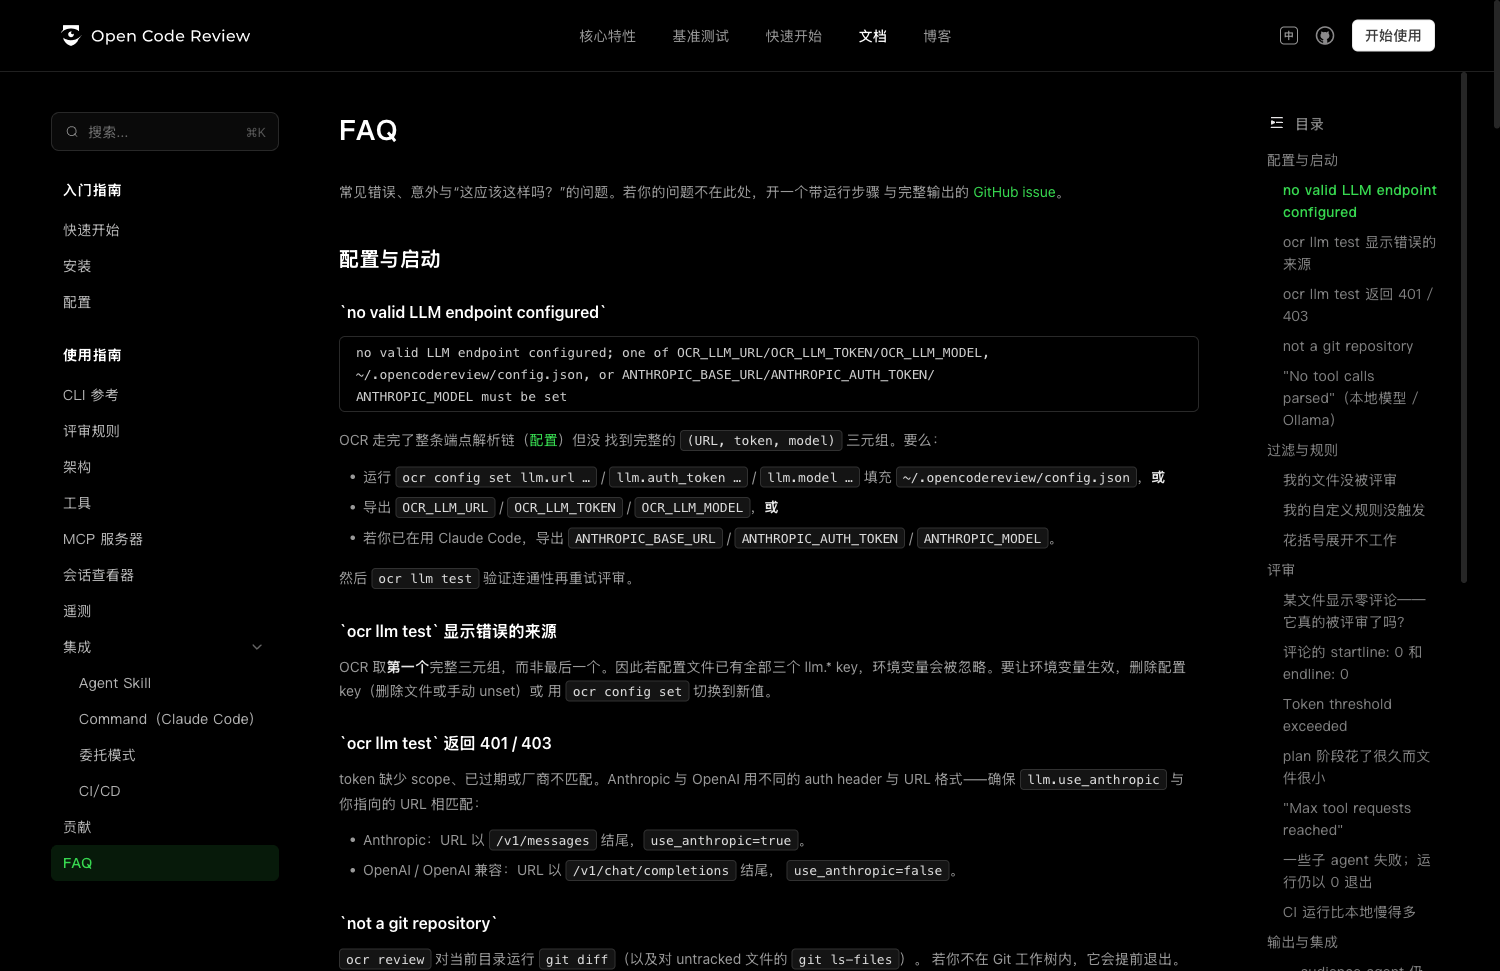
一、no valid LLM endpoint configured:端点没配全
报错原文:no valid LLM endpoint configured; one of OCR_LLM_URL/OCR_LLM_TOKEN/OCR_LLM_MODEL, ~/.opencodereview/config.json, or ANTHROPIC_BASE_URL/ANTHROPIC_AUTH_TOKEN/ANTHROPIC_MODEL must be set!
原因是没找到完整的一套 (URL, token, model):OCR 会依次查环境变量、配置文件 ~/.opencodereview/config.json、以及你已有的 Claude Code 环境变量,只配一两个不算完整。解法任选一种:
- 交互式配置:ocr config provider 选厂商,再 ocr config model 选模型。
- 直接写配置:ocr config set llm.url、llm.auth_token、llm.model。
- 导出 OCR_LLM_URL、OCR_LLM_TOKEN、OCR_LLM_MODEL 三个环境变量。
配完先跑 ocr llm test 再重试。注意配置文件和环境变量同时存在时,取第一个完整三元组。
二、401 / 403:厂商类型与 URL 形状不匹配
token 缺权限、过期或厂商配错都会报这个:
| 你用的厂商 | URL 结尾 | use_anthropic |
|---|---|---|
| Anthropic | /v1/messages | true |
| OpenAI 及兼容接口 | /v1/chat/completions | false |
三、No tool calls parsed:模型不会调工具
本地模型最常见的坑,报错会刷屏:No tool calls parsed for src/foo.go, retrying... 接着 Max tool requests reached for src/foo.go.,最后一个评论都不出。
根因是 OCR 全程靠工具调用驱动审查,模型必须支持原生 function calling。只在文本里“叙述”工具调用的模型跑不通,deepseek-r1 是典型例子,qwen3 这类没问题。处理办法:
- 换支持工具调用的模型,走 Ollama 就从带 tools 标签的模型里挑。
- 先用 curl 单测模型是否返回结构化 tool_calls,再怀疑 OCR 配置。
- 模型没问题只是轮次不够,用 --max-tools 提高上限(默认 100 轮,低于默认值会被忽略)。
四、not a git repository:不在 Git 工作树里
ocr review 依赖 git diff 和 git ls-files,不在仓库里会直接退出。cd 进仓库,或加 --repo /path/to/repo;官方要求 Git 2.41 以上。
五、文件“没被审查”:其实是被过滤了
这类情况不报错,先用 ocr review --preview 看去留原因(不花钱):
| 提示原因 | 含义 | 怎么办 |
|---|---|---|
| binary | 没有可审文本 | 不用管 |
| user_exclude | 命中自己的 exclude 规则 | 删掉该模式 |
| unsupported_ext | 扩展名不在允许清单 | 加进 include |
| default_path | 命中内置测试文件排除规则 | 加进 include 覆盖 |
| provider_directory | vendor、node_modules 这类目录 | 不用管 |
| too_large | 单文件 diff 超过 max_tokens 的 80% | 提高 --max-tokens 或拆小提交 |
规则不生效时用 ocr rules check <文件路径> 看命中的层级与 glob。
六、提示词超出阈值(prompt token 超限)
报错原文:WARNING: prompt tokens (240000) exceed 80% of max_tokens(200000) [round 1] for group "src/big.sql"。
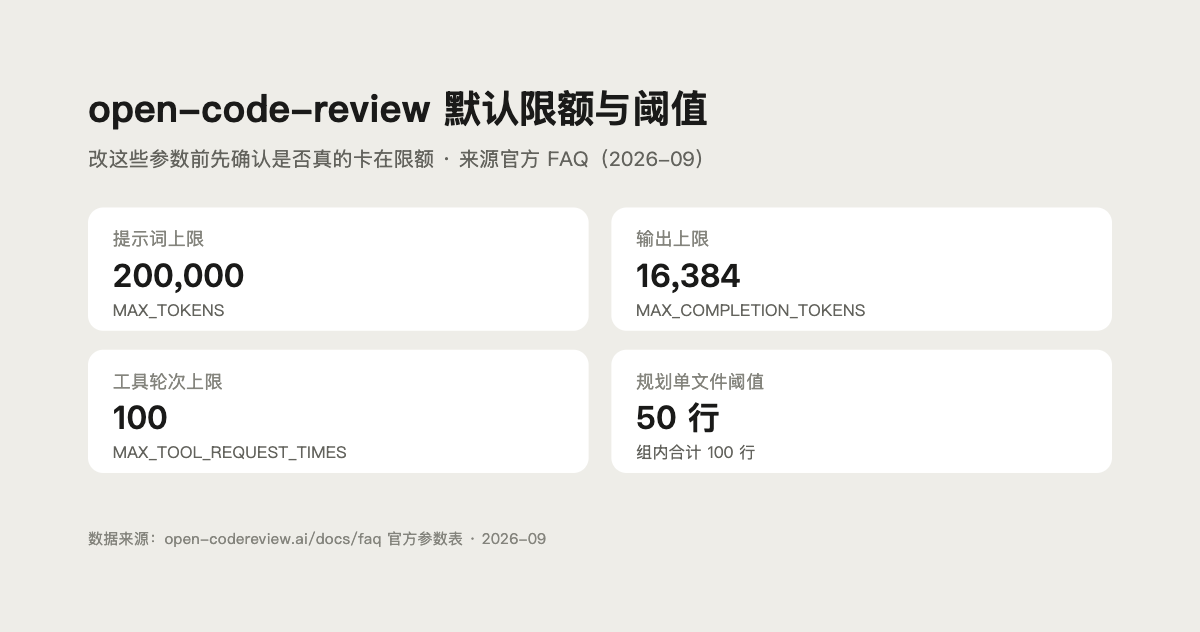
MAX_TOKENS 默认 200000,只管提示词;输出由 MAX_COMPLETION_TOKENS 控制,默认 16384,所以这条说的是输入太大。处理:自动生成文件加进 exclude、大重构拆小提交、用 --commit 逐个审。
七、注释定位到 0 行、输出空 JSON
- start_line 和 end_line 都是 0:模型改写了 existing_code 而不是原样复制 diff,评论是真的,只是没自动定位。
- comments 是空数组:没选中文件时 status 是 skipped,审了没问题时是 complete。
八、先确认版本是最新的
- 安装命令 npm install -g @alibaba-group/open-code-review;仓库见 alibaba/open-code-review。
- 截至 2026 年 9 月 17 日,npm 上最新版本是 1.12.5,Apache-2.0,要求 Node 14 以上,升级用 npm install -g @alibaba-group/open-code-review@latest。
- postinstall 会从 GitHub Releases 拉平台二进制,受限网络最容易失败,改用官方安装脚本或直接下 Release 二进制。
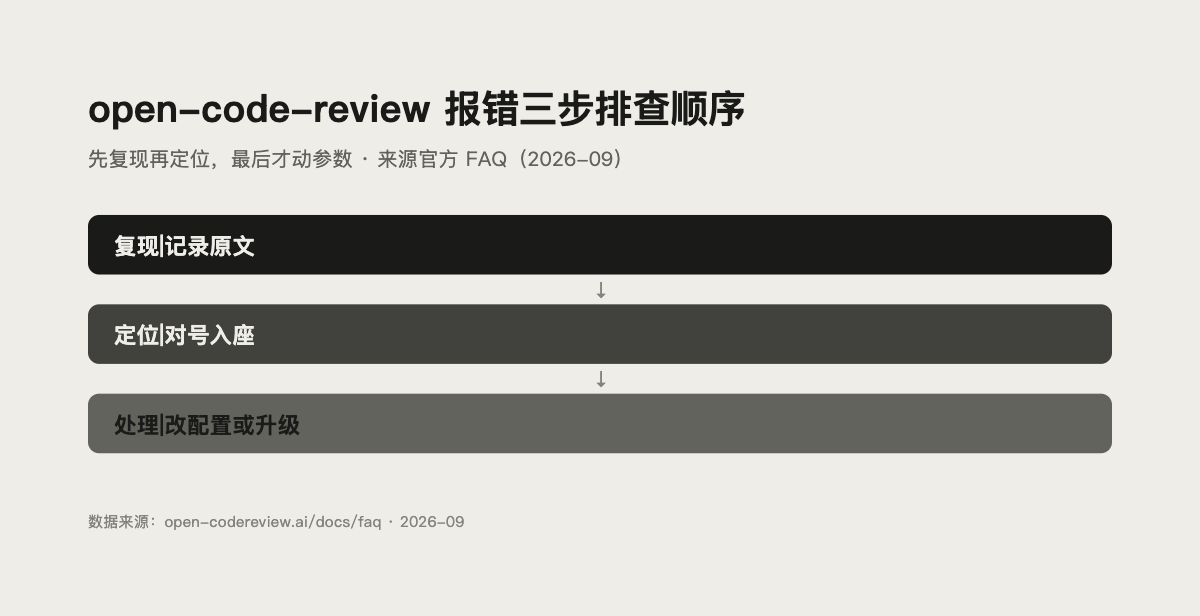
报错排查顺序
- ocr llm test:确认端点与鉴权。
- ocr review --preview:确认文件有没有进审查范围。
- 看会话日志或 ocr viewer:确认模型有没有发出工具调用,再决定换模型或调参数。
定位补充:它是阿里把内部 AI 代码审查助手开源的 CLI,官方用 50 个仓库、200 个真实 PR 做过评测。同类工具可以看 OpenAI Codex 完整指南、Omen Alpha 在哪能用,写插件时 OpenAI Plugins 是什么 也可以参考。
常见问题
ocr 是什么命令,和 open-code-review 什么关系?
答:ocr 是它的命令行入口,npm 全局安装后可用;ocr review 审差异,ocr scan 整文件扫描。
报 no valid LLM endpoint configured 一定是没配 Key 吗?
答:不一定。它表示没有找到完整的 URL、token、model 三元组,补齐后先跑 ocr llm test。
用国产模型能跑吗?
答:只要支持原生函数调用就能跑,qwen3 一类可以;只把工具调用写进文本里的不行。
内网装不上怎么办?
答:postinstall 会去 GitHub Releases 拉平台二进制,受限网络下容易失败,改用官方安装脚本。
没有报错但一条评论都没有,是哪里出问题?
答:先用 ocr review --preview 确认文件是否被过滤,再看 JSON 的 status:skipped 是没选中文件,complete 才是审过没问题。
评论定位到 0 行还能用吗?
答:能用,评论内容是真的,只是没自动定位,多数 Agent 集成会读 existing_code 定位。
 京ICP备2024094994号-29